原論文
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer
- arXiv への初回投稿
- arXiv:1910.10683
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{transformerst52019,
  title = {{Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer}},
  author = {Colin Raffel and Noam Shazeer and Adam Roberts and Katherine Lee and Sharan Narang and Michael Matena and Yanqi Zhou and Wei Li and Peter J. Liu},
  year = {2019},
  eprint = {1910.10683},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1910.10683}
}
2019 年後半、NLP の事前学習の論文は読み切れないほど出ていた。
BERT はマスク言語モデル、GPT-2 は左から右への言語モデル、XLNet は並べ替え言語モデルを使う。RoBERTa に言わせれば、BERT は訓練が足りなかっただけだ。どの論文も、目的関数、モデル構造、事前学習データ、訓練ステップ数、微調整の方法と、一度にいくつも変えている。最終的にスコアは上がっても、どの変更の手柄なのかをはっきり言うのは難しい。
Google の Raffel、Shazeer らはこの論文で、とても愚直で、しかもとても高くつくことをやった。すべてのタスクを同じ形式に書き直し、基準となる設定を一つ固定して、一度に一つの要因だけを変え、一項目ずつ比べたのだ。比べ終わると、各項目の最良の選択を組み合わせ、110 億パラメータまで拡大して、約 1 兆 token で訓練した(2019 年には超巨大モデルだったが、今日の基準では小型モデルにすぎない)。
著者らは序論で、この論文の目的は新しい手法の提案ではなく、分野全体の現状を整理することだとはっきり述べている。この統一モデルは T5(Text-to-Text Transfer Transformer)と呼ばれる。論文はあわせて、クリーニング済みのウェブコーパス C4 も公開し、これは後に多くの言語モデルの事前学習データになった。
問題の定義
NLP における転移学習(transfer learning)では、まず大量のラベルなしテキストで事前学習し、それから下流タスクのラベル付きデータで微調整する。2019 年には、この流れのどの段階にも選択肢がいくつもあり、しかも互いに比べにくかった。
BERT のようなエンコーダだけのモデルは、分類や、原文中の答えの位置を示すことは得意だが、翻訳や要約を直接生成することはできない。GPT のような言語モデルは生成できるが、分類タスクでは通常、分類ヘッドを別に付ける必要がある。モデル、損失関数、デコード方法のどれかが違えば、比較で出てきた差にはほかの変数が混ざってしまう。
そこで著者らには、分類、質問応答、翻訳、要約を同時に扱える共通の枠組みが必要だった。同じモデル、同じ損失関数、同じハイパーパラメータの組で、すべてのタスクを回せるようにする。それがあってはじめて、一度に一つの要因だけを変えられる。
問題を解く
テキストを入れて、テキストを出す
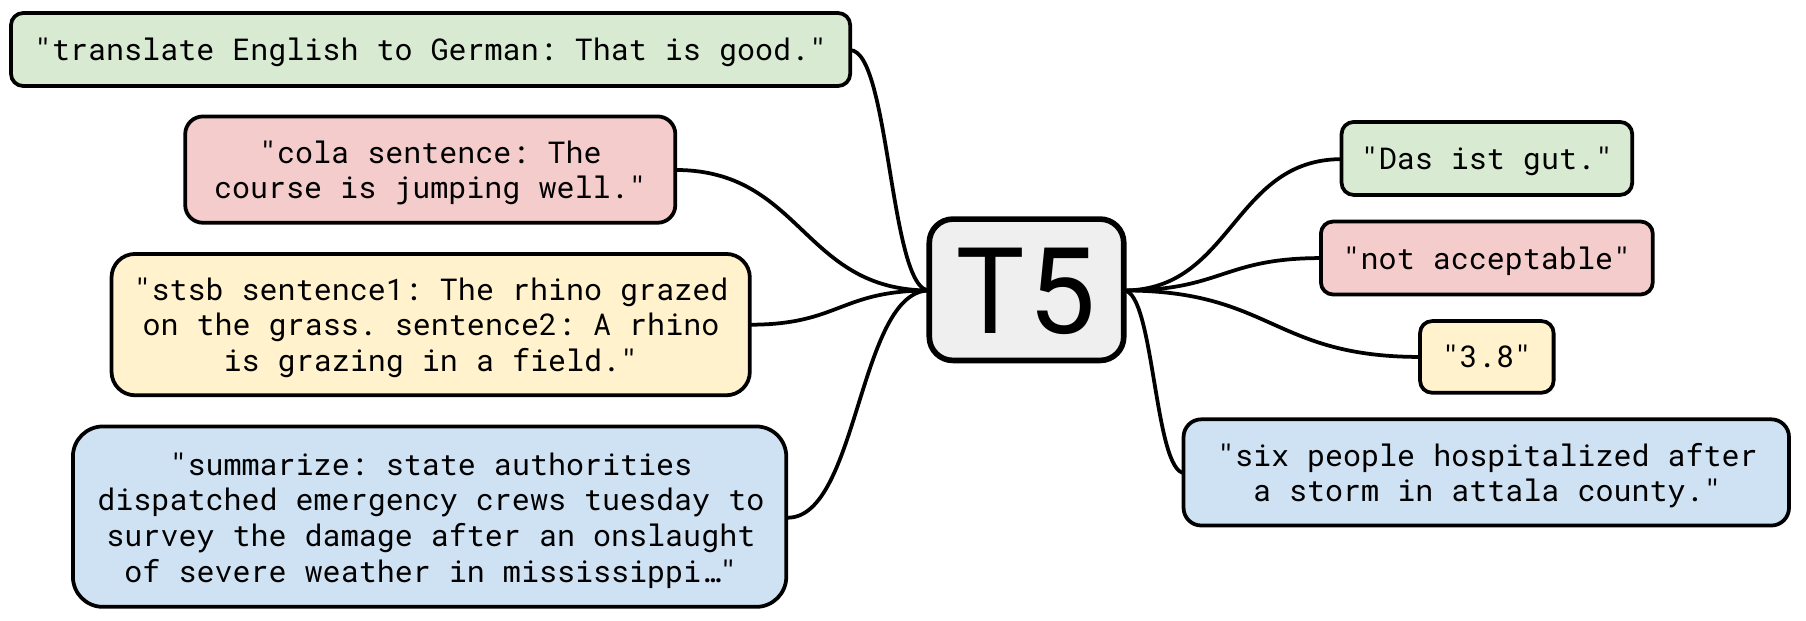
どのタスクも「テキストを入力し、テキストを出力する」形に書き直し、タスク名を入力の先頭にプレフィックスとして直接書く。翻訳なら「translate English to German: That is good.」を入力し、「Das ist gut.」を出力するよう訓練する。
分類タスクも同じで、出力がクラス名に変わるだけだ。MNLI は前提と仮説の関係を判定するタスクで、入力は次のようになる。
mnli premise: I hate pigeons. hypothesis: My feelings towards pigeons are filled with animosity.
目標の出力は entailment という単語だ。モデルが選択肢にない単語、たとえば「hamburger」を出力したら、そのまま不正解として扱う。著者らによれば、実際にはそういうケースは一度も見なかったという。
もう少し変換が必要なタスクが二種類ある。STS-B は二つの文の類似度を予測するタスクで、答えは 1 から 5 の実数だ。著者らはラベルの大半が 0.2 刻みになっていることに気づき、スコアを最も近い 0.2 刻みの値に丸めてから文字列にした。たとえば 2.57 は「2.6」になり、回帰問題が 21 クラスの分類になる。Winograd 系の代名詞の曖昧性解消タスクでは、曖昧な代名詞をアスタリスクで囲み、それが指す名詞をモデルに出力させる。
入力:The city councilmen refused the demonstrators a permit because *they* feared violence.
出力:The city councilmen
すべてのタスクは最尤推定で訓練する。つまり普通の交差エントロピーに teacher forcing を組み合わせる。プレフィックスの書き方自体も一種のハイパーパラメータで、著者らは言い回しを変えてみたが、影響は小さかった。
モデル:元の Transformer にほぼ忠実
モデルは標準的なエンコーダ・デコーダ型の Transformer で、著者らが変えたのは三か所だけだ。
- LayerNorm はスケーリングだけで、バイアスを加えない。
- LayerNorm を各サブレイヤーの入力側に移す。残差の経路そのものは正規化しない。後によく Pre-LN と呼ばれる形だ。
- 相対位置エンコーディングを一つのスカラーに簡略化し、注意スコアに直接加える。各注意ヘッドがそれぞれ一組を持ち、すべての層で共有する。バケットは全部で 32 個で、対応する距離の範囲は対数的に広がり、128 を超える距離はすべて同じバケットに入る。一つの層では 128 より先の位置の違いを区別できないが、層を重ねれば区別できるようになる。
出力層は入力の埋め込みと重みを共有する。この点は元の Transformer と同じだ。著者らはこの三つの変更についてアブレーションをしていない。本論文で比べたい要因とは関係がないからだ。
基準モデルはエンコーダとデコーダがそれぞれ 12 層で、どちらも BERT-Base と同程度の大きさだ。、フィードフォワード層 、注意ヘッド 12 個、各ヘッド 。合計で約 2.2 億パラメータあり、ネットワークのスタックが二つあるので、BERT-Base のおよそ二倍になる。
C4:クリーニングしたウェブテキスト
Common Crawl は毎月約 20TB のウェブページのテキストを収集しているが、その大半はメニュー、エラーメッセージ、重複した定型文やコードだ。著者らは 2019 年 4 月のスナップショットに、一連のルールを適用した。
- ピリオド、感嘆符、疑問符、閉じ引用符で終わる行だけを残す。
- 3 文未満のページはページごと捨てる。5 単語以上の行だけを残す。
- 「汚い言葉リスト」にある単語が一つでも出てくるページは、ページごと削除する。
- 「Javascript」を含む行は削除し、「lorem ipsum」を含むページは削除する。
- 波括弧
{を含むページは削除する。たいていはコードだからだ。 - Wikipedia の引用マーカーと、「terms of use」「cookie policy」のような文字列を含む行を削除する。
- 重複除去:繰り返し現れる連続した三文の断片は、一つだけ残す。
- langdetect を使い、英語である確率が 0.99 以上のページだけを残す。
結果は約 750GB になり、著者らは Colossal Clean Crawled Corpus、略して C4 と名づけた。三年あまり後に Meta が LLaMA を訓練したときも、C4 は事前学習データの 15% を占めていた。
基準の訓練設定
事前学習は ステップ回す。一バッチは長さ 512 の系列 128 本で、パッキング後は一バッチ約 token、合計で約 億 token になる。BERT の約 1,370 億、RoBERTa の約 2.2 兆に比べればずっと少ないが、さまざまな設定を比べるには十分で、しかも C4 は十分大きいので、全工程を通じてデータを一度も繰り返さない。
オプティマイザは AdaFactor。事前学習の最初の ステップは学習率 0.01 で固定し、その後はステップ数の平方根の逆数に従って減衰させる。下流タスクはどれも ステップ微調整し、学習率は 0.001 で固定、5,000 ステップごとに保存して、検証セットで最もよい checkpoint を報告する。語彙は SentencePiece で訓練した 32,000 個のワードピースで、訓練データは英語の C4 とドイツ語、フランス語、ルーマニア語を 10:1:1:1 で混ぜたものだ。下流にこの三言語の翻訳タスクがあるからである。
事前学習の目的:抜き取った断片だけを予測する
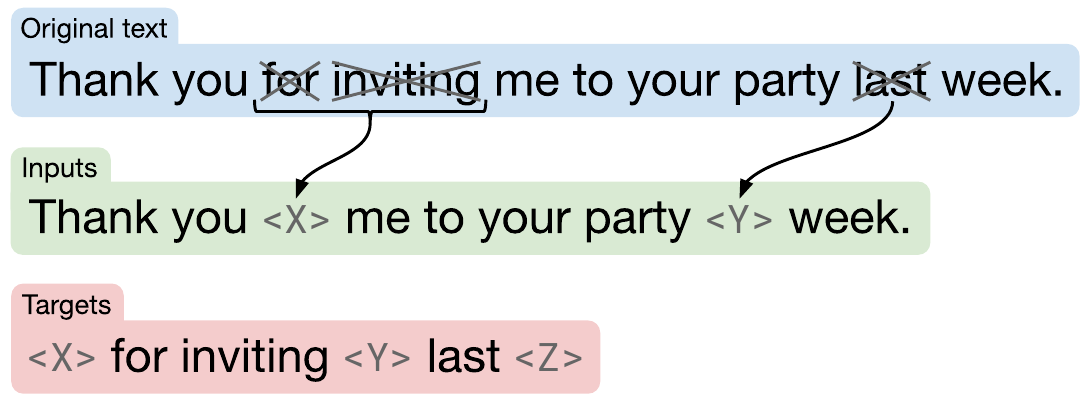
基準の目的は BERT のマスク言語モデルを改造したものだ。token の 15% をランダムに選んで破損させ、連続して選ばれた token は一つの断片にまとめて、一つの「センチネル」(sentinel)token で置き換える。断片ごとに違うセンチネルを使う。出力には抜き取られた断片だけを含め、各断片の前に同じセンチネルを置き、最後に終端としてセンチネルをもう一つ付け足す。
図の例どおりにコードを書いてみよう。
tokens = "Thank you for inviting me to your party last week .".split()
noise = [0, 0, 1, 1, 0, 0, 0, 0, 1, 0, 0]  # 1 = 破損させる対象に選ばれた token

def span_corrupt(tokens, noise):
    sentinels = iter(["<X>", "<Y>", "<Z>"])
    inputs, targets, prev = [], [], 0
    for tok, n in zip(tokens, noise):
        if n and not prev:          # 連続した破損区間の先頭にセンチネルを置く
            s = next(sentinels)
            inputs.append(s)
            targets.append(s)
        if n:
            targets.append(tok)     # 破損させた token は出力にだけ現れる
        else:
            inputs.append(tok)
        prev = n
    targets.append(next(sentinels))  # 最後に終端のセンチネルをもう一つ足す
    return inputs, targets

inputs, targets = span_corrupt(tokens, noise)
print(" ".join(inputs))    # Thank you <X> me to your party <Y> week .
print(" ".join(targets))   # <X> for inviting <Y> last <Z>
print(len(tokens), len(inputs), len(targets))  # 11 10 6
「for」と「inviting」は隣り合っているので、一つの <X> を共有する。元の文は 11 token で、入力は 10 token に減り、出力はたった 6 token だ。BERT のやり方にならって「元の文全体を出力する」形にすると、デコーダは 11 token を生成しなければならない。著者らが抜き取った断片だけを予測する方式を選んだのは主に計算を節約するためで、デコーダの系列が短いほど事前学習は速くなる。
実際の T5 は <extra_id_0>、<extra_id_1> のような特殊 token をセンチネルに使う。これらは語彙に追加されたもので、どのワードピースにも対応しない。
基準はどれだけ安定しているか
どの実験も何度も繰り返すのは高くつきすぎる。そこで著者らは基準設定を最初から 10 回訓練し、その 10 回の標準偏差をすべての変種の参考値とした。ほとんどのタスクで標準偏差はスコアの 1% 未満だが、CoLA、CB、COPA のような小さなデータセットは例外で、CB の検証セットはわずか 56 件しかなく、F1 の標準偏差は 3.2 にもなる。論文の表では、最高スコアとの差が標準偏差の二倍以内の結果をすべて太字にしている。
同じモデルを事前学習せずに直接 ステップ訓練すると、GLUE は 83.28 から 66.22 に、SQuAD は 80.88 から 50.31 に落ちる。英仏翻訳はほとんど影響を受けない(39.82 対 39.77)。このデータセット自体が十分大きいからだ。
議論
論文の本体は、構造、目的、データ、訓練戦略からスケーリングまでの一連の対照実験だ。表で報告されるのは GLUE と SuperGLUE の平均スコア、CNN/DM 要約の ROUGE-2、SQuAD の完全一致率、三組の翻訳の BLEU で、最後の総合成績を除けば、どれも検証セットでの値だ。
構造:パラメータ数と計算量は分けて考える
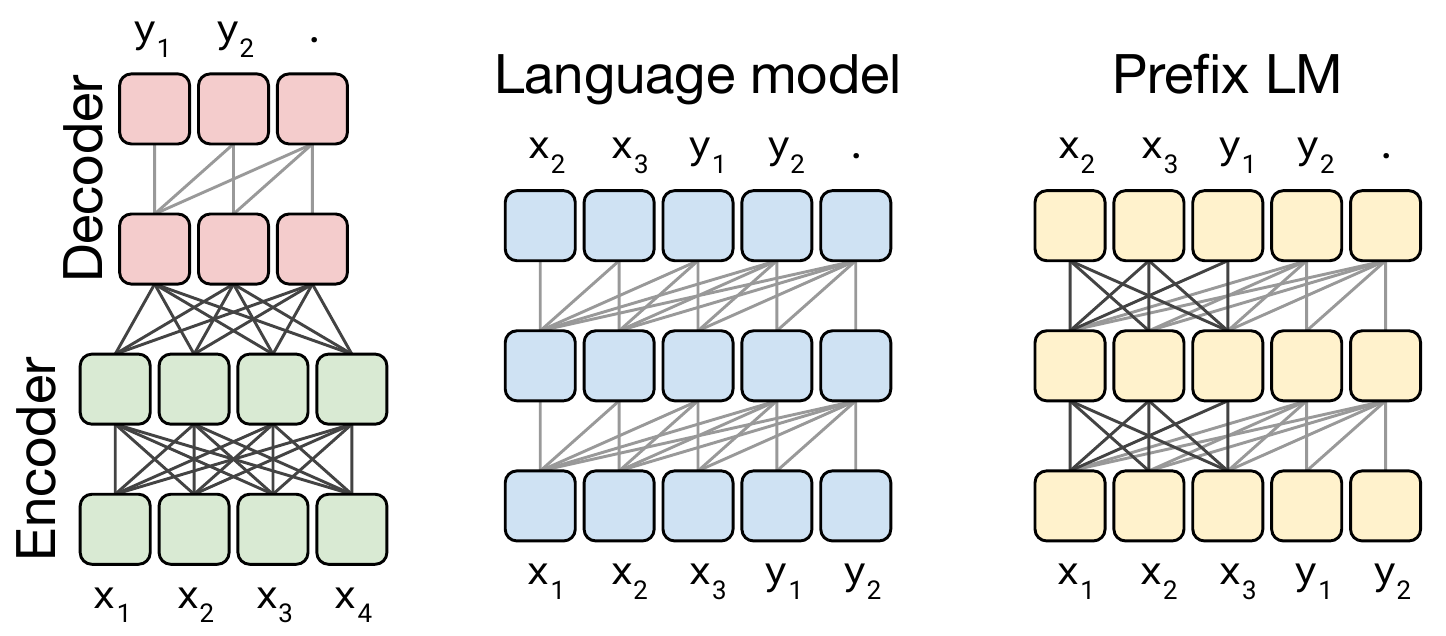
図の濃い灰色の線は全可視の注意を、薄い灰色の線は因果マスク、つまり過去の位置しか見られない注意を表す。言語モデルで翻訳を扱うときは、「translate English to German: That is good. target: Das ist gut.」のように、入力と出力を一本の系列につなげる必要がある。問題は、因果マスクのせいで入力部分の各位置も前しか見られず、文の前半の表現が後半を見られないことだ。prefix LM は入力の部分を全可視に変えて、この点を解決する。分類タスクでは prefix LM は実は BERT によく似ていて、違いは分類結果を出力層が直接生成することだけだ。
構造を比べる前に、「公平」の基準を決めなければならない。エンコーダとデコーダがそれぞれ 層のモデルは、パラメータ数では 層の言語モデルとほぼ同じだ。だが計算量は 層の言語モデルと同程度にすぎない。エンコーダは入力だけ、デコーダは出力だけを処理するのに対し、言語モデルは各層を入力と出力の両方にかけるからだ。著者らが実測したところ、両者の一ステップあたりの時間はほぼ同じだった。
BERT-Base 規模のスタック一つのパラメータ数を 、入出力一組の処理に必要な計算量を FLOPs とすると、結果は次のとおりだ。
| 構造 | 目的 | パラメータ | 計算量 | GLUE | SuperGLUE | SQuAD | 英独 BLEU |
|---|---|---|---|---|---|---|---|
| エンコーダ・デコーダ | ノイズ除去 | 83.28 | 71.36 | 80.88 | 26.98 | ||
| エンコーダ・デコーダ、パラメータ共有 | ノイズ除去 | 82.81 | 70.73 | 80.63 | 26.72 | ||
| エンコーダ・デコーダ、各 6 層 | ノイズ除去 | 80.88 | 68.42 | 77.59 | 26.38 | ||
| 言語モデル | ノイズ除去 | 74.70 | 55.02 | 61.14 | 25.09 | ||
| Prefix LM | ノイズ除去 | 81.82 | 68.11 | 78.94 | 26.43 | ||
| エンコーダ・デコーダ | 言語モデル | 79.56 | 64.29 | 76.02 | 26.27 |
原論文 Table 2 をもとに整理。一部の行と列を抜粋。
同じ計算量なら、エンコーダ・デコーダとノイズ除去目的の組み合わせが、すべてのタスクで最もよい。エンコーダとデコーダでパラメータを共有すると、パラメータ数は半分になるがスコアは少ししか落ちず、同じ 個のパラメータを持つ prefix LM よりもよい。著者らは、明示的なエンコーダ・デコーダ注意が効いていると考えている。層数を半分にすると明らかに悪くなる。もう一つ一貫している結果として、ノイズ除去の目的はどの構造でも言語モデルの目的を上回る。
事前学習の目的:差は小さいので、安いものを選ぶ
目的関数の比較は三段階で行う。第一段階では三つの大きな方向を比べる。prefix 言語モデル(GLUE 80.69)、BERT 式のマスク(82.96)、そして文をシャッフルして元に戻す方式(73.17)だ。BERT 式が最もよく、シャッフルの復元は明らかに遅れる。
第二段階では BERT 式の変種を比べる。ランダムな置換をなくす、断片全体をセンチネルで置き換える、破損させた token を単純に削除する、といったものだ。四つの変種のスコアはどれも近い。token を削除する版は GLUE でわずかに高いが、これは主に CoLA(60.04、基準は 53.84)から来ている。著者らは、文が文法的に正しいかの判断は、どこで単語が欠けているかに気づくことと関係があるのだろうと推測している。ただしこの版は SuperGLUE ではセンチネル版より悪い。
第三段階では破損の割合と断片の長さを調整する。10% から 25% まではあまり差がなく、50% になると GLUE と SQuAD がはっきり下がる。断片の破損は二つのパラメータで表す。500 token の系列で 15% を破損させるなら 75 token になり、それを 25 個の断片に分けると決めれば、平均の長さは 3 になる。平均長 3 の版は、翻訳以外のほとんどのタスクで token ごとのランダムな破損をわずかに上回り(SuperGLUE 72.53 対 71.36)、しかも系列が短くなって訓練が速い。
著者らの結論は、試したノイズ除去の目的どうしの性能差は小さく、主に計算コストで選ぶべきだ、というものだ。
事前学習データ:フィルタリングは効く、小さすぎると丸暗記する
C4 のフィルタリング規則をすべて外す(言語判定だけは残す)と、データは 6.1TB になり、すべてのタスクが悪化して、GLUE は 83.28 から 81.46 に落ちた。
小さくても分野の集中したデータは、特定のタスクで勝つ。Wikipedia と Toronto Books Corpus の組み合わせ(BERT が使ったもので、計 20GB)は SuperGLUE を 73.24 まで押し上げたが、その伸びはほぼすべて MultiRC から来ている。MultiRC の完全一致率は 25.78 から 50.93 に跳ね上がっており、MultiRC の最大のデータ源はまさに小説だ。ニュースサイトの内容だけを残した RealNews-like 版は、ニュースの読解タスク ReCoRD を 68.16 から 73.72 に引き上げた。下流タスクと事前学習データの分野が近いほど、効果は高い。
代償はデータ量だ。GPT-2 の WebText のやり方をまねて(Reddit でスコアが 3 以上のリンクだけを残す)、Common Crawl を 12 か月分使っても、得られたのは 17GB だけだった。著者らはさらに C4 をわざと切り詰め、同じ 340 億 token の訓練で同じデータを繰り返し見るようにした。64 回の繰り返しなら影響は小さい。1,024 回繰り返すと GLUE は 79.55 に、4,096 回では 76.34 に落ちる。それなのに訓練損失ははっきり低くなる。モデルがデータを丸暗記し始めたということだ。
訓練戦略:全パラメータの微調整がやはり最良
一部のパラメータだけを更新する手法は分が悪い。Adapter は各フィードフォワード層の後ろに小さな「全結合-ReLU-全結合」ブロックを加え、それと LayerNorm だけを訓練する。内部次元 のとき、SQuAD はまだ 79.32 あるが、英独翻訳はたった 13.84 BLEU になる。データの少ないタスクなら小さな adapter で十分だが、データの多いタスクにはずっと大きな次元が必要だ。層ごとに凍結を解いていく方法(gradual unfreezing)は、すべてのタスクでわずかに後退した。
マルチタスク学習は text-to-text の枠組みではとても簡単で、異なるデータセットのサンプルを同じバッチに混ぜればよい。厄介なのは、各タスクにどれだけの割合を割り当てるかだ。著者らは三つの混ぜ方を比べた。
- データ量に比例:データが多いほど多く抽出するが、上限 を設け、ラベルなしデータや英仏翻訳のような大きなデータセットがほかのタスクを埋もれさせないようにする。
- 温度スケーリング:各タスクの割合を 乗してから正規化する。 なら比例と同じで、 が大きいほど均等に近づく。
- 均等割り当て:どのタスクも抽出される確率が同じ。
均等割り当てが最も悪く、GLUE は 76.13 しかない。比例で混ぜる場合、ほとんどのタスクにそれぞれ最適な がある。温度スケーリングは が最もよい。しかし、どの混ぜ方も「まず教師なしで事前学習し、それから個別に微調整する」には追いつかなかった。
折衷案は効く。まずマルチタスクの混合で事前学習し、それから個別のタスクで微調整すると、GLUE は 83.11 で基準の 83.28 とほぼ同じになり、英語→ルーマニア語の翻訳はわずかに高い。目標タスクを事前学習の混合から外しても(leave-one-out)、スコアはわずかに下がるだけだ。多くのタスクを見たモデルは、見たことのないタスクにも適応できるということになる。ラベル付きタスクだけで事前学習し、ラベルなしデータをまったく使わないと、翻訳以外は明らかに悪化する。
計算量が 4 倍あったら、どう使うか
計算量が 4 倍になったら、長く訓練するか、モデルを大きくするか、アンサンブルにするか。著者らは実際に一度比べてみた。
| やり方 | GLUE | SuperGLUE | SQuAD | CNN/DM | 英独 BLEU |
|---|---|---|---|---|---|
| 基準 | 83.28 | 71.36 | 80.88 | 19.24 | 26.98 |
| 同じサイズ、ステップ数 4 倍 | 85.33 | 74.72 | 82.45 | 19.33 | 27.08 |
| 同じサイズ、バッチ 4 倍 | 84.60 | 74.64 | 82.52 | 19.42 | 27.07 |
| モデル 2 倍、ステップ数 2 倍 | 86.18 | 77.18 | 84.18 | 19.66 | 27.52 |
| モデル 4 倍、ステップ数そのまま | 85.91 | 78.04 | 83.86 | 19.73 | 27.47 |
| 独立に訓練した 4 モデルのアンサンブル | 84.77 | 71.74 | 83.09 | 20.10 | 28.05 |
原論文 Table 13 をもとに整理。一部の行と列を抜粋。
四つの使い方はどれも効果がある。モデルを大きくするほうが、訓練量だけを増やすより通常は効果が高い。モデル 2 倍で 2 倍長く訓練するのと、モデル 4 倍とでは、ほぼ同じだ。アンサンブルは CNN/DM 要約と、英独および英語→ルーマニア語の翻訳でほかのすべてのやり方を上回るが、SuperGLUE にはほとんど効かない。著者らは、大きなモデルはその後の微調整も推論も高くつくこと、小さなモデルを長く訓練するコストは多くの下流タスクで分け合えることにも注意を促している。
組み合わせる:T5
最終的な T5 は、研究の結論を組み合わせたものだ。
- 目的:断片の破損。破損率 15%、平均の断片長 3。
- 訓練量:100 万ステップ、一バッチは長さ 512 の系列 本で、約 1 兆 token。基準の 32 倍だ。分野の集中したデータセットは小さすぎて何百回も繰り返すことになるので、引き続き C4 を使う。
- モデルサイズ:Small(6000 万)、Base(2.2 億)、Large(7.7 億)、3B、11B。3B と 11B では主にフィードフォワード層を大きくした。 はそれぞれ 16,384 と 65,536、注意ヘッドはそれぞれ 32 個と 128 個だ。フィードフォワード層を広げた理由について、著者らは TPU が大きな密行列の乗算を最も得意とするからだと述べている。
- マルチタスクで事前学習してから微調整する。GLUE と SuperGLUE はサブタスクごとの微調整に切り替え、小さなデータセットでの過学習を避けるためにバッチを 8 に縮める。
- 翻訳と要約では幅 4 のビームサーチを使う。
T5 は 24 タスクのうち 18 タスクで当時の最高記録を出した。3B の時点ですでにいくつかのタスクで先行研究を上回っており、著者らは 11B への拡大が最高の成績を得るうえで最も重要な一歩だったと考えている。GLUE の平均は 90.3。SuperGLUE の平均は 88.9 で、それまでの最高は 84.6、人間は 89.8。SQuAD の完全一致率は 91.26 で、それまでの最高は 90.1。CNN/DM の ROUGE-2 は 21.55 で、それまでの最高は 20.30 だった。
スコアの裏には、著者ら自身が指摘している問題もある。T5 は MultiRC と ReCoRD で人間を大きく上回ったが、著者らは、評価指標が機械の出力に有利に働いた可能性のほうが高いと見ている。人間は COPA と WSC でどちらも 100% で、T5 はまだかなり及ばない。翻訳では一つも最高記録を取れなかった。事前学習は英語だけで、当時の最高の翻訳システムは逆翻訳(back-translation)などのデータ拡張も使っていた。
最後の実験は、T5 の進歩のうちどれだけが規模によるものかに答える。基準モデルを同じく 1 兆 token で訓練した版(Baseline-1T)は GLUE 84.80、SuperGLUE 73.90、SQuAD 83.01。T5-Base は 85.97、75.64、85.44 だ。両者は大きさも訓練量も同じで、違いは研究の中で選び出された、規模以外の変更だけだ。そして T5-Base はすべてのタスクで勝っている。
その後の検証
C4 は公開後に広く使われ、2021 年には Dodge らが最初の本格的な C4 の文書化研究を行った。単一ドメインで最も多くの token を占めていたのは patents.google.com だった。内容には機械翻訳で生成されたテキストや、ほかの NLP ベンチマークのテスト問題も含まれており、たとえば XSum 要約では参照解答の 15.49% がそのままの形で C4 に現れていた。
彼らは「汚い言葉リスト」で削除された内容を特に詳しく調べた。削除された文書のうち、性的な内容が中心のクラスタはおよそ三割を占め、ほかに科学、医学、健康、法律や政治に関する文書もあった。方言のトピックモデルで分類すると、アフリカ系アメリカ人英語とヒスパニック系英語の文書が削除される割合はそれぞれ 42% と 32% で、白人英語はわずか 6.2% だった。性的指向に触れた文書は最もフィルタで除かれやすく、「gay」に関連する削除文書を人手でサンプリングして確認したところ、36% は攻撃的でも性的でもない内容だった。ページごと削除するキーワードフィルタは安上がりだが、削られるものは中立ではない。
構造についての結論も、後続の研究と照らし合わせておく価値がある。T5 の比較は「事前学習の後に各タスクで微調整する」設定で行われた。BigScience の Wang らは 2022 年に別の設定で比べ直し、事前学習後のゼロショット性能だけを見ると、因果デコーダと自己回帰言語モデル目的の組み合わせが最もよく、マルチタスクのプロンプト微調整を加えると、入力が全可視でマスク目的で訓練した構造が最もよいことを示した。つまり T5 の結論は、それ自身の設定のもとで成り立つ。その後の大規模モデルがおおむねデコーダだけの構造に向かったのは、ゼロショットや少数ショットでの使い方がますます重視されるようになったことと関係している。
結論
この論文は、とても長い実験マニュアルのように読める。まずすべてのタスクをテキストを入れてテキストを出す形に書き直し、一度に一つの要因だけを変えていく。構造、目的、データ、微調整から規模まで、どの項目にも引ける表がある。
いくつかだけ持ち帰るなら、だいたいこんなところだ。ノイズ除去の目的はどれも似たようなものなので、訓練の安いものを選ぶ。事前学習データはまずきれいにし、繰り返し見なくてすむほど大きくする。余った計算資源は、まずモデルを大きくするのに使う。
「エンコーダ・デコーダが最良」という項目のほうは、二年後、Google 自身の PaLM ですら守らなかった。