原論文
PaLM: Scaling Language Modeling with Pathways
- arXiv への初回投稿
- arXiv:2204.02311
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{transformerspalm2022,
  title = {{PaLM: Scaling Language Modeling with Pathways}},
  author = {Aakanksha Chowdhery and Sharan Narang and Jacob Devlin and Maarten Bosma and Gaurav Mishra and Adam Roberts and Paul Barham and Hyung Won Chung and Charles Sutton and Sebastian Gehrmann and Parker Schuh and Kensen Shi and Sasha Tsvyashchenko and Joshua Maynez and Abhishek Rao and Parker Barnes and Yi Tay and Noam Shazeer and Vinodkumar Prabhakaran and Emily Reif and Nan Du and Ben Hutchinson and Reiner Pope and James Bradbury and Jacob Austin and Michael Isard and Guy Gur-Ari and Pengcheng Yin and Toju Duke and Anselm Levskaya and Sanjay Ghemawat and Sunipa Dev and Henryk Michalewski and Xavier Garcia and Vedant Misra and Kevin Robinson and Liam Fedus and Denny Zhou and Daphne Ippolito and David Luan and Hyeontaek Lim and Barret Zoph and Alexander Spiridonov and Ryan Sepassi and David Dohan and Shivani Agrawal and Mark Omernick and Andrew M. Dai and Thanumalayan Sankaranarayana Pillai and Marie Pellat and Aitor Lewkowycz and Erica Moreira and Rewon Child and Oleksandr Polozov and Katherine Lee and Zongwei Zhou and Xuezhi Wang and Brennan Saeta and Mark Diaz and Orhan Firat and Michele Catasta and Jason Wei and Kathy Meier-Hellstern and Douglas Eck and Jeff Dean and Slav Petrov and Noah Fiedel},
  year = {2022},
  eprint = {2204.02311},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2204.02311}
}
「Google が TPU チームに弁の立つクジラを雇ったばかりなんだ。異なる二つの pod の間でどうコミュニケーションをとるか、実演してみせたよ!」
このダジャレは、二つのことを知らないと笑えない。pod は TPU チップのまとまりであり、クジラの群れのことでもある。2022 年 4 月、Google は PaLM 論文の最初の図で、モデルにこのジョークを解説させた。
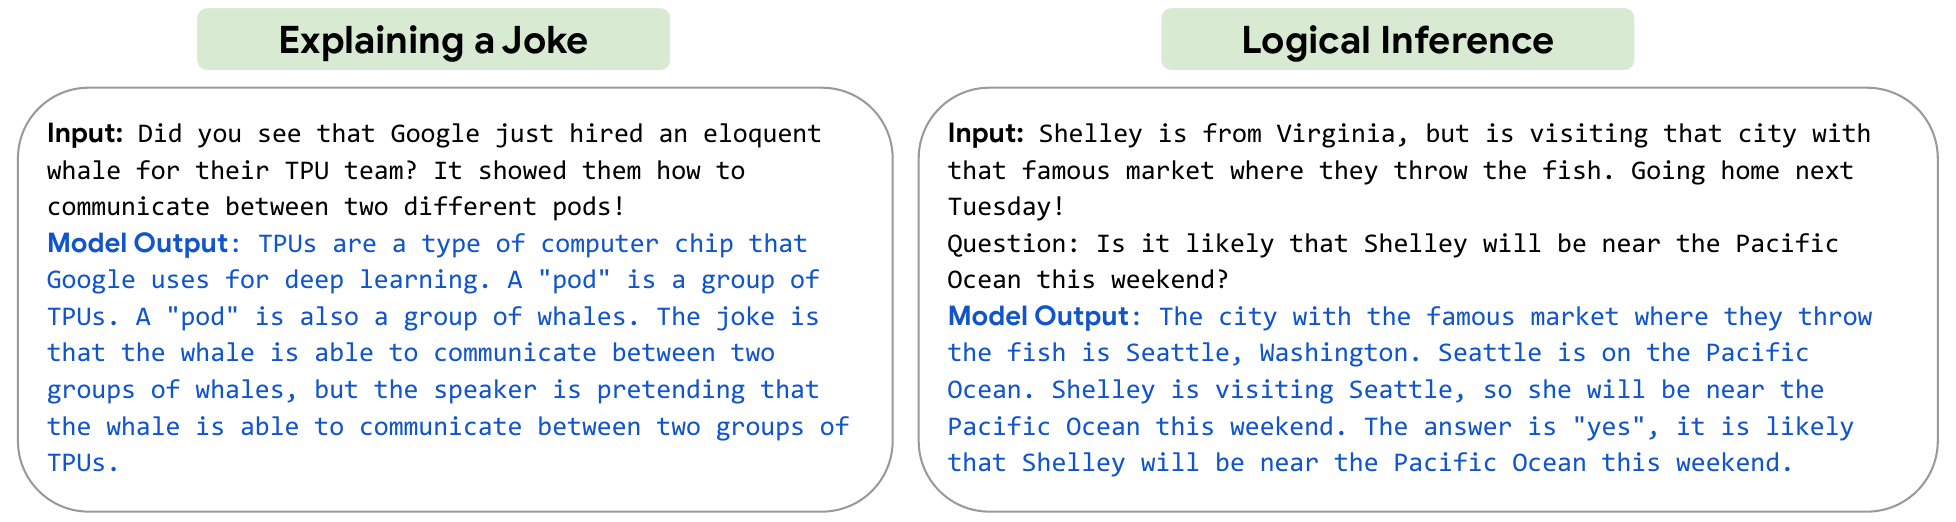
左はジョークで、モデルの答えは、クジラは二つのクジラの群れの間でコミュニケーションできる、話し手はそのクジラが二組の TPU の間でコミュニケーションできるふりをしている、というものだ。右は別の種類の問題で、モデルはまず「魚を投げる人がいる市場」がシアトルにあると見抜かないと、Shelley が週末に太平洋の近くにいるかどうかに答えられない。どちらの例も貪欲デコーディングを使い、プロンプトには説明つきの例を二つ入れている。同じ年の少し前に提案された、思考の連鎖プロンプトだ。
ジョーク自体も、この論文のことを言っている。PaLM(Pathways Language Model)は 5,400 億パラメータの密な言語モデルで、6,144 個の TPU v4 チップで訓練され、二つの TPU v4 Pod にまたがっている。それを支えているのが、Google の新しい Pathways システムだ。
ああもう、めんどくさい!こんなに説明が要るジョークなんて、ちっとも面白くない。
問題の定義
GPT-3 の後、GLaM、Gopher、Chinchilla、Megatron-Turing NLG、LaMDA が次々に少数ショット学習の成績を押し上げた。著者らはこれらの進歩を四つの方向にまとめている。
- モデルの深さと幅を大きくする。
- 訓練の token 数を増やす。
- よりきれいで、出どころの多様なデータを使う。
- 疎なモジュールで、計算量を増やさずに容量を増やす。
PaLM は主に一つ目の道を進む。すべてのパラメータが計算に加わる密なモデルを大きくして、少数ショットの能力がもう飽和しているのかを確かめるのだ。
そのためには、まず工学的な問題を片づけなければならない。当時最大の訓練規模は 4,096 個の TPU v3 だった。Megatron-Turing NLG は 2,240 枚の A100、Gopher は四つの TPU v3 Pod を使い、どちらもパイプライン並列(pipeline parallelism)で複数のマシンにまたがっていた。パイプライン並列には「バブル」の問題がある。パイプラインを満たすときと空にするときに多くのデバイスが遊んでしまい、メモリ帯域の負担も増える。著者らは、パイプライン並列を使わずに、訓練を二つの Pod へ広げたいと考えた。
問題を解く
アーキテクチャ:実用的な変更の詰め合わせ
PaLM はデコーダのみの Transformer に、いくつかの変更を加えたものだ。
- SwiGLU:フィードフォワード層の活性化関数を に変える。行列積が三つ必要になるが、Shazeer は計算量をそろえた比較で、品質が上がることを示している。
- 並列層:標準的な書き方ではアテンションを通してからフィードフォワードを通すが、PaLM は両者に同じ入力を読ませ、結果を足し合わせる。
アテンションとフィードフォワードの入力側の行列積をまとめられるので、大規模では訓練が約 15% 速くなる。著者らのアブレーションでは、8B では品質がわずかに落ち、62B では差がなかったので、540B でも影響はないと推測している。
- Multi-Query Attention:各アテンションヘッドはそれぞれ自分の query を持つが、すべてのヘッドが同じ key と value を共有する。訓練の品質と速度への影響は小さく、自己回帰デコーディングではコストを大きく節約できる。(その後、Llama 2 の 34B と 70B は、両者の中間にあたる GQA を採用した。)
- RoPE 位置エンコーディング、入出力の埋め込み共有。
- バイアスなし:すべての全結合層と LayerNorm にバイアス項を置かない。著者らは、これで大規模モデルの訓練がより安定することを見つけた。
- 256k の SentencePiece 語彙:完全に可逆で、空白をすべて保持し(コードには重要だ)、語彙にない Unicode 文字は UTF-8 のバイトに分解し、数字は必ず一桁ずつに分ける。たとえば「123.5」は「1 2 3 . 5」になる。翌年の LLaMA も同じやり方を踏襲した。
三つのサイズの構成は次のとおりだ。フィードフォワード層の幅は常に 、各アテンションヘッドは常に 256 次元である。
| モデル | 層数 | アテンションヘッド数 | パラメータ数 | バッチサイズ | |
|---|---|---|---|---|---|
| PaLM 8B | 32 | 16 | 4,096 | 86.3 億 | 256 → 512 |
| PaLM 62B | 64 | 32 | 8,192 | 625 億 | 512 → 1,024 |
| PaLM 540B | 118 | 48 | 18,432 | 5,403.5 億 | 512 → 1,024 → 2,048 |
原論文 Table 1 をもとに整理。
データ:7,800 億 token を一度だけ読む
訓練データは LaMDA と GLaM のデータをもとにした合計 7,800 億 token で、内訳は SNS の会話 50%、フィルタ済みのウェブページ 27%、英語の書籍 13%、GitHub のコード 5%、Wikipedia 4%、英語のニュース 1% だ。ウェブページは品質分類器のスコアに応じてサンプリングし、スコアが高いほど選ばれやすいが、スコアの低いページも完全には除外していない。コードは GitHub のオープンソースプロジェクトから取った。copyleft ライセンスのものを除き、よく使われる 24 言語に絞ると 196GB のソースコードになり、そこから Levenshtein 距離で重複ファイルを取り除いた。英語以外のデータは約 22% を占める。
三つのモデルはいずれも、このデータを一度しか見ていない。各出どころの比率も、どの部分も繰り返し見ることがないように調整してある。
インフラ:パイプライン並列なしで二つの Pod にまたがる
TPU v4 Pod は一つあたり 3,072 個のチップと 768 台のホストを持つ。Pod の中では、各重みテンソルを 12 分割してモデル並列にし、さらに 256 ウェイの完全シャーディングのデータ並列を行う。各 Pod がモデル全体を一つずつ持つ。
二つの Pod の間のデータ並列は Pathways に任せる。一つの Python クライアントがバッチを半分ずつ二つの Pod に送る。それぞれが順伝播と逆伝播を計算し終えたら勾配を交換し、それぞれで合算してパラメータを更新する。こうして両方の Pod で、ビット単位で同一の重みが得られる。
難しいのは Pod をまたぐネットワークだ。勾配はすべてのチップが計算を終えてから送り始めるので、1,536 台のホストが同じ瞬間に一斉にデータを送る。ホストのペアごとに 1 ステップあたり約 1.3GB の勾配を交換し、瞬間的な合計流量は 81 Tbps に達する。著者らは勾配を小さく切り分け、複数のデータセンターネットワークのリンクに分散して送った。最終的に、二つの Pod のスループットは一つの Pod の 1.95 倍になった。理論上の 2 倍に届かなかった分は、逆伝播と Pod 間の勾配転送が重なっていないことによる。
モデル FLOPs 使用率で効率を測る
著者らは、それまでよく使われてきた「ハードウェア FLOPs 使用率」(HFU)は比較に向かないと考えた。HFU は実装に左右される。たとえば再計算(rematerialization)で計算量と引き換えにメモリを節約すると、ハードウェアの FLOPs は増えるが、それは訓練が本当に求めているものではない。訓練で欲しいのは、1 秒に何 token 処理できるかだ。
そこで著者らは、モデル FLOPs 使用率(MFU)を提案した。実際の token スループットを、「ハードウェアがピーク性能で必要な計算だけを行った場合」の理論スループットで割ったものだ。必要な計算に数えるのは順伝播と逆伝播だけで、再計算は含めない。パラメータ数 のデコーダは、1 token あたり の行列演算 FLOPs(順伝播 、逆伝播 )を必要とし、アテンションでさらに が加わる。PaLM 540B の数字で一度計算してみよう。
N = 540.35e9                     # パラメータ数
L, H, Q, T = 118, 48, 256, 2048  # 層数、アテンションヘッド数、ヘッドあたりの次元、系列長
chips, peak = 6144, 275e12       # TPU v4 のチップ数、チップあたりのピーク行列演算 FLOP/s
tokens_per_sec = 238.3e3         # 実測の訓練スループット

flops_per_token = 6 * N + 12 * L * H * Q * T   # 順伝播 2N + 逆伝播 4N に、アテンションを加える
mfu = tokens_per_sec * flops_per_token / (chips * peak)
print(f"{6 * N:.3e} {12 * L * H * Q * T:.3e}")  # 3.242e+12 3.563e+10
print(f"{mfu:.1%}")                              # 46.2%
アテンションの項は の 1% 程度しかなく、大規模モデルの計算量はほとんどが重みとの行列積に費やされる。同じ計算方法で、GPT-3 は 21.3%、Gopher は 32.5%、Megatron-Turing NLG は 30.2%。PaLM の 46.2% は、並列化の戦略、XLA コンパイラの最適化、並列層から来ている。再計算の FLOPs も含めると、ハードウェア使用率は 57.8% になる。
訓練設定と損失スパイク
設定のうち、少し変わったものを挙げる。
- 最適化器は因子分解をしない Adafactor で、効果は「パラメータスケーリング」つきの Adam に近い。最初の 1 万ステップは学習率を に固定し、その後は で減衰させる。二次モーメントの係数は とした( はステップ数)。著者らは、これが 0.99 に固定するより安定することを見つけた。まれな token の埋め込みでは、短い窓で二次モーメントをうまく推定できないからだ。
- z-loss()を一項追加して、softmax の正規化項 を 0 に近づけ、安定性を高める。
- バッチサイズは訓練につれて倍にしていく。540B はまず 512 系列(約 100 万 token)で 5 万ステップまで、次に 1,024 系列で 11.5 万ステップまで、最後に 2,048 系列(約 400 万 token)で 25.5 万ステップの終了まで訓練した。初期の小さなバッチはサンプル効率がよく、後期の大きなバッチは勾配の推定がより正確で、行列も大きくなって TPU の効率が上がる。
- 事前学習では dropout を使わず、どの checkpoint から再開してもビット単位で再現できる。
勾配クリッピングをしていても、540B は訓練中に約 20 回の損失スパイクを起こした。間隔はかなり不規則で、訓練の後半に起きることもある。小さいモデルではこの問題は出なかった。著者らは原理的な解決策を見つけられず、最終的にはスパイクの約 100 ステップ前の checkpoint から再開し、スパイクの前後にあたる 200~500 個のバッチを飛ばした。
著者らは「悪いデータ」のせいかどうかも調べた。スパイク付近のバッチを、もっと前の checkpoint で訓練しても、スパイクは起きない。つまりスパイクは、特定のデータと特定のパラメータの状態が重なったときにだけ起きる。先に触れたビット単位の再現性のおかげで、この種の検証もきれいに行える。同じ checkpoint から回し直せば、結果は完全に同じになる。
議論
英語の NLP と MMLU
GPT-3 の論文で使われた 29 個の英語ベンチマークのうち、PaLM 540B の少数ショットの成績は 28 個で最高記録を更新した。比較対象は GLaM、GPT-3、Megatron-Turing NLG、Gopher、Chinchilla、LaMDA それぞれの最高成績だ。MMLU の 5-shot の平均は 69.3 で、それまでの最高は Chinchilla の 67.5。四つの大分類のうち、Chinchilla に負けたのは「その他」だけだった。
BIG-bench:人間の平均は超えたが、すべてではない
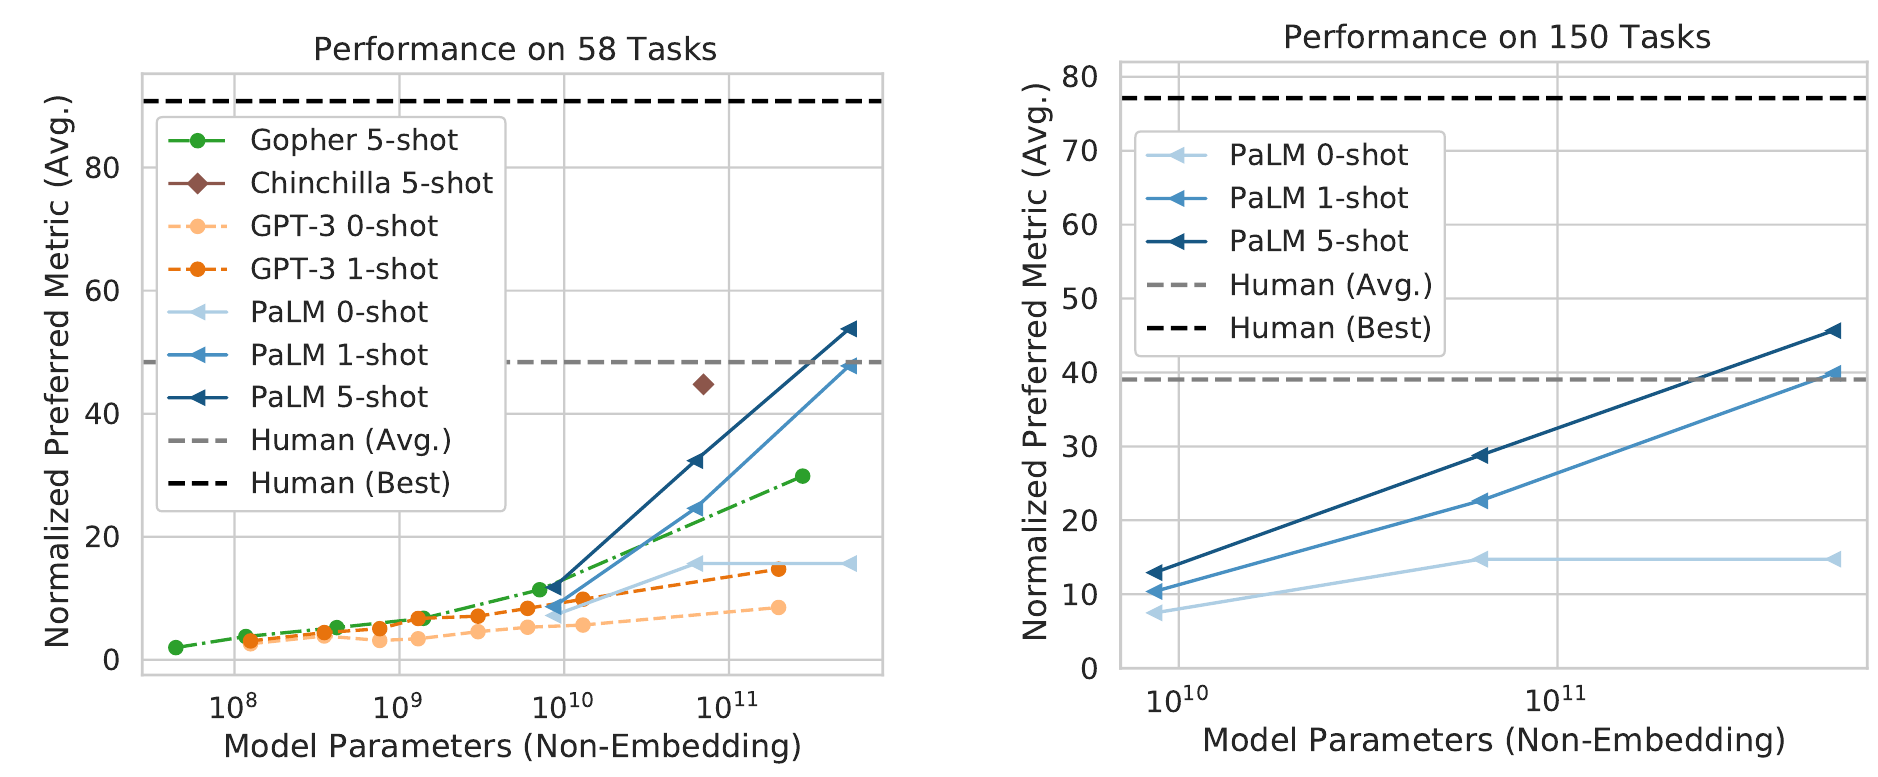
BIG-bench は、150 を超えるタスクからなる共同作成のベンチマークだ。人間のベースラインは、クラウドソーシングの作業者(通常 10 人)に同じタスク説明と例を見せて答えてもらったもので、検索エンジンや電卓など、どんな道具を使ってもよい。「人間の平均」は全員の平均、「人間の最高」は各問題で最も高い点を取ったものだ。
左図は、三つのモデル系列すべてが評価された 58 個のタスクだけを見ている。PaLM 540B の 5-shot は人間の平均を上回り、そのうち 44 個のタスクでそれまでの最高成績を超えた。PaLM の三つのサイズはほぼ一本の対数線形の直線に乗っており、著者らはそこから、さらに大きくすればもっと良くなると見ている。右図は 150 個のタスクでの PaLM の結果で、傾向は似ている。
人間の最高にはまだ遠い。タスクを一つずつ見ると、35% のタスクではまだ人間の平均が PaLM 540B に勝っている。
不連続な進歩
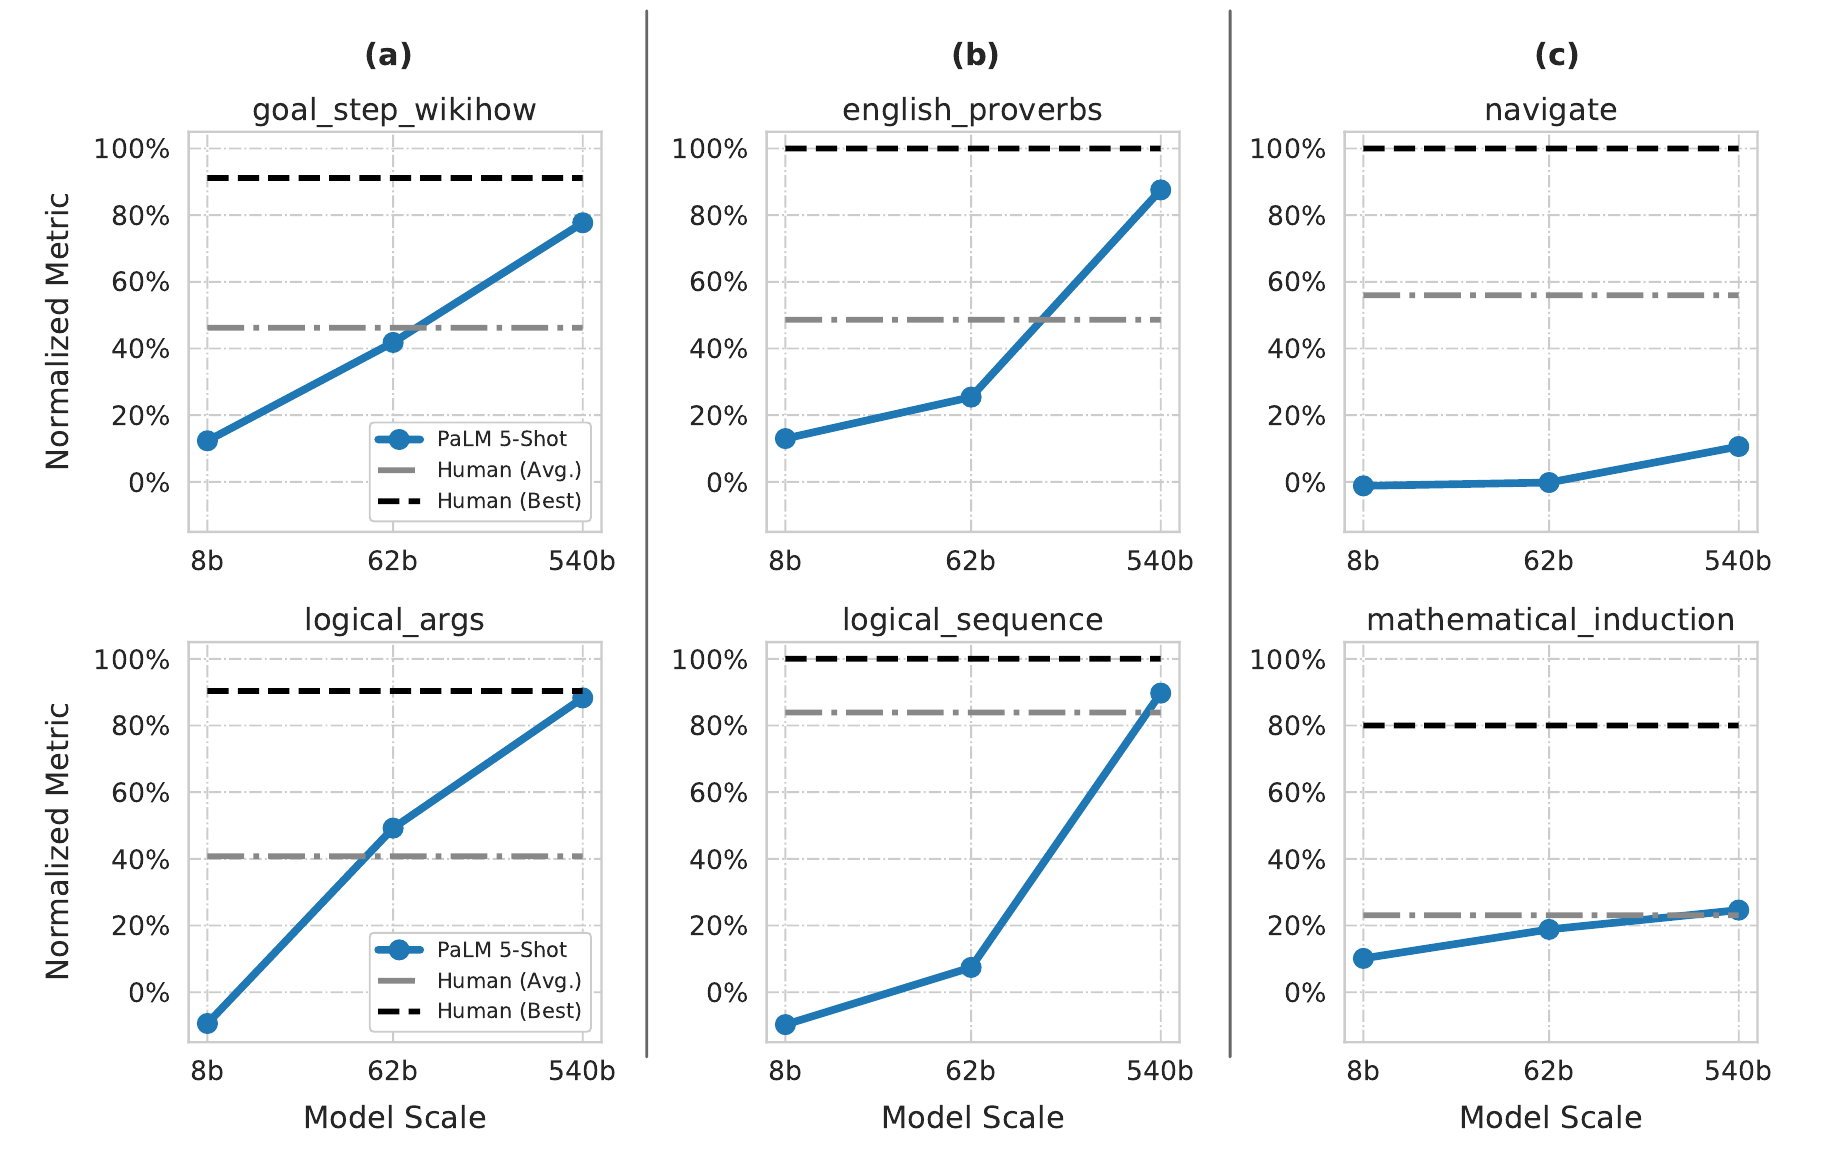
著者らは六つのタスクを選び、三種類のスケーリング曲線を示した。(a) は規模とともに着実に上がる。(c) はほとんど進歩がなく、540B は 62B よりわずかに良いだけで、人間の最高からは遠い。(b) は 8B から 62B ではわずかしか進歩しないのに、62B から 540B で突然大きく跳ぶ。
著者らは「不連続」をこう数値化している。english_proverbs を例にとると、三つのサイズのスコアは約 13%、25%、87% だ。8B から 62B でパラメータはおよそ 8 倍になり、62B から 540B もほぼ同じ倍率なので、前の区間の対数線形の傾向で外挿すれば、540B は になるはずだ。実際には 87% で、50 ポイントの差がある。150 個のタスク全体では、25% のタスクで不連続の度合いが 10 ポイントを超え、15% のタスクで 20 ポイントを超えた。
english_proverbs はことわざの裏にある比喩を理解する必要があり、著者らはそれには高い抽象的推論能力が要ると考えている。mathematical_induction は逆で、問題は現実の数学と矛盾しうる前提、たとえば「2 は奇数である」を与えたうえで、帰納的な推論が正しいかを問う。PaLM のどのサイズも、同じタスクを解いた人間も、前提が誤っている問題では苦戦した。
推論とコード
PaLM は、同じチームが少し前に提案した思考の連鎖プロンプトも使っている。8-shot に思考の連鎖と外部計算機を加えると、GSM8K は 58% に達する。
| モデルと手法 | GSM8K の正解率 |
|---|---|
| PaLM 540B、思考の連鎖 + 計算機 | 58% |
| PaLM 540B、思考の連鎖 | 54% |
| PaLM 540B、思考の連鎖なし | 17% |
| PaLM 62B、思考の連鎖 | 33% |
| GPT-3、微調整 + 思考の連鎖 + 計算機 | 34% |
| GPT-3、微調整 + 思考の連鎖 + 計算機 + 検証器 | 55% |
原論文 Table 10 をもとに整理。
それまでの 55% には、微調整と計算機に加えて、専用に訓練した検証器が必要だった。PaLM は少数ショットプロンプトだけでそれを超えた。
コードについては、PaLM 540B はコード向けの特別な訓練をしていないのに、HumanEval の pass@100 は 76.2% で、コード専用の Codex 12B(72.3%)に匹敵する。PaLM の訓練データに含まれる Python の token は約 27 億しかなく、Codex(約 1,000 億)の三十分の一にも満たない。著者らはこれを、他のプログラミング言語や自然言語からの転移と、大規模モデルのサンプル効率の高さによるものと解釈している。さらにコードで微調整した PaLM-Coder 540B は、HumanEval の pass@100 が 88.4% に達した。
記憶とバイアス
著者らは訓練データから 100 token の断片を無作為に取り出し、最初の 50 token をモデルに与えて、貪欲デコーディングで残りの 50 token を一字一句違わずに続けられるかを調べた。8B は 1.6% の断片を続けられ、540B は 2.4% で、モデルが大きいほど多く覚えている。一度しか出てこない断片では、540B の記憶率は 0.75% だが、500 回を超えて出てくる断片では 40% を超える。コードのコーパスにはライセンス条項やコピー&ペーストされたコード片が大量にあり、最も覚えられやすい。書籍のコーパスはほとんどが唯一無二の文章で、最も覚えられにくい。
バイアスの分析では、宗教に関する続きを書かせると、モデルはイスラム教をテロリズム、過激主義、暴力といった語と結びつけた。この傾向はどのサイズにも見られる。有害性については、62B と 540B の全体的な有害性が 8B よりわずかに高い。モデルが書いた続きの有害性はプロンプト自体の有害性と強く相関するが、人間が書いた続きにはそれほど強い相関はない。
著者ら自身が残した問い
論文の「スケーリングの未解決問題」の節は面白い。PaLM が主に大きくしたのはモデルのサイズだが、著者らは「モデルが大きいこと」と「より多くの token を見ること」のそれぞれの寄与を切り分けるアブレーションはしていないと認めている。そのうえで問う。同じ訓練予算で、7 兆 token を見る 62B モデルや、3.6 兆 token を見る 120B モデルを訓練したら、7,800 億 token を見た 540B と比べてどうなるのか?小さいモデルの性能が同等なら、推論コストはずっと低くなる。
DeepMind の Chinchilla は、PaLM が発表される一週間前に、ちょうど同じ問題を扱っていた。著者らは、両者で突き合わせられる結果を並べている。
| モデル | パラメータ(B) | Token(B) | 訓練 FLOPs(ZFLOPs) | 英語ベンチマーク 9 項目の平均 |
|---|---|---|---|---|
| PaLM 62B | 62 | 795 | 295.7 | 64.8 |
| Chinchilla | 70 | 1,400 | 588.0 | 65.2 |
| Gopher | 280 | 300 | 504.0 | 59.5 |
| PaLM 540B | 540 | 780 | 2,527.2 | 70.3 |
原論文 Table 21 をもとに整理。
訓練 FLOPs が Chinchilla の約半分の PaLM 62B は、Chinchilla と平均でわずか 0.4 ポイントしか違わない。Gopher ははっきり遅れている。著者らは、これが Chinchilla の結論、つまり Gopher はそのサイズにしては訓練が足りないという結論を裏づけることに同意している。ただし PaLM と Chinchilla は異なるデータを使っているので、ここから「サイズ X のモデルが Y token を見たら PaLM 540B より良くなるか」に答えることはできない、と著者らは考えている。
一年後の PaLM 2 技術報告が、その一部に答えている。Chinchilla の結論に従い、データ量とモデルサイズをおおむね 1:1 の比率で大きくした。最大の PaLM 2-L は PaLM 540B よりずっと小さいが、訓練の計算量はより多い。
結論
密なモデルを 5,400 億パラメータまで押し上げても、少数ショットの能力はまだ伸びていた。英語ベンチマーク 29 個のうち 28 個を制し、GSM8K ではプロンプトだけで微調整+検証器を超え、BIG-bench のタスクの四分の一は 62B から 540B の間で突然開眼した。
自分の訓練がどれだけ効率よく回っているか知りたいなら、MFU がそのまま使える計算方法だ。1 秒あたりの処理 token 数に を掛けて、チップのピーク性能で割れば、PaLM の 46.2% と並べて比べられる。
ただ、Chinchilla の「1 パラメータあたり約 20 token」という比率でいけば、5,400 億パラメータなら約 11 兆 token を読むべきところを、PaLM は 7,800 億しか読んでいない。クジラは賢いが、ちょっと読書が足りなかった。