原論文
Large Batch Training of Convolutional Networks
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:1708.03888
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizerslars2017,
  title = {{Large Batch Training of Convolutional Networks}},
  author = {Yang You and Igor Gitman and Boris Ginsburg},
  year = {2017},
  eprint = {1708.03888},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1708.03888}
}
2017 年 6 月、Facebook の Goyal らは 256 枚の GPU、バッチサイズ 8,192 で ImageNet の ResNet-50 を 1 時間で学習させ、しかも正解率を落とさなかった。彼らのレシピは二つのルールからなる。バッチを何倍かにしたら、学習率も同じ倍率で大きくする。最初の数エポックは小さな学習率でウォームアップする。
2 か月後、NVIDIA のインターン 2 人と NVIDIA の Boris Ginsburg が同じレシピを AlexNet に持ち込んだところ、バッチが 2K を超えた途端に学習できなくなった。わずか 8 ページのこのテクニカルレポートは、この失敗から始まる。
問題の定義
データ並列学習では、1 つのバッチを多数の GPU に分け、それぞれで勾配を計算してから平均する。GPU が増え、しかも各 GPU を目いっぱい使おうとすれば、グローバルバッチはどんどん大きくなる。エポック数を変えなければ、バッチを 倍にすると更新ステップ数は 分の 1 になる。それを取り戻すいちばん素直な方法は、学習率も 倍にすることだ。論文はこの直感を で説明している。小さいバッチで 2 歩続けて進むのは、大きいバッチで 2 倍の学習率を使って 1 歩進むのとおおよそ同じになる。ただし、2 歩目の勾配が 1 歩目とあまり変わらないことが前提だ。
この前提は学習初期に最も当てにならないので、Goyal らはウォームアップを加えた。著者らは BVLC 版の AlexNet で同じことを試し、100 エポック学習させた。
| バッチ | 学習率 | top-1(%) |
|---|---|---|
| 512 | 0.02 | 58.8 |
| 4,096 | 0.05 | 53.1 |
| 8,192 | 0.03 | 44.8 |
原論文 Table 1(a) をもとに整理。各バッチで正解率が最も高い学習率を採用、ウォームアップは 2.5 エポック。
学習率がまったく上げられない。バッチ 4K では学習率が 0.06 を超えるとウォームアップがあっても発散するので、0.05 で止めるしかない。8K では 0.03 止まりだった。線形スケーリングどおりなら、8K の学習率はバッチ 512 の 16 倍、0.32 になるはずだ。
ほかの人たちもこの壁にぶつかっていた。Hoffer らはより控えめな平方根スケーリングに切り替え、特製の Ghost BatchNorm を組み合わせたが、AlexNet はバッチ 8K で 53.93% にとどまり、小さいバッチの水準にはほど遠かった。Krizhevsky 自身が線形スケーリングを提案したときも、AlexNet は 1K までしか伸ばせず、約 1 ポイント落ちていた。
著者らはまず AlexNet の LRN 層を BatchNorm に替え、AlexNet-BN と名づけた。これだけで、ウォームアップなしでもバッチ 8K で学習率 0.3 が使えるようになり、正解率は 58.0%。バッチ 512 の 60.2% との差は 2.2 ポイントだけになった(もとは 14 ポイント差)。残りの 2.2 ポイントは、Keskar らが言う汎化ギャップなのだろうか。著者らがバッチ 256 と 8K の訓練損失とテスト損失を比べたところ、両者のギャップにはっきりした違いはなかった。そこで、問題は学習そのものがうまくいっていないこと、つまりモデルがまだ十分に学びきれていないことにあると判断した。
では、なぜ学習率を大きくできないのか。
層ごとの食欲
著者らは AlexNet-BN の 1 回目のイテレーションが終わった時点で、各層の重みのノルム と勾配のノルム を取り出して比べた。
| 層 | 比 | ||
|---|---|---|---|
| conv1 | 0.098 | 0.017 | 5.76 |
| conv2 | 0.16 | 0.002 | 83.5 |
| conv3 | 0.196 | 0.0015 | 127 |
| conv4 | 0.196 | 0.0013 | 148 |
| conv5 | 0.16 | 0.0002 | 69 |
| fc6 | 6.4 | 0.005 | 1345 |
| fc7 | 6.4 | 0.013 | 489 |
| fc8 | 0.316 | 0.016 | 19 |
原論文 Table 2 をもとに整理。重みのみを掲載し、バイアス項の比は 8.48 から 117 のあいだ。
この比は、そのまま一つの学習率として読める。1 ステップの更新の大きさが、ちょうど重みそのものの大きさに等しくなる学習率だ。学習率を 1 にすると、conv1 は 1 ステップで自分の重みの約 17%()を書き換えてしまうが、fc6 は 0.07%()しか動かない。
ネットワーク全体で一つの学習率を共有すると、最も壊れやすい層に合わせるしかない。conv1 の上限は fc6 より 200 倍以上低く、学習率を少し大きくしただけで conv1 が先に崩れる。conv1 を守るために学習率を下げれば、今度は fc6 のような層がほとんど動かない。論文は、この比が学習初期に最も高く、数エポック後には急速に下がることも観察している。ウォームアップが効くのは、小さな学習率ならどの層にとっても安全で、重みが少し大きくなってから学習率を引き上げられるからだ。
著者らは発想を変えた。層ごとに食欲が違うなら、層ごとに学習率を一つずつ与えればいい。
問題の解決
層ごとに物差しを一つ
LARS(Layer-wise Adaptive Rate Scaling)は、第 層の更新を、グローバル学習率 にその層固有の local LR を掛けたものとして書く。
は trust coefficient(信頼係数)と呼ばれ、「1 ステップのうちに、この層にどれだけの変化を許すか」を表す。論文の AlexNet の実験ではすべて を使っていて、ResNet-50 については別に記載がない。
二つの式を合わせて、更新の大きさを計算してみよう。
勾配の大きさが消えた。各層の各ステップの更新は、どれも自分の重みのノルムの 倍で、勾配が決めるのは方向だけだ。AlexNet-BN がバッチ 8K で使った を例にとると、学習率がまだ減衰していないうちは、各ステップで更新に入る量はどの層でも重みのノルムの 1.4%(モーメンタムの蓄積はまだ数えていない)で、conv1 も fc6 も同じ扱いになる。著者らはまた、更新の大きさが勾配の大きさに左右されなくなるので、勾配消失や勾配爆発の問題もある程度は和らぐと指摘している。
Adam や RMSProp のような適応的手法と比べると、LARS には違いが二つある。一つは粒度で、パラメータごとではなく層ごとに一つの学習率を持つ。論文はこのほうが安定するとしている。もう一つは基準点で、更新の幅を決めるのに重みそのものの大きさを使う。Adam が使うのは勾配の過去の統計だ。
重み減衰とモーメンタムを加える
重み減衰 があるときは、それも分母に入れる。
学習手順の全体(原論文 Algorithm 1。 には式 (6) に従って を補った)では、各ステップで各層に対して次を行う。
グローバル学習率は 2 次の多項式減衰をたどり、モーメンタムは 。順序に注意したい。trust ratio が使うのはこのステップの勾配のノルムで、スケーリングしてからモーメンタムに蓄積する。のちに LAMB の論文が LARS を整理し直したときは、モーメンタムのほうのノルムをとる形に変わっていて、両者は完全には同じでない。
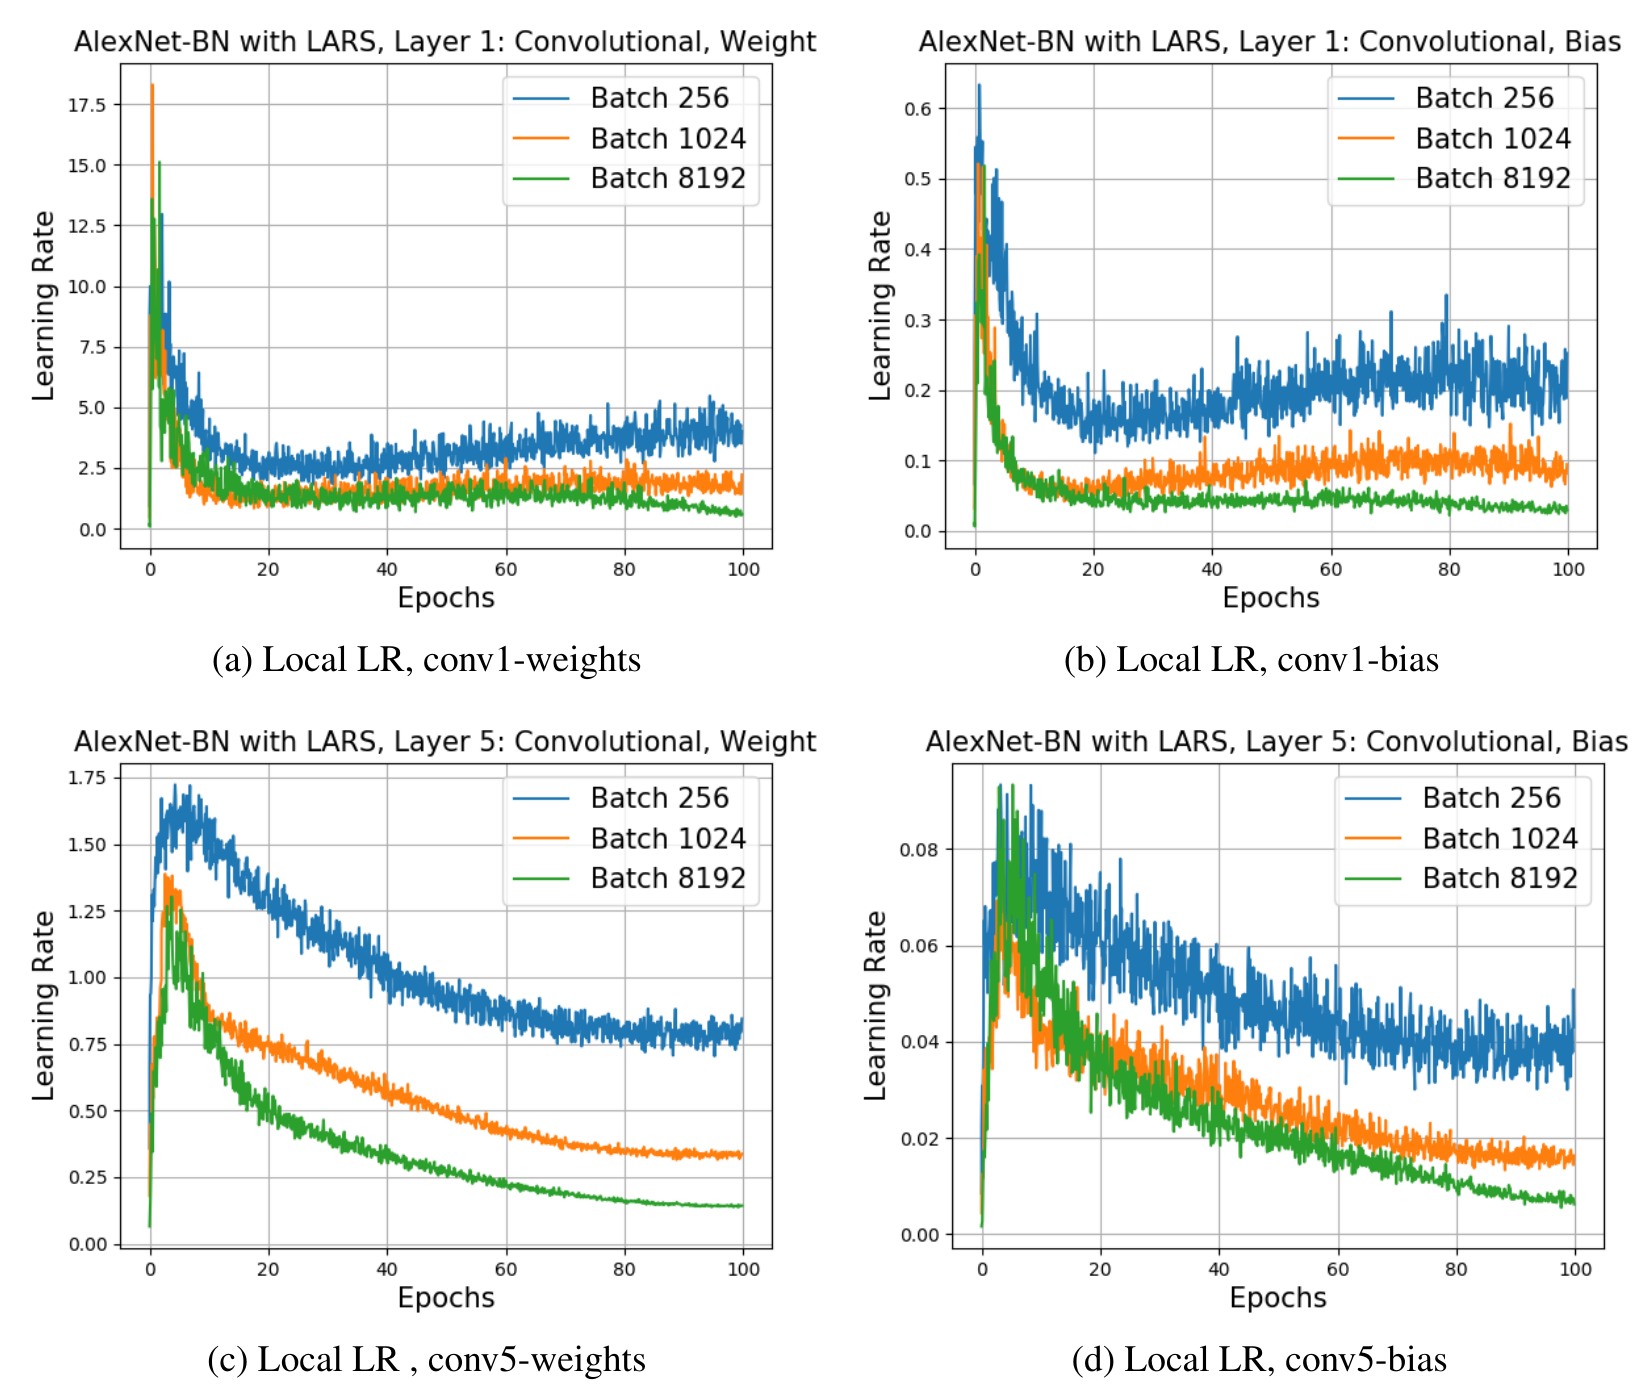
この図は、LARS が自動で計算した local LR を描いている。まず縦軸の目盛りを見ると、conv1 の重みは最大 17.5、conv5 の重みは 1.75 に届かず、二つのバイアス項はさらに小さく、最大でも 0.6 と 0.08 だ。同じネットワークの中で、各層が実際に使う学習率は 1〜2 桁も違う。次に 3 本の線を見ると、学習後期にはバッチが大きいほど曲線が低く抑えられている。これについて論文は、local LR は「層とバッチサイズに強く依存する」と述べるだけで、それ以上の説明はしていない。層によって、バッチによって、学習の進み具合によって変わるこうした学習率は、手書きのスケジュールではとても作れない。
議論
AlexNet を 32K まで
著者らは LARS で二つのネットワークを学習し直した。どちらも 100 エポックで、SGD のモーメンタム 0.9、重み減衰 0.0005、、NVIDIA DGX-1 上で実行している。バッチ 16K と 32K はメモリに収まらないので、1 つのバッチをいくつかに切り分け、勾配を蓄積してから更新することで模擬した。
| バッチ | AlexNet 学習率 | AlexNet(%) | AlexNet-BN 学習率 | AlexNet-BN(%) |
|---|---|---|---|---|
| 512 | 2 | 58.7 | 2 | 60.2 |
| 4K | 10 | 58.5 | 10 | 60.4 |
| 8K | 10 | 58.2 | 14 | 60.1 |
| 16K | 14 | 55.0 | 23 | 59.3 |
| 32K | TBD | TBD | 22 | 57.8 |
原論文 Table 3 をもとに整理。AlexNet はウォームアップ 2 エポック、AlexNet-BN はウォームアップ 5 エポック。表中の TBD は原文の記載どおり。
バッチ 8K の AlexNet は、LARS なしのときの 44.8% から 58.2% まで戻り、バッチ 512 との差は 0.5 ポイントだけになった。AlexNet-BN はさらに粘り、16K で 0.9、32K で 2.4 ポイント落ちる程度だった。
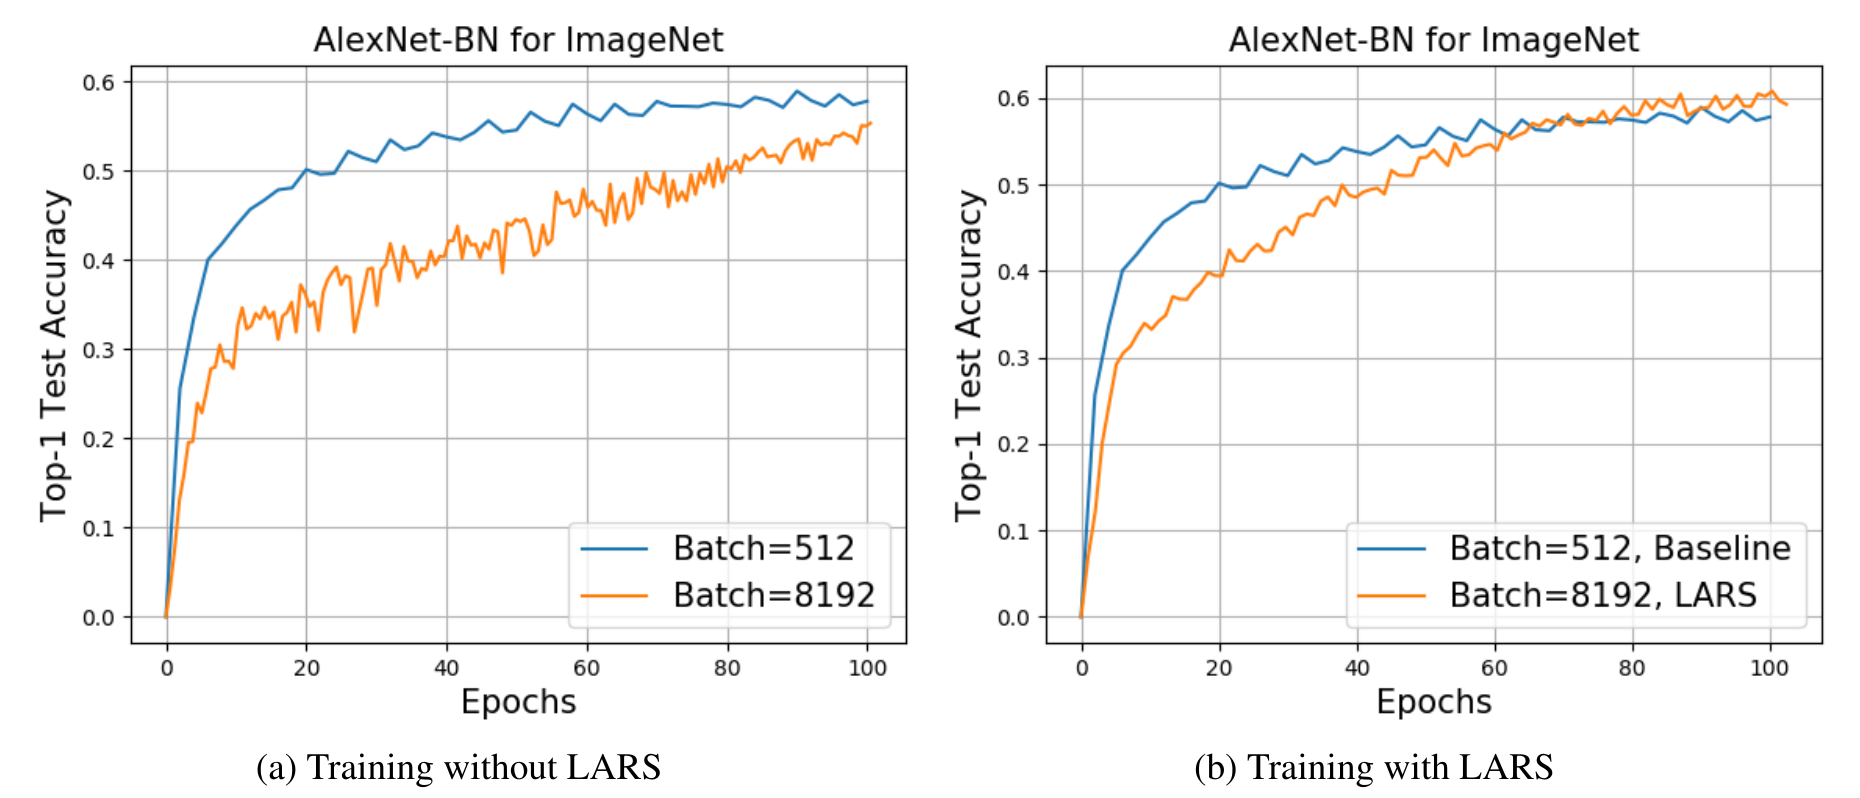
この図は、バッチ 8K での AlexNet-BN の学習過程だ。左は LARS なしで、橙線は最初から最後まで後れをとっている。右は LARS ありで、最初の 60 エポックはまだ遅れているが、その後追いついて少し上回る。大きいバッチは出だしがやはり遅いが、LARS があれば同じエポック数のうちに取り返せる。
ほかに、調整に関わる観察が二つある。一つは使える学習率の範囲が広いことで、AlexNet-BN は 16K ならベース学習率 13 から 22 のどれでも約 59.3%、32K なら 17 から 28 のどれでも約 57.5% になる。もう一つは、32K に残った差は長く学習すれば取り戻せることで、100、125、150、200 エポックでそれぞれ 57.8%、59.2%、59.5%、59.9% だった。著者らの説明では、バッチがある程度以上大きくなると確率的勾配はすでに真の勾配にかなり近く、バッチをさらに大きくしても得られる情報は増えない。ただし注意したいのは、200 エポックの 59.9% もまだ 60.2% を下回っていること、そしてエポック数を 2 倍にして学習するのは、そもそも大きいバッチで望んでいた結果ではないことだ。
ResNet-50
ResNet-50 は 90 エポック、モーメンタム 0.9、重み減衰 0.0001 で学習し、LARS に 5 エポックのウォームアップと 2 次の多項式減衰を組み合わせた。
| バッチ | グローバル学習率 | top-1(%) |
|---|---|---|
| 256(LARS なし) | 0.2 | 73.0 |
| 8K | 0.6 | 72.7 |
| 16K | 2.5 | 73.0 |
| 32K | 2.9 | 72.3 |
原論文 Table 4 をもとに整理。
32K でもベースラインより 0.7 ポイント低いだけだ。ただし、ここでのベースラインは 73% しかない。著者らはごく単純なデータ拡張(256×256 に縮小してから 224×224 をランダムに切り出し、左右反転)しかしておらず、テストも中央の切り出し 1 枚だけを使っているからだ。Goyal らのベースラインは 76.4% である。しかも論文は、ResNet-50 の大きいバッチにどんなハードウェアを使ったかを書いておらず、AlexNet の 16K、32K については勾配の蓄積で模擬したと明記している。論文全体を通して、実際に千枚規模の GPU まで広げたときの実時間(wall-clock)は示されていない。
LARS もあらゆるタスクで効くわけではない。1 年半後、同じ第一著者が Google で LARS を使って BERT を事前学習したところ、バッチ 16K で SQuAD の F1 が 89.6 に落ち、32K ではそのまま発散した。この失敗が、彼を次のオプティマイザへと導いた。
見直される LARS
LARS はその後、大きいバッチの標準装備になった。MLPerf Training の ResNet-50 部門では、closed division で使えるオプティマイザはモーメンタム SGD と LARS の 2 種類だけで、2 回の大会の優勝チームはどちらも LARS を使い、バッチはそれぞれ 32,768 と 65,536 だった。自己教師あり学習でも広く採用されていて、SimCLR は「学習を安定させるため、すべてのバッチサイズで LARS を使う」と明記しているし、BYOL もそうだ。
2021 年、Google の Nado らは〈A Large Batch Optimizer Reality Check〉で、LARS は本当に普通のオプティマイザより大きいバッチが得意なのか、と改めて問い直した。彼らの指摘によれば、LARS 論文の ResNet-50 の正解率は低めで、同じバッチでほかのオプティマイザと比べてもいない。彼らは MLPerf で最速だった LARS のパイプラインを持ってきて、オプティマイザとハイパーパラメータだけを替えて Nesterov モーメンタムを使い、バッチ 32,768、2,512 ステップ(64 エポック)の条件でそれぞれ 50 回走らせた。LARS の中央値は 75.97% で、50 回のうち 35 回が 75.9% のしきい値に達した。Nesterov の 2 通りの設定は、それぞれ 75.97%(34 回)と 75.92%(29 回)だった。
追いつくまでの道のりは楽ではなかった。彼らは、MLPerf 版の「LARS」が実は通常の重みにだけ LARS を使い、BatchNorm のパラメータとバイアス項は普通の heavy-ball モーメンタムに任せ、L2 正則化もかけていないことに気づいた。この細部は LARS 論文には書かれていないのに、どちらのオプティマイザにとっても「きわめて重要」だった。Nesterov の側も、ラベルスムージング、BatchNorm の初期化、ウォームアップ曲線の形を調整し直してようやく追いついた。訓練正解率も見ておきたい。Nesterov は 78.97%、LARS は 78.07% なのに、テスト正解率はほぼ同じだ。そこで Nado らは、LARS の層ごとの正規化はむしろ一種の正則化に近いのではないかと考えている。予算を 6,000 ステップに広げ、最も単純な cosine スケジュールに切り替えると、Nesterov は 76.7%、LARS は 76.9% で、いくつもの設定が楽に 75.9% を超えた。彼らの結論は、大きいバッチそのものはそれほど不安定ではなく、難しいのは極端に厳しいステップ数の予算の中ですべてのハイパーパラメータをきちんと調整しきることだ、というものだ。
NFNet の著者らも同じ道を通っている。NFNet の適応的勾配クリッピング(AGC)も勾配ノルムと重みノルムの比を見ていて、論文はこれを LARS のような正規化型オプティマイザを緩めた版だと位置づけている。更新の上限だけを制限し、勾配の大きさを完全には捨てない。彼らは LARS をそのまま使うことも試し、大きいバッチでも同じように安定して学習できたが、正解率は悪くなった。
結論
LARS の貢献は、一つの表と一行の式だ。表は AlexNet-BN の各層の が 200 倍以上も違うことを示し、式は各層の更新を自分の重みの一定割合に固定する。これによって AlexNet はバッチ 8K で 44.8% から 58.2% に戻り、ResNet-50 は 32K でも 0.7 ポイント落ちるだけで済んだ。一方で、普通のオプティマイザでは届かないことまでは示しておらず、3 年あまり後には Nado らが Nesterov を使い、同じステップ数で追いついている。
LARS を自分で実装するなら、BatchNorm のパラメータとバイアス項は trust ratio と重み減衰の対象から外すこと。MLPerf も、その後の自己教師あり学習の実装もそうしている。ほかのオプティマイザと比べるときも、同じステップ数で、モーメンタム SGD をきちんと一組調整してから比べてほしい。
Table 3 の AlexNet 32K の二つの TBD は、v3 で確定稿になってもそのまま残り、ついに埋まることはなかった。