原論文
Scaling Instruction-Finetuned Language Models
- arXiv への初回投稿
- arXiv:2210.11416
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modeltuningflant52022,
  title = {{Scaling Instruction-Finetuned Language Models}},
  author = {Hyung Won Chung and Le Hou and Shayne Longpre and Barret Zoph and Yi Tay and William Fedus and Yunxuan Li and Xuezhi Wang and Mostafa Dehghani and Siddhartha Brahma and Albert Webson and Shixiang Shane Gu and Zhuyun Dai and Mirac Suzgun and Xinyun Chen and Aakanksha Chowdhery and Alex Castro-Ros and Marie Pellat and Kevin Robinson and Dasha Valter and Sharan Narang and Gaurav Mishra and Adams Yu and Vincent Zhao and Yanping Huang and Andrew Dai and Hongkun Yu and Slav Petrov and Ed H. Chi and Jeff Dean and Jacob Devlin and Adam Roberts and Denny Zhou and Quoc V. Le and Jason Wei},
  year = {2022},
  eprint = {2210.11416},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2210.11416}
}
FLAN は 2021 年に、数十種類の NLP データセットを指示の形に書き直して言語モデルを微調整すると、モデルが見たことのないタスクをこなしやすくなることを見つけた。ほぼ同じころ、T0 と InstructGPT もそれぞれ指示データでモデルを微調整し、どちらも良い結果を出している。
次の問いは自然に出てくる。問題をもっと増やし、モデルをもっと大きくしたら、さらに良くなるのか?
Google の Chung らはこの論文で、その両方を当時の限界まで押し広げた。タスクは FLAN の 62 種類から 1,836 種類に増え、モデルは最大で 5,400 億パラメータの PaLM を使い、さらに思考の連鎖(chain-of-thought、CoT)のデータも加えた。こうしてできたモデルが Flan-PaLM だ。同じ手順で 8,000 万から 110 億パラメータの T5 も微調整して重みを公開した。これが、のちに多くの人が使った Flan-T5 である。
問題の定義
それまでの指示チューニングの研究は、それぞれ一つの方向にしか規模を広げていなかった。FLAN は 137B のモデルを使ったが、タスクは 62 種類だけ。Natural Instructions v2 は 1,600 種類以上のタスクを集めたが、モデルは最大でも 11B だった。両方を同時に大きくしたらどうなるか、試した人はいなかった。
もう一つの問題はもっと厄介だ。先行研究の指示データはほぼすべて「答えをそのまま出す」形式だったが、PaLM が出たその年に最も注目を集めた能力の一つは、推論のステップを書いてから答える思考の連鎖だった。答えをそのまま出す問題ばかりで微調整したら、モデルは一歩ずつ推論するやり方を忘れてしまわないだろうか?
だからこの論文は、三つの問いに答えようとしている。
- タスク数とモデルサイズを一緒に大きくすると、効果はどう変わるか?
- 指示チューニングは思考の連鎖による推論を損なうか? 損なうなら、どう補うか?
- このやり方は、別のアーキテクチャや別のサイズに移しても効くか?
問題を解く
1,836 種類のタスク
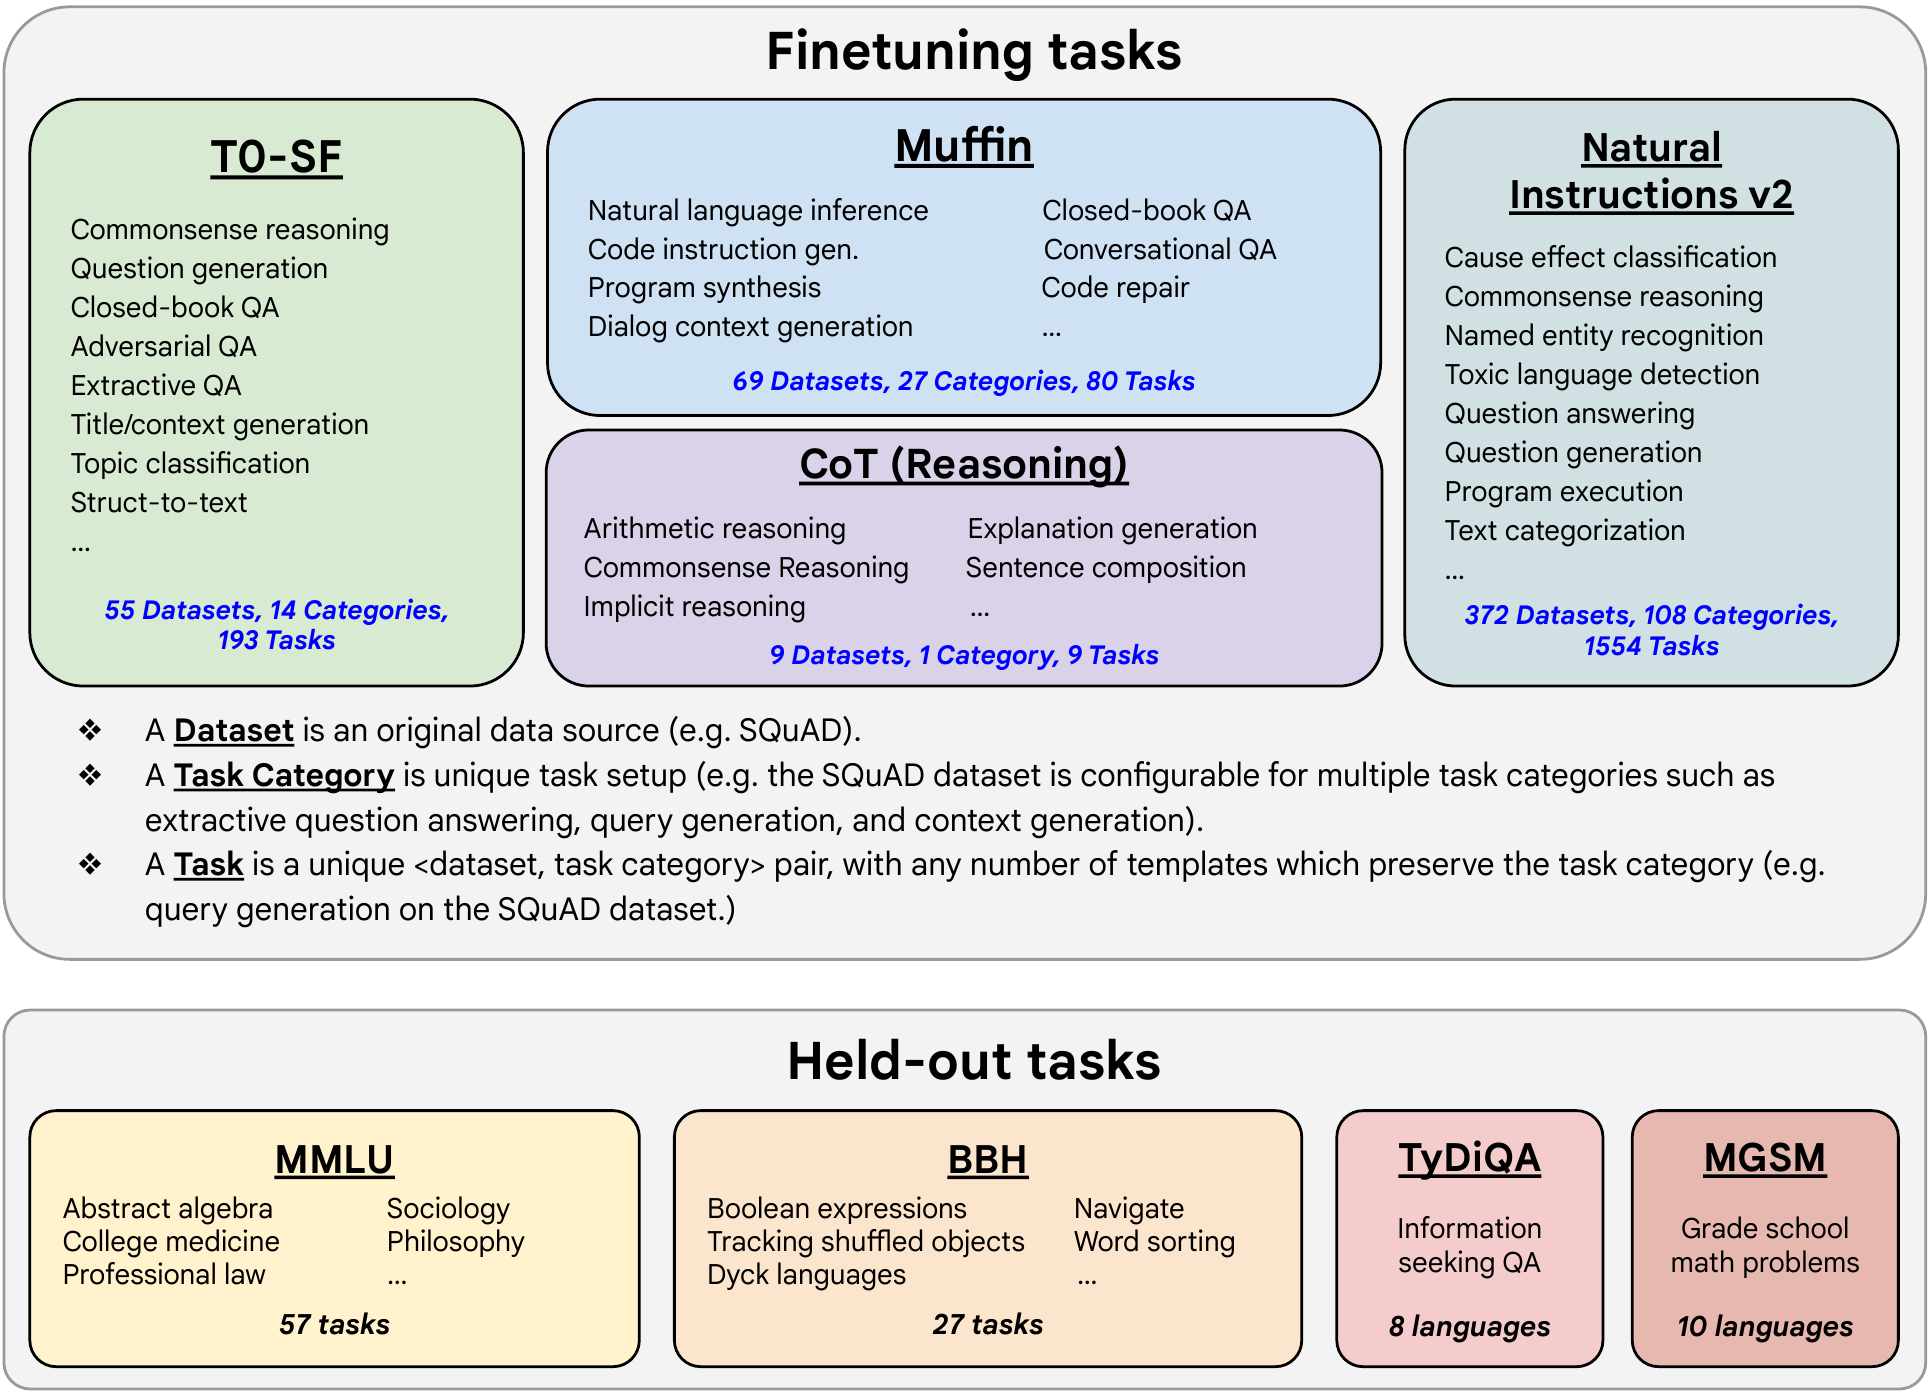
まず、図に出てくる三つの単位を区別しておこう。データセットは元のデータの出どころで、たとえば SQuAD だ。タスクカテゴリは問題の型で、同じ SQuAD を抽出型の質問応答にも、問題作成にも、文脈の生成にも使える。タスクは「データセット × タスクカテゴリ」の組み合わせ一つのことで、たとえば「SQuAD で問題を作る」がそれにあたる。
四つのデータ群には、それぞれ出どころがある。
- Muffin(80 種類):FLAN の元のタスクを中心に、この論文で新たに加えた対話やコード生成などのタスクを足したもの。
- T0-SF(193 種類):T0 のタスクのうち Muffin と重ならない部分。SF は「sans Flan」、つまり Flan 抜きという意味だ。
- NIV2(1,554 種類):Natural Instructions v2。MMLU は評価に使うので、著者らは先に MMLU に関係する 44 種類のタスクを削除した。
- CoT(9 種類):推論過程が人手で書かれている九つのデータセット。たとえば算術推論の GSM8K、多段推論の StrategyQA などで、著者らはデータセットごとに約十個の指示テンプレートを書いた。
合わせると 473 データセット、146 カテゴリ、1,836 タスクになる。
さらに各問題は、例があるかないか、推論過程を書くか書かないかを組み合わせた、さまざまな形式で出てくる。論文の例で言うと次のとおり。
[例なし、推論を書かない]
Answer the following yes/no question. Can you write a whole Haiku in a single tweet?
→ yes

[例あり、推論を書く]
Q: Answer the following yes/no question by reasoning step-by-step. Could a dandelion suffer from hepatitis?
A: Hepatitis only affects organisms with livers. Dandelions don't have a liver. The answer is no.
Q: Answer the following yes/no question by reasoning step-by-step. Can you write a whole Haiku in a single tweet?
A: A haiku is a japanese three-line poem. That is short enough to fit in 280 characters. The answer is yes.
「推論を書く」形式を使うのは、あの九つの CoT データセットだけだ。
微調整そのものは安い
どのモデルも同じ手順を使い、調整するのは学習率、バッチサイズ、dropout、ステップ数だけだ。最適化器は Adafactor で、学習率は減衰させずに一定。短いサンプルは複数を一本の系列に詰め込み、マスクでサンプル間の注意を遮る。
事前学習と比べると、指示チューニングにかかる計算量は微々たるものだ。Flan-PaLM 540B の微調整は事前学習の計算量の 0.2% しか使っておらず、おおよそ TPU v4 を 512 個使って 37 時間だ。Flan-T5 の各サイズは 0.2% から 1.6% の間に収まる。
どう試験するか
評価には、微調整データに含まれていない問題だけを使う。
- MMLU:数学、歴史、法律、医学などを含む 57 科目の試験問題。5-shot。
- BBH:BIG-Bench のうち、PaLM がまだ平均的な人間の評価者に勝てない難しい 23 タスク。3-shot。
- TyDiQA:8 言語の質問応答。1-shot。
- MGSM:GSM8K の数学の文章題を人手で 10 言語に翻訳したもの。8-shot。
GPT-3 論文で使われた一連の評価は、著者らはあえて使っていない。それらのタスクの訓練セットは、ほぼすべて微調整データにすでに入っているからだ。
MMLU と BBH はそれぞれ二回ずつ試す。一回は直接答えさせ、もう一回は思考の連鎖を書いてから答えさせる。六つのスコアをさらに一つの「正規化平均」にまとめる。正規化とは、当てずっぽうで答えたときのスコアをゼロ点とし、残りの範囲を 0 から 100 に引き伸ばすことだ。たとえば二択の問題なら当てずっぽうでも 50% 取れるので、55% 正解すると と数え、45% なら −10% になる。
議論
問題は多いほど良いが、効くのは最初の 282 種類
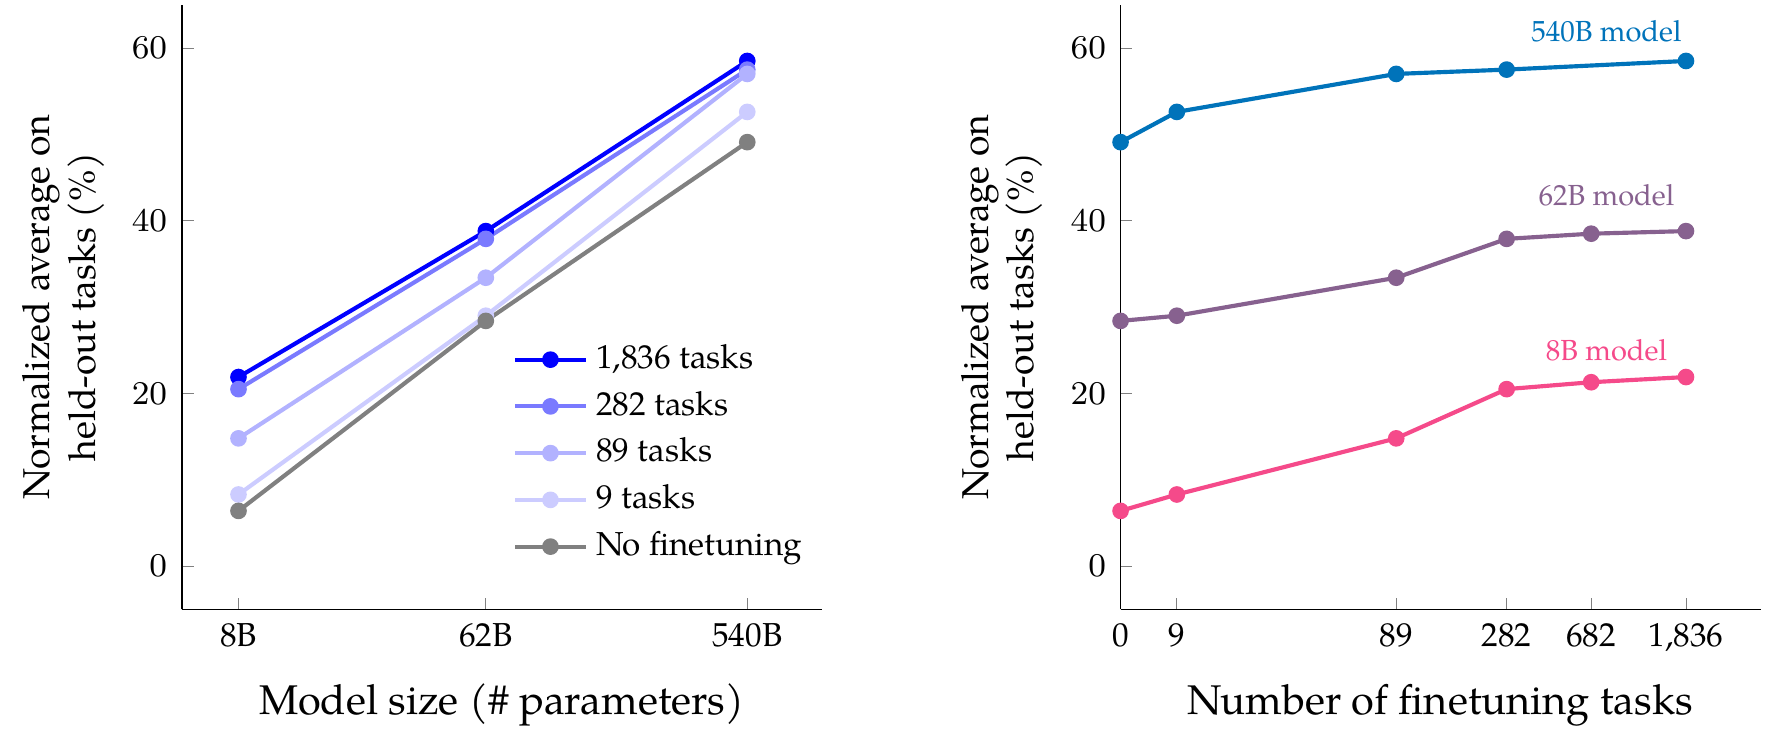
左図はモデルサイズを見るものだ。灰色線は微調整なし、ほかの線は異なる数のタスクを加えたもの。三つのサイズのどれでも、指示チューニングは正規化平均を 9.4 から 15.5 ポイント引き上げた。モデルを約十倍にするたびに、微調整の有無にかかわらず、スコアははっきり上がる。
右図はタスク数を見るものだ。タスクは CoT、Muffin、T0-SF、NIV2 の順に一群ずつ加えていき、0 から 282 種類まで増やす間に曲線が最も急に上がる。その後 1,836 種類まで増やしても、伸びはごくわずかだ。
著者らは二つの説明を挙げている。一つは、後から加えたタスクの多様性が足りず、モデルに新しいことを教えていないというもの。もう一つは、指示チューニングの効果は主に、モデルに「事前学習ですでに知っていることを口に出す」ことを覚えさせる点にあり、これはある程度学べば飽和する、というものだ。二つ目の説明は数字とつじつまが合う。PaLM は事前学習で 7,800 億 token を読んだが、指示チューニングに使ったのは 14 億 token、約 0.2% にすぎない。
小さいモデルと大きいモデルのどちらがより得をするのかについても、著者らは結論を出していない。絶対的なスコアで見ると、8B は 15.5、540B は 9.4 上がった。誤り率が減った割合で見ると、540B は 18.4%、8B は 16.6% だ。同じ数字でも、計算の仕方を変えると結論が逆になる。
思考の連鎖を練習しないと、推論のやり方を忘れる
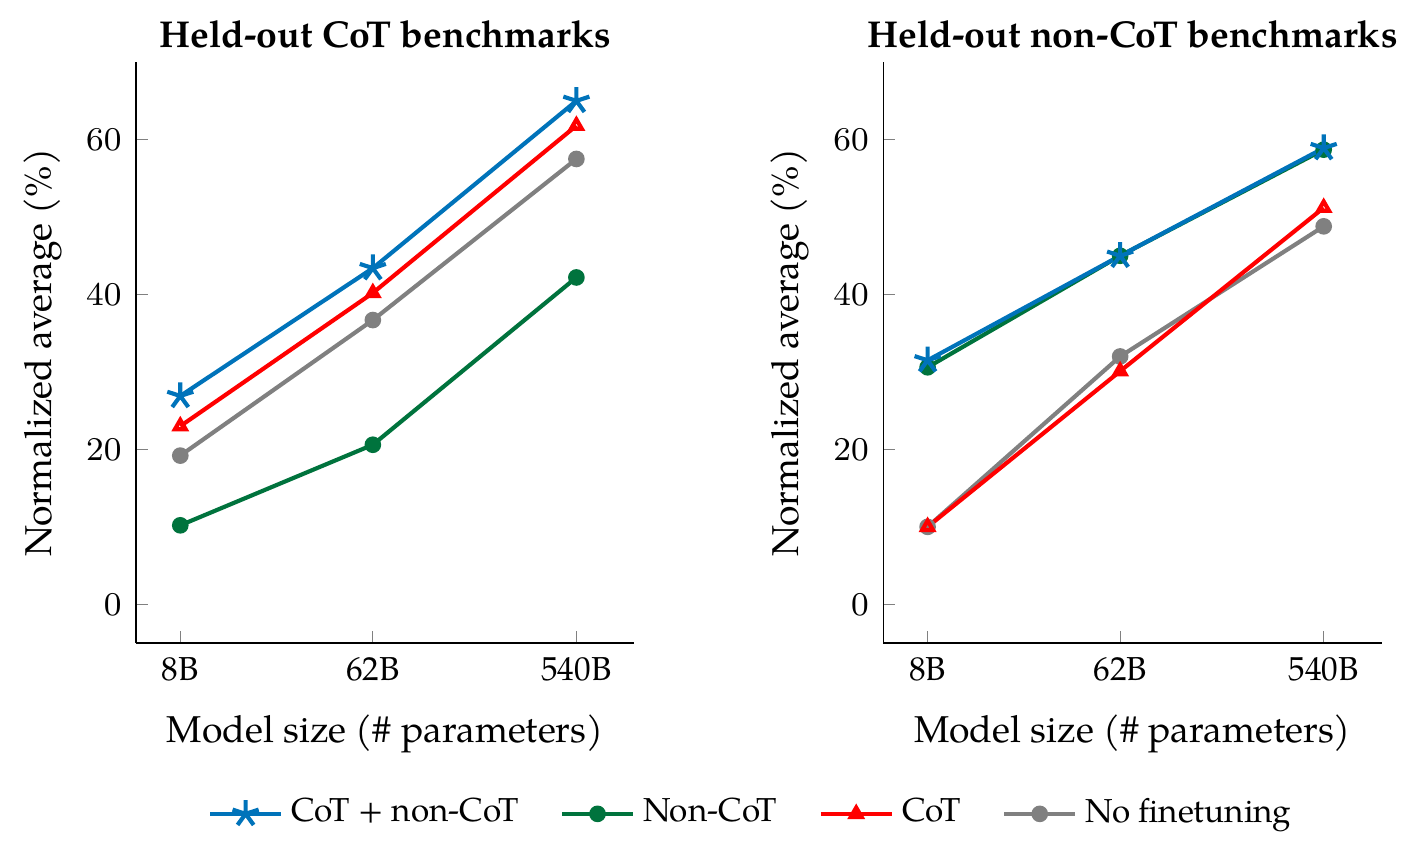
この図は論文全体でいちばん見る価値がある。左図の緑線を見てほしい。答えをそのまま出すデータだけで微調整すると、思考の連鎖が必要な評価では、まったく微調整しない場合よりかえって悪くなる。540B では 57 前後から 42 前後に落ちている。
これは先行研究と矛盾しているように見える。FLAN も T0 も、指示チューニングは見たことのないタスクに役立つと言っていた。著者らの説明では、以前の評価は「見たことのない NLP タスク」しか見ておらず、たとえば感情分析を訓練から外しておいて感情分析を試す、といったものだった。しかも以前のモデルは小さすぎて、そもそも思考の連鎖がうまくできなかった。言い換えると、指示チューニングが役に立つのは、微調整のときと同じプロンプト形式の新しいタスクだ。微調整で直接答える練習しかしていなければ、思考の連鎖で試されたときに損をする。
解決に必要なのは、九つの CoT データセットだけだ。青線は二種類のデータを一緒に微調整したもので、左図では四本の線の中で最も高い。右図では、青線と非 CoT データだけの緑線がほぼ重なっており、思考の連鎖のデータを加えても、直接答える問題の足は引っぱっていない。
この九つのデータセットには副次的な効果もある。微調整のとき、CoT データの一部は例なしで与えるので、Flan-PaLM はゼロショットの思考の連鎖を身につけた。問題の後ろに「Let's think step by step」と一言加えるだけで、BBH のスコアが上がる。微調整していない PaLM では、この一言を加えても効果がない。Kojima らが以前に行ったゼロショットの思考の連鎖の実験では、成功例の多くが InstructGPT を使っていた。著者らは、InstructGPT の微調整データにもともと思考の連鎖に似たものが含まれていたからだろうと推測している。
主な成績
三つをまとめて得られたのが Flan-PaLM 540B だ。MMLU では思考の連鎖に自己一貫性(何度もサンプリングして多数決を取る)を組み合わせて 75.2% に達し、PaLM の 69.3%、code-davinci-002 の 68.3%、Chinchilla の 67.6% をいずれも上回った。多言語の数学問題 MGSM では 72.0% で、ベンガル語でさえ 69.6% ある。GSM8K は 83.9% だが、GSM8K の訓練セットは微調整データに入っている。
勝てなかったところもある。BBH のうち記号操作だけを問うアルゴリズム系のタスク、たとえばシャッフルされた物を順に追跡する、単語をアルファベット順に並べる、といったものでは、Flan-PaLM はまだ code-davinci-002 に負ける。TyDiQA は PaLM より 14.9 ポイント高いものの、TyDiQA の訓練セットで直接微調整した ByT5 にはまだ及ばない。
別のモデルでも効く
著者らは同じ手順を、アーキテクチャ、サイズ、事前学習の目的関数が異なるモデルに当てはめた。以下に何行か抜粋する。
| モデル | 正規化平均 | MMLU 直接 | MMLU CoT | BBH 直接 | BBH CoT |
|---|---|---|---|---|---|
| T5-XL(3B) | −4.1 | 25.7 | 14.5 | 27.4 | 19.2 |
| Flan-T5-XL(3B) | 19.1 | 52.4 | 45.5 | 41.0 | 35.2 |
| T5-XXL(11B) | −2.9 | 25.9 | 18.7 | 29.5 | 19.3 |
| Flan-T5-XXL(11B) | 23.7 | 55.1 | 48.6 | 45.3 | 41.4 |
| PaLM 62B | 28.4 | 55.1 | 49.0 | 37.4 | 43.0 |
| PaLM 540B | 49.1 | 71.3 | 62.9 | 49.1 | 63.7 |
| Flan-PaLM 540B | 58.4 | 73.5 | 70.9 | 57.9 | 66.3 |
原論文 Table 5 をもとに整理。一部の行と列を抜粋。
最も得をしたのは T5 だ。微調整していない T5(ここで使っているのは、言語モデルの目的関数で追加訓練した LM-adapted 版)は、これらの難しい評価ではほとんど当てずっぽうと変わらず、MMLU の思考の連鎖はわずか 14.5% と、四択のランダムな推測よりも低い。だから正規化平均がマイナスになる。微調整すると、3B の Flan-T5-XL は MMLU で 52.4% を取り、GPT-3 175B の 43.9% を上回る。11B の Flan-T5-XXL も BBH の直接回答で PaLM 62B に勝っていて、表では 45.3 対 37.4 だ。
論文全体で最も強いモデルは Flan-U-PaLM で、PaLM 540B を UL2 の目的関数でさらに事前学習してから、指示チューニングを施したものだ。著者らの結論は、この二つの方法は重ねがけでき、どちらもモデルを大きくする必要がない、というものだ。
使いやすくなる
スコアのほかに、著者らは PaLM 540B と Flan-PaLM 540B の自由回答を人に比べてもらった。評価セットは 190 問で、創造性、推論、計画、説明などのカテゴリにわたり、ゼロショットも少数ショットもある。結果は、79% の場合に Flan-PaLM のほうが好まれた。問題に「一歩ずつ考えよう」と加えると、好みの差はさらに約 10% 広がった。
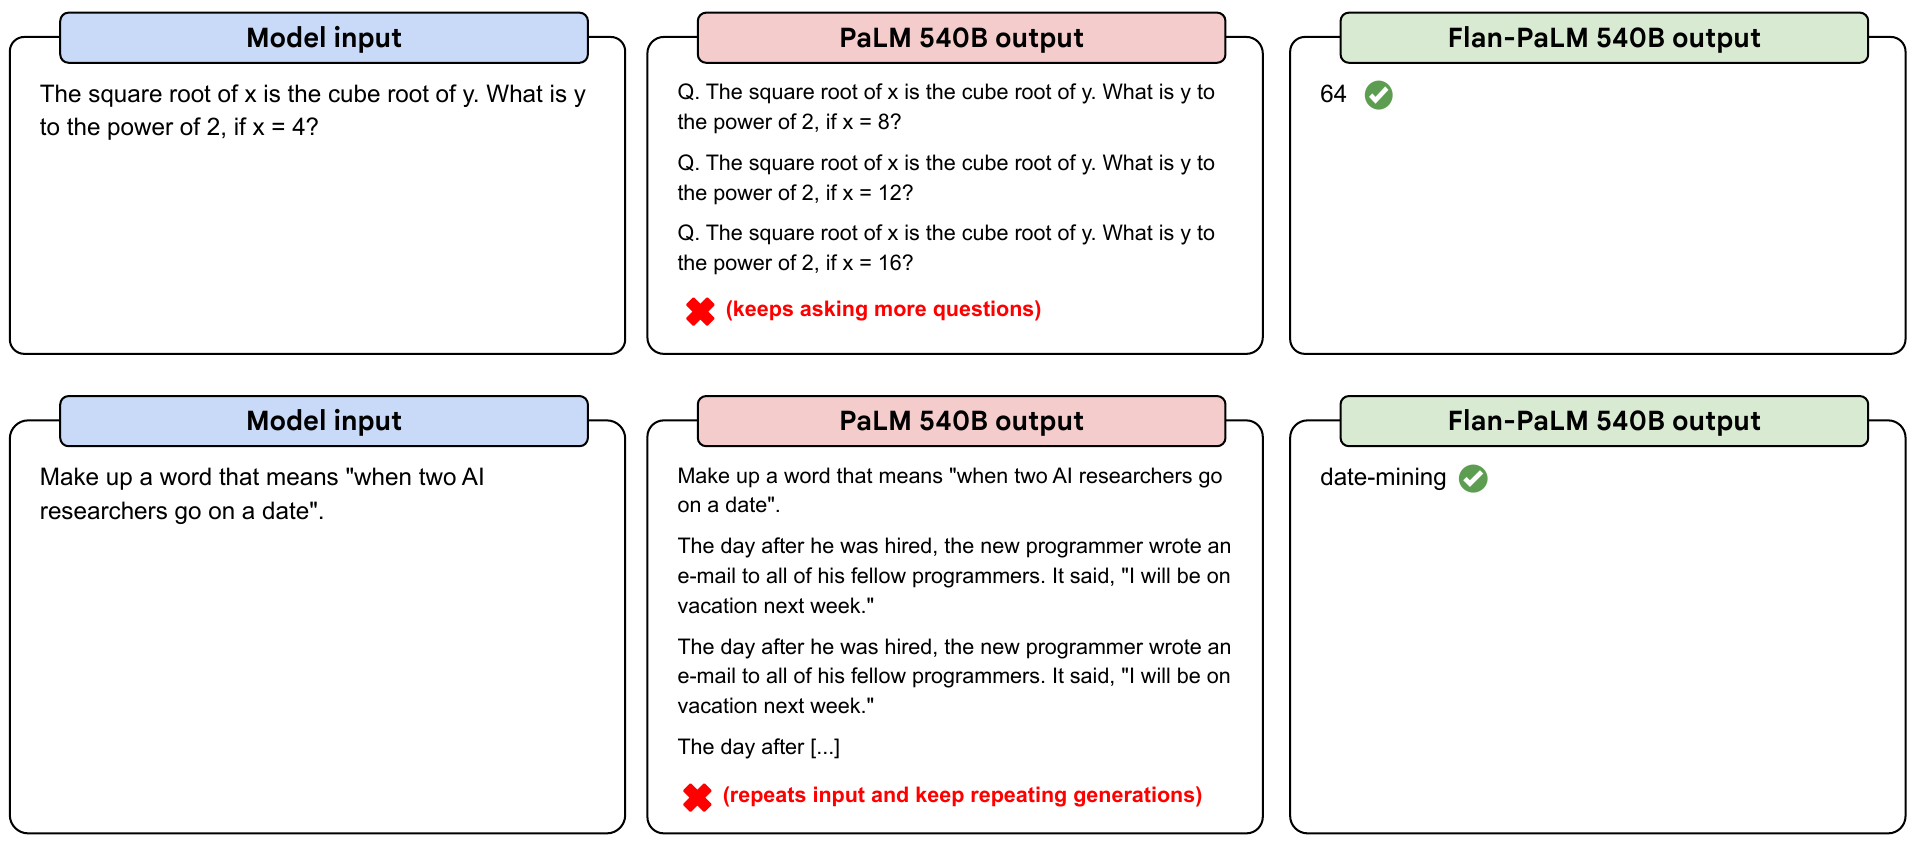
1 問目は なので、、 だ。PaLM は答えずに、この問題を試験用紙の冒頭だと思って、次から次へと問題を出し続ける。2 問目では、まず問題文を書き写し、それから問題と関係のない同じ物語を延々と繰り返す。
著者らは PaLM のゼロショット出力に三つの悪い癖を見つけた。答えずに関連する文章を書き続ける、問題を少しだけ変えて繰り返す、そしていつ止めればいいかわからない。著者らは、事前学習で系列終端記号を使っていなかったことが関係していると推測している。指示チューニングによって、モデルは答え終えたら止まることを覚える。これはプロンプトエンジニアリングなどしない一般のユーザーにとって、特に大事なことだ。
その後
論文は最後の一文で、ほぼすべての事前学習済み言語モデルに指示チューニングを施すべきだと勧めている。その後の流れはおおむねこの言葉どおりに進み、モデルを公開するときにベース版と指示チューニング版を同時に出すのが、ほとんど慣例になった。四か月後の LLaMA もこの論文の手順に従って 65B に簡単な指示チューニングを施し、MMLU は 63.4% から 68.9% に上がった。
Google は 2023 年初め、タスクとテンプレート一式を The Flan Collection としてまとめて公開した。ただ数か月後には、風向きも変わってきた。LIMA は、厳選した 1,000 件の質疑応答だけで LLaMA 65B を微調整し、かなり良い回答を書けるようにした。人々は、タスクの数だけでなく、指示データの品質や出どころ、たとえば実際のユーザーの質問かどうかを、より気にするようになった。
結論
この論文は、指示チューニングの三つの方向を一緒に押し広げた。タスクを 1,836 種類まで増やしたが、効果は主に最初の 282 種類に集中している。モデルを十倍にしても、効果ははっきり残る。思考の連鎖のデータは九つのデータセットだけで、直接回答の訓練による推論の後退を取り戻せる。その代償は、事前学習の計算量の 0.2% から 1.6% にすぎない。
いちばん実用的な教訓は、微調整データがどんな形をしているかで、モデルが得意な形式が決まるということだ。直接回答のデータだけで微調整すると、540B は思考の連鎖が必要な評価で、正規化平均が微調整なしの約 57 から約 42 にかえって下がる。九つの思考の連鎖データセットを加えてはじめて、この損を避けられる。
多くの人にとって、この論文が残したのはあの Flan-T5 の重みだ。PaLM は最後まで公開されなかったので、Flan-PaLM のスコアがいくら見事でも、論文の中で眺めるしかない。