Article original
Muon is Scalable for LLM Training
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:2502.16982
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizersmuonscalable2025,
  title = {{Muon is Scalable for LLM Training}},
  author = {Jingyuan Liu and Jianlin Su and Xingcheng Yao and Zhejun Jiang and Guokun Lai and Yulun Du and Yidao Qin and Weixin Xu and Enzhe Lu and Junjie Yan and Yanru Chen and Huabin Zheng and Yibo Liu and Shaowei Liu and Bohong Yin and Weiran He and Han Zhu and Yuzhi Wang and Jianzhou Wang and Mengnan Dong and Zheng Zhang and Yongsheng Kang and Hao Zhang and Xinran Xu and Yutao Zhang and Yuxin Wu and Xinyu Zhou and Zhilin Yang},
  year = {2025},
  eprint = {2502.16982},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2502.16982}
}
Muon s'est fait un nom dans une compétition.
Le NanoGPT speedrun est une compétition publique que Keller Jordan maintient sur GitHub. La règle consiste à entraîner, sur 8 H100, un modèle de langage jusqu'à une perte de 3.28 sur l'ensemble de validation de FineWeb, le plus vite possible ; 3.28 est le score obtenu par Andrej Karpathy en reproduisant GPT-2 small. Le 15 octobre 2024, Jordan remplace AdamW par Muon, un optimiseur de sa conception, et l'entraînement gagne d'un coup 35 % de vitesse, un nouveau record. Dans les deux mois suivants, 7 chercheurs établissent encore 12 nouveaux records, tous avec Muon.
En décembre 2024, Jordan publie un billet de blog qui présente la conception de Muon. Il le termine par trois questions auxquelles il ne sait pas lui-même répondre. Muon passe-t-il à l'échelle au-delà de 20 milliards de paramètres et d'un billion de tokens ? Les itérations de Newton–Schulz peuvent-elles être réparties sur de grands clusters de GPU ? Muon ne vaut-il que pour le préentraînement, et échoue-t-il en affinage ou en apprentissage par renforcement ?
Deux mois plus tard, Moonshot AI (le développeur de Kimi) publie ce rapport technique, qui répond aux deux premières questions et en partie à la troisième. L'équipe entraîne à partir de zéro avec Muon un modèle MoE de 3 milliards de paramètres activés et 16 milliards au total, sur 5.7 billions de tokens, baptisé Moonlight.
Muon n'a pas d'article à lui. Cette note commence donc par expliquer Muon à partir du billet de Jordan, puis examine les deux ajouts de Moonshot AI pour passer à l'échelle, et enfin ce qu'est devenue, une fois vérifiée par d'autres, l'affirmation d'une « efficacité de calcul environ 2 fois supérieure ».
Définir le problème
Ce qu'est Muon
La définition de Jordan tient en quatre lignes (Algorithm 2 du billet) :
Les deux premières lignes sont simplement SGD avec momentum. La différence est à la troisième ligne, où Muon « orthogonalise » la matrice de momentum avant de s'en servir pour la mise à jour. Si la décomposition en valeurs singulières de est , l'orthogonalisation la remplace par , en gardant les directions (, ) et en mettant toutes les valeurs singulières à 1. NewtonSchulz5 est la routine qui approxime cette opération en cinq étapes de multiplications matricielles ; nous la décortiquerons plus loin.
Cette opération n'a de sens que pour des matrices ; Muon ne s'applique donc qu'aux poids 2D des couches cachées, comme les projections d'attention et les couches feed-forward d'un Transformer. Les paramètres scalaires et vectoriels (gains de LayerNorm, biais), ainsi que la couche d'embedding et la tête de classification finale, pourtant 2D, sont confiés à AdamW. Les noyaux de convolution, eux, sont aplatis en matrices en fusionnant leurs trois dernières dimensions.
En pratique, on utilise un momentum de type Nesterov, en envoyant à l'orthogonalisation, avec un coefficient de momentum de 0.95. Le billet rapporte aussi une expérience de Vlado Boza, où orthogonaliser séparément les trois projections Q, K et V donne de meilleurs résultats que de les réunir en une seule matrice.
Pourquoi orthogonaliser
Jordan observe empiriquement que les mises à jour calculées par SGD avec momentum et par Adam pour les poids 2D d'un Transformer ont un conditionnement très élevé ; ce sont presque des matrices de faible rang. Toute la mise à jour est dominée par quelques directions singulières, et les composantes dans les autres directions sont négligeables. Il suppose que ces petites directions, toutes petites qu'elles soient, comptent pour l'apprentissage ; en ramenant toutes les directions à la même taille, l'orthogonalisation amplifie ces « directions rares ».
Une autre lecture vient de Old Optimizer, New Norm, de Jeremy Bernstein et Laker Newhouse (2024). Ils voient un optimiseur comme « le pas de plus forte descente selon le gradient, sous une contrainte de norme donnée ». Si l'on borne la taille de chaque coordonnée (norme ), le pas de plus forte descente est le signe du gradient ; si l'on borne la norme spectrale de toute la matrice (sa plus grande valeur singulière), c'est . Adam sans EMA se réduit au premier, et Shampoo sans accumulation correspond exactement au second.
Une matrice de poids est un opérateur linéaire qui agit sur des vecteurs cachés ; il est donc plus logique de mesurer par la norme spectrale de combien elle change. Moonshot AI adopte aussi ce point de vue dans son article, et juge la contrainte de norme de Muon plus pertinente que celle d'Adam.
Et à plus grande échelle ?
Sur les modèles de moins de 1.5B, Muon brille. Jordan entraîne avec Muon un modèle de 1.5B jusqu'au niveau HellaSwag de GPT-2 XL en 10 heures de 8×H100, contre 13.3 heures pour AdamW. Mais il s'agit de petits modèles et d'entraînements courts.
Dès que Moonshot AI agrandit le modèle et le nombre de tokens, l'avantage de Muon sur AdamW se réduit. L'article cherche à en trouver la cause, et à rendre Muon directement utilisable, sans réglage supplémentaire, pour des entraînements de plusieurs centaines de milliards à plusieurs billions de tokens.
Résoudre le problème
Newton–Schulz : orthogonaliser sans SVD
La SVD donne directement , mais elle est trop lente sur GPU. Les itérations de Newton couplées (coupled Newton) courantes dans les implémentations de Shampoo ne sont stables qu'en float32, constate Jordan, et elles sont lentes elles aussi. Les itérations de Newton–Schulz n'utilisent que des multiplications matricielles et tournent de façon stable en bfloat16.
Regardons ce qu'une itération fait à une matrice. Soit ; une étape de Newton–Schulz s'écrit
et restent intacts ; seule chaque valeur singulière passe dans un polynôme de degré cinq, . Itérer fois revient à appliquer fois de suite.
Il suffit donc de deux conditions pour que les itérations poussent la matrice vers .
- Toutes les valeurs singulières sont au départ dans ; il suffit de diviser d'abord la matrice par sa norme de Frobenius, l'orthogonalisation étant insensible à une remise à l'échelle globale.
- Les coefficients sont choisis pour que , appliqué de façon répétée, pousse toutes les valeurs de vers 1.
converge déjà. Mais Jordan tient au nombre d'étapes. ; plus est grand, plus vite les toutes petites valeurs singulières sont amplifiées. Il constate aussi que les valeurs singulières finales n'ont pas besoin de valoir exactement 1 ; si elles tombent entre 0.7 et 1.3, la courbe de perte de l'entraînement n'en est pas affectée. Il rend donc aussi grand que possible dans cette marge de tolérance, et obtient par une méthode de gradient , avec lequel cinq étapes suffisent.
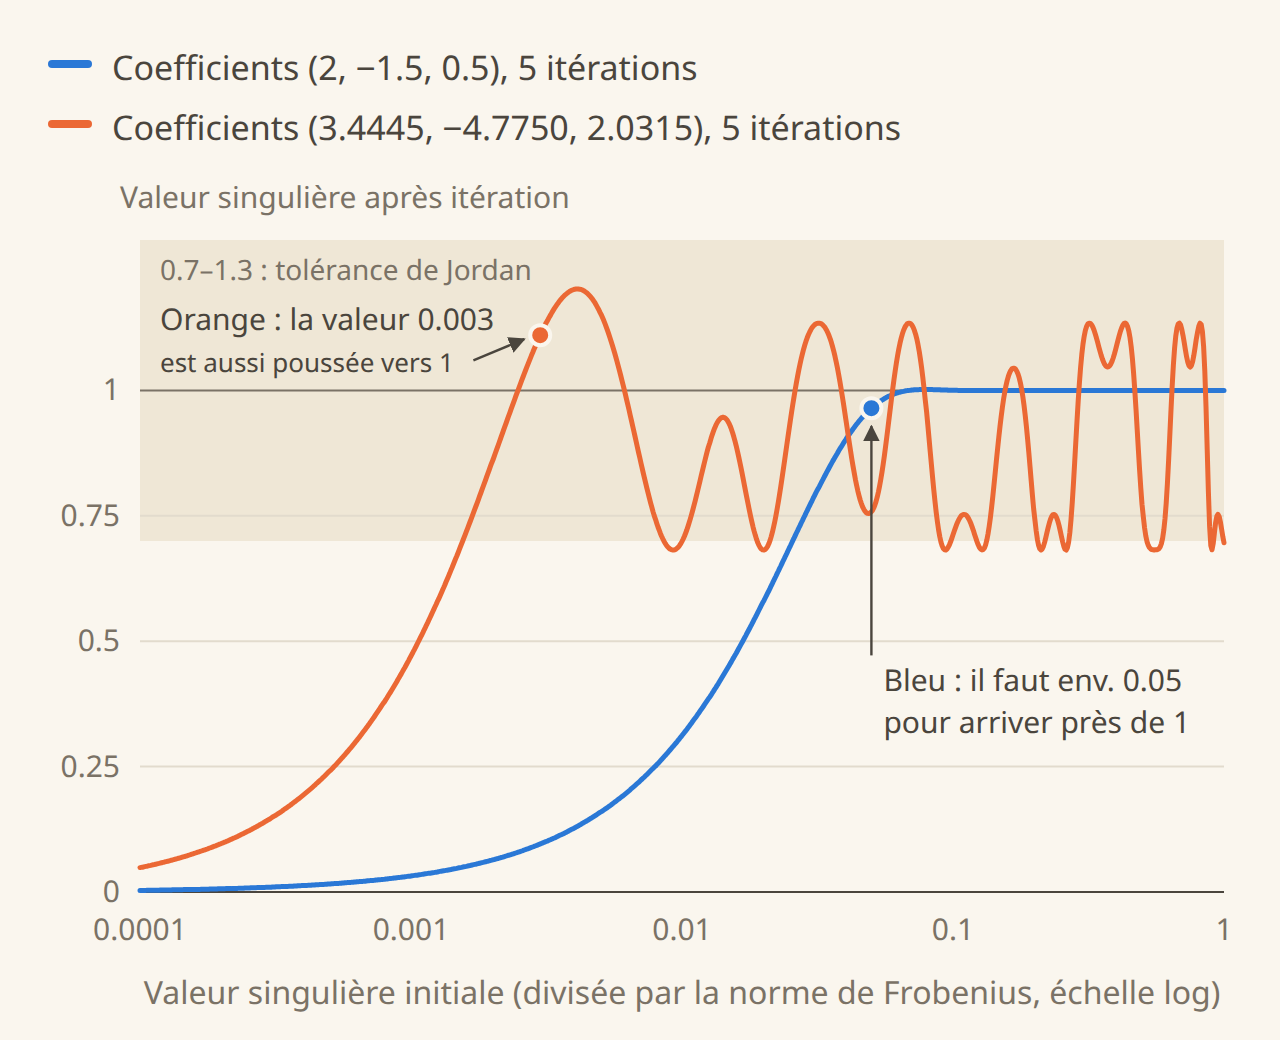
La courbe bleue correspond aux coefficients prudents. Elle converge proprement vers 1, mais seulement pour des valeurs singulières d'environ 0.05 au moins ; les valeurs plus petites restent petites après cinq étapes, et l'orthogonalisation reste inachevée. La courbe orange correspond aux coefficients réglés par Jordan ; même une valeur singulière de 0.003 est poussée près de 1, au prix d'un résultat qui oscille entre environ 0.68 et 1.2. C'est cette courbe orange qu'utilise Muon ; à strictement parler, ce qu'elle calcule est un aux « valeurs singulières à peu près égales ».
L'implémentation officielle (KellerJordan/Muon) tient en ces quelques lignes :
def zeropower_via_newtonschulz5(G, steps: int):
    a, b, c = (3.4445, -4.7750,  2.0315)
    X = G.bfloat16()
    if G.size(-2) > G.size(-1):
        X = X.mT                                   # pour que X @ X.mT soit du côté le plus petit
    X = X / (X.norm(dim=(-2, -1), keepdim=True) + 1e-7)   # valeurs singulières ramenées dans [0, 1]
    for _ in range(steps):
        A = X @ X.mT
        B = b * A + c * A @ A
        X = a * X + B @ X                          # aX + b(XXᵀ)X + c(XXᵀ)²X
    if G.size(-2) > G.size(-1):
        X = X.mT
    return X
Le coût de calcul reste modeste. Pour une matrice (), chaque itération demande environ opérations en virgule flottante. Jordan estime le surcoût à au plus, où est le nombre d'itérations, la dimension du modèle et le nombre de tokens par lot. Pour le NanoGPT speedrun, avec et , le surcoût est d'environ 0.7 % ; pour Llama 405B, avec et d'environ 16 millions, d'environ 0.5 %.
Premier ajout : la décroissance des poids
Le Muon original de Jordan n'a pas de décroissance des poids. En passant à l'échelle, Moonshot AI observe que la RMS des poids et des sorties de chaque couche ne cesse de croître, jusqu'à sortir de la plage de haute précision du bfloat16. La solution retenue consiste à ajouter la même décroissance des poids découplée qu'AdamW :
Pour en vérifier l'effet, ils entraînent un modèle de 800 millions de paramètres sur 100 milliards de tokens, environ 5 fois le nombre optimal de tokens selon leur scaling law. Sans décroissance des poids, Muon converge d'abord le plus vite et mène de 0.023 la version avec décroissance des poids vers l'étape 24 000 ; ensuite, certains poids deviennent trop grands, et à l'étape 66 000, il est au contraire dépassé de 0.017. Dans ce régime de surentraînement, Muon avec décroissance des poids bat à la fois le Muon original et AdamW.
Des évaluations indépendantes ultérieures vont dans le même sens. Semenov et al., de l'EPFL, comparent les deux versions sur des modèles de 124M à 720M ; les performances du Muon original se dégradent quand le modèle grandit, tandis que la version de cet article (qu'ils appellent D-Muon) reste stable dans toutes les configurations.
Second ajout : une mise à jour de même taille pour chaque matrice
Le second problème se cache dans l'orthogonalisation elle-même. Toutes les valeurs singulières de valent 1, si bien que le carré de sa norme de Frobenius est égal à son rang . Une matrice de rang plein a pour rang ; la moyenne quadratique (RMS) de ses éléments vaut donc
C'est le Lemma 1 de l'article. La RMS des mises à jour de Muon mesurée pendant l'entraînement est effectivement proche de cette valeur théorique.
Faisons le calcul pour un modèle de dimension cachée . La projection query de l'attention est , avec une RMS de mise à jour d'environ ; la première couche d'un MLP classique est , avec une RMS de mise à jour d'environ seulement, moitié moins. Avec le même taux d'apprentissage, des matrices de formes différentes parcourent des distances différentes à chaque étape.
L'article identifie deux situations à risque. Les matrices dont est très grand (par exemple les grands MLP denses) reçoivent des mises à jour trop petites et apprennent mal ; celles dont est très petit (par exemple quand chaque tête KV est traitée comme un paramètre indépendant dans GQA ou MLA) reçoivent des mises à jour trop grandes, et l'entraînement devient instable.
La correction consiste à multiplier la mise à jour de chaque matrice par , ce qui compense le Lemma 1. Moonshot AI va un pas plus loin. Muon ne gère que les matrices ; l'embedding, la tête de classification et RMSNorm restent confiés à AdamW, et l'idéal est que les deux optimiseurs partagent le même taux d'apprentissage et la même décroissance des poids. D'après leur expérience, la RMS des mises à jour d'AdamW tourne autour de 0.2 à 0.4 ; ils remettent donc aussi la mise à jour de Muon à l'échelle de cette plage :
Ainsi, la RMS de mise à jour de chaque matrice vaut 0.2, et Muon peut reprendre directement le taux d'apprentissage et la décroissance des poids réglés pour AdamW. C'est la formule la plus utile de l'article. Dans l'exemple open source de Moonlight, elle tient en une ligne, adjusted_ratio = 0.2 * math.sqrt(max(A, B)), qui sert à amplifier le taux d'apprentissage du terme Muon ; le terme de décroissance des poids reste multiplié par le lr d'origine.
La valeur 0.2 repose sur des expériences. Sur un petit modèle entraîné 2 000 étapes (environ 2 milliards de tokens), avec une RMS de mise à jour de Muon fixée à 0.05, 0.1, 0.2, 0.4 et 0.8, la perte de validation vaut respectivement 3.503, 3.374, 3.325, 3.314 et 3.543, contre 3.679 pour AdamW. 0.2 et 0.4 sont presque aussi bons l'un que l'autre, et les auteurs ont retenu 0.2.
Une autre expérience compare trois façons de contrôler la RMS. Pour amplifier les différences de forme, ils remplacent le SwiGLU du modèle 800M par un MLP à deux couches , et évaluent à 4B tokens :
| Méthode | Perte de validation | RMS des poids du MLP |
|---|---|---|
| Multiplier partout par | 2.812 | 0.0252 |
| Normaliser directement la sortie à une RMS de 0.2 | 2.789 | 0.0501 |
| Multiplier par | 2.789 | 0.0489 |
D'après la Table 1 de l'article.
La première méthode, qui ne regarde que la dimension cachée , donne sur le MLP des mises à jour moitié moins grandes que les deux autres (), et une perte plus élevée. Les deux dernières sont aussi bonnes l'une que l'autre, et l'article retient la troisième, moins coûteuse.
Les autres hyperparamètres restent inchangés. Avec 10 itérations, Newton–Schulz orthogonalise plus précisément, sans améliorer l'entraînement ; on garde donc 5 étapes. Régler le momentum n'apporte pas de gain régulier, et il reste à 0.95.
Muon distribué
Les grands entraînements utilisent généralement ZeRO-1 pour répartir l'état de l'optimiseur entre les nœuds de parallélisme de données (DP), chaque nœud ne mettant à jour que sa propre tranche de paramètres. Pour AdamW, aucun problème, puisque ses opérations se font élément par élément ; Muon, lui, a besoin de la matrice complète pour l'orthogonaliser.
Le Distributed Muon de l'article ajoute deux étapes à ZeRO-1 :
- comme d'habitude, les gradients sont répartis entre les nœuds par reduce-scatter, et chacun met à jour sa tranche locale de momentum ;
- ajout : au sein du groupe DP, les fragments de gradient mis à jour sont rassemblés par gather en une matrice complète ;
- ajout : Newton–Schulz est exécuté sur la matrice complète, et chaque nœud ne garde que la tranche qui lui revient pour appliquer la mise à jour ;
- comme d'habitude, les paramètres sont rassemblés par all-gather.
Côté mémoire, Muon n'a qu'un momentum, contre deux pour AdamW, et la mémoire d'optimiseur supplémentaire vaut la moitié de celle d'AdamW distribué. Côté communications, le gather supplémentaire ne concerne que la tranche locale et se fait en bfloat16 ; le volume total de communication vaut 1 à 1.25 fois celui d'AdamW distribué. Côté latence, l'étape d'optimisation ne représente généralement que 1 % à 3 % du temps des passes avant et arrière, et le gather peut en outre se superposer au calcul. Les auteurs disent ne voir aucune différence de latence notable sur leur cluster.
Discussion
Scaling law : environ 2 fois
Par souci d'équité, les auteurs commencent par une étude de scaling law pour AdamW. À plusieurs budgets de calcul, ils font varier la taille du modèle et le nombre de tokens pour trouver la meilleure combinaison, puis font une recherche par grille sur le taux d'apprentissage et la taille de lot, en deux ou trois passes. Ils obtiennent ainsi 5 modèles denses d'architecture Llama, de 399M à 1.5B (hors embedding), avec 8.9B à 38.9B tokens et des taux d'apprentissage de 9.5e-4 à 8.3e-4. Muon, dont la RMS de mise à jour est déjà alignée, reprend directement les hyperparamètres optimaux d'AdamW.
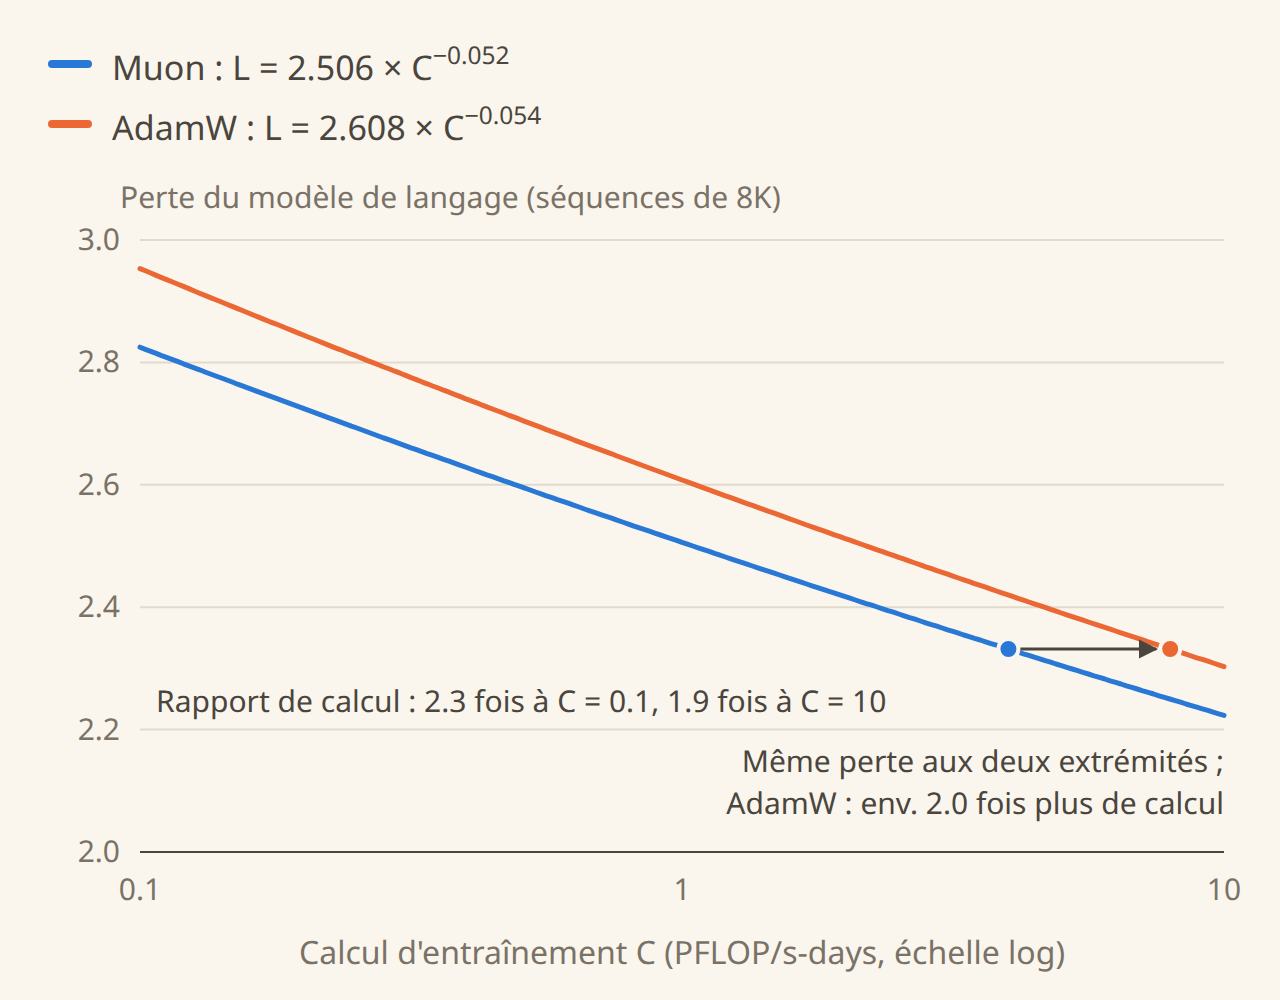
Les deux formules ajustées sont pour Muon et pour AdamW. L'article conclut que, dans un cadre compute-optimal, Muon atteint la perte d'AdamW avec environ 52 % du calcul d'entraînement, soit une efficacité de calcul environ 2 fois supérieure.
En refaisant le calcul avec ces deux formules, le rapport de calcul à perte égale vaut environ 2.3 à 0.1 PFLOP/s-days, environ 2.0 à 4 PFLOP/s-days, près du plus grand point expérimental, et tombe à environ 1.9 en extrapolant à 10 PFLOP/s-days. L'exposant d'AdamW est un peu plus grand, et les deux courbes se rapprochent lentement. Cette baisse du facteur quand le calcul augmente, nous l'avons calculée à partir des formules ajustées de l'article ; l'article n'en parle pas.
Deux conditions de ces expériences sont à garder en tête. Dans le tableau, le nombre de tokens représente environ 22 à 26 fois le nombre de paramètres, proche du ratio optimal de Chinchilla (20 fois) ; un seul volume de données a donc été testé. Et le taux d'apprentissage d'AdamW a été choisi dans le cadre de cette procédure de scaling law, entre 8e-4 et 1e-3. Ces deux points ont ensuite été discutés.
Moonlight : seul l'optimiseur change
Le modèle final reprend l'architecture de DeepSeek-V3-Small, avec 2.24B paramètres activés et 15.29B au total (3B/16B en comptant l'embedding), et quelques petites modifications, comme le retrait de la prédiction multi-token. Le contexte maximal est de 8K, et la décroissance des poids reste à 0.1 tout du long. L'entraînement se fait en trois phases :
- les 33B premiers tokens, avec un taux d'apprentissage monté linéairement à 4.2e-4 en 2 000 étapes et des lots de 2 048 séquences ;
- de 33B à 5.2T tokens, une décroissance en cosinus de 4.2e-4 à 4.2e-5, avec des lots doublés à 4 096 séquences après 200B tokens ;
- les 500B derniers tokens, avec un taux d'apprentissage d'abord remonté à 1e-4 puis ramené linéairement à 0, sur les données de la plus haute qualité, surtout des mathématiques, du code et du raisonnement.
La comparaison la plus propre est Moonlight-A, avec exactement la même configuration d'entraînement, seul l'optimiseur étant remplacé par AdamW. Les deux sont comparés sur leur checkpoint intermédiaire à 1.2T tokens :
| Évaluation | AdamW | Muon |
|---|---|---|
| MMLU | 60.2 | 60.4 |
| MMLU-pro | 26.8 | 28.1 |
| BBH | 45.3 | 43.2 |
| HumanEval | 29.3 | 37.2 |
| MBPP | 49.2 | 52.9 |
| GSM8K | 43.8 | 45.0 |
| MATH | 16.1 | 19.8 |
D'après la Table 4 de l'article (extrait) ; dans les deux cas, checkpoint intermédiaire à 1.2T tokens, avant la fin de la décroissance du taux d'apprentissage.
MMLU est presque identique, et sur BBH, c'est même AdamW qui est devant. Les plus gros écarts concernent le code et les mathématiques, avec 7.9 points de plus sur HumanEval. Les auteurs soulignent aussi les bonnes performances de Muon en mathématiques et en code, et en laissent l'explication à des travaux futurs.
Après 5.7T tokens, Moonlight obtient 70.0 sur MMLU ; DeepSeek-V2-Lite, de même taille, entraîné lui aussi sur 5.7T tokens mais avec AdamW, obtient 58.3, et Qwen2.5-3B, entraîné sur 18T tokens, 65.6. Ces modèles viennent d'équipes et de données différentes ; on peut seulement dire que Moonlight se situe sur la frontière du compromis entre calcul d'entraînement et performances, et on ne peut pas y voir une comparaison contrôlée entre optimiseurs.
L'entraînement se déroule sans accroc, sans pic de perte ni de norme du gradient. L'annexe contient deux détails. D'abord, le logit d'attention maximal de certaines couches monte au-delà de 100 au début de l'entraînement, et les auteurs écrivent qu'AdamW « se comporte plus sainement » pour contenir cette valeur ; les logits au-dessus de 100 ne représentent qu'environ un sur dix mille, et redescendent lentement ensuite. Ensuite, les gains de RMSNorm doivent eux aussi recevoir une décroissance des poids, sans quoi la RMS des sorties de chaque couche devient trop grande.
Des mises à jour plus étalées, des poids aussi
L'intuition selon laquelle Muon fait apprendre les poids dans davantage de directions peut se mesurer. Les auteurs calculent l'entropie SVD de chaque matrice de poids :
Plus les valeurs singulières sont uniformes, plus l'entropie est proche de 1 ; si quelques valeurs singulières dominent, elle est basse. Pendant les 1.2T tokens de préentraînement, sur six groupes de poids, dont l'attention, les experts, les experts partagés, le routeur et la première couche dense, l'entropie SVD moyenne de Muon est supérieure à celle d'AdamW à chaque checkpoint ; pour plus de 90 % des matrices de poids, l'entropie est aussi plus élevée avec Muon. L'écart le plus grand concerne le routeur du MoE, ce qui amène les auteurs à supposer que les MoE profitent davantage de Muon.
Changer d'optimiseur pour l'affinage ?
C'est une réponse partielle à la troisième question de Jordan. Les auteurs affinent les deux checkpoints à 1.2T tokens, chacun avec Muon et avec AdamW, pendant deux époques sur les données SFT de Tülu 3 :
| Préentraînement → SFT | MMLU | HumanEval | GSM8K |
|---|---|---|---|
| Muon → Muon | 55.7 | 57.3 | 68.0 |
| AdamW → Muon | 55.3 | 53.7 | 62.1 |
| Muon → AdamW | 50.2 | 52.4 | 64.9 |
| AdamW → AdamW | 52.0 | 53.1 | 64.6 |
D'après la Table 6 de l'article (extrait).
Muon de bout en bout donne le meilleur résultat. Mais dès que les optimiseurs du préentraînement et de l'affinage diffèrent, Muon perd tout avantage net ; le préentraînement avec Muon suivi d'un affinage avec AdamW donne même le MMLU le plus bas. En affinant le modèle de base public Qwen2.5-7B avec Adam d'un côté et Muon de l'autre, les deux font à peu près jeu égal, Muon perdant même 4 points sur GSM8K (89.8 contre 85.8). Les auteurs en concluent que l'avantage de Muon tient surtout au préentraînement ; ce phénomène de « décalage entre les optimiseurs du préentraînement et de l'affinage » figure parmi leurs questions ouvertes. Ils notent aussi que la plupart des checkpoints préentraînés existants l'ont été avec AdamW, et que ce décalage les empêche de profiter directement de Muon.
Ensuite : le QK-Clip de Kimi K2
Sur des modèles plus grands, la montée des logits d'attention a fini par poser problème. Le rapport technique de Kimi K2, en juillet 2025, raconte qu'en entraînant avec le Muon original un MoE de 9B paramètres activés et 53B au total, le logit d'attention maximal dépasse rapidement 1 000 ; à cet ordre de grandeur, les logits provoquent généralement de nets pics de perte, voire une divergence. Dans leurs expériences, le problème est plus fréquent avec Muon qu'avec AdamW. Leur hypothèse est que, comme toutes les valeurs singulières d'une mise à jour de Muon sont égales et que son rang effectif est plein, les normes spectrales de et ont plus facilement tendance à croître ensemble.
La solution s'appelle QK-Clip. Après chaque mise à jour, on regarde le logit maximal de chaque tête d'attention sur le lot courant ; s'il dépasse un seuil , on réduit ensemble les et de cette tête, le facteur étant réparti à parts égales entre query et key (chacun multiplié par ; la partie RoPE de MLA suit une règle à part). QK-Clip ne modifie que les poids, sans toucher aux passes avant et arrière de l'étape, et seulement pour les têtes qui dépassent le seuil.
Muon avec décroissance des poids et alignement de la RMS (la formule de cette note), plus QK-Clip, forme ce qu'ils appellent MuonClip. Kimi K2 l'utilise pour entraîner un modèle d'un billion de paramètres au total et de 32 milliards de paramètres activés, sur 15.5 billions de tokens, avec , sans aucun pic de perte de tout l'entraînement. QK-Clip n'agit que pendant les 70 000 premières étapes, au cours desquelles 12.7 % des têtes d'attention l'ont déclenché ; ensuite, le logit maximal de toutes les têtes redescend de lui-même sous 100, et ce garde-fou n'a plus jamais servi.
Moonshot AI n'est pas resté le seul à adopter Muon. GLM-4.5 de Zhipu (août 2025) utilise Muon pour tous ses paramètres, à l'exception des embeddings de mots, des biais et des poids de RMSNorm, avec les réglages de cet article, 5 itérations, un momentum de 0.95 et une RMS de mise à jour ramenée à 0.2. DeepSeek-V4 a lui aussi basculé la plupart de ses paramètres sur Muon ; son attention ayant déjà une RMSNorm sur query et KV, les logits n'explosent pas, et QK-Clip est inutile.
Qu'est devenu le « 2 fois » ?
Ce facteur 2 a été réexaminé à plusieurs reprises.
Wen et al., de Stanford (septembre 2025), font un balayage complet des hyperparamètres de chaque optimiseur avant de comparer l'efficacité en tokens. Pour Muon face à AdamW, ils mesurent environ 1.3 à 1.4 fois de 130M à 520M, et environ 1.1 fois à 1.2B. En annexe, ils pointent deux conditions de cet article. D'une part, le taux d'apprentissage d'AdamW est trop bas, 8e-4 à 9e-4 de 400M à 1.5B, alors que leurs optima sont plus élevés ; d'autre part, la comparaison entre Moonlight et Moonlight-A porte sur des checkpoints intermédiaires, avant la fin de la décroissance du taux d'apprentissage, alors que leurs expériences montrent que Muon prend souvent une large avance au début, mais se fait rattraper pendant la phase de décroissance.
Une étude indépendante d'Essential AI (mai 2025, de 100M à 4B) conclut que Muon a besoin de 10 % à 15 % de tokens de moins qu'AdamW pour atteindre la même perte ; son avantage se maintient, voire grandit, quand le lot devient bien plus grand que la taille de lot critique. En juillet 2026, NVIDIA, avec des MoE de 30B à 72B et des lots de plus de 25 millions de tokens, observe aussi qu'AdamW se dégrade avec de grands lots, alors que Muon tient bon.
Au total, les progrès de Muon sont réels, mais face à un AdamW bien réglé, l'écart d'efficacité en tokens est bien inférieur à 2 fois ; son avantage le plus net apparaît dans l'entraînement à grands lots. Le facteur 2 de cet article venait d'une scaling law proche de 1× Chinchilla, avec un taux d'apprentissage d'AdamW trop bas ; la comparaison entre Moonlight et Moonlight-A, elle, portait sur des checkpoints intermédiaires, avant la fin de la décroissance du taux d'apprentissage.
Conclusion
Moonshot AI ajoute à Muon une décroissance des poids découplée, pour que la RMS des poids et des sorties cesse de croître, puis une multiplication par , pour aligner la RMS de mise à jour de chaque matrice sur les 0.2 d'AdamW. Avec une implémentation distribuée de type ZeRO-1, Muon mène à bien un préentraînement MoE sur 5.7 billions de tokens, en reprenant directement les hyperparamètres d'AdamW. L'efficacité de calcul environ 2 fois supérieure se lit avec ses conditions ; les études ultérieures, avec des références bien réglées, mesurent 1.1 à 1.4 fois.
Pour passer à Muon, laissez l'embedding, la tête de classification, LayerNorm et les biais à AdamW, et confiez les autres poids 2D à Muon ; vérifiez quelle mise à l'échelle utilise votre implémentation, car celle de Moonlight peut reprendre directement le taux d'apprentissage d'AdamW, alors que celle de Jordan demande un nouveau balayage. Si votre modèle a été préentraîné avec AdamW, faites d'abord un essai à petite échelle avant de l'affiner avec Muon.
À la fin de son billet, Jordan écrivait qu'il ne savait pas si Muon passerait à l'échelle de 20 milliards de paramètres et d'un billion de tokens. Sept mois plus tard, Kimi K2 l'utilisait pour entraîner un modèle d'un billion de paramètres sur 15.5 billions de tokens.