Article original
Fantastic Pretraining Optimizers and Where to Find Them
- Publication
- ICLR 2026Conférence
- Premier dépôt sur arXiv
- arXiv:2509.02046
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizersfantasticoptimizers2025,
  title = {{Fantastic Pretraining Optimizers and Where to Find Them}},
  author = {Kaiyue Wen and David Hall and Tengyu Ma and Percy Liang},
  year = {2025},
  eprint = {2509.02046},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2509.02046}
}
Prenons un modèle de langage de 130 millions de paramètres, entraîné avec AdamW selon la recette de l'article GPT-3, avec un taux d'apprentissage maximal de 6e-4. Changeons un seul chiffre, en passant le taux d'apprentissage à 8e-3, sans toucher au reste. Pour atteindre la même perte, il faut deux fois moins d'étapes.
L'article présente cette expérience dès sa première figure. Cette courbe d'AdamW à la recette GPT-3 est justement la référence à laquelle se comparent les articles de nouveaux optimiseurs comme Sophia, MARS ou Cautious, qui annoncent pour la plupart une accélération de 2 fois. La version à grande échelle de Muon annonce environ 2 fois, SOAP 1.4 fois, et DION rapporte même 3 fois.
Si bien régler le taux d'apprentissage de la référence suffit à gagner 2 fois, de combien ces optimiseurs sont-ils vraiment plus rapides ? Kaiyue Wen, David Hall, Tengyu Ma et Percy Liang, de Stanford, placent 11 optimiseurs dans une même procédure, règlent chacun en partant de zéro, et les comparent de 130 millions jusqu'à 1.2 milliard de paramètres.
Le titre de l'article reprend celui du film Les Animaux fantastiques (Fantastic Beasts and Where to Find Them). Cette note examine comment ils conçoivent une comparaison équitable, quelles accélérations ils mesurent, et en quoi leurs résultats diffèrent de quelques évaluations à grande échelle contemporaines ou ultérieures.
Définir le problème
Selon les auteurs, si les nouveaux optimiseurs tardent à remplacer AdamW, c'est à cause des méthodes d'évaluation, avec deux problèmes principaux.
Le premier est un réglage inégal. Les auteurs d'une nouvelle méthode règlent généralement leur optimiseur avec soin, mais reprennent une vieille recette pour la référence, ou font partager à tous les optimiseurs le même taux d'apprentissage et la même décroissance des poids.
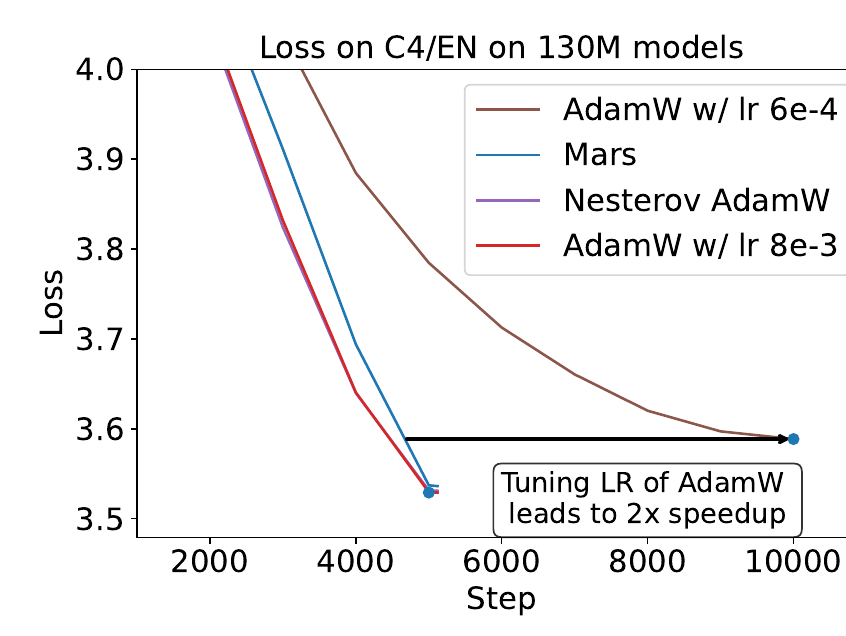
La courbe marron est AdamW avec un taux d'apprentissage de 6e-4, la rouge avec 8e-3. La courbe rouge atteint en moins de 5 000 étapes la perte finale de la courbe marron à 10 000 étapes, et finit même plus bas, vers 3.53. MARS (bleu) et Nesterov AdamW (violet) figurent aussi sur la figure, et finissent tous deux très près de la courbe rouge bien réglée. Avec la courbe marron comme référence, MARS semble 2 fois plus rapide ; avec la rouge, l'écart est bien plus faible.
Partager les hyperparamètres n'est pas plus équitable. Même entre optimiseurs très proches, les hyperparamètres optimaux peuvent beaucoup différer. Pour Lion, par exemple, le balayage de l'article trouve une décroissance des poids optimale d'environ 0.6, contre environ 0.1 pour AdamW ; s'ils partagent la même valeur, l'un des deux est forcément désavantagé.
Le second est un cadre d'évaluation trop étroit. La plupart des articles ne comparent qu'autour de 1× Chinchilla, sur une ou deux tailles de modèle, et certains comparent même des checkpoints intermédiaires. 1× Chinchilla désigne le ratio optimal en calcul établi par l'article Chinchilla, environ 20 tokens par paramètre. Les vrais grands modèles vont de 1 fois à plus de 50 fois ; une méthode qui gagne à 1× ne gagne pas forcément quand les données sont abondantes.
Ce sont les deux questions auxquelles l'article veut répondre. Comment s'assurer que chaque optimiseur est réglé presque au mieux ? Et quelle est l'accélération selon la taille du modèle et le volume de données ?
Résoudre le problème
Le terrain d'expérience
Les données imitent celles d'OLMo 2 et mêlent DCLM-baseline (3.8T tokens), StarCoder V2 (0.25T) et ProofPile 2 (55B), avec le tokenizer de Llama 3. Tous les modèles ont une architecture Llama à 32 couches et des séquences de 4 096 tokens ; seule la largeur change :
| Modèle | Dimension cachée | Dimension feed-forward | Têtes d'attention |
|---|---|---|---|
| 130M | 512 | 2 048 | 8 |
| 300M | 768 | 3 072 | 12 |
| 520M | 1 024 | 4 096 | 16 |
| 1.2B | 1 536 | 6 144 | 24 |
D'après la Table 2 de l'article.
Le volume de données est exprimé en multiples de Chinchilla, 1×, 2×, 4× et 8× (1× correspondant à 20 fois le nombre de paramètres hors embedding). La métrique principale est la perte de validation sur le sous-ensemble anglais de C4, et plus d'une dizaine de précisions en aval, comme HellaSwag ou ARC, sont aussi suivies. Les expériences tournent en JAX sur 128 TPU v5 lite, soit, selon l'estimation des auteurs, l'équivalent d'environ 12 H100.
L'unité de comparaison est « le nombre de tokens nécessaires pour atteindre une même perte », sans compter le temps de calcul supplémentaire par étape. Les auteurs justifient ce choix par le fait que les articles SOAP et Muon de Kimi montrent tous deux qu'avec une implémentation soignée, le surcoût par étape des optimiseurs matriciels peut descendre sous 10 %.
Les 11 optimiseurs se répartissent en cinq catégories :
- Référence : AdamW
- Variantes d'AdamW qui réduisent la variance des mises à jour : NAdamW (momentum de Nesterov), MARS, Cautious
- Économes en mémoire : Lion, Adam-mini
- Matriciels : Muon, Scion, Kron (PSGD), SOAP
- Approximation de la hessienne : Sophia (résultats en annexe)
Les optimiseurs scalaires et matriciels diffèrent par la façon dont agit le préconditionnement. Les scalaires, comme AdamW, Lion ou MARS, multiplient chaque paramètre par son propre scalaire ; les matriciels, comme Muon, SOAP ou Kron, traitent toute la matrice de poids comme un tout et transforment le gradient par des multiplications matricielles.
Un réglage en trois phases
Une recherche exhaustive sur toutes les combinaisons coûterait trop cher ; les auteurs procèdent en trois phases.
La première phase est une descente par coordonnées. Chaque hyperparamètre a un ensemble discret de valeurs candidates ; pour AdamW, il s'agit du taux d'apprentissage, de la décroissance des poids, du nombre d'étapes d'échauffement, de , , , du seuil d'écrêtage du gradient et de la taille de lot (batch size). Le point de départ est la configuration recommandée par l'article d'origine. À chaque tour, on fixe les autres hyperparamètres et on n'en balaie qu'un seul ; si la perte de validation s'améliore de plus de , on adopte la nouvelle valeur. On enchaîne les tours jusqu'à ce qu'aucun hyperparamètre n'apporte plus d'amélioration significative. Cette étape est faite une fois pour chacune de 6 configurations, 1× pour 130M, 300M et 520M, plus 2×, 4× et 8× pour 130M.
L'article donne un exemple avec AdamW. La configuration initiale est un taux d'apprentissage de 0.008, une décroissance des poids de 0.1, 1 000 étapes d'échauffement et des lots de 256 séquences, pour une perte de 3.298 ; le premier tour porte l'échauffement à 2 000 étapes, et la perte descend à 3.282 ; le deuxième tour passe le lot à 128 séquences, et la perte descend à 3.263 ; enfin, le seuil d'écrêtage du gradient passe à 2, la perte reste à 3.263, et le balayage s'arrête.
La deuxième phase ne règle que les hyperparamètres qui varient avec l'échelle. Les auteurs font deux observations. Beaucoup d'hyperparamètres n'ont presque aucun effet sur la perte tant qu'ils restent près de leur optimum ; et parmi ceux qui comptent, l'optimum change rarement avec l'échelle.
Ils considèrent donc comme « quasi optimale » toute configuration dont la perte est à moins de de l'optimum. Si un hyperparamètre a une valeur quasi optimale dans toutes les configurations, il est insensible à l'échelle, et on le fixe ; sinon, il est sensible à l'échelle et passe à la deuxième phase.
Au final, chaque optimiseur n'a que peu d'hyperparamètres à régler de nouveau. Pour AdamW, ce sont le taux d'apprentissage, l'échauffement, la décroissance des poids et la taille de lot ; pour Lion, le taux d'apprentissage et ; pour Muon et Kron, le taux d'apprentissage seulement. La deuxième phase est refaite sur 6 configurations, 2×, 4× et 8× pour 300M et 520M, soit 12 configurations au total avec la première phase.
La troisième phase extrapole les tendances. Pour chaque hyperparamètre à régler de nouveau, on ajuste sur les optima des 12 configurations
est le nombre de paramètres, le nombre de tokens. Pour valider, les auteurs refont une première phase complète pour AdamW à 1.2B, 1× ; les hyperparamètres prédits par l'ajustement donnent une perte à moins de de l'optimum effectivement trouvé. Ils utilisent ensuite ces prédictions pour deux études de cas plus grandes, l'une avec le modèle 1.2B de 1× à 8×, l'autre avec 130M et 300M poussés jusqu'à 16×.
Les tableaux de l'annexe montrent comment les optima évoluent avec l'échelle. Pour AdamW à 130M, 1×, le meilleur taux d'apprentissage est 0.008, avec une décroissance des poids de 0.1 et des lots de 128 séquences ; à 1.2B, 1×, on passe à un taux d'apprentissage de 0.002, une décroissance des poids de 0.2 et des lots de 256 séquences. Le taux d'apprentissage de la partie matricielle de Muon descend, lui, de 0.016 à 0.004 (à 1.2B, 1×, 0.008 donne même une perte un peu plus basse). Le modèle est environ 9 fois plus grand, et le taux d'apprentissage 2 à 4 fois plus petit ; appliquer directement à 1.2B le taux d'apprentissage réglé sur 130M désavantagerait la référence.
Comment mesurer l'accélération
L'accélération se calcule en tokens. Pour chaque taille de modèle, on ajuste d'abord une courbe sur les quatre pertes d'AdamW à 1×, 2×, 4× et 8×
Si un optimiseur atteint une perte avec tokens, on inverse la courbe d'AdamW pour trouver les tokens dont AdamW a besoin pour atteindre le même . L'accélération vaut alors .
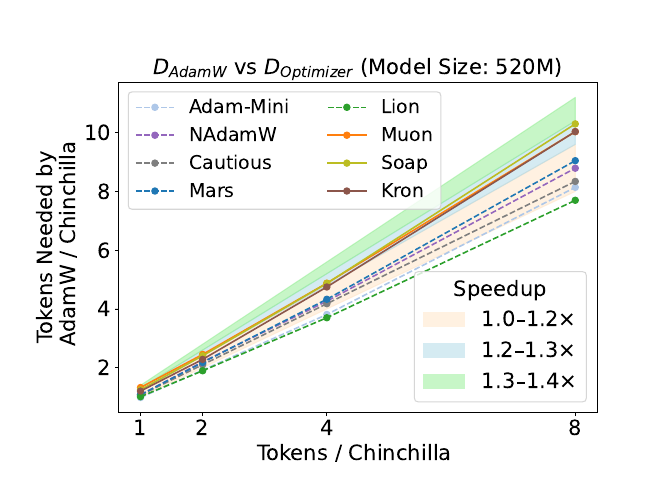
Pour lire cette figure, regardez à quelle distance chaque courbe se trouve de la diagonale. Un optimiseur aussi rapide qu'AdamW aurait ses points sur ; plus les points sont hauts, plus AdamW doit lire de tokens pour le rattraper. À 520M, les optimiseurs matriciels en trait plein se situent à peu près dans la bande de 1.2 à 1.4 fois, et leurs courbes se relèvent d'autant plus que le volume de données grandit.
Discussion
Résultat principal : 1.4 fois au plus, et moins à mesure que le modèle grandit
En rassemblant les résultats sur trois tailles de modèle et quatre volumes de données, quatre tendances se dégagent.
- Aucune méthode n'atteint 2 fois. Face à un AdamW bien réglé, le maximum est d'environ 1.4 fois. SOAP est l'un des rares articles à avoir sérieusement réglé sa propre référence, et les 1.4 fois qu'il annonce sont les plus proches de ce qui est mesuré ici, soit en réalité 1.2 à 1.3 fois à 300M et 520M.
- Les matriciels battent les scalaires. À chaque taille de modèle, Muon, SOAP, Kron et Scion dominent les optimiseurs scalaires. À 1×, Muon est le meilleur ; à 8×, SOAP et Kron le rattrapent et le dépassent. L'accélération des matriciels augmente avec le volume de données et diminue quand le modèle grandit.
- Une fois réglés, les scalaires font tous à peu près jeu égal avec AdamW, avec une accélération moyenne inférieure à 1.2 fois. Les variantes à variance réduite, NAdamW, MARS et Cautious, battent légèrement AdamW.
- Lion et Adam-mini, économes en mémoire, suivent AdamW de près, au plus 5 % plus lents, parfois un peu plus rapides. Quand le modèle grandit, Lion prend de plus en plus de retard, tandis qu'Adam-mini se rapproche au contraire.
Les meilleures pertes de chaque configuration, en annexe, montrent directement à quel point les écarts sont faibles ; en voici quelques cases :
| Optimiseur | 130M, 1× | 520M, 8× | 1.2B, 8× |
|---|---|---|---|
| AdamW | 3.529 | 2.913 | 2.752 |
| NAdamW | 3.531 | 2.907 | 2.749 |
| Lion | 3.552 | 2.915 | — |
| Muon | 3.464 | 2.906 | 2.748 |
| SOAP | 3.483 | 2.899 | 2.749 |
Tableau établi pour cette note à partir des lignes de meilleure configuration de chaque cadre, dans les annexes C, D et E de l'article ; perte de validation C4/EN, plus elle est basse, mieux c'est. Seuls quatre optimiseurs ont été lancés à 1.2B.
À 130M, 1×, Muon est 0.065 plus bas qu'AdamW, le plus grand écart du tableau. À 1.2B, 8×, les quatre optimiseurs tiennent dans 0.004.
1.2B : on tombe à 1.1 fois
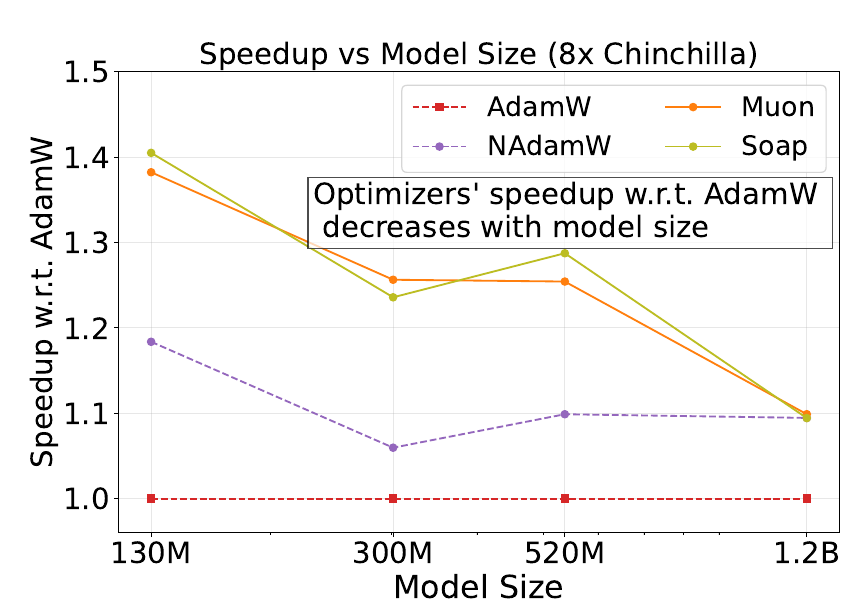
Cette figure se place à 8× Chinchilla et montre comment l'accélération évolue avec la taille du modèle. SOAP et Muon sont tous deux proches de 1.4 fois à 130M, mais ne sont plus qu'à environ 1.1 fois à 1.2B, presque au niveau de NAdamW.
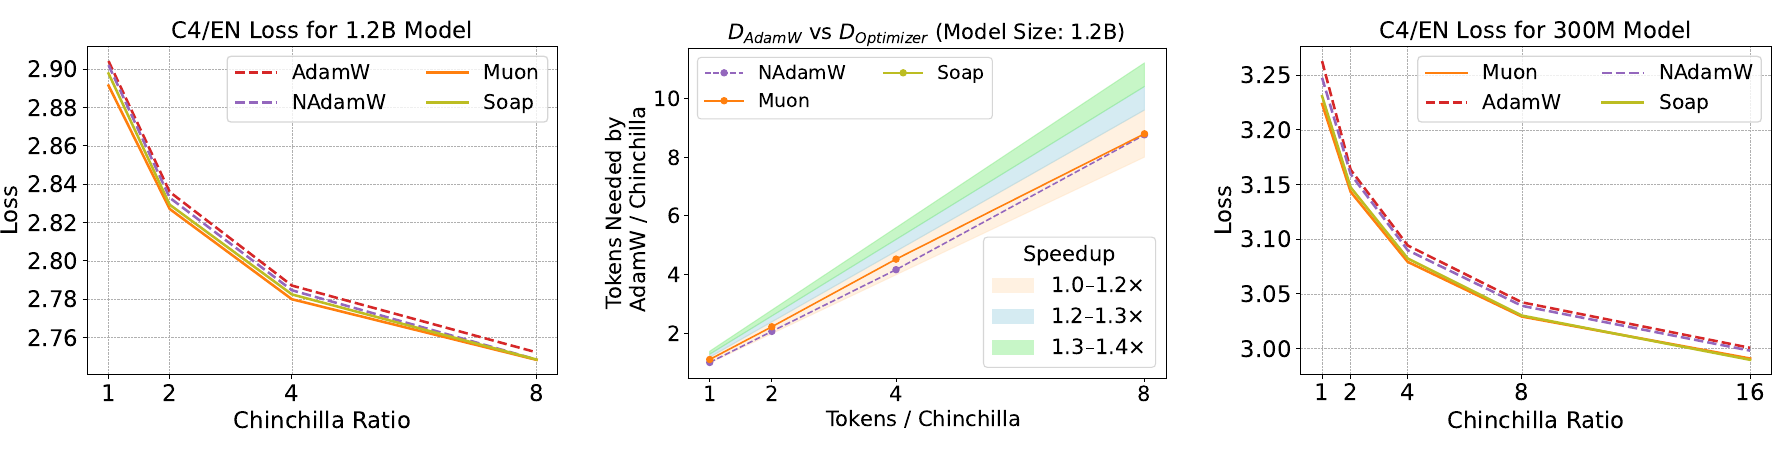
Le graphique de gauche montre la perte à 1.2B. NAdamW, Muon et SOAP restent plus rapides qu'AdamW, mais presque sans écart entre eux ; converti en accélération, au centre, cela fait environ 1.1 fois. Les évaluations en aval ne montrent pas de différence non plus ; à 8× (193B tokens), la moyenne sur dix tâches est de 67.15 pour AdamW, 66.70 pour NAdamW et 66.98 pour Muon.
À partir de 16 entraînements, les auteurs ajustent une scaling law pour AdamW et pour Muon, , et prédisent qu'à 7B, 1×, la perte de Muon dépassera même celle d'AdamW. Avec les coefficients de l'annexe, on obtient, à 7B et 1×, 2.5706 pour AdamW et 2.5729 pour Muon, soit 0.002 d'écart, moins que l'erreur RMS de 0.005 de l'ajustement de Muon lui-même. Cette prédiction extrapole 6 fois au-delà de la plage ajustée ; on peut seulement dire que, sur cette trajectoire, l'avantage de Muon se réduit jusqu'à devenir invisible, sans pouvoir désigner de vainqueur.
Le graphique de droite va jusqu'à 16× Chinchilla. À 8×, SOAP dépassait déjà Muon à 130M et 520M ; les auteurs le vérifient à nouveau en poussant 300M jusqu'à 16×, et SOAP l'emporte encore, de même qu'à 130M. Ils supposent que le moment d'ordre deux conservé par SOAP et Kron devient plus utile quand les données sont abondantes. Pourtant, dans les tableaux de l'annexe, la meilleure perte à 300M, 16× est de 2.990 pour SOAP et de 2.991 pour Muon, soit seulement 0.001 d'écart, moins que le seuil de 0.003 que les auteurs utilisent eux-mêmes pour « compter comme une amélioration » dans leur descente par coordonnées. Une lecture plus prudente de ce passage est qu'avec plus de données, l'avance initiale de Muon disparaît.
Les premières courbes sont trompeuses
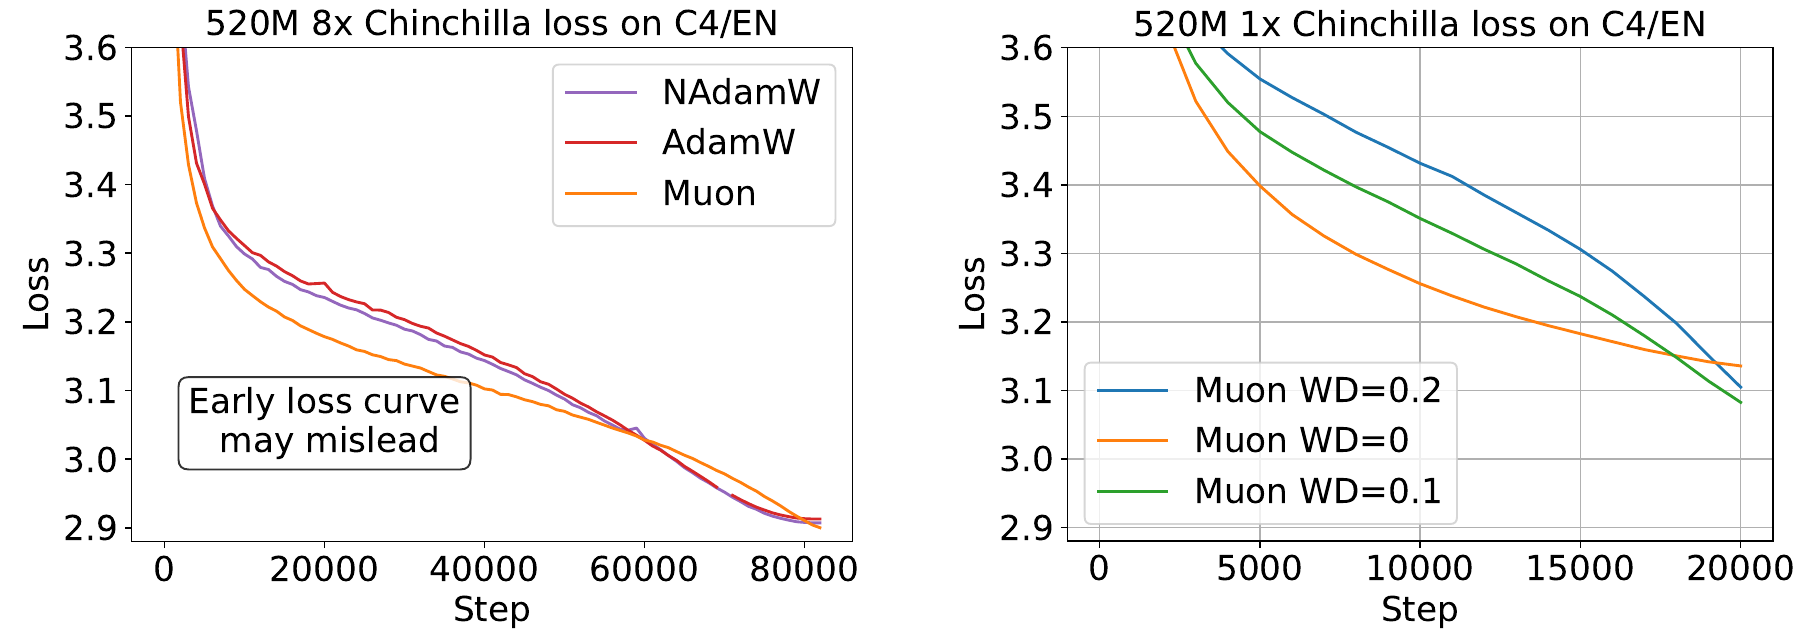
Le graphique de gauche montre les courbes d'entraînement complètes à 520M, 8×. Muon prend une large avance pendant la première moitié ; si l'on comparait à 30 000 étapes, il paraîtrait bien plus rapide. Une fois que le taux d'apprentissage commence à décroître fortement, AdamW et NAdamW le rattrapent, les trois courbes se croisent vers 60 000 étapes, et les points d'arrivée sont presque identiques.
Le graphique de droite montre le même optimiseur avec trois décroissances des poids. Sans décroissance des poids, Muon est le plus rapide au début, puis stagne, et finit le pire des trois ; avec 0.1, il termine le mieux.
Les auteurs recommandent donc de ne comparer que les checkpoints finaux. Ils citent ici nommément l'article Muon de Kimi, qui, pour comparer les modèles MoE entraînés avec Muon et avec AdamW, utilisait justement des checkpoints intermédiaires, avant la fin de la décroissance du taux d'apprentissage.
La même section fait deux autres observations.
- Un seul hyperparamètre suffit à inverser le classement. À 520M, 8×, si l'on fixe le taux d'apprentissage de SOAP au double de son optimum, son avance sur MARS disparaît presque. Les auteurs ont recensé tous les entraînements où un seul hyperparamètre est modifié et où la perte reste à moins de 0.02 de l'optimum ; les distributions de Muon, SOAP et MARS se chevauchent. Sans balayage systématique, le classement peut être presque arbitraire.
- La décroissance des poids optimale dépend de l'optimiseur. Nous avons vu qu'elle est d'environ 0.6 pour Lion ; pour Kron, elle est d'environ 0.5, et c'est la clé de sa victoire sur AdamW.
D'où venaient les « 2 fois » d'avant
L'annexe G passe en revue les configurations des articles antérieurs pour trouver pourquoi leurs accélérations étaient surestimées.
- Sophia (2 fois) : taux d'apprentissage maximal inférieur à 6e-4. L'une des raisons est que le chargement des données de Levanter utilisé à l'époque ne mélangeait pas complètement les données ; en reproduisant les expériences, les auteurs constatent qu'il faut un mélange complet pour pouvoir utiliser de façon stable un grand taux d'apprentissage. Dans leur cadre, Sophia n'apporte pas d'accélération significative en dessous de 0.5B.
- MARS (2 fois) : une référence similaire à celle de Sophia. Les figures de la première version de l'article MARS montraient d'ailleurs déjà qu'AdamW s'améliore nettement avec un taux d'apprentissage porté à 3e-3.
- Muon (2 fois) : environ 1.3 fois sur le NanoGPT speedrun. Kimi mesure 2 fois, mais avec un taux d'apprentissage d'AdamW trop bas, seulement 8e-4 à 9e-4 de 400M à 1.5B ; et la comparaison des MoE est faite avant la fin de la décroissance du taux d'apprentissage. L'étude indépendante d'Essential AI mesure une efficacité en tokens de 1.1 à 1.2 fois.
- SWAN, DION (2 à 3 fois) : comparaisons faites en dessous de 1× Chinchilla, où les accélérations sont naturellement plus grandes ; le coût de communication, point fort de DION, est absent de la comparaison de cet article.
- SPlus (2 fois) : taux d'apprentissage constant, sans décroissance, ce qui s'écarte des réglages habituels du préentraînement.
Une autre évaluation contemporaine
Un jour avant Fantastic, Semenov, Pagliardini et Jaggi, de l'EPFL, publient eux aussi sur arXiv Benchmarking Optimizers for Large Language Model Pretraining. Ils entraînent environ 2 900 modèles pour environ 30 000 heures de GPU et comparent, eux aussi, 11 méthodes, sur des modèles de 124M à 720M plus un MoE de 520M ; les données sont FineWeb, avec des séquences de seulement 512 tokens, et des lots allant de 16 000 à 2 millions de tokens.
Les deux études s'accordent sur bien des points, par exemple que la décroissance des poids ne doit pas valoir 0, que le taux d'apprentissage doit décroître suffisamment bas, et que les variantes d'AdamW à variance réduite comme MARS sont réellement utiles. La plus grande divergence concerne les optimiseurs matriciels. Semenov et al. trouvent qu'AdEMAMix et MARS battent Muon, avec une large avance des deux à 720M et des lots d'un million de tokens ; chez Fantastic, au contraire, Muon bat nettement MARS.
Fantastic analyse lui-même les raisons de cet écart dans sa section sur les travaux connexes.
- Taille de lot : les expériences les plus soigneusement réglées de Semenov et al., à 124M, n'utilisent que des lots de 16 000 et 130 000 tokens ; les lots retenus par Fantastic font tous au moins 400 000 tokens environ. MARS et AdEMAMix moyennent les gradients pour réduire le bruit, ce qui les avantage dans le régime de petits lots dominé par le bruit ; avec de grands lots, cet avantage se réduit.
- Matériel : l'EPFL semble utiliser surtout 1 à 8 H100, où les petits lots sont plus rentables ; Fantastic utilise 128 TPU, et il faut de grands lots pour en exploiter pleinement le parallélisme.
- Réglage : autour de 520M, les meilleurs taux d'apprentissage trouvés par Fantastic vont de 4e-3 à 8e-3, contre 1e-3 à 2e-3 pour l'EPFL, dont certains repris tels quels de petits modèles sans nouveau réglage ; Fantastic règle aussi séparément le taux d'apprentissage de l'embedding et celui des poids matriciels de Muon.
Les deux études se rejoignent aussi sur certains points. L'EPFL constate que Lion et Signum s'améliorent nettement avec de plus grands lots, mais décrochent de nouveau quand le modèle grandit ; Muon avec décroissance des poids reste stable dans toutes les configurations, alors que le Muon original se dégrade quand le modèle grandit.
À plus grande échelle
L'article lui-même compte ce plafond de 1.2B parmi ses limites. En juillet 2026, SOAP, Muon, and Beyond: Pushing LLM Pretraining Scales, de NVIDIA, pousse la comparaison jusqu'à plusieurs milliards de paramètres.
Leur cadre diffère beaucoup de celui de Fantastic.
- Modèles et données : un 8B dense, et des MoE de 30B paramètres au total pour 3B activés, et de 72B au total pour 8B activés ; entraînés sur 1 à 3 billions de tokens.
- Lots : environ 25 millions de tokens par lot comme base, puis 2, 3 et 4 fois plus ; le résumé mentionne jusqu'à environ 100 millions de tokens.
- Réglage : AdamW utilise la recette de production d'origine de Nemotron ; les taux d'apprentissage de Muon et de SOAP sont surtout convertis grâce à l'alignement de la RMS de mise à jour de Kimi, puis ajustés selon la règle de la racine carrée quand le lot grandit, sans balayage individuel comme chez Fantastic.
Muon et SOAP battent systématiquement AdamW, avec un écart maximal à grands lots. Quand le lot grandit, AdamW se dégrade, alors que Muon reste stable. Sur le MoE 30B, à lot égal, les résultats en aval de Muon sont pour la plupart égaux ou supérieurs, par exemple 58.19 contre 54.45 sur MMLU-Pro, et 82.52 contre 79.65 en moyenne sur les mathématiques ; sur le MoE 72B, Muon avec un lot double, face à AdamW avec un lot simple, gagne 4.5 points en moyenne sur le code, mais en perd 3.2 en moyenne sur les mathématiques. Une fois son instabilité à grands lots corrigée, SOAP obtient une perte légèrement inférieure à celle de Muon, et les auteurs recommandent de le privilégier quand la mémoire le permet.
Ces deux résultats peuvent coexister. Fantastic mesure l'efficacité en tokens après un réglage exhaustif, avec des lots où AdamW est à l'aise (environ 500 000 à un million de tokens) ; NVIDIA mesure qui tient encore quand le lot dépasse largement la taille de lot critique d'AdamW. Essential AI observe la même chose de 100M à 4B ; Muon atteint la même perte avec 10 % à 15 % de tokens en moins, et cet avantage se maintient ou s'élargit quand le lot grandit.
Autres observations et limites
Tous les optimiseurs partagent aussi quelques phénomènes. Avec décroissance des poids, la norme des paramètres monte puis redescend en suivant la planification du taux d'apprentissage ; pendant la décroissance du taux d'apprentissage, la norme du gradient augmente, sans que la perte se dégrade pour autant ; pour chaque optimiseur, perte d'entraînement et perte de validation évoluent de la même façon, et aucun ne se distingue par une meilleure généralisation.
Côté limites, les auteurs écrivent explicitement qu'ils ne vont pas au-delà de 1.2B. D'autres conditions sont à garder en tête. L'article ne compare que l'efficacité en tokens, sans compter le temps réel ni les communications ; il n'utilise qu'une seule recette de données et une architecture Llama dense ; et ses lots dépassent tous plusieurs centaines de milliers de tokens.
Conclusion
Par un réglage en trois phases, cet article amène chacun des 11 optimiseurs près de son optimum, puis convertit leur efficacité en tokens de 130M à 1.2B et de 1× à 8× Chinchilla. Une fois tout réglé, les optimiseurs matriciels les plus rapides gagnent environ 1.3 à 1.4 fois sur les petits modèles, mais seulement environ 1.1 fois à 1.2B ; les scalaires font à peu près jeu égal avec AdamW. Les « 2 fois » antérieurs venaient surtout de références faibles et de checkpoints intermédiaires.
En lisant un article d'optimiseur, vérifiez d'abord si le taux d'apprentissage d'AdamW a été balayé, si la comparaison porte sur des checkpoints de fin d'entraînement, et combien de tailles de modèle et de volumes de données les expériences couvrent. Avant de changer vous-même d'optimiseur, balayez aussi le taux d'apprentissage, la décroissance des poids et l'échauffement d'AdamW ; si vous partez d'un taux trop bas comme celui de la recette GPT-3, cette seule étape peut déjà économiser la moitié des étapes.
Quant à l'endroit où trouver ces animaux fantastiques, à en juger par les résultats de NVIDIA en 2026, ce serait plutôt du côté des lots de plus de 25 millions de tokens.