Article original
Shampoo: Preconditioned Stochastic Tensor Optimization
- Publication
- ICML 2018Conférence
- Premier dépôt sur arXiv
- arXiv:1802.09568
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizersshampoo2018,
  title = {{Shampoo: Preconditioned Stochastic Tensor Optimization}},
  author = {Vineet Gupta and Tomer Koren and Yoram Singer},
  year = {2018},
  eprint = {1802.09568},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1802.09568}
}
Le nom de cet article se cache dans une note de bas de page, en page 2, qui dit « We call it Shampoo because it has to do with preconditioning. »
Conditioner, c'est l'après-shampooing ; preconditioning, c'est donc « avant l'après-shampooing », autrement dit le shampooing. Les remerciements saluent d'ailleurs Roy Frostig pour avoir trouvé ce nom.
Plaisanterie mise à part, l'article s'attaque à un problème très concret. Un optimiseur qui veut voir comment les paramètres s'influencent les uns les autres doit maintenir une matrice dont la taille est le « carré du nombre de paramètres » ; Vineet Gupta et Tomer Koren, de Google Brain, et Yoram Singer, de Princeton, cherchent un moyen de ne jamais avoir à stocker réellement cette matrice.
Définir le problème
Ce que fait le préconditionnement
Dans la descente de gradient la plus simple, chaque paramètre avance dans la direction opposée au gradient, avec le même taux d'apprentissage pour tous. Une méthode de préconditionnement multiplie d'abord le gradient par une matrice avant de faire le pas :
Si est diagonale, chaque paramètre voit simplement son pas mis à l'échelle séparément ; Adam et AdaGrad appartiennent à cette famille. Si est une matrice pleine, elle peut en plus « faire tourner » le gradient. Quand le paysage de la perte forme une vallée étroite et oblique, deux paramètres doivent bouger ensemble pour avancer le long du fond de la vallée ; une matrice diagonale ne peut que mettre à l'échelle chacun des deux axes séparément, et seule une matrice pleine peut redresser cette vallée oblique.
AdaGrad à matrice pleine, c'est trop gros
AdaGrad existe en version à matrice pleine (full-matrix), dont le préconditionneur est la racine carrée de la somme des produits extérieurs des gradients :
Ses propriétés théoriques sont meilleures que celles de la version diagonale, mais personne n'a les moyens de s'en servir. Prenons une couche entièrement connectée de . Une fois aplatie, elle compte 1.05 million de paramètres ; fait alors , soit environ éléments, plus de 4 To en simple précision ; et il faut à chaque fois en prendre la racine carrée puis l'inverser, pour un coût de calcul en .
Il existait alors plusieurs échappatoires. L'approximation diagonale est bon marché, mais elle jette toutes les corrélations entre paramètres ; les sketches et autres méthodes d'estimation sont jugés par les auteurs « seldom practical at large scale ». K-FAC utilise lui aussi une factorisation de Kronecker, mais c'est la matrice de Fisher qu'il approxime ; il faut échantillonner la distribution prédictive du modèle, et la méthode dépend de la structure de rétropropagation d'un réseau feed-forward, si bien qu'il faut tout redériver à chaque changement d'architecture.
Les paramètres d'un réseau de neurones sont déjà des matrices et des tenseurs, pour une couche entièrement connectée, quatre dimensions pour un noyau de convolution. Peut-on garder cette forme, et approximer cet énorme préconditionneur avec quelques petites matrices ? C'est la question de l'article.
Résoudre le problème
Un à gauche, un à droite
Dans le cas matriciel, Shampoo maintient deux préconditionneurs pour une matrice de poids , l'un à gauche de taille , l'autre à droite de taille (Algorithm 1) :
Les valeurs initiales sont et . accumule les corrélations entre les « lignes », c'est-à-dire, pour une couche entièrement connectée, entre les unités de sortie ; accumule celles entre les « colonnes », c'est-à-dire entre les caractéristiques d'entrée. Lors de la mise à jour, le gradient est multiplié une fois à gauche et une fois à droite.
Pour la même couche , et totalisent 2.1 millions d'éléments, soit 8 Mo en simple précision. La mémoire passe de à , et le coût des puissances de matrices de à .
Ces deux petites matrices sont en fait une grande matrice déguisée. Le Lemma 4 de l'article donne une identité sur le produit de Kronecker. Une fois aplati, est égal à multiplié par le gradient aplati. Shampoo utilise donc un préconditionneur , , sauf que cette matrice n'est jamais assemblée.
En code, la mise à jour d'un paramètre matriciel tient en quelques lignes :
import torch

def matrix_power(A, p):
    """Puissance p d'une matrice symétrique définie positive : on diagonalise et on n'élève que les valeurs propres à la puissance p"""
    lam, Q = torch.linalg.eigh(A)
    return Q @ torch.diag(lam ** p) @ Q.T

class ShampooMatrix:
    """Algorithm 1 : Shampoo pour une matrice de poids m×n"""
    def __init__(self, m, n, lr, eps=1e-4):
        self.L = eps * torch.eye(m)   # L_0 = εI_m
        self.R = eps * torch.eye(n)   # R_0 = εI_n
        self.lr = lr

    @torch.no_grad()
    def step(self, W, G):
        self.L += G @ G.T             # accumule la statistique gauche m×m
        self.R += G.T @ G             # accumule la statistique droite n×n
        W -= self.lr * matrix_power(self.L, -0.25) @ G @ matrix_power(self.R, -0.25)
L'implémentation de l'article est en TensorFlow et calcule les puissances de matrices par SVD ; le principe est le même.
Pourquoi 1/4
AdaGrad prend une racine carrée ; l'exposant ne devrait-il donc pas être ? Shampoo utilise pourtant , une fois à gauche et une fois à droite.
La réponse se trouve dans le Lemma 8. En supposant que la matrice de gradient de chaque étape est de rang au plus , les auteurs démontrent que :
Le membre de gauche est la statistique d'AdaGrad complet. La preuve se fait en deux temps. On montre d'abord séparément et , soit une borne supérieure de chaque côté ; puis, grâce à la monotonie de la moyenne géométrique matricielle, on élève chacune des deux bornes à la puissance avant de les multiplier. C'est de là que vient le premier .
Le préconditionneur d'AdaGrad prend en plus la racine carrée de la statistique. La racine carrée préserve l'ordre entre matrices semi-définies positives ; en élevant les deux membres à la puissance , on obtient
D'où , une moitié venant de la moyenne géométrique, l'autre de la racine carrée d'AdaGrad. Le de Shampoo est une matrice à structure de Kronecker qui majore le préconditionneur d'AdaGrad complet. Les auteurs soulignent que les petites valeurs propres du préconditionneur à matrice pleine, celles qui pèsent le plus sur l'effet du préconditionnement, ne disparaissent pas avec cette approximation.
L'article donne aussi une intuition. Cet exposant fait décroître le pas global en , le rythme habituel de l'optimisation stochastique. Quand l'amplitude des gradients est stable, et croissent à peu près linéairement avec le nombre d'étapes ; et apportent chacun , ce qui donne exactement .
Ce est un produit de la borne utilisée dans la preuve. Les implémentations ultérieures ont rendu l'exposant réglable et passent souvent à ; nous y reviendrons dans la discussion.
La version tensorielle
Un noyau de convolution a quatre dimensions. La forme générale de Shampoo (Algorithm 2) maintient, pour chaque dimension du tenseur, un préconditionneur de taille , dont la statistique est la matrice obtenue en contractant le gradient selon toutes les autres dimensions ; à la mise à jour, on multiplie dimension par dimension par , où est l'ordre du tenseur. Pour une matrice, , et l'on retrouve .
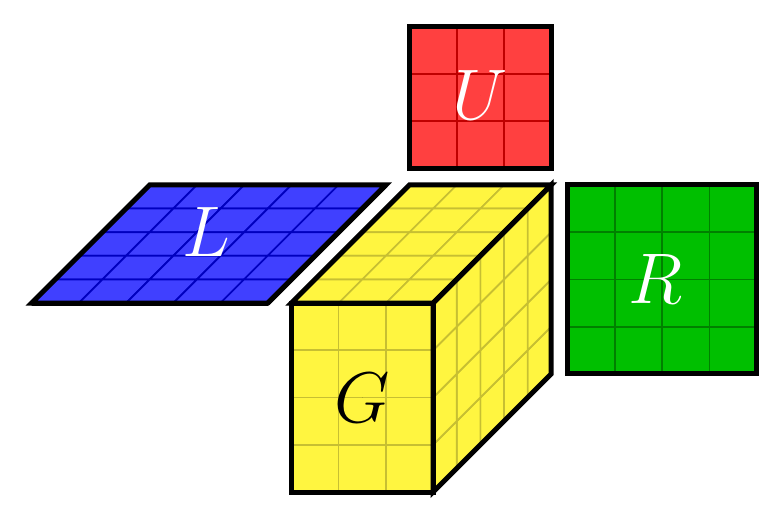
Prenons le plus gros noyau de convolution des expériences CIFAR-100 de l'article, . Il a 589 824 paramètres, et le préconditionneur d'AdaGrad complet compte environ éléments ; Shampoo n'a besoin que de quatre matrices, soit éléments, avec un exposant de .
La garantie de convergence et ses conditions
La théorie est démontrée dans le cadre de l'optimisation convexe en ligne (Theorem 7). Quand le rang des gradients ne dépasse pas , le regret est majoré par
est la distance maximale entre et la solution optimale au fil des itérations. Si la norme spectrale des gradients ne dépasse pas 1, les deux traces croissent chacune en , et le regret total est en , le meilleur rythme possible en optimisation convexe en ligne. La version tensorielle (Theorem 10) suit le même raisonnement, étant remplacé par la moyenne géométrique des rangs de chaque dimension.
Il faut lire les conditions attentivement. La perte doit être convexe ; peut croître avec , et pour le borner, il faudrait projeter dans une boule à chaque étape, avec la norme induite par . Cette projection coûte cher ; les auteurs l'omettent dans l'algorithme et acceptent une borne « slightly looser ». Les réseaux profonds ne sont pas convexes. Cette preuve donne l'origine et la motivation de l'algorithme, et ce sont les expériences qui en font la démonstration sur les réseaux de neurones.
Les compromis du passage à la pratique
L'implémentation fait deux compromis. Chaque tenseur de paramètres est traité séparément, ce qui donne au total un préconditionneur diagonal par blocs (block-diagonal) qui ignore les corrélations entre couches. Quand une dimension est trop grande (seuil d'environ 1200 dans les expériences), elle bascule automatiquement sur la version diagonale (Algorithm 3 de l'annexe A), et seuls les éléments diagonaux sont stockés. Les expériences ajoutent en outre deux ajustements heuristiques, des racines de matrices recalculées seulement toutes les 20 à 100 étapes, et un momentum de gradient de coefficient 0.9 ; selon les auteurs, le premier n'a « almost no impact » sur la précision.
Discussion
Des expériences à petite échelle
Toutes les expériences utilisent une taille de lot de 128, et les préconditionneurs sont mis à jour avec le gradient moyen de tout le lot. En classification d'images, il s'agit d'un ResNet à 32 couches de 2.4M paramètres et d'un petit Inception de 1.65M paramètres sur CIFAR-10, et d'un ResNet à 55 couches sans BatchNorm, de 13.5M paramètres, sur CIFAR-100 ; pour chaque optimiseur, 10 taux d'apprentissage entre 0.01 et 10 sont balayés. Pour cette partie, l'article ne trace que des courbes de perte d'entraînement, sans tableau comparatif de précision en test.
Côté modèle de langage, il s'agit d'un modèle Attention de 9.8M paramètres sur LM1B, dont le plus gros tenseur est .
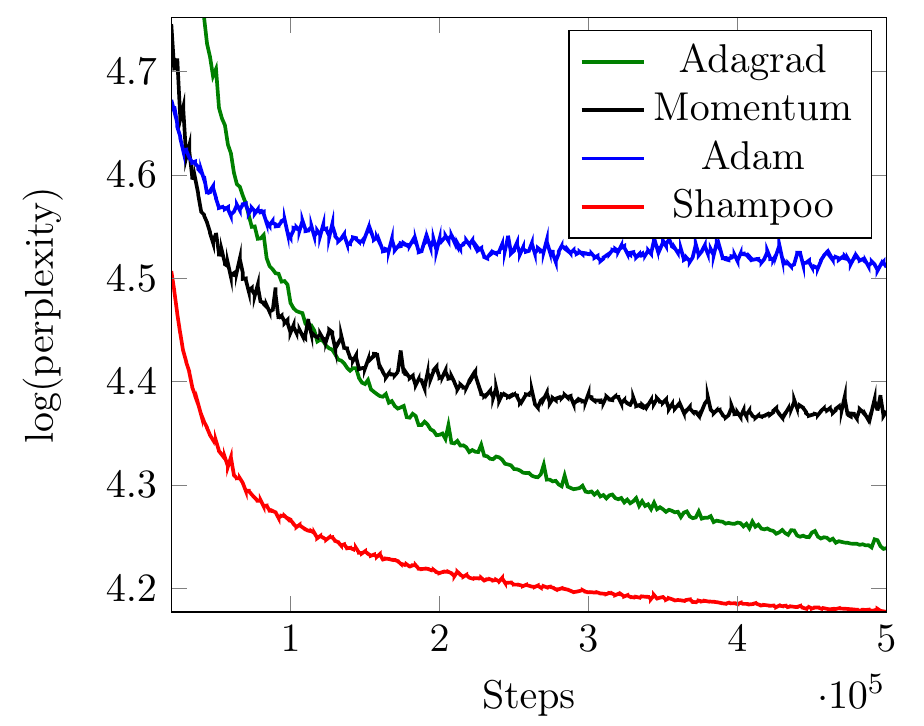
La courbe rouge est la plus basse dès le premier point et atteint environ 4.18 à 500 000 étapes ; AdaGrad, en vert, est vers 4.24, Momentum, en noir, vers 4.37, et Adam, en bleu, stagne très tôt autour de 4.5.
Les conditions de comparaison de cette figure ne sont pas symétriques. Shampoo utilise directement le taux d'apprentissage par défaut , alors que pour les autres méthodes, les auteurs « explored various different settings », sans préciser quelles valeurs ont été essayées pour Adam. Adam reste loin derrière AdaGrad sur ce modèle Attention. Selon notre lecture, cela cadre mal avec ce qu'on a observé ensuite, les Transformers étant couramment entraînés avec Adam, et l'écart vient très probablement de cette asymétrie de réglage ; c'est à garder en tête en lisant la figure.
Combien coûte chaque étape
À la question « les opérations matricielles ne sont-elles pas trop lentes ? », l'article répond par un tableau du nombre d'étapes par seconde (Tesla K40, lots de 128) :
| Expérience | SGD | Shampoo | Rapport |
|---|---|---|---|
| ResNet-32 (C10) | 2.184 | 2.151 | 98 % |
| Inception (C10) | 3.638 | 3.506 | 96 % |
| ResNet-55 (C100) | 1.210 | 1.249 | 103 % |
| Attention (LM1B) | 4.919 | 3.509 | 71 % |
D'après la Table 1 de l'article ; les rapports sont calculés pour cette note, et les chiffres d'Adam et d'AdaGrad, proches de ceux de SGD, sont omis.
Sur les réseaux convolutifs, la différence est presque nulle, et ResNet-55 va même un peu plus vite que SGD. Sur LM1B, le nombre d'étapes par seconde tombe à 71 % de celui de SGD, sans que l'article en analyse la cause ; le plus gros tenseur de ce modèle est , et avec le seuil d'environ 1200 utilisé dans les expériences, la dimension de 2000 passe à la version diagonale. Ces chiffres ont été mesurés sur des modèles de quelques millions de paramètres seulement, avec des racines recalculées toutes les 20 à 100 étapes.
Les Shampoo d'après
La version originale de 2018 était encore loin de l'entraînement à grande échelle. Les deux versions suivantes relèvent surtout de l'ingénierie.
Distributed Shampoo, d'Anil et al. (2020). Les trois auteurs de l'article d'origine figurent parmi les auteurs, et l'article s'intitule « Scalable Second Order Optimization for Deep Learning ». Ils constatent que le conditionnement de est énorme sur les modèles réels, si bien que les racines de matrices doivent être calculées en double précision, ce qui coûte cher sur TPU. Les modifications comprennent :
- à chaque étape, l'accélérateur se contente d'accumuler les statistiques ; toutes les étapes, les racines -ièmes inverses sont calculées de façon asynchrone sur les CPU de l'hôte, réparties sur tous les cœurs, sans bloquer la boucle d'entraînement ;
- les racines inverses sont calculées par itérations de Newton couplées (coupled Newton) au lieu de la SVD, avec un démarrage à chaud (warm start) ;
- les couches dont une dimension se compte en millions, comme l'embedding ou le softmax, ne sont préconditionnées que d'un côté, et les grandes couches entièrement connectées sont découpées en blocs préconditionnés séparément ;
- les préconditionneurs ne sont mis à jour que toutes les quelques centaines d'étapes ;
- le grafting, qui prend la direction de Shampoo et la taille du pas d'une méthode du premier ordre bien réglée (par exemple AdaGrad diagonal), avec une greffe couche par couche ;
- l'exposant devient un hyperparamètre réglable, et les statistiques passent à une moyenne mobile exponentielle.
Au final, sur la traduction anglais-français de WMT'14, le Transformer a besoin de deux fois moins d'étapes, et le temps réel (wall-clock) baisse de 45 % (d'environ 12 heures à 6.7 heures).
La version PyTorch de Shi et al. (2023). Une équipe de Meta la réécrit pour l'entraînement en parallélisme de données sur GPU. Chaque worker ne se charge du préconditionnement que d'une partie des blocs de paramètres, puis les directions sont rassemblées par AllGather ; le temps réel par étape dépasse d'au plus 10 % celui des méthodes diagonales. Les racines de matrices passent à torch.linalg.eigh, et l'équipe constate que la simple précision suffit généralement ; les petites dimensions sont fusionnées, les grandes découpées en blocs, avec une taille de bloc maximale de 2048 dans les expériences ImageNet ; grafting, correction du biais, décroissance des poids découplée et Nesterov sont tous de la partie. Sur ResNet-50 avec ImageNet, Shampoo atteint en 60 époques la précision de validation de SGD-Nesterov en 90 époques, pour un temps réel total 1.35 fois plus court.
AlgoPerf 2024. En août 2024, MLCommons publie les résultats de la première compétition d'algorithmes d'entraînement AlgoPerf ; le vainqueur de la catégorie à réglage externe est justement ce PyTorch Distributed Shampoo, avec un score de 0.78, soit environ 28 % plus rapide en moyenne que la référence NAdamW. Les détails de l'article d'analyse publié après la compétition sont plus instructifs. Sur les huit charges de travail, il n'est le plus rapide que sur deux, Criteo 1TB et ViT ; sur WMT, il met plus de deux fois le temps de la soumission la plus rapide ; sur ResNet, il n'atteint pas la cible de façon fiable dans le budget de temps. Il doit sa victoire à sa régularité, honorable sur presque toutes les charges.
La même année, le rapport technique de Gemini 1.5 indique aussi que 1.5 Flash « is trained with higher-order preconditioned methods », en citant AdaGrad entre autres, sans nommer la méthode.
1/4 ou 1/2
La question de l'exposant a fini par trouver sa réponse. Anil et al. écrivent en annexe que traiter l'exposant comme un hyperparamètre donne parfois de meilleurs résultats, et leurs expériences d'auto-encodeur utilisent justement ; l'implémentation de Shi et al. suggère, pour les réseaux surtout composés de couches entièrement connectées, de forcer l'exposant à , soit aussi , ou de multiplier l'exposant d'origine par 1.82. Selon l'explication de Morwani et al. (2024), est exactement le résultat d'une étape de la méthode de la puissance itérée pour « trouver la meilleure approximation de Kronecker de la statistique d'AdaGrad complet », et il est très proche de cette meilleure approximation. Puisque approxime déjà , il faut prendre de chaque côté pour imiter la puissance d'AdaGrad. À la lumière de Morwani et al. (2024), nous résumons le de l'article d'origine comme un exposant issu d'une borne pas assez serrée.
Le n'a pas été inutile pour autant. Retirons l'accumulation et regardons seulement le gradient de l'étape courante, :
Toutes les valeurs singulières sont ramenées à 1 ; c'est la mise à jour orthogonalisée de Muon. À la première étape de Shampoo, la statistique ne contient qu'un seul gradient, et quand ε est petit, la direction suivie est ; si l'on fait une étape avec le code ci-dessus sur un gradient aléatoire , le résultat ne diffère de que par le décalage dû à ε, le plus souvent de l'ordre de . Dans son billet de décembre 2024 qui présente Muon, Keller Jordan écrit lui aussi que Shampoo sans accumulation, avec du momentum en plus, c'est Muon ; la différence est que Shampoo calcule des racines quatrièmes inverses, alors que Muon les approxime à bas coût par itération de Newton–Schulz.
Conclusion
Shampoo approxime, par le produit de Kronecker de deux petites matrices, le préconditionneur impossible à stocker d'AdaGrad à matrice pleine ; la mémoire passe de à , et un regret en est démontré dans le cadre convexe. Les expériences de l'article ne dépassent pas la dizaine de millions de paramètres et montrent surtout que « chaque étape n'est pas beaucoup plus lente ».
Pour l'essayer aujourd'hui, prenez directement le Distributed Shampoo de Meta, et commencez les réglages avec un grafting sur Adam, un exposant de et des préconditionneurs mis à jour toutes les quelques dizaines d'étapes ; mesurez d'abord de combien la plus grande dimension de votre modèle ralentit chaque étape. Le code d'origine sert surtout à comprendre l'algorithme.
On lit en page 12 de l'article « We plan to implement Shampoo in PyTorch in the near future ». La version qui a remporté AlgoPerf est justement la version PyTorch écrite par l'équipe de Meta, cinq ans plus tard.