Article original
Symbolic Discovery of Optimization Algorithms
- Publication
- NeurIPS 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2302.06675
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizerslion2023,
  title = {{Symbolic Discovery of Optimization Algorithms}},
  author = {Xiangning Chen and Chen Liang and Da Huang and Esteban Real and Kaiyuan Wang and Yao Liu and Hieu Pham and Xuanyi Dong and Thang Luong and Cho-Jui Hsieh and Yifeng Lu and Quoc V. Le},
  year = {2023},
  eprint = {2302.06675},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2302.06675}
}
Commençons par un bout de code. Il écrête le gradient puis en prend l'arcsin, fait ensuite deux interpolations, dont l'une avec un coefficient de 1.109, supérieur à 1 ; une fois la mise à jour calculée, il remplace encore la variable de momentum par le cosh de la mise à jour.
Ce code n'a pas été écrit par un humain. Une équipe de Google Brain est partie d'AdamW et a laissé l'ordinateur modifier le programme au hasard, instruction par instruction ; au total, plus d'un million de candidats ont été produits, pour environ 3 000 jours de TPU v2, avant que celui-ci ne soit retenu. Une fois les instructions inutiles supprimées et le reste simplifié, il ne reste que quatre lignes, baptisées Lion (EvoLved Sign Momentum).
Ces quatre lignes ne stockent qu'un seul momentum, et la mise à jour de chaque paramètre ne regarde que le signe. Selon l'article, Lion fait gagner jusqu'à 2 % à ViT sur ImageNet, réduit jusqu'à 5 fois le calcul de préentraînement sur JFT, et pousse BASIC-L à 88.3 % en zero-shot sur ImageNet.
Le même article énumère aussi, avec une honnêteté appréciable, les cas où Lion ne gagne pas. Cette note se lit en deux moitiés. La première montre comment l'ordinateur a trouvé ces quatre lignes ; la seconde examine ce que le choix de « ne regarder que le signe » apporte, ce qu'il coûte, et comment Lion s'est comporté ensuite en préentraînement de modèles de langage.
Définir le problème
En 2023, les optimiseurs conçus à la main sont déjà nombreux, pour la plupart des méthodes adaptatives. Pourtant, pour entraîner de grands modèles de langage, de vision ou multimodaux, tout le monde utilise encore AdamW, ou Adafactor pour économiser la mémoire.
Les tentatives de faire trouver des optimiseurs par l'ordinateur ne manquent pas non plus, mais chacune bute sur un obstacle.
- Apprendre à optimiser (learning to optimize) : on entraîne un réseau de neurones qui produit directement les mises à jour des paramètres. Ces optimiseurs boîte noire n'ont appris que sur quelques petites tâches, et ne généralisent pas aux grands modèles ni aux longs entraînements.
- Recherche dans des arbres d'expressions : par exemple, en 2017, Bello et al. trouvent PowerSign et AddSign par apprentissage par renforcement. Pour que la recherche reste praticable, les opérandes sont fixés et la taille de l'arbre est limitée, si bien qu'on ne peut changer ni la façon d'accumuler le momentum, ni la façon dont il entre dans la mise à jour. L'article souligne que c'est précisément la partie la plus décisive de Lion.
- AutoML-Zero : toute la chaîne d'apprentissage automatique est confiée à la recherche, mais l'évaluation ne porte que sur des tâches jouets.
Les auteurs décomposent le problème en deux. D'abord, l'espace des programmes est infini, et les bons programmes y sont extrêmement rares ; sur une tâche proxy bon marché, ils ont tiré au hasard 2 millions de programmes, et le meilleur restait nettement derrière AdamW. Ensuite, la recherche ne peut évaluer que sur de petites tâches, alors que les tâches visées sont plus de dix mille fois plus grandes ; un programme qui gagne sur une petite tâche échoue souvent sur une grande.
Résoudre le problème
Écrire un optimiseur comme un programme
L'objet de la recherche est une fonction train. Elle prend en entrée les poids w, le gradient g, le taux d'apprentissage de l'étape lr, ainsi que deux variables initialisées à zéro, m et v, qui servent à garder l'historique ; elle renvoie la mise à jour à soustraire à cette étape. Voici AdamW écrit sous cette forme (Program 3 de l'article, sans correction du biais ni ) :
def train(w, g, m, v, lr):
    g2 = square(g)
    m = interp(g, m, 0.9)
    v = interp(g2, v, 0.999)
    sqrt_v = sqrt(v)
    update = m / sqrt_v
    wd = w * 0.01
    update = update + wd
    lr = lr * 0.001
    update = update * lr
    return update, m, v
interp(x, y, a) vaut (1 - a) * x + a * y, c'est-à-dire une moyenne mobile exponentielle. Cette signature ne garde volontairement, comme AdamW, que deux variables supplémentaires ; les algorithmes trouvés ne peuvent donc pas consommer plus de mémoire qu'AdamW.
Le corps de la fonction est une suite d'affectations, sans limite de longueur ni de nombre de variables locales ; chaque instruction appelle l'une de plus de quarante fonctions mathématiques courantes, qui correspondent pour la plupart à des fonctions NumPy ou à des opérations d'algèbre linéaire. Les conditions, les boucles et les fonctions définies par l'utilisateur ont aussi été essayées, sans meilleur résultat ; elles n'ont donc pas été retenues.
Il y a trois types de mutations : insérer une instruction au hasard, en supprimer une, ou changer un argument d'une instruction. Un argument peut être remplacé par une variable existante ou par une nouvelle constante ; une constante existante est multipliée par , avec tiré d'une loi normale standard. Les constantes sont les hyperparamètres de l'algorithme ; ci-dessus, par exemple, 0.001 est le taux d'apprentissage maximal et 0.01 la décroissance des poids.
Les programmes peuvent contenir des instructions redondantes, sans effet sur la sortie. Comme chaque mutation ne change qu'une instruction, ces instructions redondantes peuvent servir de marchepied quand un changement important demande la coordination de deux ou trois instructions.
Rendre la recherche praticable
La recherche utilise l'évolution régularisée (regularized evolution). La population compte en permanence 1 000 programmes ; à chaque tour, on en tire deux au hasard, on copie le meilleur et on le fait muter, le nouveau programme entre dans la population et le plus ancien en sort.
La population initiale est entièrement composée d'AdamW, avec deux types de redémarrage. L'un repart d'AdamW, pour gagner en exploration en multipliant les lancements ; l'autre repart du meilleur programme du moment, pour creuser plus loin. Les résultats varient beaucoup d'une recherche à l'autre, d'où la nécessité de multiplier les lancements. Face à un réglage des hyperparamètres d'AdamW et à une recherche aléatoire disposant chacun de quatre fois plus de calcul, la recherche évolutive l'emporte nettement.
Une autre clé des économies est l'exécution abstraite (abstract execution). Avant d'exécuter réellement un programme, on fait trois choses :
- inférer le type et la forme de chaque variable, rejeter d'emblée les programmes dont les types ou les formes ne concordent pas, et continuer à muter jusqu'à obtenir un programme enfant valide ;
- calculer une empreinte (hash) fonctionnelle de l'entrée à la sortie ; un programme sémantiquement identique mais écrit autrement est alors retrouvé dans une table, sans être réexécuté ;
- suivre les instructions dont dépend la sortie, pour repérer les instructions redondantes.
D'après les statistiques de cinq recherches de 300 000 programmes chacune, environ 70 % des instructions sont redondantes en fin de recherche, et les programmes sont en moyenne 3 fois plus courts une fois celles-ci supprimées ; le taux de succès du cache est d'environ 89 %, ce qui divise le coût de la recherche par environ dix.
Les tâches proxy sont toutes petites. En vision, il s'agit d'entraîner un ViT de 3 couches et de dimension 96 sur 10 % d'ImageNet, avec des images réduites à 64×64, une taille de lot (batch size) de 64 et 30k étapes ; en langage, un Transformer de 2 couches et de dimension 128 sur LM1B, pendant 20K étapes. Chaque programme est évalué en moins de 20 minutes sur un TPU v2, avec la précision de validation ou la perplexité comme fitness.
Chaque recherche tourne environ 72 heures sur 100 TPU v2 et produit 200 000 à 300 000 programmes, dont seulement 20 000 à 30 000 sont réellement exécutés grâce au cache. Cinq recherches, plus un redémarrage à partir du meilleur programme, coûtent au total environ 3 000 jours de TPU v2.
Des petites tâches aux grandes
La fitness de la recherche monte sans cesse, mais celle mesurée sur une tâche un peu plus grande se met à baisser ; l'article appelle cela meta-overfitting, un surapprentissage de la tâche proxy. Les auteurs ont lancé 50 recherches et noté à quel stade chacune commençait à surapprendre. La moitié surapprend très tôt, mais une longue traîne ne le fait que très tard, et plus une recherche surapprend tard, meilleurs sont ses programmes sur les grandes tâches.
Ils ajoutent donc à la recherche une sélection en entonnoir (funnel selection). À partir de la tâche proxy A, ils agrandissent le modèle et le nombre d'étapes pour obtenir une tâche B 10 fois plus grande ; seuls les programmes qui battent la référence sur B passent à une tâche C 100 fois plus grande.
Les programmes retenus sont ensuite simplifiés en trois temps. On supprime d'abord les instructions redondantes par exécution abstraite ; puis celles qui « ont un effet, mais dont la suppression change très peu de chose » (ce qui peut aussi se faire par une évolution qui interdit les insertions) ; enfin, un humain réordonne les instructions et renomme les variables pour aboutir à une forme simple, mathématiquement équivalente.
Du Program 4 aux quatre lignes de Lion
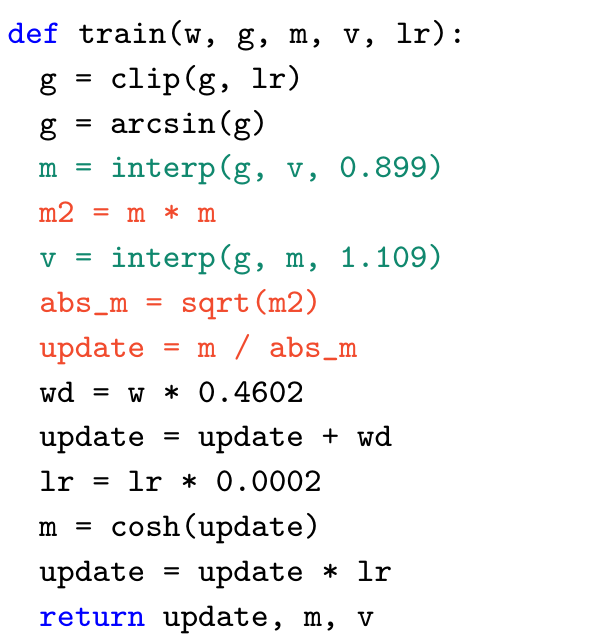
C'est l'étrange programme du début. Simplifions-le ligne par ligne.
- Les trois lignes rouges :
m2 = m * m,abs_m = sqrt(m2),update = m / abs_m, soit , c'est-à-diresign(m). clipetarcsin: les retirer ne dégrade pas la qualité, ils sont donc supprimés. Cette étape n'est pas équivalente à l'expression d'origine ;clipréduit tout le gradient selon sa norme à l'étape courante, avec un facteur qui change à chaque étape, et une fois le gradient entré dans l'interpolation du momentum, cela modifie encore le poids relatif de l'étape courante par rapport à l'historique. Leur suppression repose sur les résultats expérimentaux.- Le
coshfinal : il est écrit dansm, maismest réaffecté dès le début du tour suivant ; cette ligne n'a aucun effet. - Les deux lignes vertes :
mest l'interpolation du gradient courant et devavec 0.899, etvcelle du gradient et de ce nouveaumavec 1.109. En substituant la première ligne dans la seconde,vdevient une moyenne mobile de coefficient proche de 1, simplement écrite autrement ; l'article la réécrit avec . Quant àm, c'est l'interpolation du gradient courant et de l'historique avec environ 0.9, juste avant le passage par sign. - Les constantes :
0.4602est la décroissance des poids,0.0002la mise à l'échelle du taux d'apprentissage ; après simplification, elles deviennent deux hyperparamètres.
Par ailleurs, les moyennes mobiles d'Adam partent de 0, si bien que leurs estimations sont trop petites lors des premières étapes, et il faut une correction du biais pour que l'amplitude des mises à jour reste juste. L'article fait remarquer que la correction du biais ne change pas la direction ; or sign ne regarde que la direction, et cette étape a donc aussi été retirée.
Lion une fois mis au propre (Algorithm 2 de l'article) :
Par défaut, et . Par rapport à AdamW, il n'y a plus de moment d'ordre deux , plus de , plus de correction du biais. Dans l'implémentation PyTorch officielle (google/automl), une étape tient en ces quelques lignes :
p.data.mul_(1 - lr * weight_decay)                # décroissance des poids découplée
update = exp_avg * beta1 + grad * (1 - beta1)     # c_t : interpolation du gradient courant et du momentum
p.add_(update.sign_(), alpha=-lr)                 # on ne garde que le signe
exp_avg.mul_(beta2).add_(grad, alpha=1 - beta2)   # m_t : mise à jour du momentum avec beta2
Attention à l'ordre des deux dernières lignes. Les poids sont mis à jour avec , tandis que c'est qui est conservé pour l'étape suivante, et les deux utilisent des coefficients différents.
À quoi servent les deux β
Pourquoi deux β ? En développant , on peut calculer le poids de chaque gradient passé dans la direction de mise à jour. Le gradient courant pèse ; le gradient d'il y a étapes pèse , soit environ avec les valeurs par défaut. La figure ci-dessous trace la somme des poids des dernières étapes.
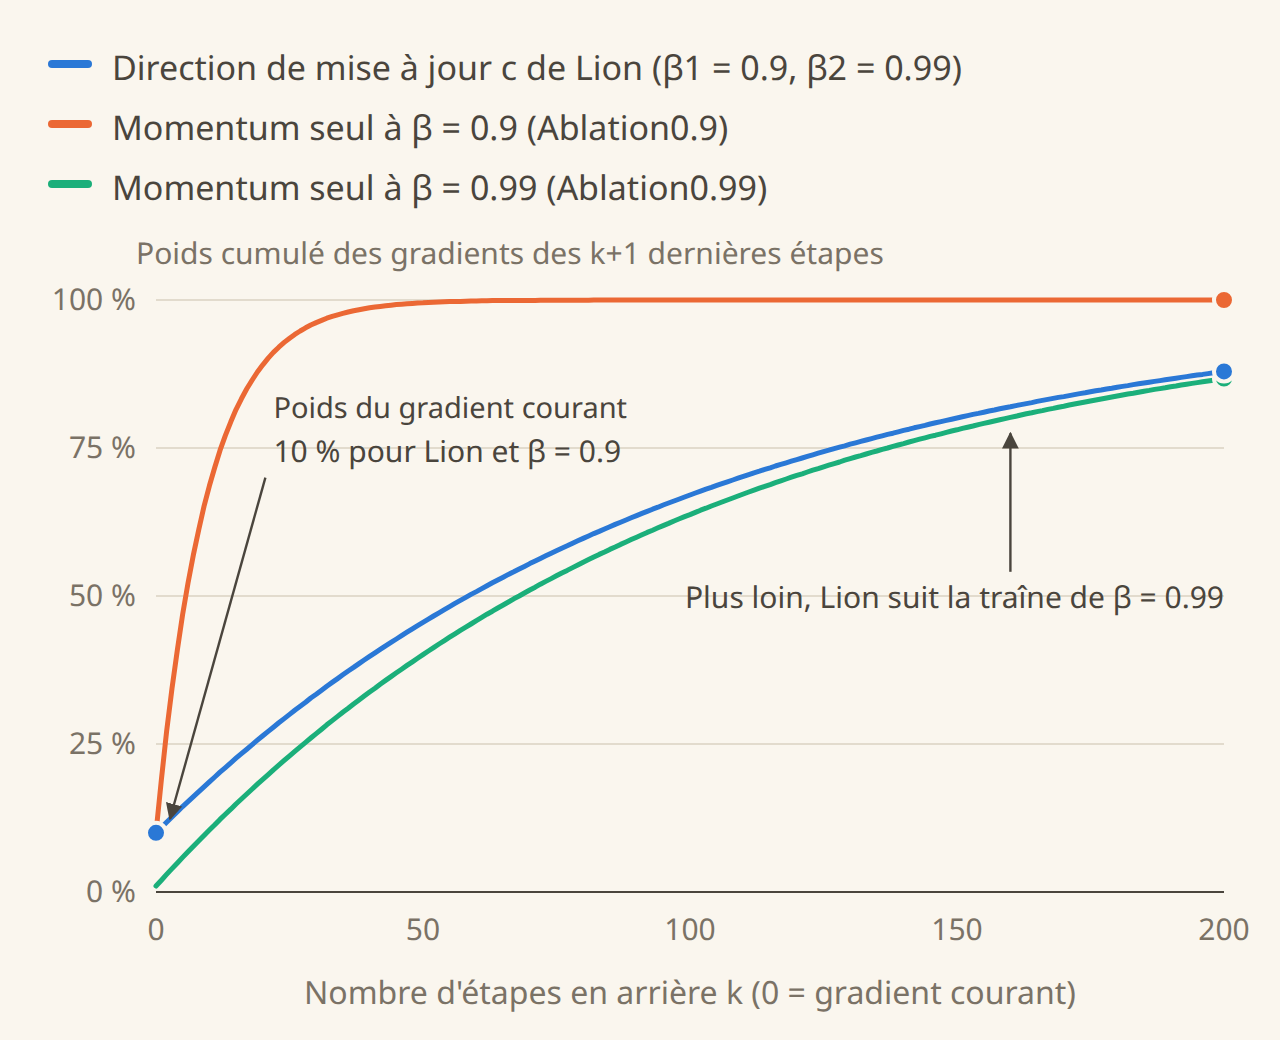
La courbe orange est un momentum unique à ; le gradient courant y pèse 10 %, mais seules les vingt ou trente dernières étapes sont retenues. La courbe verte n'utilise que ; sa mémoire est environ 10 fois plus longue, mais le gradient courant n'y pèse plus que 1 %. La courbe bleue de Lion prend les deux. Lors de la mise à jour, le gradient courant pèse 10 %, comme dans la courbe orange ; pour le passé, elle suit la longue traîne de la courbe verte.
Ce sont justement les courbes orange et verte que teste l'ablation de l'article. Sur ViT-B/16 (ImageNet, avec RandAug et Mixup), les deux versions qui prennent le signe d'un momentum unique atteignent 79.54 % () et 79.90 % (), toutes deux sous les 80.12 % d'AdamW, alors que Lion atteint 80.77 %. Sur le modèle de langage PG-19, la conclusion est la même.
C'est aussi là que Lion se distingue de signSGD (2018) et de sa version avec momentum. Tous deux prennent le signe, mais la règle d'accumulation du momentum diffère ; signSGD visait à réduire les communications en entraînement distribué, et se montre moins bon sur les réseaux convolutifs de classification d'images.
Ce que coûte le signe
Avec sign, la mise à jour a la même amplitude sur chaque coordonnée. Hors décroissance des poids, chaque paramètre bouge à chaque étape soit de , soit de .
La mise à jour d'Adam, , a une amplitude différente sur chaque coordonnée, et sa moyenne quadratique (RMS) globale est généralement inférieure à 1 ; Moonshot AI a mesuré 0.2 à 0.4 dans son article sur Muon. La sortie de sign ne contient que des ±1, d'où une RMS de 1, et une norme plus grande pour le vecteur de mise à jour. L'article recommande pour Lion un taux d'apprentissage 3 à 10 fois plus petit que pour AdamW, en réduisant dans la même proportion les taux initial, maximal et final ; les autres réglages, comme la planification du taux d'apprentissage ou l'écrêtage du gradient, restent inchangés.
Si le taux d'apprentissage diminue, la décroissance des poids doit suivre. La force réelle de la décroissance des poids découplée sur les poids est ; si est 3 à 10 fois plus petit, doit être 3 à 10 fois plus grand pour garder une force comparable. L'article donne quelques valeurs utilisées en pratique :
| Tâche | Lion (, ) | Référence (, ) |
|---|---|---|
| ViT-B/16, forte augmentation | 1e-4, 10.0 | AdamW 1e-3, 1.0 |
| Modèle de diffusion | 3e-5, 0.1 | AdamW 3e-4, 0.01 |
| Modèle de langage 7.5B | 1e-4, 0.01 | Adafactor 1e-3, 0.001 |
D'après le §5 de l'article.
En principe, les valeurs par défaut de suffisent ; seules les expériences sur les modèles de langage les ont réglées à part, avec et . D'après l'expérience des auteurs, un un peu plus petit, donc une mémoire un peu plus courte, rend l'entraînement plus stable.
Les avantages concernent la mémoire et la vitesse. Lion ne stocke qu'un momentum, AdamW deux. Pour ViT-B/16 en résolution 224 avec des lots de 4 096, AdamW a besoin d'au moins 16 TPU v4 pour tenir en mémoire, Lion de 8 seulement (les deux stockant leur momentum en bfloat16). Grâce à ses calculs simples, Lion fait aussi 2 % à 15 % d'étapes par seconde de plus qu'AdamW et Adafactor dans les expériences, selon la tâche, le code et le matériel.
Discussion
Toutes les comparaisons se font face à AdamW, ou face à Adafactor pour les grands modèles à mémoire contrainte ; SGD avec momentum n'est comparé que sur ResNet. Pour chaque optimiseur, le taux d'apprentissage maximal et la décroissance des poids sont réglés sur une échelle logarithmique. Par défaut, on utilise une décroissance en cosinus avec 10K étapes d'échauffement, et le momentum est stocké en bfloat16.
Classification d'images : la série la plus flatteuse
Entraînement à partir de zéro sur ImageNet (moyenne de trois lancements ; ResNet-50 avec des lots de 1 024 pendant 90 époques, les autres modèles avec des lots de 4 096 pendant 300 époques), extrait du Top-1 :
| Modèle | Augmentation | AdamW | Lion |
|---|---|---|---|
| ResNet-50 | Aucune | 76.34 | 76.45 |
| Mixer-B/16 | Aucune | 68.12 | 70.11 |
| ViT-B/16 | Aucune | 75.48 | 77.44 |
| ViT-B/16 | Oui | 80.12 | 80.77 |
| CoAtNet-3 | Oui | 84.45 | 84.87 |
D'après la Table 2 de l'article ; « Oui » désigne RandAug et Mixup. Pour ResNet-50, SGD avec momentum obtient 76.22.
La tendance est très cohérente. Moins l'architecture a de biais inductifs, comme ViT ou MLP-Mixer, plus l'écart est grand ; une forte augmentation de données le réduit ; sur le réseau convolutif ResNet-50, les trois optimiseurs sont presque à égalité.
Pour ViT, les auteurs expliquent que sign introduit une forme de bruit qui a un effet régularisant. Le ViT-B/16 entraîné avec Lion a une perte d'entraînement plus élevée (0.75 contre 0.61), mais une précision de validation supérieure de 2 % ; après ajout d'un bruit gaussien aux poids, la perte du modèle Lion (1.37) reste aussi bien inférieure à celle du modèle AdamW (3.74), signe qu'il a convergé vers une région plus plate. Cette explication ne repose pour l'instant que sur ces indices indirects.
Sur des données à grande échelle comme JFT, l'écart est encore plus net.
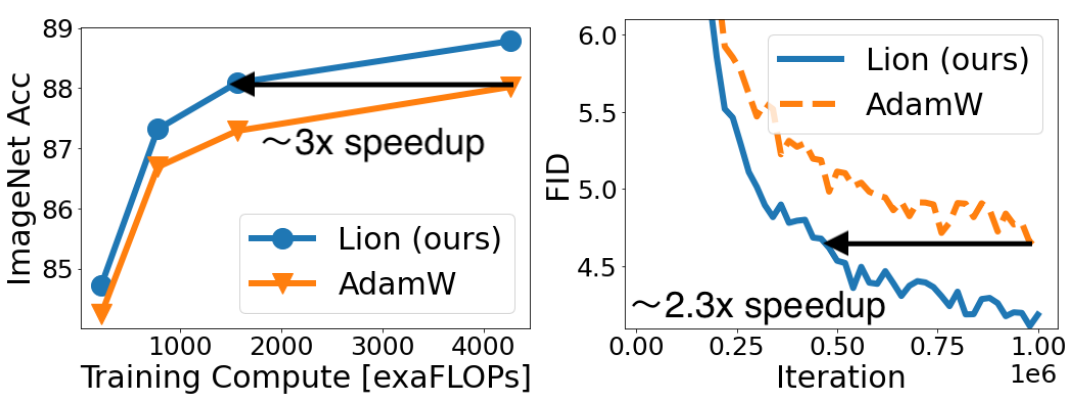
Sur le graphique de gauche, l'abscisse est le calcul de préentraînement et l'ordonnée la précision ImageNet après affinage ; les points des courbes couvrent ViT-B/16, ViT-L/16, ViT-H/14 et différents budgets de préentraînement. La flèche indique qu'un ViT-L/16 entraîné avec Lion rattrape déjà un ViT-H/14 entraîné avec AdamW, ce qui revient à diviser le calcul de préentraînement par 3 sur ImageNet et ImageNet V2, et par 5 sur ImageNet ReaL. Zhai et al. ont entraîné un ViT-L/16 avec AdamW jusqu'à 4 millions d'étapes, sans égaler Lion à 1 million d'étapes.
Après affinage, sur les jeux de test plus difficiles à décalage de distribution, le ViT-L/16 entraîné avec Lion creuse encore l'écart, avec 6.08 points de plus sur ImageNet-A et 5.54 sur ImageNet-R. Avec JFT-3B, le ViT-g/14 entraîné avec Lion dépasse le ViT-G/14 antérieur avec 1.8 fois moins de paramètres, et le ViT-G/14 de Lion atteint 90.71 %.
L'apprentissage contrastif image-texte progresse aussi. Avec LiT, qui gèle la tour image et n'entraîne que la tour texte, le zero-shot ImageNet gagne environ 0.7 à 1.1 point aux trois échelles. Pour BASIC-L, en passant à Lion aussi bien pour le préentraînement de la tour image que pour la phase contrastive, le zero-shot ImageNet monte de 85.7 % avec Adafactor à 88.3 %, 2.0 points au-dessus du record de l'époque ; après affinage, il atteint 91.1 %, 0.1 point au-dessus du record.
Modèles de diffusion : plus la résolution est haute, plus l'écart grandit
Le graphique de droite concerne la génération inconditionnelle sur ImageNet 256×256 (U-Net amélioré, lots de 2 048, taux d'apprentissage constant, échantillonnage DDPM en 1 000 étapes, sans guidance). Lion atteint le FID final d'AdamW dès 440 000 étapes, soit 2.3 fois moins d'étapes, avec un FID final de 4.1 contre 4.7. Il y a aussi un gain en 64×64 et 128×128, mais plus la résolution est haute, plus l'écart grandit.
Pour la génération d'images à partir de texte façon Imagen, les résultats sont mitigés. Le modèle de base 64×64 ne progresse pas nettement ; sur le modèle de super-résolution 64→256, Lion obtient un meilleur score CLIP et une courbe de FID moins bruitée.
Modèles de langage : à grande échelle, égalité
Les expériences à petite échelle utilisent Wiki-40B et PG-19, avec des modèles de 110M, 336M et 731M, des lots de tokens et 125 000 étapes d'entraînement. La perplexité de validation de Lion est toujours plus basse ; le modèle moyen obtient des accélérations de 1.6 et 1.5 fois respectivement, et le grand modèle atteint 2 fois sur PG-19.
À plus grande échelle, les choses changent. Sur un jeu de données de 1.6 billion de tokens, les auteurs entraînent à la manière de GPT-3 trois modèles de 1.1B, 2.1B et 7.5B, sur 300B tokens chacun, avec des lots de 3M tokens, face à Adafactor. Tout au long de l'entraînement, la perplexité des deux reste la même. Lion n'a qu'une petite avance sur les scores moyens des évaluations in-context en one-shot ; pour le modèle 7.5B, par exemple, la moyenne des tâches de génération passe de 24.1 à 24.7, et celle des tâches de compréhension de 61.3 à 61.7.
En modélisation de langage masqué (C4), la perplexité de Lion face à AdamW est de 4.18 contre 4.25, 3.42 contre 3.54 et 3.18 contre 3.25 ; après affinage de T5 sur GLUE, le score moyen gagne 0.4 à 0.5 point à chacune des trois échelles.
Taille de lot et tolérance au réglage
Prendre le signe amplifie le bruit du gradient ; intuitivement, Lion devrait avoir besoin de plus grands lots pour bien estimer la direction. Les auteurs l'ont mesuré directement.
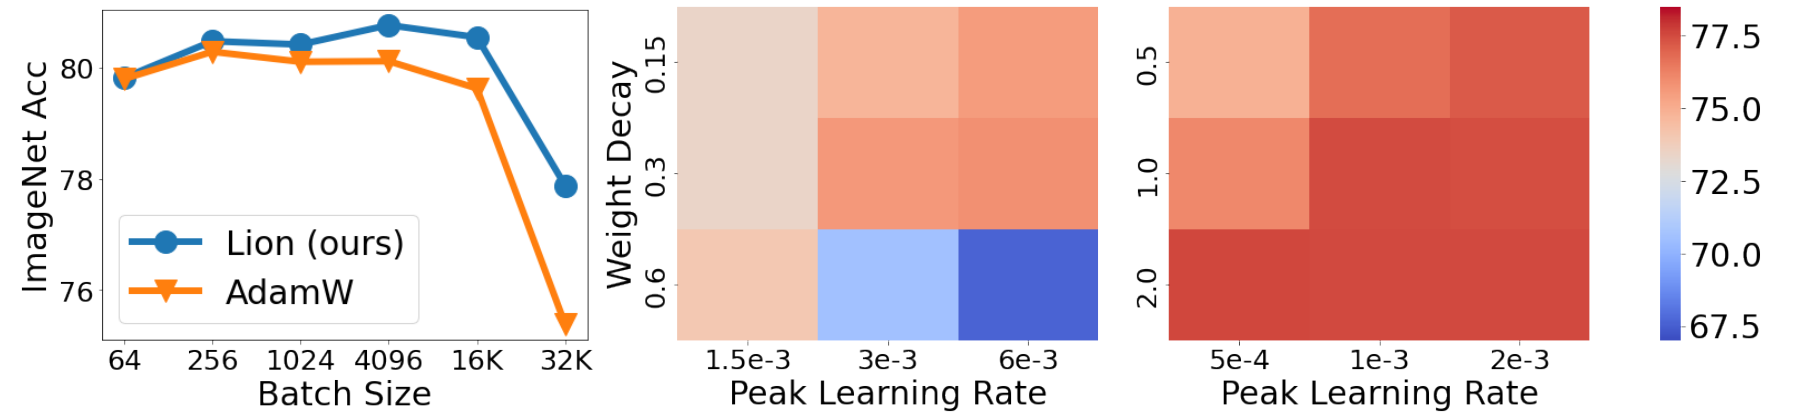
Le graphique de gauche fixe l'entraînement à 300 époques et fait varier la taille de lot. Le meilleur lot est 256 pour AdamW et 4 096 pour Lion, qui préfère donc bien les grands lots ; mais avec un lot réduit à 64, Lion ne s'effondre pas pour autant. Avec un lot porté à 32K (il ne reste que 11 000 étapes), Lion obtient 77.9 % et AdamW 75.4 %.
Les deux cartes thermiques, au centre et à droite, balaient chacune trois taux d'apprentissage et trois décroissances des poids. AdamW tombe vers 67.5 % dans le coin où taux d'apprentissage et décroissance des poids sont tous deux élevés ; parmi les neuf cases de Lion, seule celle où les deux sont au plus bas est nettement plus claire. Dans ce cadre, Lion est moins sensible aux hyperparamètres. Attention toutefois, les cases de chaque carte ont été choisies dans sa propre plage recommandée, et le taux d'apprentissage de Lion est de toute façon 3 à 10 fois plus petit.
L'article compare aussi RAdam, NAdam, AdaBelief, AMSGrad, ainsi que PowerSign et AddSign trouvés par AutoML (chacun avec son taux d'apprentissage et sa décroissance des poids réglés, le reste aux valeurs par défaut d'Optax). Sur ViT-B/16, ces références se situent entre 78.50 % et 80.32 %, sans vainqueur net, et Lion atteint 80.77 %. PowerSign et AddSign sont les deux plus mauvais, ce qui rejoint un vieux constat, selon lequel « les optimiseurs trouvés automatiquement se transposent mal aux tâches réelles ».
Les limites écrites par l'article lui-même
Dans la section 6, les auteurs énumèrent clairement les limites.
- Biais de la recherche : la conception de l'espace de recherche reste inspirée des optimiseurs du premier ordre, si bien que les résultats ressemblent facilement à des algorithmes existants, et les fonctions nécessaires aux méthodes du second ordre manquent ; la recherche coûte cher, et la simplification demande encore une intervention humaine.
- Tâches à écart faible ou nul : sur ResNet, les trois optimiseurs diffèrent très peu ; une forte augmentation absorbe le gain ; sur le modèle de base d'Imagen, sur la perplexité des modèles de langage entraînés sur le grand jeu de données interne, et en modélisation de langage masqué sur C4, Lion fait à peu près jeu égal avec AdamW. Selon les auteurs, le point commun est un grand volume de données de haute qualité.
- Lots trop petits : en dessous de 64, Lion peut ne pas faire mieux qu'AdamW.
- Mémoire : il faut toujours stocker un momentum en bfloat16, ce qui reste coûteux pour les très grands modèles.
En énonçant le point 2, les auteurs ajoutent que la perplexité peut être considérée comme une métrique plus fiable que les évaluations in-context. Autrement dit, sur la métrique que les auteurs eux-mêmes jugent la plus fiable, aucune différence n'apparaît pour les modèles de langage à grande échelle.
Les évaluations ultérieures
Le préentraînement des modèles de langage est ensuite devenu le principal champ de bataille des optimiseurs ; Lion a été retesté par plusieurs études indépendantes, qui ont toutes observé des gains inférieurs à ceux de l'article d'origine.
- Kaddour et al. (NeurIPS 2023) : en préentraînant BERT et T5 à budget de calcul fixe, les gains de Lion, de Sophia et d'autres méthodes disparaissent face à une référence dont le taux d'apprentissage décroît jusqu'au bout.
- Zhao et al. (ICLR 2025) : sur des modèles de langage autorégressifs de 150M à 1.2B, à part SGD, Adam, Adafactor, Lion et Sophia ont des performances optimales et une stabilité vis-à-vis du taux d'apprentissage comparables. Ils notent aussi que Lion avec n'est autre que Signum (signSGD avec momentum).
- Semenov et al. (septembre 2025) : Lion et Signum sont très mauvais avec de petits lots et s'améliorent nettement quand le lot grandit ; mais avec un modèle de 720M et des lots d'un million de tokens, ils décrochent de nouveau face aux autres méthodes.
- Wen et al. (septembre 2025) : une fois chaque optimiseur passé par un balayage complet de ses hyperparamètres, Lion est au plus 5 % plus lent qu'AdamW, parfois un peu plus rapide, et son retard grandit avec la taille du modèle. Les optima qu'ils trouvent permettent justement de vérifier les recommandations ci-dessus. Dans la configuration 130M, 1× Chinchilla, le meilleur taux d'apprentissage d'AdamW est 0.008, avec une décroissance des poids de 0.1 ; la meilleure combinaison du tableau de Lion est 0.002 et 0.7, et passer seulement le taux d'apprentissage à 0.001, ou seulement la décroissance des poids à 0.6, abaisse même la perte de 0.003. Un taux d'apprentissage 4 à 8 fois plus petit et une décroissance des poids 6 à 7 fois plus grande tombent bien dans la recommandation « 3 à 10 fois » de l'article Lion.
L'expérience des implémentations communautaires va dans le même sens. Le README de lion-pytorch, de lucidrains, consigne une série de retours d'utilisateurs. Avec le taux d'apprentissage d'Adam, Lion fait bien pire qu'Adam ; en divisant le taux d'apprentissage par 3, il gagne au contraire en début d'entraînement ; en appliquant directement la règle « 10 fois plus petit », on obtient le pire des essais. Le README conseille finalement de ne l'utiliser qu'avec des lots d'au moins 64, et note que les résultats négatifs apparaissent surtout dans des cadres que l'article n'a pas évalués, comme l'apprentissage par renforcement.
Conclusion
Lion est un optimiseur trouvé par recherche de programmes, puis simplifié à la main. Sa mise à jour est , le momentum étant accumulé à part avec ; chaque paramètre bouge à chaque étape d'une quantité fixe , et un seul momentum est stocké. Ses progrès les plus nets concernent ViT et JFT, l'apprentissage contrastif image-texte et les modèles de diffusion à haute résolution, et ils viennent tous avec des conditions, de grands lots, une architecture de type Transformer et une augmentation de données pas trop forte.
Pour remplacer AdamW par Lion, divisez le taux d'apprentissage par 3 à 10, multipliez la décroissance des poids par le même facteur, et vérifiez que les lots ne sont pas trop petits. Commencez ensuite le balayage à 3 fois, plutôt que d'appliquer directement 10 fois. Pour un modèle de langage, essayez d'abord et .
Partie d'AdamW, la recherche a évolué pendant 3 000 jours de TPU pour aboutir, en préentraînement de modèles de langage, à un optimiseur à peu près aussi rapide qu'AdamW. Au moins, l'état de l'optimiseur a été divisé par deux.