Article original
Adafactor: Adaptive Learning Rates with Sublinear Memory Cost
- Publication
- ICML 2018Conférence
- Premier dépôt sur arXiv
- arXiv:1804.04235
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizersadafactor2018,
  title = {{Adafactor: Adaptive Learning Rates with Sublinear Memory Cost}},
  author = {Noam Shazeer and Mitchell Stern},
  year = {2018},
  eprint = {1804.04235},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1804.04235}
}
Ouvrez la configuration d'entraînement de l'article T5 ; à la ligne de l'optimiseur, on lit « For optimization, we use AdaFactor ». Par la suite, l'affinage de FLAN et de Flan-T5, tout comme le préentraînement de PaLM et de ses 540 milliards de paramètres, l'utilisent aussi.
Revenons à la source. L'article d'Adafactor ne porte que sur une seule tâche expérimentale, un Transformer de traduction anglais→allemand, chaque entraînement prenant moins de deux heures sur un seul TPU v2. Noam Shazeer et Mitchell Stern le disent dès la première page, Adam est trop gourmand en mémoire.
Définir le problème
Adam stocke deux valeurs supplémentaires par paramètre, le moment d'ordre un et le moment d'ordre deux . Selon l'article, la mémoire est ainsi triplée, avec une copie pour les poids, une pour et une pour . Prenons la matrice de poids d'une couche feed-forward de ; elle compte 4 194 304 paramètres, et Adam doit stocker 8 388 608 valeurs de plus.
En 2018, les auteurs observent que la puissance de calcul progresse bien plus vite que la capacité mémoire, et que la mémoire est déjà l'une des limites à la taille des modèles. Si l'on ne compte que les poids et l'état de l'optimiseur, les deux copies supplémentaires d'Adam font que la même mémoire ne peut accueillir qu'un modèle trois fois plus petit.
Les auteurs visent quatre objectifs :
- réduire le moment d'ordre deux de valeurs à ;
- supprimer le moment d'ordre un, ;
- traiter l'instabilité qui apparaît une fois le momentum supprimé ;
- exprimer le pas comme une proportion de la taille des paramètres.
Les deux premiers économisent de la mémoire, le troisième règle les ennuis nés de ces économies, et le quatrième est une amélioration ajoutée au passage par les auteurs.
Résoudre le problème
Ne garder que les sommes de lignes et de colonnes
Supposons que les poids d'une couche forment une matrice ; Adam maintient pour elle une moyenne exponentielle des carrés du gradient de même taille. Si l'on ne stockait que deux petites matrices et , avec , la mémoire serait bien moindre. Reste à savoir comment factoriser.
L'approximation de rang faible la plus courante est la SVD tronquée, optimale pour la norme de Frobenius, mais elle pose deux problèmes. D'abord, les premiers vecteurs singuliers ne s'additionnent pas ; les vecteurs singuliers d'une somme de deux matrices n'ont pas de lien simple avec ceux de chacune, ce qui empêche de les raccorder à une moyenne exponentielle. Ensuite, les éléments de l'approximation peuvent être négatifs, alors qu'Adam doit prendre la racine carrée de puis son inverse.
Les auteurs se tournent vers la divergence KL généralisée, courante en factorisation en matrices non négatives, aussi appelée I-divergence :
Elle n'est jamais négative, et ne vaut 0 que lorsque . L'objectif est de minimiser sous la contrainte que et soient toutes deux non négatives. Un rang quelconque exige une optimisation alternée ; le cas du rang 1 admet une solution analytique (Lemma 1 de l'article) :
est la somme de chaque ligne, la somme de chaque colonne, et le dénominateur la somme de tous les éléments. En clair, l'estimation à la ligne et à la colonne vaut « somme de la ligne × somme de la colonne ÷ somme totale ».
Faisons le calcul sur un exemple :
Le coin supérieur gauche vaut , le coin inférieur droit ; la matrice entière est restituée à l'identique, car la deuxième ligne vaut exactement le tiers de la première, si bien que est elle-même de rang 1. Remplaçons le 2 du coin inférieur droit par 8 ; les sommes des lignes deviennent , celles des colonnes , le total 30, et l'estimation du coin inférieur droit tombe à . La factorisation retient l'ampleur globale de chaque ligne et de chaque colonne, mais pas le fait qu'une case ressorte particulièrement.
Cette solution n'utilise que les sommes des lignes et des colonnes, deux fonctions linéaires de ; « moyenner puis sommer » revient donc à « sommer puis moyenner ». En pratique, il suffit de tenir une moyenne exponentielle des sommes de lignes et une autre des sommes de colonnes, sans jamais reconstituer en entier. Pour la couche de , le moment d'ordre deux passe de 4 194 304 valeurs à 5 120.
Les auteurs écrivent la version avec sous la forme de l'Algorithm 2 :
La mise à jour se fait ensuite à la manière d'Adam, avec . Les biais et les autres paramètres vectoriels gardent le élément par élément d'origine ; ils sont de toute façon petits.
Supprimer le momentum, et tout casse
La deuxième étape est plus simple encore, , et l'on ne stocke même plus .
Toutes les expériences portent sur un Transformer de traduction anglais→allemand WMT'14, avec 100 000 étapes et des batchs d'environ 4 096 tokens source et 4 096 tokens cible, soit à peu près un huitième de ceux de l'article d'origine du Transformer. Chaque configuration est entraînée deux fois, une fois avec échauffement, avec un taux d'apprentissage , et une fois sans, en partant directement de . La métrique est le BLEU sur le jeu de développement newstest2013.
| Configuration | Avec échauffement | Sans échauffement |
|---|---|---|
| (A) Adam, | 25.6 | 0.1 |
| (B) Adam, | 25.4 | 23.1 |
| (C) Moment d'ordre deux factorisé, | 25.4 | 0.2 |
| (D) Moyennes des lignes seules | 25.2 | 0.3 |
| (E) Moyennes des colonnes seules | 0.3 | 0.5 |
D'après la Table 2 de l'article ; toutes les configurations utilisent .
Avec échauffement, supprimer le momentum (A contre B), puis factoriser le moment d'ordre deux (C), ne fait varier le BLEU que de quelques dixièmes. (D) et (E) sont deux témoins encore plus économes, qui ne stockent que les moyennes des lignes ou que celles des colonnes. Les moyennes des lignes font à peu près jeu égal avec la référence, les moyennes des colonnes cassent tout. Selon les auteurs, ce modèle partage une même matrice de poids entre les plongements de mots et le softmax de sortie, chaque ligne correspondant à un token ; la ligne d'un token fréquent a un gradient bien plus grand que celle d'un token rare, et ne garder que les moyennes des colonnes ramène tous les tokens à une même échelle.
Le problème se trouve dans la colonne de droite. Sans échauffement, (B), avec momentum, obtient encore 23.1, mais (A), sans momentum, s'effondre à 0.1.
Un moment d'ordre deux périmé
Les auteurs soupçonnent . Avec un petit , le moment d'ordre deux décroît vite, et Reddi et al. ont déjà montré que cela pose des problèmes de convergence ; avec un grand , l'estimation provient de gradients anciens, et ne suit plus quand le modèle évolue rapidement.
On observe les deux cas. Avec , on obtient 25.6 avec échauffement et 0.1 sans ; avec , 18.4 et 15.6, c'est stable mais médiocre.
Pour vérifier ce « décrochage », les auteurs définissent une grandeur :
est la mise à jour avant multiplication par le taux d'apprentissage. Si est bien estimé, le de chaque paramètre devrait être proche de 1, et la RMS de toute la matrice aussi.
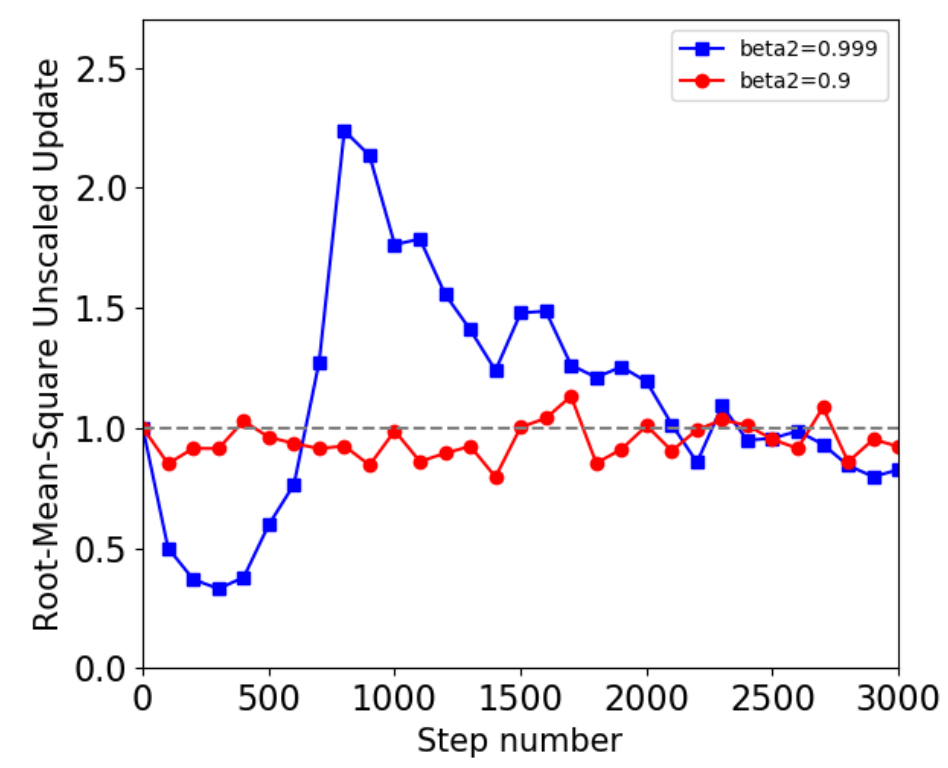
La courbe rouge, , reste autour de 1. La courbe bleue, , tombe d'abord vers 0.33 pendant les 300 premières étapes, avec des mises à jour plus petites que prévu ; puis, vers l'étape 800, elle grimpe à 2.24, avec des mises à jour plus de deux fois plus grandes que prévu. Les deux entraînements utilisent un échauffement et aucun ne finit par diverger ; ce n'est donc pas « l'entraînement qui s'effondre et fait grossir les mises à jour ». Selon les auteurs, ce sont les mises à jour trop grandes qui causent l'instabilité, et ils reconnaissent que cette figure n'est qu'un indice, pas une preuve.
Update clipping
Puisque le problème vient de mises à jour trop grandes, autant les limiter directement :
Si la RMS dépasse le seuil , la mise à jour de toute la matrice est réduite proportionnellement jusqu'à . C'est différent de l'écrêtage du gradient habituel. L'écrêtage du gradient limite le gradient, mais les méthodes comme Adam divisent ensuite paramètre par paramètre par ; dès que est périmé, un gradient écrêté peut encore être amplifié en une très grande mise à jour. L'update clipping limite directement le pas réellement appliqué au final.
Avec , le 0.1 obtenu sans échauffement remonte à 21.5 ; avec , le seuil est trop lâche, et l'on reste à 0.2. Avec échauffement, ajouter ou non l'écrêtage ne fait pas de différence notable.
Faire monter au fil des étapes
L'autre voie consiste à rendre petit au début et grand ensuite. Les auteurs remarquent d'abord que la correction du biais d'Adam équivaut déjà à un croissant :
Il vaut 0 pour , puis se rapproche progressivement de . Les auteurs proposent une autre planification :
Avec le retenu dans l'article, on obtient 0.84 à l'étape 10, 0.975 à l'étape 100, 0.996 à l'étape 1 000, on dépasse 0.999 vers l'étape 5 600, et l'on atteint 0.9994 à l'étape 10 000. En début d'entraînement, cela se comporte comme une décroissance rapide, donc stable ; plus tard, comme une décroissance lente, donc une estimation plus précise.
Cette planification a deux autres avantages. , si bien que les poids de tous les gradients passés somment exactement à 1, sans besoin de correction du biais. Par ailleurs, les auteurs montrent, à partir de la condition de convergence d'un produit infini, que seul garantit que le poids de chaque ancien gradient finisse par tendre vers 0 ; avec , monte trop vite, et les premiers gradients gardent durablement un poids non négligeable. correspond exactement à la moyenne arithmétique de tous les carrés de gradient.
| Configuration | Avec échauffement | Sans échauffement |
|---|---|---|
| (G) | 18.4 | 15.6 |
| (H) , écrêtage | 25.4 | 21.5 |
| (I) , écrêtage | 25.7 | 0.2 |
| (J) Factorisé, , écrêtage | 25.6 | 22.4 |
| (K) | 25.6 | 21.1 |
| (L) | 25.6 | 0.1 |
| (N) , écrêtage | 25.9 | 22.4 |
D'après la Table 2 de l'article ; toutes avec .
Utilisé seul, suffit à tenir sans échauffement ; seul ne suffit pas et doit être combiné à l'écrêtage. (N) obtient, avec échauffement, le meilleur score de tout le tableau, 25.9, et (J) montre qu'un moment d'ordre deux factorisé combiné à l'écrêtage atteint lui aussi une stabilité comparable à celle d'Adam avec momentum.
Pas relatif
La dernière pièce n'a rien à voir avec la mémoire. Le taux d'apprentissage d'Adam est un pas absolu ; les auteurs jugent la variation relative des paramètres plus importante, et multiplient donc le pas par la taille des paramètres eux-mêmes :
est la moyenne quadratique actuelle de cette matrice de paramètres, et un plancher qui permet aux paramètres initialisés à 0 de quitter l'origine. Les remerciements de l'article citent expressément l'avis de Geoffrey Hinton, selon qui l'entraînement se passe bien lorsque chaque mise à jour fait environ à fois la taille des paramètres.
Les auteurs testent trois initialisations des plongements de mots (50 000 étapes, batchs de 16 384 tokens, plongements non partagés avec le softmax). L'approche du Transformer d'origine initialise avec un écart-type de puis multiplie par au moment du calcul, de sorte qu'un même taux d'apprentissage absolu convient aux plongements comme aux autres poids ; Adam obtient 26.4, Adafactor 26.6. Avec des initialisations plus naïves, Adam tombe à 25.8 et 24.2, alors qu'Adafactor conserve 26.4 et 25.4. Quand l'échelle des paramètres est mal fixée, le pas relatif en souffre moins.
Assembler le tout
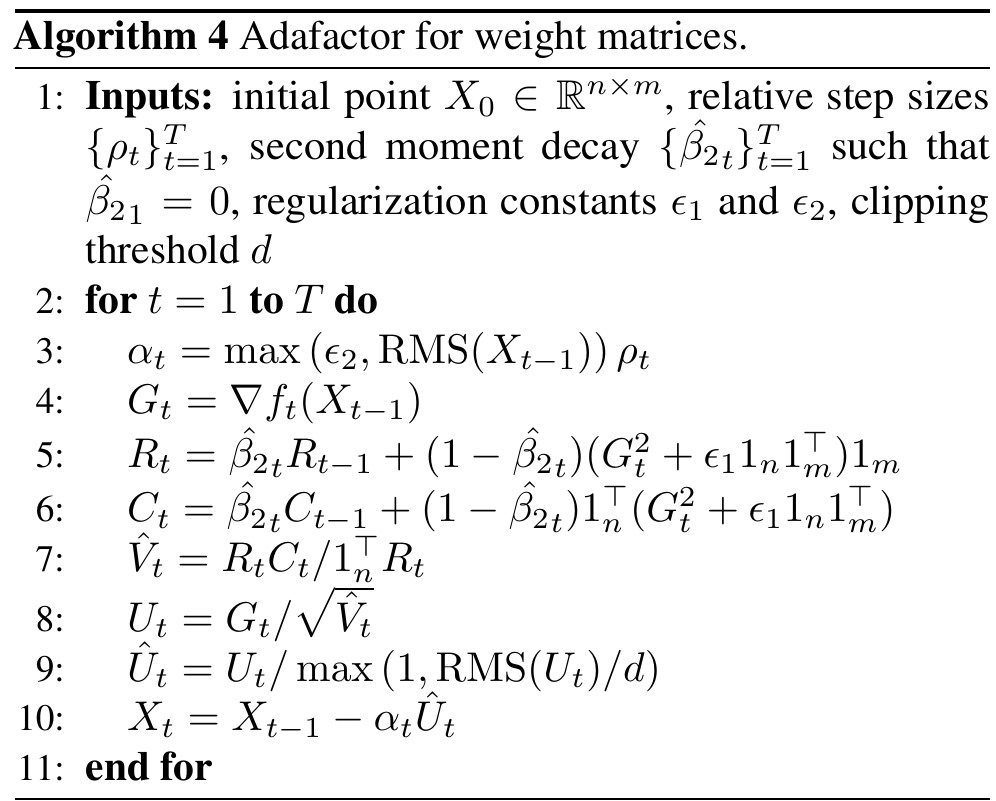
En enchaînant les cinq pièces, on obtient l'Algorithm 4. La ligne 3 est le pas relatif, les lignes 5 et 6 les moyennes des sommes de lignes et de colonnes, avec ajouté, la ligne 7 reconstitue le moment d'ordre deux, et la ligne 9 est l'update clipping. Les hyperparamètres recommandés par l'article sont , , , et , sans momentum. Pour une matrice , tout l'optimiseur ne stocke que valeurs supplémentaires.
Discussion
Les résultats de la version complète
| Configuration | Avec échauffement | Sans échauffement |
|---|---|---|
| (A) Adam, | 25.6 | 0.1 |
| (B) Adam, | 25.4 | 23.1 |
| (O) Adafactor | 25.0 | 25.5 |
| (P) Adafactor avec momentum rétabli | 24.9 | 25.3 |
| (Q) SGD, meilleur taux d'apprentissage | 24.3 | 9.1 |
D'après la Table 2 de l'article ; (O) et (P) utilisent le pas relatif ; pour (Q), avec échauffement et sans, tous les taux plus grands divergeant sans échauffement.
Sans échauffement, l'Adafactor complet obtient le meilleur score du tableau, 25.5 ; avec échauffement, il obtient 25.0, soit 0.6 de moins que (A), sans momentum, et 0.4 de moins que (B), avec momentum. Les auteurs reconnaissent eux-mêmes que les pas relatifs ne sont pas directement comparables à ceux des autres lignes, et qu'on ne peut pas affirmer que la stabilité vienne du pas relatif. SGD n'occupe pas non plus de mémoire supplémentaire, mais plafonne à 24.3 au mieux, et se montre très sensible au taux d'apprentissage.
Ces résultats ne viennent que d'une tâche de traduction, d'un seul modèle, de 100 000 étapes et de batchs huit fois plus petits que dans la configuration d'origine. L'article conclut que la mémoire économisée « devrait » permettre d'entraîner des modèles bien plus grands, mais ne présente aucune expérience sur un grand modèle, ni aucune mesure réelle de mémoire ou de vitesse.
Adafactor par la suite
Les vrais tests à grande échelle, ce sont d'autres qui les ont faits.
T5 adopte Adafactor directement ; son taux d'apprentissage de préentraînement, « constant à 0.01 pendant les 10 000 premières étapes, puis décroissant en racine carrée inverse », n'est autre que le de cet article. Les fichiers de configuration d'entraînement publiés par T5 reprennent aussi le de l'article, le seuil d'update clipping de 1.0, le moment d'ordre deux factorisé et la mise à l'échelle par les paramètres.
Pour Gopher, DeepMind a exploré une autre direction. À 1.4 milliard de paramètres, Adafactor est stable et pratique, mais à 7.1 milliards, de petites divergences de la perte commencent à apparaître ; le taux d'apprentissage maximal d'Adam est de , et Adafactor reste instable même ramené à . Ils finissent tout de même par affiner Gopher avec Adafactor, dont les besoins matériels sont bien plus faibles.
Pour entraîner ViT-G et ses 2 milliards de paramètres, Google juge Adafactor « inutilisable tel quel » et y apporte trois modifications : rétablir un moment d'ordre un en demi-précision, désactiver la mise à l'échelle du pas par la norme des poids, et plafonner à 0.999. Ainsi modifié, il fait jeu égal avec Adam, voire un peu mieux.
PaLM va plus droit au but. L'article précise qu'il utilise Adafactor « sans factorisation », ce qui revient à peu près à Adam avec mise à l'échelle par les paramètres ; momentum , moment d'ordre deux avec , et taux d'apprentissage de pendant les 10 000 premières étapes, puis décroissant en . Ils précisent que cette planification de est plus stable qu'une valeur fixe de 0.99, car les plongements des tokens rares ne permettent pas d'estimer correctement le moment d'ordre deux sur une fenêtre courte.
L'update clipping a lui aussi fait carrière seul. En 2023, Wortsman et al. constatent que les pics de perte (loss spikes) des grands entraînements CLIP surviennent toujours 1 à 8 étapes après que le moment d'ordre deux a sous-estimé le carré du gradient, et proposent StableAdamW, c'est-à-dire « AdamW avec l'update clipping d'Adafactor ». Ils écrivent aussi que l'Adafactor sous sa forme d'origine n'est plus guère utilisé pour les entraînements à grande échelle, et supposent que cela tient à la factorisation du moment d'ordre deux ou à l'absence de momentum.
Côté bibliothèques, Hugging Face Transformers propose Adafactor depuis longtemps, alors que PyTorch n'a ajouté torch.optim.Adafactor qu'à sa version 2.5. Les deux utilisent le pas relatif par défaut (on peut le désactiver chez Hugging Face) ; la version PyTorch traite lr comme la borne supérieure de , et indique que la position de s'écarte délibérément de l'article.
Conclusion
Adafactor ramène le moment d'ordre deux de à grâce à une factorisation de rang 1 par sommes de lignes et de colonnes, puis supprime le momentum. L'instabilité qui en résulte, les auteurs la font remonter à un moment d'ordre deux périmé, et la règlent avec l'update clipping et la planification de . Tout cela tient sur une tâche de traduction, et a ensuite tenu à l'échelle de T5 ; à plusieurs milliards de paramètres, Gopher le signale instable, et PaLM comme ViT-G y réintroduisent le momentum.
Si vous utilisez Adafactor dans Hugging Face en voulant contrôler vous-même le taux d'apprentissage, pensez à régler relative_step=False et scale_parameter=False. Sinon, l'optimiseur utilisera son intégré, ou multipliera encore votre taux d'apprentissage par la RMS des paramètres, et la planification que vous avez écrite ne s'appliquera pas telle quelle.
Dans l'Adafactor de PaLM, il ne reste même plus le « factor ».