Article original
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer
- Publication
- Journal of Machine Learning Research 2020Revue
- Premier dépôt sur arXiv
- arXiv:1910.10683
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{transformerst52019,
  title = {{Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer}},
  author = {Colin Raffel and Noam Shazeer and Adam Roberts and Katherine Lee and Sharan Narang and Michael Matena and Yanqi Zhou and Wei Li and Peter J. Liu},
  year = {2019},
  eprint = {1910.10683},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1910.10683}
}
Dans la seconde moitié de 2019, il sortait plus d'articles de préentraînement en NLP qu'on ne pouvait en lire.
BERT utilise un modèle de langage masqué, GPT-2 un modèle de langage de gauche à droite, XLNet un modèle de langage par permutation, et RoBERTa affirme que BERT n'avait simplement pas été assez entraîné. Chaque article changeait plusieurs choses à la fois : fonction objectif, architecture, données de préentraînement, nombre de pas d'entraînement, méthode d'affinage. Au final, les scores montaient, mais il était difficile de dire à quel élément en revenait le mérite.
Dans cet article, Raffel, Shazeer et leurs collègues de Google ont fait quelque chose de bête et méchant, et de très coûteux. Ils ont réécrit toutes les tâches dans un même format, fixé une configuration de référence, puis changé un seul facteur à la fois pour comparer les éléments un par un. Les comparaisons faites, ils ont combiné le meilleur choix pour chaque élément et l'ont porté à 11 milliards de paramètres, entraînés sur environ 1 000 milliards de tokens (en 2019, c'était un mastodonte ; aujourd'hui, ce serait tout juste un petit modèle).
Dès l'introduction, les auteurs précisent que le but de l'article n'est pas de proposer une nouvelle méthode, mais de dresser un état des lieux de tout le domaine. Ce modèle unifié s'appelle T5 (Text-to-Text Transfer Transformer). L'article publie aussi un corpus web nettoyé, C4, qui servira ensuite de données de préentraînement à de nombreux modèles de langage.
Définir le problème
En NLP, l'apprentissage par transfert (transfer learning) consiste à préentraîner sur de grandes quantités de texte non annoté, puis à affiner sur les données annotées de la tâche aval. En 2019, chaque étape de ce pipeline offrait plusieurs options, difficiles à comparer entre elles.
Les modèles à encodeur seul comme BERT excellent en classification ou pour repérer dans le texte source la position d'une réponse, mais ne savent pas générer directement une traduction ou un résumé. Les modèles de langage comme GPT savent générer, mais demandent généralement une tête de classification supplémentaire pour les tâches de classification. Dès que le modèle, la fonction de perte ou le mode de décodage diffèrent, les écarts mesurés mêlent d'autres variables.
Les auteurs avaient donc besoin d'un cadre commun capable de traiter à la fois classification, questions-réponses, traduction et résumé, pour faire passer toutes les tâches par le même modèle, la même fonction de perte et le même jeu d'hyperparamètres. Ce n'est qu'avec un tel cadre qu'on peut changer un seul facteur à la fois.
Résoudre le problème
Du texte en entrée, du texte en sortie
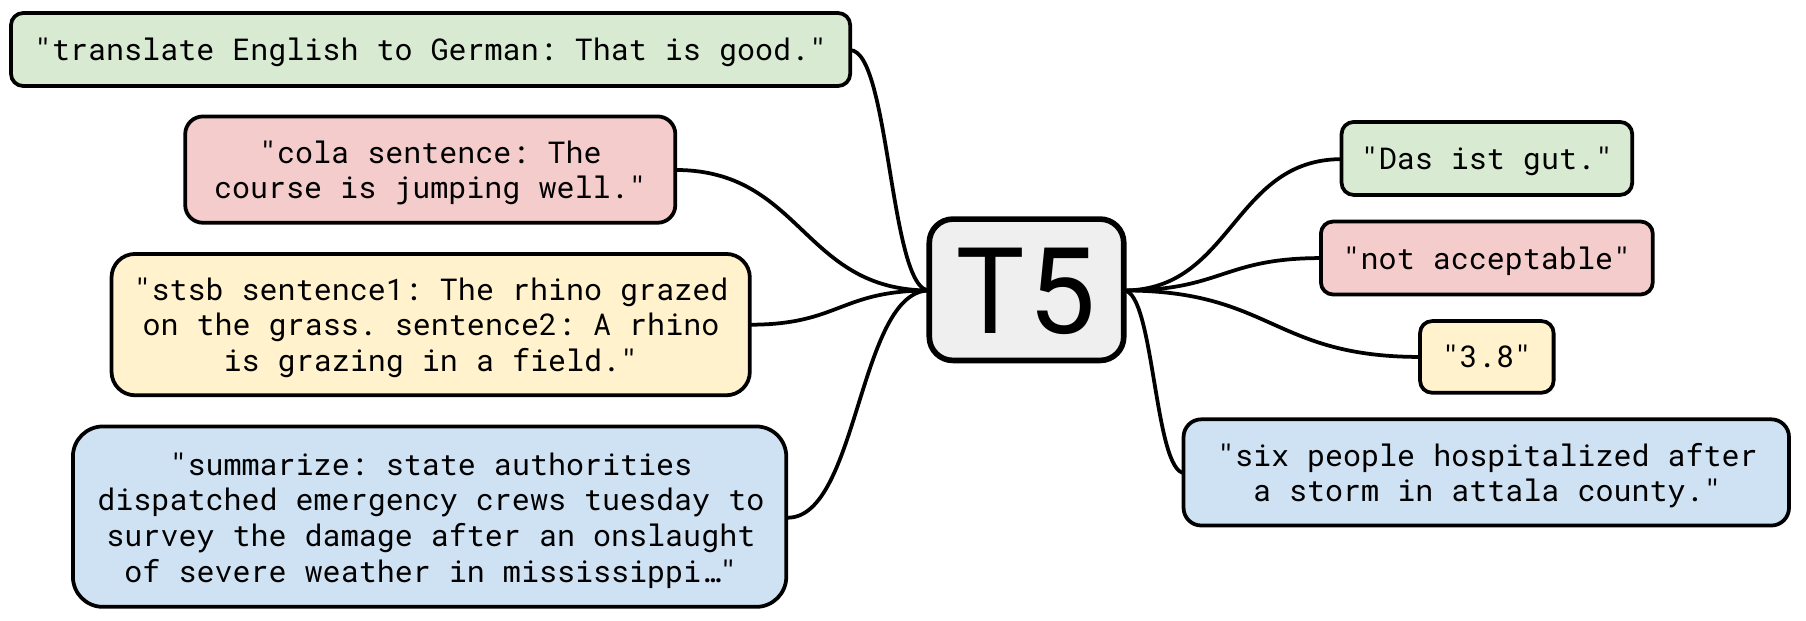
Chaque tâche est réécrite sous la forme « un texte en entrée, un texte en sortie », avec le nom de la tâche écrit en préfixe devant l'entrée. Pour la traduction, l'entrée est « translate English to German: That is good. », et le modèle est entraîné à produire « Das ist gut. ».
Les tâches de classification fonctionnent de la même manière, la sortie devenant simplement le nom de la classe. MNLI demande de déterminer la relation entre une prémisse et une hypothèse ; l'entrée est :
mnli premise: I hate pigeons. hypothesis: My feelings towards pigeons are filled with animosity.
La sortie cible est le mot entailment. Si le modèle produit un mot hors des options, par exemple « hamburger », la réponse est directement comptée comme fausse ; les auteurs disent n'avoir jamais observé ce cas en pratique.
Deux types de tâches demandent une conversion supplémentaire. STS-B demande de prédire la similarité entre deux phrases, un réel entre 1 et 5. Les auteurs ont remarqué que les annotations suivent pour la plupart des pas de 0.2 ; ils arrondissent donc le score au multiple de 0.2 le plus proche avant de le convertir en chaîne, par exemple 2.57 devient « 2.6 », et le problème de régression devient une classification à 21 classes. Pour les tâches de désambiguïsation de pronoms de type Winograd, le pronom ambigu est marqué par des astérisques, et le modèle doit produire le nom auquel il renvoie :
Entrée : The city councilmen refused the demonstrators a permit because *they* feared violence.
Sortie : The city councilmen
Toutes les tâches sont entraînées par maximum de vraisemblance, c'est-à-dire l'entropie croisée habituelle avec teacher forcing. La formulation du préfixe est en soi un hyperparamètre ; les auteurs ont essayé d'autres formulations, avec peu d'effet.
Le modèle : proche du Transformer d'origine
Le modèle est un Transformer encodeur-décodeur standard, que les auteurs ne modifient qu'en trois points :
- LayerNorm se contente de mettre à l'échelle, sans biais additif.
- LayerNorm est déplacée à l'entrée de chaque sous-couche, le chemin résiduel lui-même n'étant pas normalisé ; c'est ce qu'on appellera plus tard Pre-LN.
- L'encodage de position relative est simplifié en un scalaire, ajouté directement aux scores d'attention. Chaque tête d'attention a son propre jeu de valeurs, partagé par toutes les couches. Il y a 32 compartiments au total, dont les plages de distance croissent de façon logarithmique ; toutes les distances au-delà de 128 tombent dans le même compartiment. Une seule couche ne distingue pas les écarts de position au-delà de 128, mais plusieurs couches empilées y parviennent.
La couche de sortie partage ses poids avec l'embedding d'entrée, comme dans le Transformer d'origine. Les auteurs ne font pas d'ablation sur ces trois modifications, qui sont sans rapport avec les facteurs que l'article compare.
Le modèle de référence a 12 couches dans l'encodeur et 12 dans le décodeur, chaque pile ayant la taille de BERT-Base : , couche feed-forward , 12 têtes d'attention, avec par tête. Cela fait environ 220 millions de paramètres au total, à peu près deux fois BERT-Base, puisqu'il y a deux piles de réseau.
C4 : du texte web nettoyé
Common Crawl récupère chaque mois environ 20TB de texte de pages web, mais il s'agit surtout de menus, de messages d'erreur, de gabarits répétés ou de code. Les auteurs appliquent une série de règles à l'instantané d'avril 2019 :
- Ne garder que les lignes qui se terminent par un point, un point d'exclamation, un point d'interrogation ou un guillemet fermant.
- Jeter les pages de moins de 3 phrases ; ne garder que les lignes d'au moins 5 mots.
- Supprimer toute page qui contient un mot de la « liste de gros mots ».
- Supprimer les lignes contenant « Javascript » et les pages contenant « lorem ipsum ».
- Supprimer les pages contenant une accolade
{, le plus souvent signe de code. - Supprimer les marques de citation de Wikipédia, ainsi que les lignes contenant des chaînes comme « terms of use » ou « cookie policy ».
- Dédupliquer : tout passage de trois phrases consécutives qui apparaît plusieurs fois n'est conservé qu'une seule fois.
- Avec langdetect, ne garder que les pages dont la probabilité d'être en anglais atteint au moins 0.99.
Le résultat fait environ 750GB ; les auteurs l'appellent Colossal Clean Crawled Corpus, ou C4. Plus de trois ans plus tard, quand Meta a entraîné LLaMA, C4 représentait encore 15 % de ses données de préentraînement.
Configuration d'entraînement de référence
Le préentraînement dure pas, avec des lots de 128 séquences de longueur 512, soit, après empaquetage, environ tokens par lot, et environ milliards de tokens au total. C'est bien moins que les quelque 137 milliards de BERT ou les quelque 2 200 milliards de RoBERTa, mais cela suffit pour comparer les configurations ; et comme C4 est assez grand, aucune donnée n'est vue deux fois de tout le processus.
L'optimiseur est AdaFactor. Pendant les premiers pas de préentraînement, le taux d'apprentissage est fixé à 0.01, puis il décroît selon l'inverse de la racine carrée du nombre de pas. Chaque tâche aval est affinée pendant pas avec un taux d'apprentissage fixe de 0.001 ; un checkpoint est sauvegardé tous les 5 000 pas, et l'on rapporte le meilleur sur l'ensemble de validation. Le vocabulaire compte 32 000 sous-mots entraînés avec SentencePiece, sur un mélange de C4 en anglais et de textes allemands, français et roumains dans les proportions 10:1:1:1, puisque les tâches aval comprennent ces trois traductions.
Objectif de préentraînement : ne prédire que les segments retirés
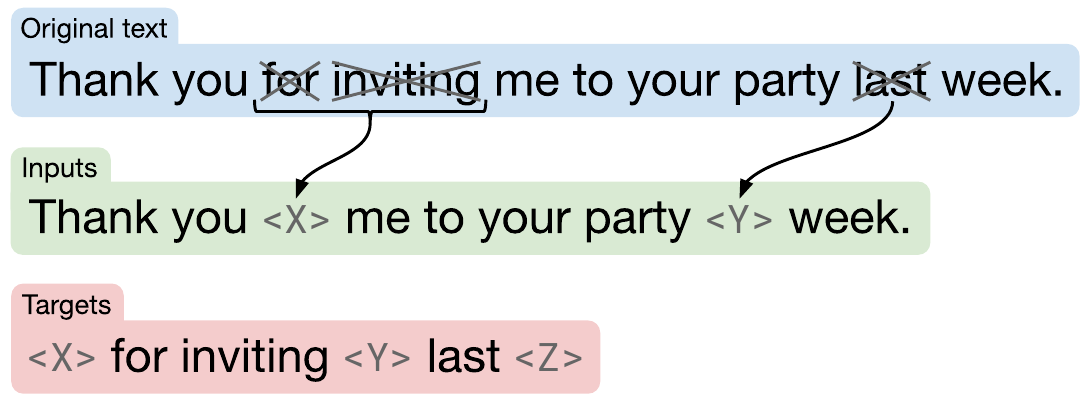
L'objectif de référence est dérivé du modèle de langage masqué de BERT. On choisit au hasard 15 % des tokens à corrompre ; les tokens corrompus consécutifs sont regroupés en un segment, remplacé par un unique token « sentinelle » (sentinel), différent pour chaque segment. La sortie ne contient que les segments retirés, chacun précédé de la sentinelle qui le remplace dans l'entrée, et une dernière sentinelle sert de marqueur de fin.
Écrivons-le en suivant l'exemple de la figure :
tokens = "Thank you for inviting me to your party last week .".split()
noise = [0, 0, 1, 1, 0, 0, 0, 0, 1, 0, 0]  # 1 = token choisi pour être corrompu

def span_corrupt(tokens, noise):
    sentinels = iter(["<X>", "<Y>", "<Z>"])
    inputs, targets, prev = [], [], 0
    for tok, n in zip(tokens, noise):
        if n and not prev:          # début d'un segment corrompu : on place une sentinelle
            s = next(sentinels)
            inputs.append(s)
            targets.append(s)
        if n:
            targets.append(tok)     # un token corrompu n'apparaît que dans la sortie
        else:
            inputs.append(tok)
        prev = n
    targets.append(next(sentinels))  # une dernière sentinelle sert de marqueur de fin
    return inputs, targets

inputs, targets = span_corrupt(tokens, noise)
print(" ".join(inputs))    # Thank you <X> me to your party <Y> week .
print(" ".join(targets))   # <X> for inviting <Y> last <Z>
print(len(tokens), len(inputs), len(targets))  # 11 10 6
« for » et « inviting » sont adjacents et partagent donc un même <X>. La phrase d'origine compte 11 tokens, l'entrée n'en garde que 10, et la sortie n'en a que 6. Avec l'approche de BERT, qui consiste à « reproduire toute la phrase d'origine », le décodeur devrait générer 11 tokens. Les auteurs ont choisi de ne prédire que les segments retirés surtout pour économiser du calcul : plus la séquence du décodeur est courte, plus le préentraînement est rapide.
Le vrai T5 utilise comme sentinelles des tokens spéciaux comme <extra_id_0> ou <extra_id_1>, ajoutés au vocabulaire et ne correspondant à aucun sous-mot.
Quelle stabilité pour la référence ?
Répéter chaque expérience plusieurs fois coûterait trop cher. Les auteurs entraînent plutôt la configuration de référence 10 fois à partir de zéro, et prennent l'écart-type de ces 10 exécutions comme repère pour toutes les variantes. Pour la plupart des tâches, l'écart-type est inférieur à 1 % du score ; les petits jeux de données comme CoLA, CB ou COPA font exception, et pour CB, dont l'ensemble de validation ne compte que 56 exemples, l'écart-type du F1 atteint 3.2. Les tableaux de l'article mettent en gras tous les résultats situés à moins de deux écarts-types du meilleur score.
Si l'on entraîne le même modèle directement pendant pas, sans préentraînement, GLUE passe de 83.28 à 66.22 et SQuAD de 80.88 à 50.31. La traduction anglais-français n'est presque pas affectée (39.82 contre 39.77), car ce jeu de données est déjà assez grand à lui seul.
Discussion
Le corps de l'article est une longue série d'expériences contrôlées, de l'architecture aux objectifs, aux données, aux stratégies d'entraînement et au passage à l'échelle. Les tableaux rapportent la moyenne GLUE et SuperGLUE, le ROUGE-2 du résumé CNN/DM, le taux de correspondance exacte de SQuAD et le BLEU de trois paires de traduction ; à l'exception des résultats finaux, tout est mesuré sur les ensembles de validation.
Architecture : compter séparément paramètres et calcul
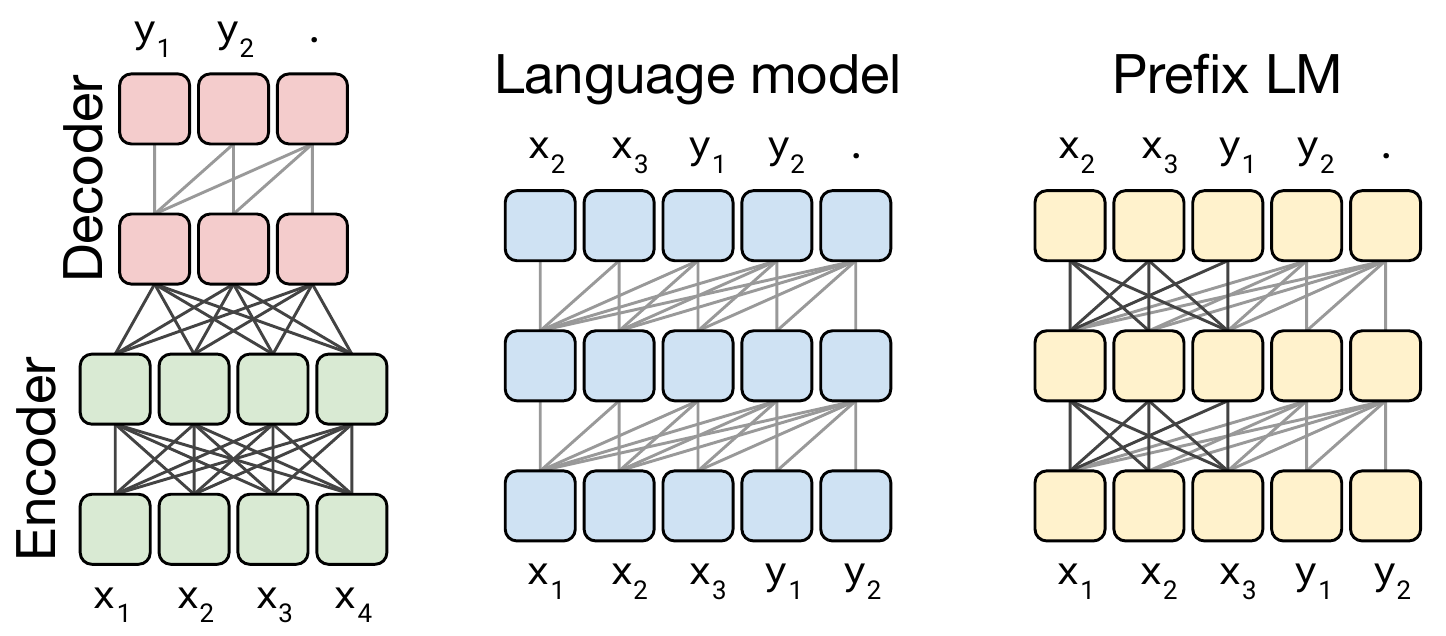
Dans la figure, les traits gris foncé représentent une attention entièrement visible, les traits gris clair un masque causal, qui ne laisse voir que les positions passées. Pour traduire, un modèle de langage doit concaténer entrée et sortie en une seule séquence : « translate English to German: That is good. target: Das ist gut. ». Le problème, c'est que le masque causal oblige aussi chaque position de la partie entrée à ne regarder qu'en arrière ; la représentation de la première moitié de la phrase ne voit pas la seconde. Le prefix LM rend la partie entrée entièrement visible, ce qui règle ce point. Pour les tâches de classification, le prefix LM ressemble en fait beaucoup à BERT, à ceci près que le résultat de classification est généré directement par la couche de sortie.
Avant de comparer les architectures, il faut définir ce qu'est une comparaison « équitable ». Un modèle encodeur-décodeur à couches de chaque côté a à peu près autant de paramètres qu'un modèle de langage à couches ; mais son coût de calcul ne correspond qu'à celui d'un modèle de langage à couches, car l'encodeur ne traite que l'entrée et le décodeur que la sortie, alors que le modèle de langage applique chaque couche à l'entrée et à la sortie réunies. D'après les mesures des auteurs, le temps par pas est presque identique dans les deux cas.
Si une pile de la taille de BERT-Base a paramètres et qu'une paire entrée-sortie demande FLOPs, on obtient les résultats suivants :
| Architecture | Objectif | Paramètres | Calcul | GLUE | SuperGLUE | SQuAD | BLEU anglais-allemand |
|---|---|---|---|---|---|---|---|
| Encodeur-décodeur | Débruitage | 83.28 | 71.36 | 80.88 | 26.98 | ||
| Encodeur-décodeur, paramètres partagés | Débruitage | 82.81 | 70.73 | 80.63 | 26.72 | ||
| Encodeur-décodeur, 6 couches chacun | Débruitage | 80.88 | 68.42 | 77.59 | 26.38 | ||
| Modèle de langage | Débruitage | 74.70 | 55.02 | 61.14 | 25.09 | ||
| Prefix LM | Débruitage | 81.82 | 68.11 | 78.94 | 26.43 | ||
| Encodeur-décodeur | Modèle de langage | 79.56 | 64.29 | 76.02 | 26.27 |
D'après la Table 2 de l'article ; sélection de lignes et de colonnes.
À coût de calcul égal, l'encodeur-décodeur avec objectif de débruitage est le meilleur sur toutes les tâches. Partager les paramètres entre encodeur et décodeur divise leur nombre par deux pour une perte de score minime, et fait encore mieux que le prefix LM, qui a le même nombre de paramètres ; les auteurs y voient l'utilité d'une attention encodeur-décodeur explicite. Diviser par deux le nombre de couches dégrade nettement les résultats. Autre résultat constant, l'objectif de débruitage bat l'objectif de modèle de langage sur toutes les architectures.
Objectif de préentraînement : peu d'écarts, prenez le moins cher
La comparaison des fonctions objectif se fait en trois tours. Le premier oppose trois grandes familles, le modèle de langage à préfixe (GLUE 80.69), le masquage à la BERT (82.96) et la remise en ordre d'une phrase mélangée (73.17). Le style BERT l'emporte, la remise en ordre est nettement derrière.
Le deuxième tour compare des variantes du style BERT, qui suppriment le remplacement aléatoire, remplacent chaque segment entier par une sentinelle, ou suppriment purement et simplement les tokens corrompus. Les quatre variantes obtiennent des scores très proches. Supprimer les tokens fait légèrement mieux sur GLUE, surtout grâce à CoLA (60.04 contre 53.84 pour la référence) ; les auteurs supposent que juger si une phrase est grammaticale a à voir avec le fait de repérer où il manque des mots. Mais cette variante fait moins bien que la version à sentinelles sur SuperGLUE.
Le troisième tour règle le taux de corruption et la longueur des segments. Entre 10 % et 25 %, la différence est faible ; à 50 %, GLUE et SQuAD baissent nettement. La corruption par segments se décrit avec deux paramètres. Dans une séquence de 500 tokens, corrompre 15 % donne 75 tokens ; si l'on impose 25 segments, chacun fait en moyenne 3 tokens. La version à longueur moyenne 3 fait légèrement mieux que la corruption aléatoire token par token sur la plupart des tâches hors traduction (SuperGLUE 72.53 contre 71.36), avec en prime des séquences plus courtes et un entraînement plus rapide.
La conclusion des auteurs est que, parmi les objectifs de débruitage essayés, les écarts de performance sont faibles, et qu'il faut choisir avant tout d'après le coût de calcul.
Données de préentraînement : le filtrage aide, un corpus trop petit s'apprend par cœur
Si l'on retire toutes les règles de filtrage de C4 (en ne gardant que la détection de langue), les données passent à 6.1TB et toutes les tâches se dégradent ; GLUE tombe de 83.28 à 81.46.
Des données plus petites mais centrées sur un domaine l'emportent sur certaines tâches. Wikipédia plus le Toronto Books Corpus (la combinaison utilisée par BERT, 20GB au total) fait monter SuperGLUE à 73.24, presque entièrement grâce à MultiRC : sa correspondance exacte bondit de 25.78 à 50.93, et la plus grande source de données de MultiRC est justement la fiction. La version RealNews-like, qui ne garde que le contenu des sites d'information, fait passer ReCoRD, une tâche de compréhension d'articles de presse, de 68.16 à 73.72. Plus le domaine de la tâche aval est proche de celui des données de préentraînement, meilleurs sont les résultats.
Le prix à payer, c'est la quantité de données. En imitant la méthode de WebText de GPT-2 (ne garder que les liens dont le score sur Reddit atteint au moins 3), 12 mois de Common Crawl ne donnent que 17GB. Les auteurs ont aussi délibérément tronqué C4, de sorte que l'entraînement sur les mêmes 34 milliards de tokens repasse plusieurs fois sur les mêmes données. Avec 64 répétitions, l'effet est faible ; avec 1 024, GLUE tombe à 79.55 ; avec 4 096, à 76.34, alors même que la perte d'entraînement est nettement plus basse, signe que le modèle commence à apprendre les données par cœur.
Stratégie d'entraînement : affiner tous les paramètres reste le mieux
Les méthodes qui ne mettent à jour qu'une partie des paramètres sont désavantagées. Les adapters ajoutent après chaque couche feed-forward un petit bloc « entièrement connecté-ReLU-entièrement connecté », et seuls ce bloc et LayerNorm sont entraînés. Avec une dimension interne , SQuAD tient encore à 79.32, mais la traduction anglais-allemand tombe à 13.84 BLEU. Pour les tâches à peu de données, un petit adapter suffit ; les tâches riches en données demandent une dimension bien plus grande. Le dégel progressif (gradual unfreezing), lui, entraîne un léger recul sur toutes les tâches.
L'apprentissage multitâche est simple dans le cadre text-to-text ; il suffit de mélanger dans un même lot des exemples de différents jeux de données. La difficulté est de fixer la part de chaque tâche. Les auteurs comparent trois façons de mélanger :
- Proportionnel à la taille des données : plus une tâche a de données, plus elle est échantillonnée, avec toutefois un plafond , pour éviter que les données non annotées et les grands jeux comme la traduction anglais-français n'écrasent les autres tâches.
- Mise à l'échelle par température : on élève la proportion de chaque tâche à la puissance , puis on renormalise ; revient au mélange proportionnel, et plus est grand, plus on se rapproche d'un mélange uniforme.
- Répartition égale : chaque tâche a la même probabilité d'être tirée.
La répartition égale est la pire, avec un GLUE de seulement 76.13. Avec le mélange proportionnel, la plupart des tâches ont un optimal ; la mise à l'échelle par température fonctionne le mieux avec . Mais aucune méthode de mélange ne rattrape le schéma « préentraînement non supervisé, puis affinage tâche par tâche ».
Un compromis fonctionne. Préentraîner sur le mélange multitâche, puis affiner sur chaque tâche, donne un GLUE de 83.11, proche des 83.28 de la référence, et la traduction anglais-roumain fait même légèrement mieux. Exclure la tâche cible du mélange de préentraînement (leave-one-out) ne fait baisser le score que légèrement, preuve qu'un modèle qui a vu beaucoup de tâches s'adapte encore à une tâche jamais vue. Préentraîner uniquement sur les tâches annotées, sans aucune donnée non annotée, dégrade nettement tout, sauf la traduction.
Avec 4 fois plus de calcul, que faire ?
Avec 4 fois plus de calcul, vaut-il mieux entraîner plus longtemps, agrandir le modèle ou faire un ensemble ? Les auteurs ont fait la comparaison.
| Approche | GLUE | SuperGLUE | SQuAD | CNN/DM | BLEU anglais-allemand |
|---|---|---|---|---|---|
| Référence | 83.28 | 71.36 | 80.88 | 19.24 | 26.98 |
| Même taille, 4 fois plus de pas | 85.33 | 74.72 | 82.45 | 19.33 | 27.08 |
| Même taille, lots 4 fois plus grands | 84.60 | 74.64 | 82.52 | 19.42 | 27.07 |
| Modèle 2 fois plus grand, 2 fois plus de pas | 86.18 | 77.18 | 84.18 | 19.66 | 27.52 |
| Modèle 4 fois plus grand, même nombre de pas | 85.91 | 78.04 | 83.86 | 19.73 | 27.47 |
| Ensemble de 4 modèles entraînés indépendamment | 84.77 | 71.74 | 83.09 | 20.10 | 28.05 |
D'après la Table 13 de l'article ; sélection de lignes et de colonnes.
Les quatre options aident toutes. Agrandir le modèle est généralement plus efficace que d'augmenter seulement la quantité d'entraînement ; un modèle 2 fois plus grand entraîné 2 fois plus longtemps et un modèle 4 fois plus grand font à peu près jeu égal. L'ensemble bat toutes les autres approches sur le résumé CNN/DM et sur les traductions anglais-allemand et anglais-roumain, mais n'aide presque pas sur SuperGLUE. Les auteurs rappellent aussi qu'un grand modèle rend plus chers l'affinage et l'inférence qui suivent ; le coût d'un entraînement prolongé d'un petit modèle, lui, peut se répartir sur de nombreuses tâches aval.
Tout assembler : T5
Le T5 final combine les conclusions de l'étude :
- Objectif : corruption de segments, 15 % des tokens, longueur moyenne de segment 3.
- Volume d'entraînement : 1 million de pas, lots de séquences de longueur 512, soit environ 1 000 milliards de tokens, 32 fois la référence. Les jeux de données centrés sur un domaine sont trop petits et seraient répétés des centaines de fois ; on reste donc sur C4.
- Tailles de modèle : Small (60 millions), Base (220 millions), Large (770 millions), 3B et 11B. 3B et 11B agrandissent surtout la couche feed-forward, avec un de 16 384 et 65 536 respectivement, et 32 et 128 têtes d'attention. Les auteurs expliquent avoir élargi la couche feed-forward parce que les TPU excellent avant tout dans les grandes multiplications de matrices denses.
- Préentraînement multitâche, puis affinage ; pour GLUE et SuperGLUE, l'affinage se fait sous-tâche par sous-tâche, avec des lots réduits à 8 pour éviter le surapprentissage sur les petits jeux de données.
- La traduction et le résumé passent à une recherche en faisceau (beam search) de largeur 4.
T5 atteint l'état de l'art de l'époque sur 18 des 24 tâches. Le 3B dépasse déjà les travaux antérieurs sur quelques tâches, et les auteurs estiment que le passage à 11B est l'étape la plus importante pour obtenir les meilleurs résultats. GLUE atteint 90.3 en moyenne ; SuperGLUE 88.9 en moyenne, contre 84.6 pour le meilleur résultat précédent et 89.8 pour les humains ; la correspondance exacte sur SQuAD vaut 91.26, contre 90.1 auparavant. Le ROUGE-2 sur CNN/DM est de 21.55, contre 20.30 auparavant.
Derrière les scores, il y a aussi des problèmes que les auteurs pointent eux-mêmes. T5 dépasse largement les humains sur MultiRC et ReCoRD, ce que les auteurs attribuent plus probablement à des métriques d'évaluation biaisées en faveur des sorties de machine ; les humains font 100 % sur COPA comme sur WSC, et T5 en reste encore assez loin. En traduction, il ne décroche aucun record. Le préentraînement n'utilise que de l'anglais, alors que les meilleurs systèmes de traduction de l'époque recouraient aussi à des augmentations de données comme la rétrotraduction (back-translation).
La dernière expérience mesure quelle part des progrès de T5 tient simplement à l'échelle. Le modèle de référence entraîné lui aussi sur 1 000 milliards de tokens (Baseline-1T) obtient GLUE 84.80, SuperGLUE 73.90 et SQuAD 83.01 ; T5-Base obtient 85.97, 75.64 et 85.44. Les deux ont la même taille et le même volume d'entraînement ; la seule différence tient aux modifications sans lien avec l'échelle retenues au fil de l'étude, et T5-Base l'emporte sur toutes les tâches.
Les vérifications qui ont suivi
Après sa publication, C4 a été très largement utilisé, et en 2021, Dodge et al. ont été les premiers à documenter C4 de façon relativement complète. Le domaine qui fournit à lui seul le plus de tokens est patents.google.com ; le contenu comprend du texte produit par traduction automatique, ainsi que des questions de test d'autres benchmarks NLP. Pour le résumé XSum, par exemple, 15.49 % des réponses de référence apparaissent telles quelles dans C4.
Ils ont examiné de près le contenu supprimé par la liste de gros mots. Parmi les documents supprimés, les groupes à dominante de contenu sexuel représentent environ 30 % ; le reste comprend des documents de sciences, de médecine, de santé, de droit et de politique. Classés avec un modèle thématique de dialectes, les documents en anglais afro-américain et en anglais hispanique sont supprimés à hauteur de 42 % et 32 %, contre seulement 6.2 % pour l'anglais blanc. Les documents qui mentionnent l'orientation sexuelle sont les plus susceptibles d'être filtrés ; une vérification manuelle d'un échantillon de documents supprimés liés à « gay » montre que 36 % d'entre eux ne sont ni offensants ni pornographiques. Le filtrage par mots-clés qui supprime la page entière ne coûte presque rien, mais ce qu'il supprime n'a rien de neutre.
Les conclusions sur l'architecture méritent aussi d'être confrontées aux travaux suivants. Les comparaisons de T5 se font dans le cadre « préentraînement, puis affinage sur chaque tâche ». En 2022, Wang et al., de BigScience, ont refait la comparaison dans un autre cadre. Si l'on ne regarde que les performances zero-shot après préentraînement, le décodeur causal avec un objectif de modèle de langage autorégressif est le meilleur ; après un affinage multitâche par prompts, c'est l'architecture à entrée entièrement visible, entraînée avec un objectif de masquage, qui l'emporte. Autrement dit, les conclusions de T5 valent dans son cadre ; si les grands modèles se sont ensuite massivement tournés vers des architectures à décodeur seul, c'est lié à l'importance croissante des usages zero-shot et few-shot.
Conclusion
Cet article se lit comme un très long manuel d'expériences. On commence par écrire toutes les tâches en texte-vers-texte, puis on change un seul facteur à la fois, de l'architecture aux objectifs, aux données, à l'affinage et à l'échelle, et chaque élément a son tableau à consulter.
Si vous ne voulez en retenir que quelques points, ce seraient à peu près ceux-ci. Les objectifs de débruitage se valent, prenez celui qui coûte le moins cher à entraîner ; les données de préentraînement doivent d'abord être nettoyées, et être assez grandes pour ne pas être vues plusieurs fois ; le calcul en plus, commencez par l'utiliser pour agrandir le modèle.
Quant à la règle « l'encodeur-décodeur est le meilleur », deux ans plus tard, même PaLM, chez Google, ne l'a pas suivie.