Article original
PaLM: Scaling Language Modeling with Pathways
- Publication
- Journal of Machine Learning Research 2023Revue
- Premier dépôt sur arXiv
- arXiv:2204.02311
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{transformerspalm2022,
  title = {{PaLM: Scaling Language Modeling with Pathways}},
  author = {Aakanksha Chowdhery and Sharan Narang and Jacob Devlin and Maarten Bosma and Gaurav Mishra and Adam Roberts and Paul Barham and Hyung Won Chung and Charles Sutton and Sebastian Gehrmann and Parker Schuh and Kensen Shi and Sasha Tsvyashchenko and Joshua Maynez and Abhishek Rao and Parker Barnes and Yi Tay and Noam Shazeer and Vinodkumar Prabhakaran and Emily Reif and Nan Du and Ben Hutchinson and Reiner Pope and James Bradbury and Jacob Austin and Michael Isard and Guy Gur-Ari and Pengcheng Yin and Toju Duke and Anselm Levskaya and Sanjay Ghemawat and Sunipa Dev and Henryk Michalewski and Xavier Garcia and Vedant Misra and Kevin Robinson and Liam Fedus and Denny Zhou and Daphne Ippolito and David Luan and Hyeontaek Lim and Barret Zoph and Alexander Spiridonov and Ryan Sepassi and David Dohan and Shivani Agrawal and Mark Omernick and Andrew M. Dai and Thanumalayan Sankaranarayana Pillai and Marie Pellat and Aitor Lewkowycz and Erica Moreira and Rewon Child and Oleksandr Polozov and Katherine Lee and Zongwei Zhou and Xuezhi Wang and Brennan Saeta and Mark Diaz and Orhan Firat and Michele Catasta and Jason Wei and Kathy Meier-Hellstern and Douglas Eck and Jeff Dean and Slav Petrov and Noah Fiedel},
  year = {2022},
  eprint = {2204.02311},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2204.02311}
}
« Google vient d'embaucher dans son équipe TPU une baleine très éloquente, et elle leur a montré comment communiquer entre deux pods différents ! »
Pour rire de ce jeu de mots, il faut savoir deux choses. En anglais, un pod est un ensemble de puces TPU, mais aussi un groupe de baleines. En avril 2022, dans la toute première figure de l'article sur PaLM, Google demande au modèle d'expliquer cette blague :
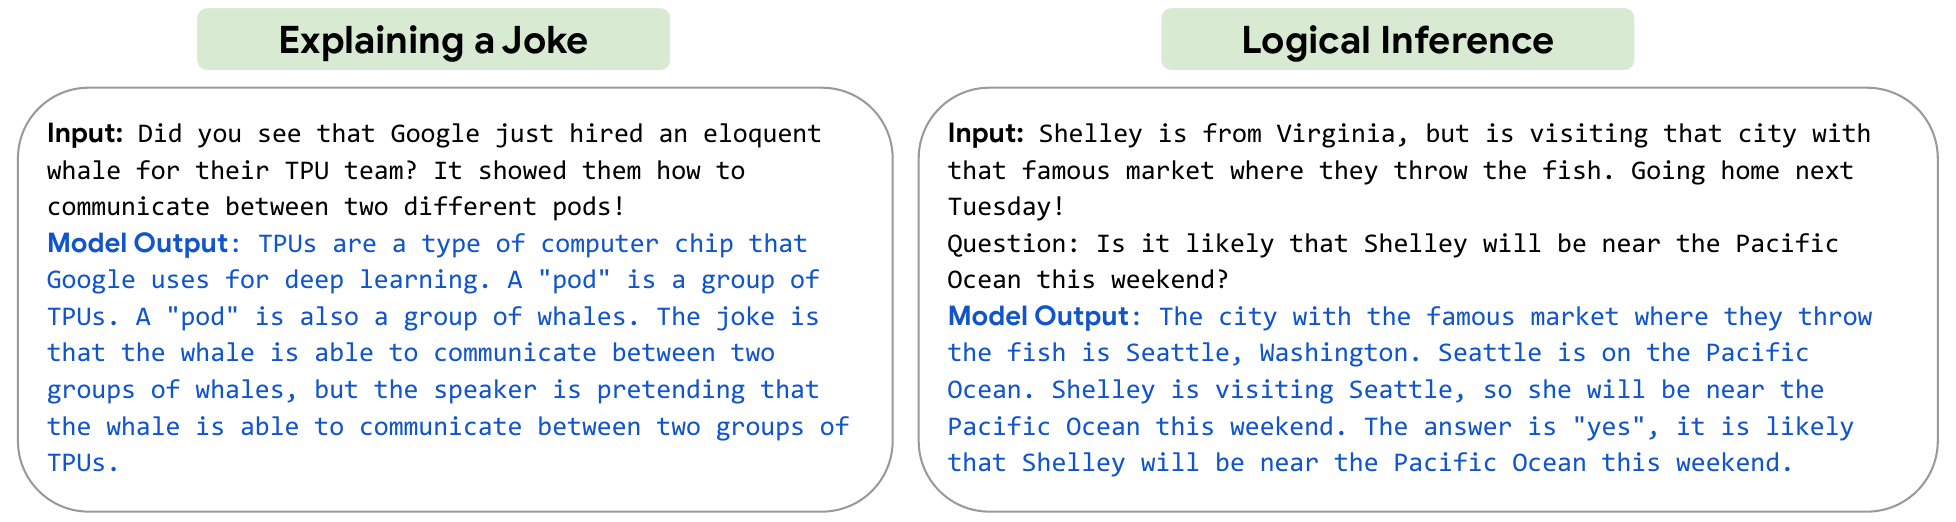
À gauche, la blague. Le modèle répond qu'une baleine peut communiquer entre deux groupes de baleines, et que celui qui parle fait comme si elle pouvait communiquer entre deux ensembles de TPU. À droite, une question d'un autre genre. Le modèle doit d'abord reconnaître que « le marché où l'on lance des poissons » se trouve à Seattle avant de pouvoir dire si Shelley sera près du Pacifique ce week-end. Les deux cas utilisent le décodage glouton, et le prompt contient deux exemples accompagnés de leur explication, autrement dit le prompting par chaîne de pensée proposé plus tôt la même année.
La blague parle aussi de l'article lui-même. PaLM (Pathways Language Model) est un modèle de langage dense de 540 milliards de paramètres, entraîné sur 6 144 puces TPU v4 réparties sur deux TPU v4 Pods, grâce au nouveau système Pathways de Google.
Pff, quelle plaie ! Une blague qu'il faut expliquer autant n'a plus rien de drôle.
Définir le problème
Après GPT-3, GLaM, Gopher, Chinchilla, Megatron-Turing NLG et LaMDA ont fait progresser tour à tour les résultats en apprentissage few-shot. Les auteurs ramènent ces progrès à quatre directions :
- agrandir le modèle en profondeur et en largeur ;
- augmenter le nombre de tokens d'entraînement ;
- utiliser des données plus propres et de sources plus variées ;
- augmenter la capacité avec des modules creux, sans augmenter le calcul.
PaLM suit surtout la première, en agrandissant un modèle dense, où tous les paramètres participent au calcul, pour voir si les capacités few-shot ont déjà atteint un plafond.
Pour y parvenir, il faut d'abord régler un problème d'ingénierie. La plus grande configuration d'entraînement de l'époque comptait 4 096 TPU v3. Megatron-Turing NLG utilisait 2 240 A100, Gopher quatre TPU v3 Pods, et tous deux s'appuyaient sur le parallélisme de pipeline (pipeline parallelism) pour s'étendre sur plusieurs machines. Le parallélisme de pipeline souffre du problème des « bulles », car beaucoup d'accélérateurs restent inactifs pendant que le pipeline se remplit et se vide, et il sollicite davantage la bande passante mémoire. Les auteurs veulent étendre l'entraînement à deux Pods sans recourir au parallélisme de pipeline.
Résoudre le problème
Architecture : un ensemble de modifications pragmatiques
PaLM est un Transformer décodeur seul, avec quelques modifications :
- SwiGLU : la fonction d'activation de la couche feed-forward devient . Cela demande trois multiplications matricielles, mais Shazeer a montré qu'à calcul égal, la qualité est meilleure.
- Couches parallèles : la formulation standard fait passer l'entrée par l'attention puis par le feed-forward ; PaLM fait lire la même entrée aux deux blocs, puis additionne leurs résultats :
Les multiplications matricielles d'entrée de l'attention et du feed-forward peuvent alors être fusionnées, ce qui accélère l'entraînement d'environ 15 % à grande échelle. Les ablations des auteurs montrent une légère baisse de qualité à 8B et aucune différence à 62B ; ils supposent donc que le 540B n'en pâtit pas non plus.
- Multi-Query Attention : chaque tête d'attention a sa propre query, mais toutes les têtes partagent les mêmes key et value. L'effet sur la qualité et la vitesse d'entraînement est faible, mais le décodage autorégressif devient beaucoup moins coûteux. (Plus tard, les versions 34B et 70B de Llama 2 passeront à GQA, un intermédiaire entre les deux.)
- Encodage de position RoPE, embeddings partagés entre entrée et sortie.
- Pas de biais : aucune couche dense ni aucune LayerNorm n'a de terme de biais ; les auteurs constatent que cela stabilise l'entraînement des grands modèles.
- Vocabulaire SentencePiece de 256k : entièrement réversible, il conserve tous les espaces (crucial pour le code), décompose les caractères Unicode hors vocabulaire en octets UTF-8 et découpe toujours les nombres chiffre par chiffre, par exemple « 123.5 » devient « 1 2 3 . 5 » ; LLaMA fera de même l'année suivante.
Voici la configuration des trois tailles ; la largeur de la couche feed-forward vaut toujours , et chaque tête d'attention a toujours 256 dimensions :
| Modèle | Couches | Têtes d'attention | Paramètres | Taille de lot | |
|---|---|---|---|---|---|
| PaLM 8B | 32 | 16 | 4 096 | 8.63 milliards | 256 → 512 |
| PaLM 62B | 64 | 32 | 8 192 | 62.5 milliards | 512 → 1 024 |
| PaLM 540B | 118 | 48 | 18 432 | 540.35 milliards | 512 → 1 024 → 2 048 |
D'après la Table 1 de l'article.
Données : 780 milliards de tokens, lus une seule fois
Les données d'entraînement s'appuient sur celles de LaMDA et de GLaM, pour un total de 780 milliards de tokens : 50 % de conversations de réseaux sociaux, 27 % de pages web filtrées, 13 % de livres en anglais, 5 % de code GitHub, 4 % de Wikipédia et 1 % d'actualités en anglais. Les pages web sont échantillonnées selon le score d'un classifieur de qualité ; plus le score est élevé, plus une page a de chances d'être retenue, mais les pages mal notées ne sont pas totalement exclues. Le code provient de projets open source sur GitHub ; après exclusion des licences copyleft et restriction à 24 langages courants, on obtient 196 Go de code source, dont on retire ensuite les fichiers en double d'après la distance de Levenshtein. Les données non anglaises représentent environ 22 %.
Les trois modèles ne voient ces données qu'une seule fois, et les proportions de chaque source sont réglées pour qu'aucune partie ne soit vue deux fois.
Infrastructure : deux Pods, sans parallélisme de pipeline
Chaque TPU v4 Pod compte 3 072 puces et 768 hôtes. À l'intérieur d'un Pod, chaque tenseur de poids est découpé en 12 parts pour le parallélisme de modèle, combiné à un parallélisme de données entièrement partitionné (fully sharded) sur 256 voies ; chaque Pod détient une copie complète du modèle.
Entre les deux Pods, Pathways se charge du parallélisme de données. Un client Python coupe le lot en deux moitiés et en envoie une à chaque Pod ; chacun calcule sa propagation avant et arrière, puis les deux Pods échangent leurs gradients, les additionnent chacun de son côté et mettent à jour les paramètres, si bien que les poids restent identiques au bit près.
La difficulté, c'est le réseau entre Pods. Les gradients ne partent qu'une fois que toutes les puces ont fini leur calcul ; les 1 536 hôtes transmettent donc tous au même instant, chaque paire d'hôtes échangeant environ 1.3 Go de gradients à chaque étape, soit un trafic instantané total de 81 Tbit/s. Les auteurs découpent les gradients en petits morceaux et les répartissent sur plusieurs liens du réseau du centre de données ; au final, le débit de deux Pods atteint 1.95 fois celui d'un seul. Le petit écart avec le facteur 2 théorique vient de ce que la rétropropagation et le transfert de gradients entre Pods ne se chevauchent pas.
Mesurer l'efficacité par l'utilisation des FLOPs du modèle
Pour les auteurs, l'« utilisation des FLOPs matériels » (HFU), courante jusque-là, se prête mal aux comparaisons. Elle dépend de l'implémentation ; par exemple, quand on sacrifie du calcul pour économiser de la mémoire grâce au recalcul (rematerialization), les FLOPs matériels augmentent, sans que ce soit ce que l'entraînement cherche réellement. Ce qui compte pour l'entraînement, c'est le nombre de tokens traités par seconde.
Les auteurs proposent donc l'utilisation des FLOPs du modèle (MFU), soit le débit de tokens observé divisé par le débit théorique qu'atteindrait le matériel « s'il ne faisait que le calcul nécessaire, à sa puissance de crête ». Le calcul nécessaire ne comprend que la propagation avant et arrière, sans le recalcul. Un décodeur de paramètres demande FLOPs de calcul matriciel par token ( en avant, en arrière), plus pour l'attention. Faisons le calcul avec les chiffres de PaLM 540B :
N = 540.35e9                     # nombre de paramètres
L, H, Q, T = 118, 48, 256, 2048  # couches, têtes d'attention, dimension par tête, longueur de séquence
chips, peak = 6144, 275e12       # puces TPU v4, FLOP/s matriciels de crête par puce
tokens_per_sec = 238.3e3         # débit d'entraînement mesuré

flops_per_token = 6 * N + 12 * L * H * Q * T   # avant 2N + arrière 4N, plus l'attention
mfu = tokens_per_sec * flops_per_token / (chips * peak)
print(f"{6 * N:.3e} {12 * L * H * Q * T:.3e}")  # 3.242e+12 3.563e+10
print(f"{mfu:.1%}")                              # 46.2%
Le terme d'attention ne pèse qu'environ 1 % de ; dans un grand modèle, presque tout le calcul part dans les multiplications de matrices par les poids. Avec la même méthode de calcul, GPT-3 obtient 21.3 %, Gopher 32.5 % et Megatron-Turing NLG 30.2 %. Les 46.2 % de PaLM viennent de la stratégie de parallélisme, des optimisations du compilateur XLA et des couches parallèles. Si l'on compte aussi les FLOPs du recalcul, l'utilisation matérielle atteint 57.8 %.
Réglages d'entraînement et pics de perte
Quelques réglages sortent de l'ordinaire :
- L'optimiseur est Adafactor sans factorisation, ce qui revient à peu près à Adam avec « mise à l'échelle des paramètres ». Le taux d'apprentissage reste fixé à pendant les 10 000 premières étapes, puis décroît en ; le coefficient du moment d'ordre deux vaut , où est le numéro d'étape. Les auteurs trouvent ce choix plus stable qu'une valeur fixe de 0.99, car sur une fenêtre courte, le moment d'ordre deux des embeddings de tokens rares est mal estimé.
- Une z-loss supplémentaire, , maintient le terme de normalisation du softmax proche de 0, ce qui améliore la stabilité.
- La taille de lot double au fil de l'entraînement. Le 540B utilise d'abord 512 séquences (environ 1 million de tokens) jusqu'à l'étape 50 000, puis 1 024 jusqu'à l'étape 115 000, et enfin 2 048 (environ 4 millions de tokens) jusqu'à la fin, à l'étape 255 000. Les petits lots du début sont plus économes en exemples ; les grands lots de la fin donnent une estimation plus précise du gradient, avec des matrices plus grandes qui exploitent mieux les TPU.
- Le préentraînement se fait sans dropout, et tout redémarrage depuis un checkpoint est reproductible au bit près.
Malgré l'écrêtage des gradients, le 540B connaît une vingtaine de pics de perte pendant l'entraînement, à intervalles très irréguliers, parfois tard dans l'entraînement ; les petits modèles n'ont pas ce problème. Faute de solution théoriquement fondée, les auteurs finissent par redémarrer depuis un checkpoint situé environ 100 étapes avant le pic et sautent les 200 à 500 lots qui l'entourent.
Ils vérifient aussi si de « mauvaises données » sont en cause. Quand ils entraînent un checkpoint plus ancien sur les lots qui entouraient un pic, aucun pic n'apparaît. Le pic ne survient donc que lorsque certaines données rencontrent un certain état des paramètres. La reproductibilité au bit près évoquée plus haut permet de mener ce genre de vérification proprement ; relancé depuis le même checkpoint, l'entraînement donne exactement le même résultat.
Discussion
NLP en anglais et MMLU
Sur les 29 benchmarks anglais utilisés dans l'article de GPT-3, les résultats few-shot de PaLM 540B établissent un nouveau record sur 28, face aux meilleurs résultats respectifs de GLaM, GPT-3, Megatron-Turing NLG, Gopher, Chinchilla et LaMDA. Sur MMLU, la moyenne en 5-shot est de 69.3, contre 67.5 pour le précédent record, détenu par Chinchilla ; sur les quatre grandes catégories, seule la catégorie « autres » reste à l'avantage de Chinchilla.
BIG-bench : au-dessus de la moyenne humaine, mais pas partout
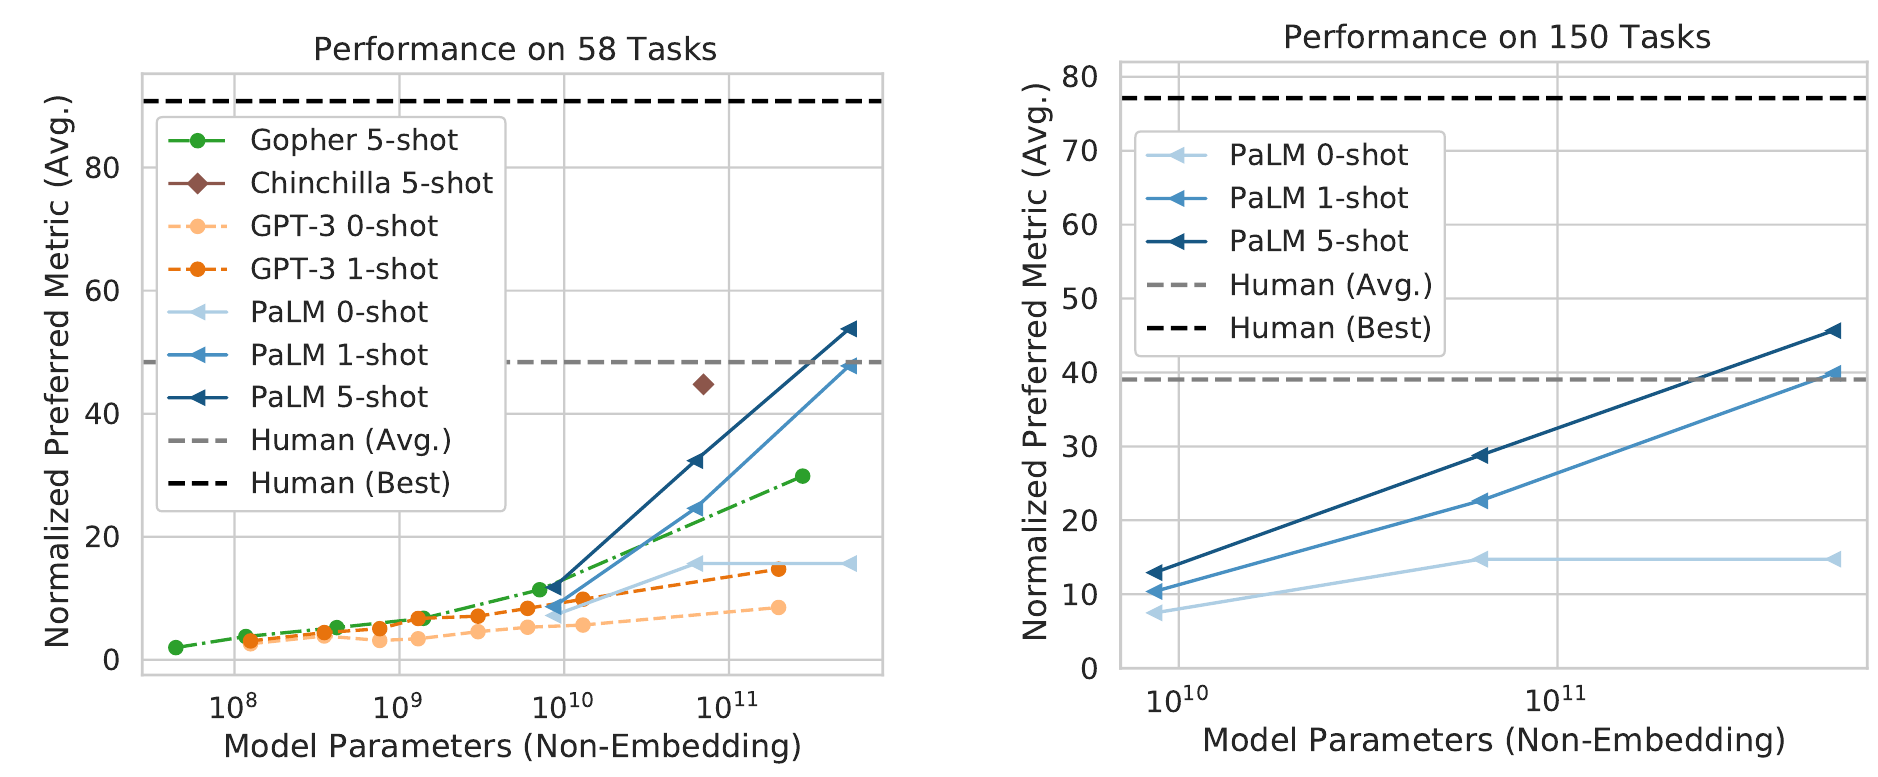
BIG-bench est un benchmark collaboratif de plus de 150 tâches. La référence humaine est obtenue en demandant à des travailleurs du crowdsourcing (généralement 10) de répondre à partir de la même description de tâche et des mêmes exemples, avec le droit d'utiliser n'importe quel outil, moteur de recherche, calculatrice ou autre ; la « moyenne humaine » est la moyenne de tous les participants, et le « meilleur humain » retient le meilleur score pour chaque question.
Le graphique de gauche ne retient que les 58 tâches évaluées par les trois familles de modèles. PaLM 540B en 5-shot dépasse la moyenne humaine et bat le meilleur résultat antérieur sur 44 de ces tâches. Les trois tailles de PaLM s'alignent à peu près sur une droite log-linéaire, ce qui fait dire aux auteurs que continuer à agrandir le modèle améliorera encore les résultats. Le graphique de droite montre PaLM sur 150 tâches, avec une tendance similaire.
On reste très loin du meilleur humain. Tâche par tâche, la moyenne humaine bat encore PaLM 540B sur 35 % des tâches.
Des progrès discontinus
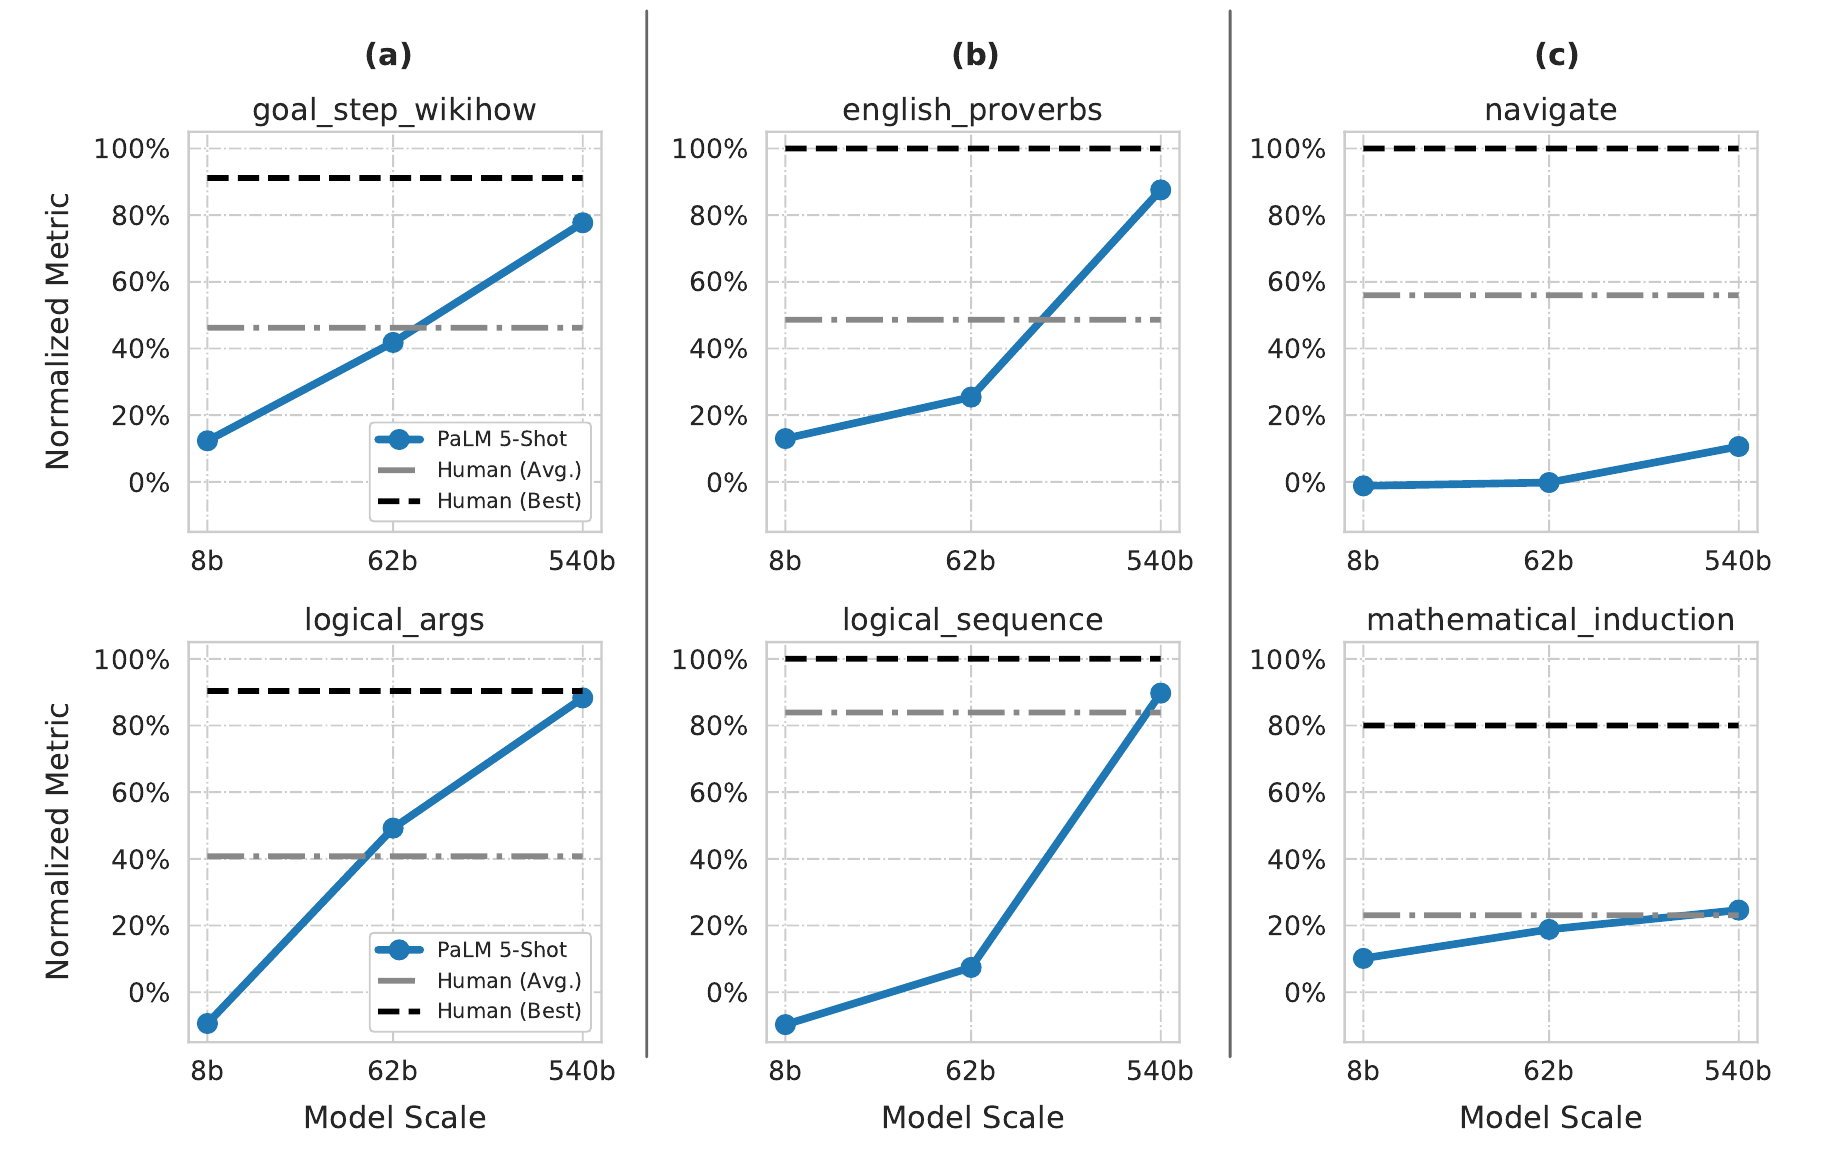
Les auteurs choisissent six tâches pour illustrer trois formes de courbes d'échelle. En (a), le score monte régulièrement avec la taille ; en (c), il ne progresse presque pas, le 540B faisant à peine mieux que le 62B, très loin du meilleur humain ; en (b), le gain est faible de 8B à 62B, puis fait un grand bond de 62B à 540B.
Les auteurs quantifient la « discontinuité » sur l'exemple d'english_proverbs, où les trois tailles obtiennent environ 13 %, 25 % et 87 %. De 8B à 62B, le nombre de paramètres est multiplié par 8 environ, et de 62B à 540B à peu près autant ; en prolongeant la tendance log-linéaire du premier segment, le 540B devrait obtenir , alors qu'il atteint en réalité 87 %, soit 50 points de plus. Sur l'ensemble des 150 tâches, 25 % présentent une discontinuité supérieure à 10 points de pourcentage, et 15 % une discontinuité supérieure à 20 points.
La tâche english_proverbs demande de comprendre la métaphore cachée derrière un proverbe, ce qui exige selon les auteurs un haut niveau de raisonnement abstrait. La tâche mathematical_induction est à l'opposé ; les énoncés posent des prémisses qui peuvent contredire les vraies mathématiques, par exemple « 2 est impair », puis demandent si le raisonnement par induction est correct. Toutes les tailles de PaLM, comme les humains qui font la même tâche, peinent sur les énoncés aux prémisses fausses.
Raisonnement et code
PaLM utilise aussi le prompting par chaîne de pensée, proposé un peu plus tôt par la même équipe. En 8-shot, avec chaîne de pensée et calculatrice externe, il atteint 58 % sur GSM8K :
| Modèle et technique | Précision sur GSM8K |
|---|---|
| PaLM 540B, chaîne de pensée + calculatrice | 58 % |
| PaLM 540B, chaîne de pensée | 54 % |
| PaLM 540B, sans chaîne de pensée | 17 % |
| PaLM 62B, chaîne de pensée | 33 % |
| GPT-3, fine-tuning + chaîne de pensée + calculatrice | 34 % |
| GPT-3, fine-tuning + chaîne de pensée + calculatrice + vérificateur | 55 % |
D'après la Table 10 de l'article.
Les 55 % précédents demandaient un fine-tuning, une calculatrice et en plus un vérificateur entraîné spécialement ; PaLM les dépasse avec un simple prompt few-shot.
Côté code, PaLM 540B, qui n'a pas été entraîné spécialement pour la programmation, obtient un pass@100 de 76.2 % sur HumanEval, comparable aux 72.3 % du Codex 12B spécialisé. Les données d'entraînement de PaLM ne contiennent qu'environ 2.7 milliards de tokens Python, moins d'un trentième de ce qu'a vu Codex (environ 100 milliards). Les auteurs y voient un transfert depuis les autres langages de programmation et la langue naturelle, ajouté à la meilleure efficacité en exemples des grands modèles. Fine-tuné ensuite sur du code, PaLM-Coder 540B atteint un pass@100 de 88.4 % sur HumanEval.
Mémorisation et biais
Les auteurs tirent au hasard des extraits de 100 tokens des données d'entraînement, donnent au modèle les 50 premiers tokens, et regardent s'il peut produire les 50 suivants mot pour mot par décodage glouton. Le 8B y parvient pour 1.6 % des extraits, le 540B pour 2.4 % ; plus le modèle est grand, plus il retient. Pour les extraits vus une seule fois, le taux de mémorisation du 540B est de 0.75 % ; pour ceux vus plus de 500 fois, il dépasse 40 %. Le corpus de code, plein de textes de licence et de fragments copiés-collés, est le plus facilement mémorisé ; le corpus de livres, fait surtout de textes uniques, l'est le moins.
Dans l'analyse des biais, les continuations liées à la religion associent l'islam à des termes comme terrorisme, extrémisme ou violence, une tendance présente à toutes les tailles. Côté toxicité, le 62B et le 540B sont globalement un peu plus toxiques que le 8B ; la toxicité des continuations du modèle est fortement corrélée à celle du prompt, alors que la corrélation est moins forte pour les continuations humaines.
Les questions que les auteurs laissent ouvertes
La section de l'article sur les « questions ouvertes du passage à l'échelle » vaut le détour. PaLM agrandit surtout la taille du modèle, mais les auteurs reconnaissent ne pas avoir fait d'ablation pour séparer la contribution d'un « modèle plus grand » de celle de « davantage de tokens ». Avec le même budget d'entraînement, demandent-ils, que donnerait un modèle de 62B entraîné sur 7 000 milliards de tokens, ou un modèle de 120B entraîné sur 3 600 milliards, comparé au 540B entraîné sur 780 milliards de tokens ? Si un modèle plus petit faisait aussi bien, l'inférence coûterait beaucoup moins cher.
Une semaine avant la publication de PaLM, Chinchilla, de DeepMind, venait justement de s'attaquer à la même question. Les auteurs mettent côte à côte les résultats comparables des deux côtés :
| Modèle | Paramètres (B) | Tokens (B) | FLOPs d'entraînement (ZFLOPs) | Moyenne sur 9 benchmarks anglais |
|---|---|---|---|---|
| PaLM 62B | 62 | 795 | 295.7 | 64.8 |
| Chinchilla | 70 | 1 400 | 588.0 | 65.2 |
| Gopher | 280 | 300 | 504.0 | 59.5 |
| PaLM 540B | 540 | 780 | 2 527.2 | 70.3 |
D'après la Table 21 de l'article.
Avec environ moitié moins de FLOPs d'entraînement que Chinchilla, PaLM 62B ne lui cède en moyenne que 0.4 point ; Gopher, lui, reste nettement derrière. Les auteurs reconnaissent que cela conforte la conclusion de Chinchilla, à savoir que Gopher était sous-entraîné pour sa taille. Mais PaLM et Chinchilla n'utilisent pas les mêmes données, et les auteurs estiment qu'on ne peut pas en tirer de réponse à la question « un modèle de taille X entraîné sur Y tokens ferait-il mieux que PaLM 540B ? ».
Un an plus tard, le rapport technique de PaLM 2 y répond en partie. Suivant la conclusion de Chinchilla, il fait croître la quantité de données et la taille du modèle à peu près dans un rapport 1:1 ; le plus grand modèle, PaLM 2-L, est bien plus petit que PaLM 540B, mais utilise davantage de calcul d'entraînement.
Conclusion
Même poussé à 540 milliards de paramètres, un modèle dense continue de gagner en capacités few-shot. PaLM bat le record sur 28 des 29 benchmarks anglais, dépasse sur GSM8K le fine-tuning avec vérificateur grâce au seul prompt, et un quart des tâches BIG-bench se débloquent d'un coup entre 62B et 540B.
Si vous voulez savoir à quel point votre entraînement est efficace, le MFU est une méthode toute prête. Multipliez le nombre de tokens traités par seconde par , divisez par la puissance de crête des puces, et vous pourrez comparer le résultat aux 46.2 % de PaLM.
Seulement, au ratio de Chinchilla, environ 20 tokens par paramètre, un modèle de 540 milliards de paramètres aurait dû lire quelque 11 000 milliards de tokens ; PaLM n'en a lu que 780 milliards. La baleine est très futée ; elle a juste un peu manqué de lecture.