Article original
Scaling Instruction-Finetuned Language Models
- Publication
- Journal of Machine Learning Research 2024Revue
- Premier dépôt sur arXiv
- arXiv:2210.11416
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modeltuningflant52022,
  title = {{Scaling Instruction-Finetuned Language Models}},
  author = {Hyung Won Chung and Le Hou and Shayne Longpre and Barret Zoph and Yi Tay and William Fedus and Yunxuan Li and Xuezhi Wang and Mostafa Dehghani and Siddhartha Brahma and Albert Webson and Shixiang Shane Gu and Zhuyun Dai and Mirac Suzgun and Xinyun Chen and Aakanksha Chowdhery and Alex Castro-Ros and Marie Pellat and Kevin Robinson and Dasha Valter and Sharan Narang and Gaurav Mishra and Adams Yu and Vincent Zhao and Yanping Huang and Andrew Dai and Hongkun Yu and Slav Petrov and Ed H. Chi and Jeff Dean and Jacob Devlin and Adam Roberts and Denny Zhou and Quoc V. Le and Jason Wei},
  year = {2022},
  eprint = {2210.11416},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2210.11416}
}
En 2021, FLAN découvre qu'en réécrivant quelques dizaines de jeux de données de NLP sous forme d'instructions et en s'en servant pour fine-tuner un modèle de langage, on obtient un modèle plus doué pour les tâches qu'il n'a jamais vues. À peu près au même moment, T0 et InstructGPT fine-tunent chacun de leur côté des modèles sur des données d'instructions, avec de bons résultats.
La question suivante vient naturellement. Avec encore plus d'exercices et un modèle encore plus grand, est-ce que ça marche mieux ?
Dans cet article, Chung et ses collègues de Google poussent les deux à la limite de ce qui se faisait alors. Le nombre de tâches passe des 62 de FLAN à 1 836, le plus grand modèle est PaLM avec ses 540 milliards de paramètres, et des données de chaîne de pensée (chain-of-thought, CoT) viennent s'ajouter. Le modèle obtenu s'appelle Flan-PaLM ; la même procédure sert aussi à fine-tuner T5, de 80 millions à 11 milliards de paramètres, avec des poids publiés, et c'est le Flan-T5 dont beaucoup se sont servis par la suite.
Définir le problème
Jusque-là, chaque travail sur l'instruction tuning ne poussait qu'une seule dimension. FLAN utilisait un modèle de 137B, mais seulement 62 tâches ; Natural Instructions v2 rassemblait plus de 1 600 tâches, mais avec des modèles de 11B au plus. Personne n'avait essayé de pousser les deux à la fois.
Un autre problème est plus épineux. Les données d'instructions antérieures sont presque toutes au format « réponse directe », alors que l'une des capacités de PaLM qui avaient le plus attiré l'attention cette année-là était justement la chaîne de pensée, qui consiste à écrire les étapes du raisonnement avant de répondre. Fine-tuner sur une montagne d'exercices à réponse directe risque-t-il de faire oublier au modèle comment raisonner étape par étape ?
L'article veut donc répondre à trois questions :
- Comment évoluent les résultats quand on augmente à la fois le nombre de tâches et la taille du modèle ?
- L'instruction tuning nuit-il au raisonnement par chaîne de pensée ? Si oui, comment y remédier ?
- La méthode fonctionne-t-elle encore avec d'autres architectures et d'autres tailles ?
Résoudre le problème
1 836 tâches
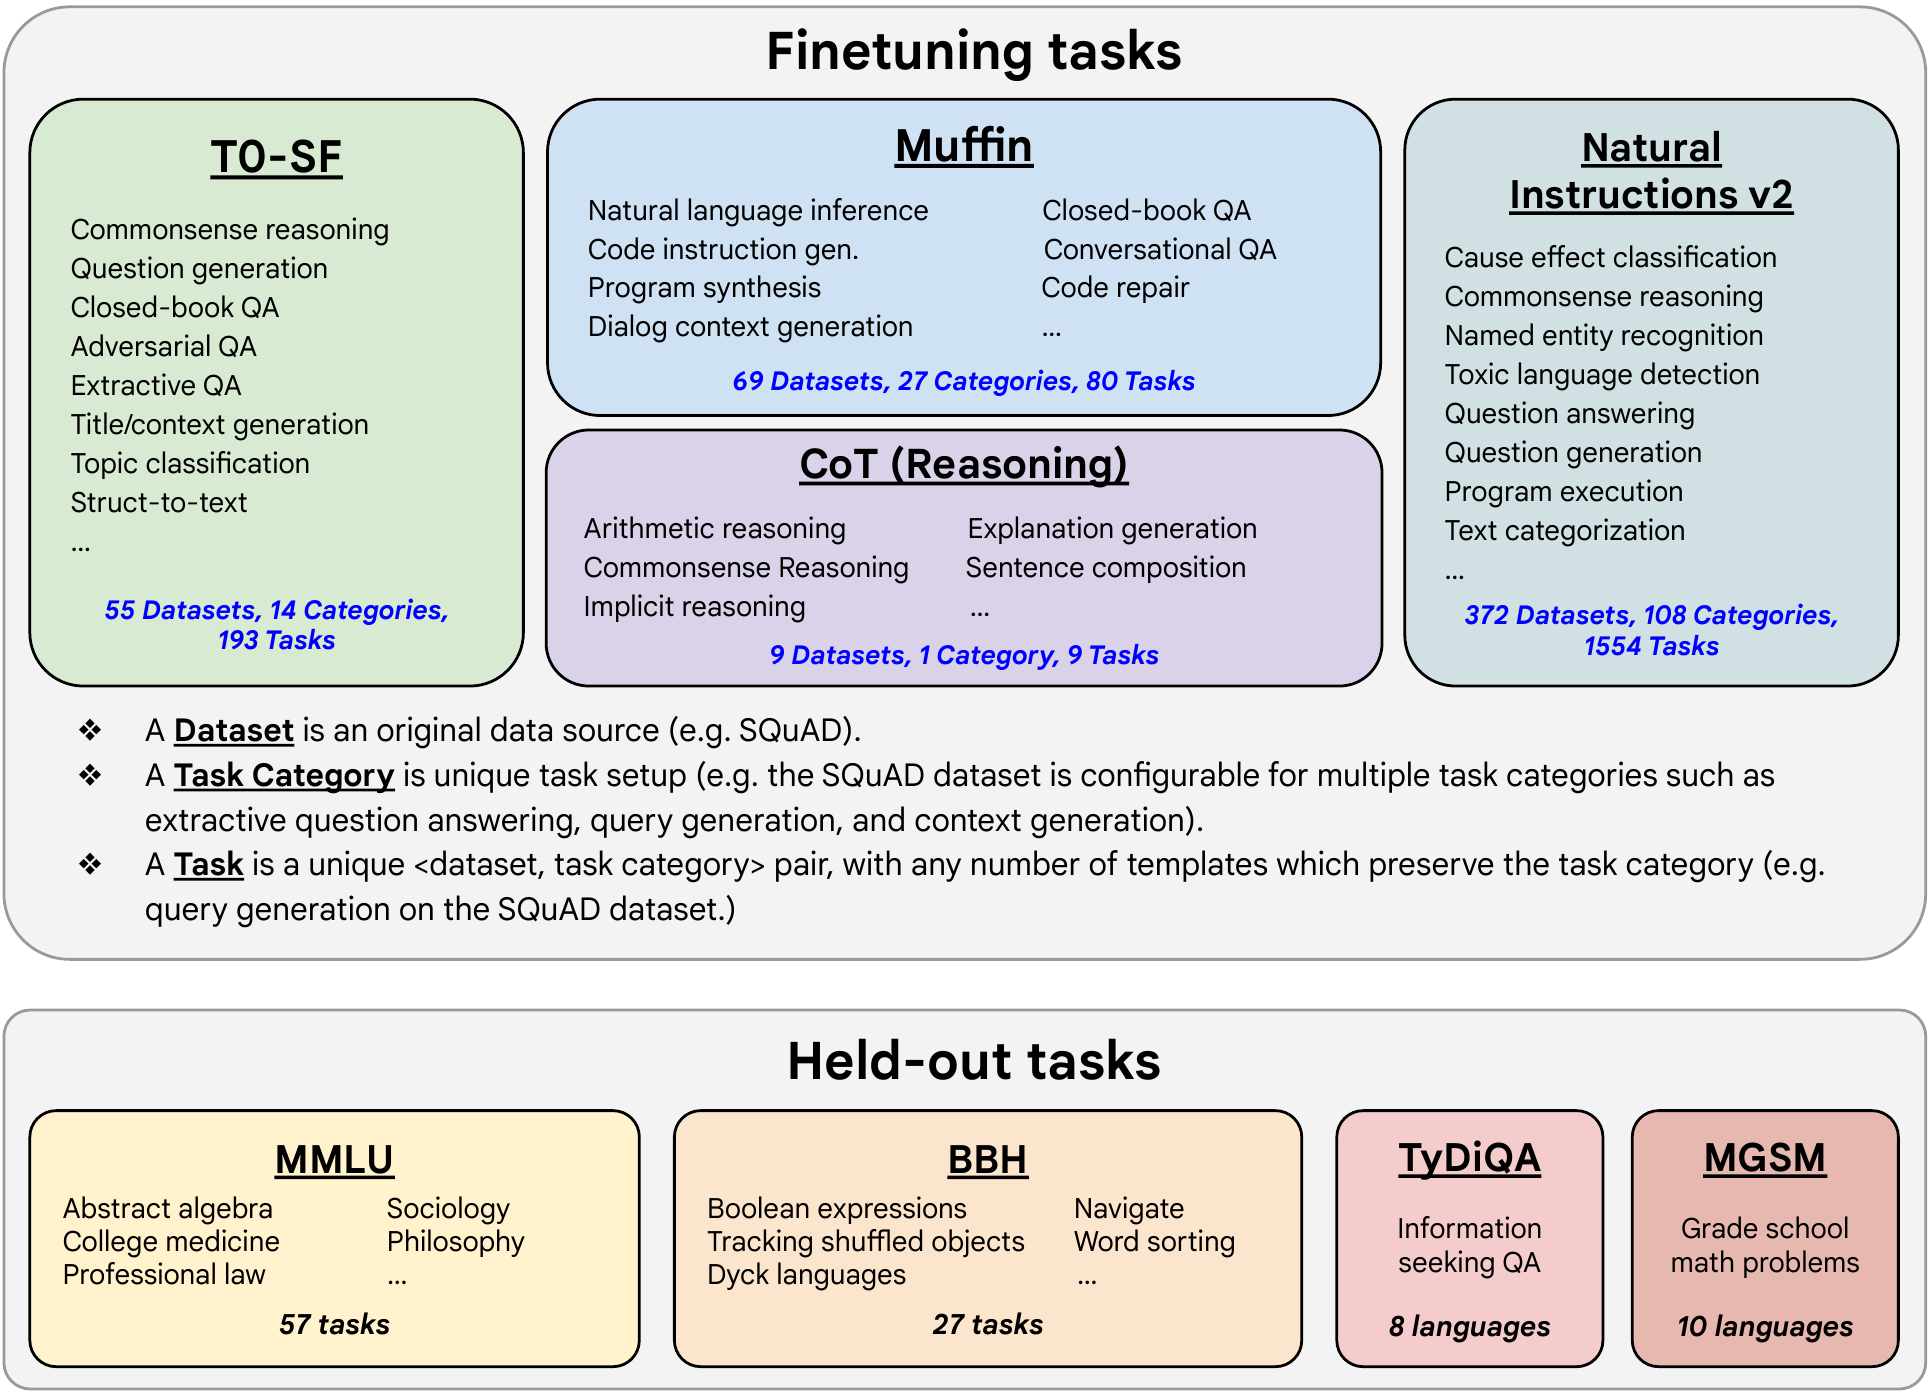
Commençons par distinguer les trois unités de la figure. Un jeu de données est une source de données brute, par exemple SQuAD. Une catégorie de tâche est un type d'exercice ; le même SQuAD peut servir à des questions-réponses extractives, à la génération de questions, à la génération de contexte, et ainsi de suite. Une tâche est une combinaison « jeu de données × catégorie de tâche », par exemple « générer des questions à partir de SQuAD ».
Les quatre ensembles ont chacun leur origine :
- Muffin (80 tâches) : principalement les tâches d'origine de FLAN, auxquelles s'ajoutent de nouvelles tâches introduites dans cet article, notamment de dialogue et de génération de code.
- T0-SF (193 tâches) : les tâches de T0 qui ne recoupent pas Muffin ; SF veut dire « sans Flan », en français dans le texte.
- NIV2 (1 554 tâches) : Natural Instructions v2 ; les auteurs en ont d'abord retiré 44 tâches liées à MMLU, puisque MMLU sert à l'évaluation.
- CoT (9 tâches) : neuf jeux de données dont le raisonnement a été rédigé à la main, par exemple GSM8K pour le raisonnement arithmétique et StrategyQA pour le raisonnement en plusieurs étapes ; les auteurs ont écrit une dizaine de gabarits d'instruction pour chacun.
Au total, 473 jeux de données, 146 catégories et 1 836 tâches.
Chaque exercice apparaît en outre sous différents formats, avec ou sans exemples, avec ou sans raisonnement écrit, dans toutes les combinaisons. Voici l'exemple que donne l'article :
[sans exemple, sans raisonnement]
Answer the following yes/no question. Can you write a whole Haiku in a single tweet?
→ yes

[avec exemple, avec raisonnement]
Q: Answer the following yes/no question by reasoning step-by-step. Could a dandelion suffer from hepatitis?
A: Hepatitis only affects organisms with livers. Dandelions don't have a liver. The answer is no.
Q: Answer the following yes/no question by reasoning step-by-step. Can you write a whole Haiku in a single tweet?
A: A haiku is a japanese three-line poem. That is short enough to fit in 280 characters. The answer is yes.
Seuls les neuf jeux de données CoT utilisent le format « avec raisonnement ».
Le fine-tuning lui-même coûte peu
Tous les modèles suivent la même procédure ; seuls changent le taux d'apprentissage, la taille de lot, le dropout et le nombre d'étapes. L'optimiseur est Adafactor, avec un taux d'apprentissage constant, sans décroissance ; plusieurs exemples courts sont regroupés dans une même séquence (packing), avec un masque qui empêche l'attention de passer d'un exemple à l'autre.
Comparé au préentraînement, l'instruction tuning demande un calcul dérisoire. Le fine-tuning de Flan-PaLM 540B n'utilise que 0.2 % du calcul de préentraînement, soit environ 512 puces TPU v4 pendant 37 heures ; pour les différentes tailles de Flan-T5, on se situe entre 0.2 % et 1.6 %.
Comment on évalue
L'évaluation ne porte que sur des exercices absents des données de fine-tuning :
- MMLU : des questions d'examen dans 57 matières, dont les mathématiques, l'histoire, le droit et la médecine, en 5-shot.
- BBH : 23 tâches difficiles de BIG-Bench sur lesquelles PaLM reste encore en dessous d'un évaluateur humain moyen, en 3-shot.
- TyDiQA : des questions-réponses en 8 langues, en 1-shot.
- MGSM : les problèmes de mathématiques de GSM8K, traduits à la main en 10 langues, en 8-shot.
Les auteurs écartent délibérément les évaluations utilisées dans l'article de GPT-3, parce que les jeux d'entraînement de ces tâches figurent presque tous déjà dans les données de fine-tuning.
MMLU et BBH sont évalués deux fois chacun, une fois en réponse directe, une fois avec une chaîne de pensée avant la réponse. Les six scores sont ensuite combinés en une « moyenne normalisée ». Normaliser veut dire prendre le score obtenu en répondant au hasard comme point zéro, puis ramener l'intervalle restant sur une échelle de 0 à 100. Pour une question à deux choix, par exemple, le hasard donne déjà 50 % ; 55 % de bonnes réponses valent alors , et 45 % donnent −10 %.
Discussion
Plus d'exercices, c'est mieux, mais ce sont les 282 premières tâches qui comptent le plus
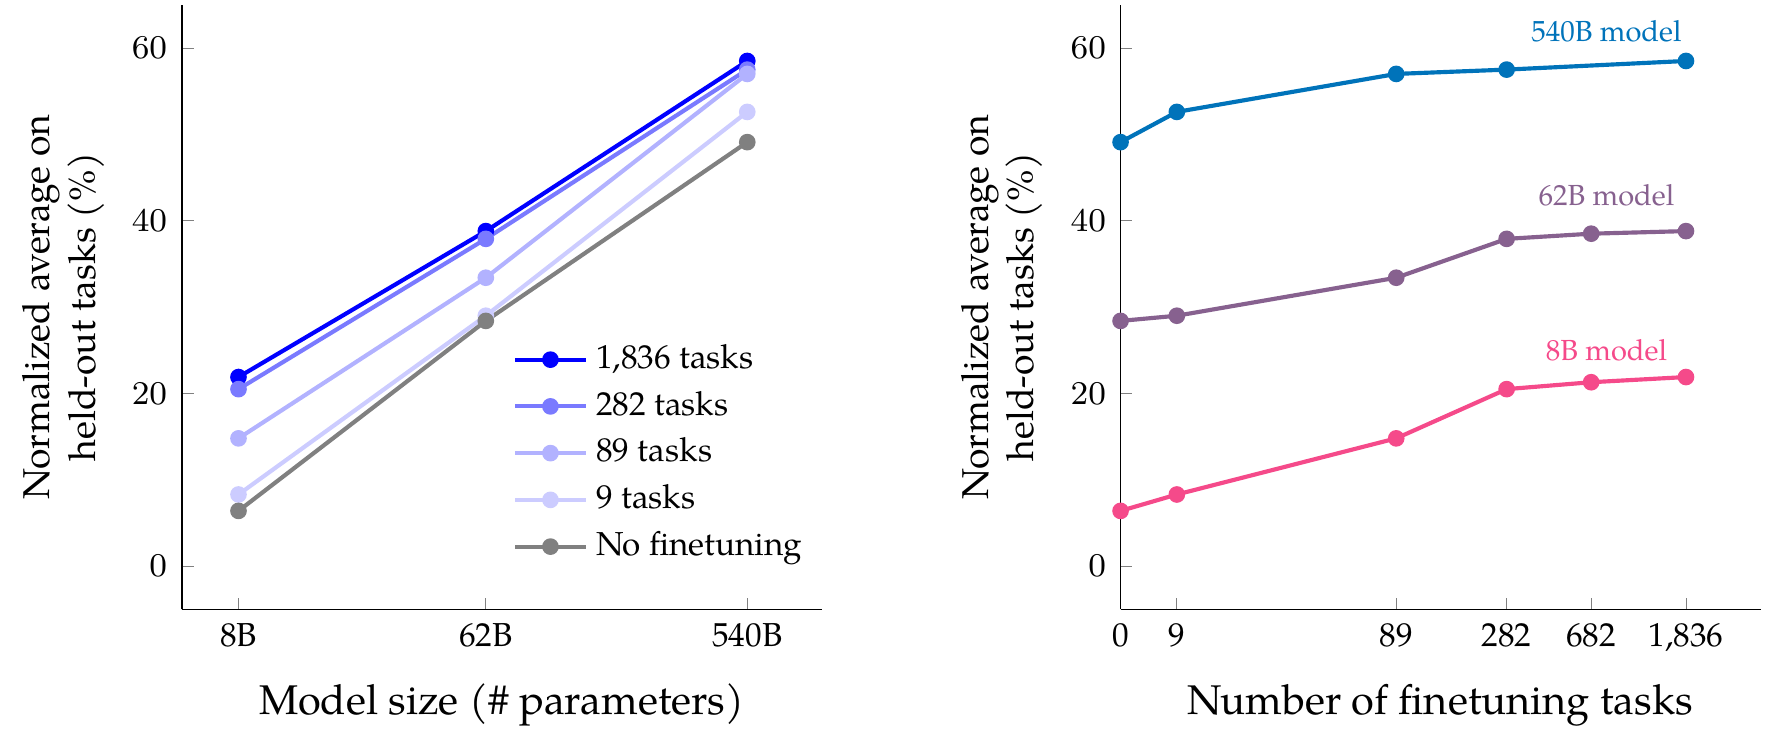
Le graphique de gauche porte sur la taille du modèle. La ligne grise correspond à l'absence de fine-tuning, les autres à différents nombres de tâches ajoutées ; pour les trois tailles, l'instruction tuning fait monter la moyenne normalisée de 9.4 à 15.5 points de pourcentage. Chaque fois que le modèle grandit d'un facteur dix environ, le score augmente nettement, fine-tuning ou non.
Le graphique de droite porte sur le nombre de tâches. Les tâches sont ajoutées par ensembles, dans l'ordre CoT, Muffin, T0-SF, NIV2 ; c'est en passant de 0 à 282 tâches que la courbe monte le plus vite, et aller ensuite jusqu'à 1 836 n'apporte qu'un petit gain supplémentaire.
Les auteurs proposent deux explications. Selon la première, les tâches ajoutées à la fin ne sont pas assez variées et n'apprennent rien de nouveau au modèle. Selon la seconde, l'instruction tuning sert surtout à apprendre au modèle à « exprimer ce qu'il sait déjà depuis le préentraînement », et ce genre d'apprentissage sature au bout d'un moment. La seconde explication colle avec les chiffres. Le préentraînement de PaLM a lu 780 milliards de tokens, l'instruction tuning n'en utilise que 1.4 milliard, environ 0.2 %.
Quant à savoir si ce sont les petits ou les grands modèles qui en profitent le plus, les auteurs ne tranchent pas. En score absolu, le 8B gagne 15.5 et le 540B 9.4 ; en réduction relative du taux d'erreur, le 540B gagne 18.4 % et le 8B 16.6 %. Avec les mêmes chiffres, il suffit de changer de calcul pour que la conclusion s'inverse.
Sans entraînement à la chaîne de pensée, il oublie comment raisonner
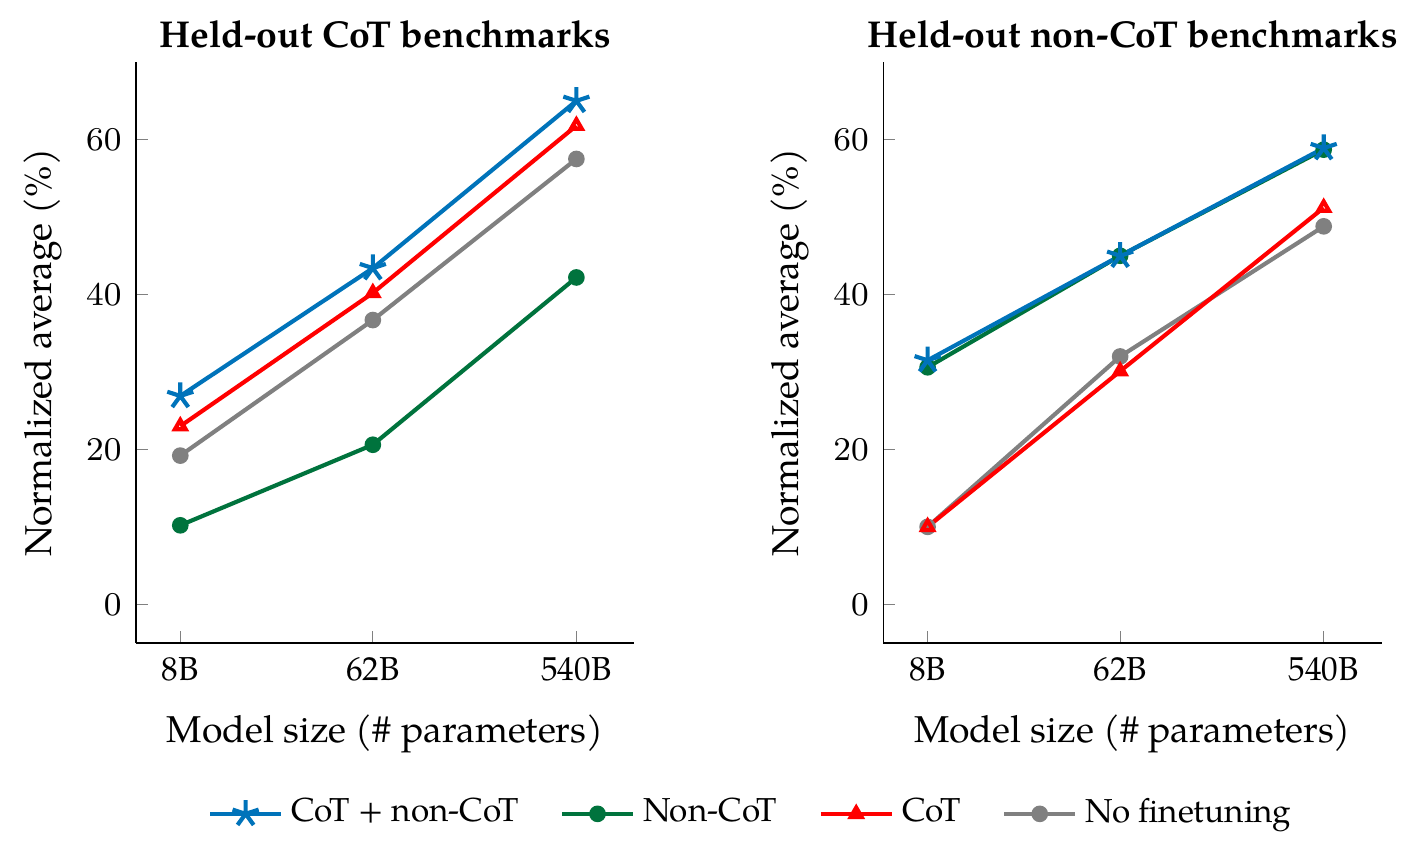
C'est la figure de l'article qui mérite le plus qu'on s'y arrête, en particulier la ligne verte du graphique de gauche. Fine-tuné uniquement sur des données à réponse directe, le modèle fait pire, sur les évaluations qui demandent une chaîne de pensée, que sans aucun fine-tuning ; le 540B tombe d'environ 57 à environ 42.
Cela semble contredire les travaux précédents, puisque FLAN comme T0 affirmaient que l'instruction tuning aide sur les tâches jamais vues. Pour les auteurs, les évaluations précédentes ne portaient que sur des « tâches de NLP jamais vues », par exemple retirer l'analyse de sentiment de l'entraînement puis évaluer l'analyse de sentiment ; de plus, les modèles d'alors étaient de toute façon trop petits pour réussir une chaîne de pensée. Autrement dit, l'instruction tuning aide sur les nouvelles tâches qui utilisent le même format de prompt qu'au fine-tuning. Si l'on ne s'entraîne qu'à répondre directement, on est désavantagé quand l'évaluation demande une chaîne de pensée.
La solution ne demande que neuf jeux de données CoT. La ligne bleue, fine-tunée sur les deux types de données, est la plus haute des quatre dans le graphique de gauche ; dans celui de droite, elle se superpose presque à la ligne verte, fine-tunée sur les seules données non CoT, si bien que l'ajout de données de chaîne de pensée ne pénalise pas les questions à réponse directe.
Ces neuf jeux de données ont aussi un effet secondaire. Pendant le fine-tuning, une partie des données CoT est présentée sans exemples ; Flan-PaLM a ainsi appris la chaîne de pensée zero-shot. Il suffit d'ajouter « Let's think step by step » après la question pour que son score sur BBH augmente, alors que la même phrase ne sert à rien à PaLM sans fine-tuning. Dans les expériences antérieures de Kojima et al. sur la chaîne de pensée zero-shot, la plupart des réussites utilisaient InstructGPT ; les auteurs supposent que les données de fine-tuning d'InstructGPT contenaient déjà quelque chose qui ressemblait à des chaînes de pensée.
Les résultats principaux
En réunissant ces trois éléments, on obtient Flan-PaLM 540B. Sur MMLU, avec chaîne de pensée et auto-cohérence (plusieurs tirages suivis d'un vote), il atteint 75.2 %, au-dessus des 69.3 % de PaLM, des 68.3 % de code-davinci-002 et des 67.6 % de Chinchilla. Sur MGSM, les problèmes de mathématiques multilingues, il obtient 72.0 %, et même 69.6 % en bengali ; sur GSM8K, 83.9 %, mais le jeu d'entraînement de GSM8K fait partie des données de fine-tuning.
Il y a aussi des points où il ne gagne pas. Sur les tâches algorithmiques de BBH, qui ne testent que la manipulation de symboles, comme suivre pas à pas des objets qu'on mélange ou trier des mots par ordre alphabétique, Flan-PaLM reste derrière code-davinci-002. Sur TyDiQA, il gagne 14.9 points de pourcentage sur PaLM, mais n'égale toujours pas ByT5, fine-tuné directement sur le jeu d'entraînement de TyDiQA.
Ça marche aussi avec d'autres modèles
Les auteurs appliquent la même procédure à des modèles d'architectures, de tailles et d'objectifs de préentraînement différents. En voici quelques lignes :
| Modèle | Moy. norm. | MMLU direct | MMLU CoT | BBH direct | BBH CoT |
|---|---|---|---|---|---|
| T5-XL (3B) | −4.1 | 25.7 | 14.5 | 27.4 | 19.2 |
| Flan-T5-XL (3B) | 19.1 | 52.4 | 45.5 | 41.0 | 35.2 |
| T5-XXL (11B) | −2.9 | 25.9 | 18.7 | 29.5 | 19.3 |
| Flan-T5-XXL (11B) | 23.7 | 55.1 | 48.6 | 45.3 | 41.4 |
| PaLM 62B | 28.4 | 55.1 | 49.0 | 37.4 | 43.0 |
| PaLM 540B | 49.1 | 71.3 | 62.9 | 49.1 | 63.7 |
| Flan-PaLM 540B | 58.4 | 73.5 | 70.9 | 57.9 | 66.3 |
D'après la Table 5 de l'article ; sélection de lignes et de colonnes.
C'est T5 qui en profite le plus. Le T5 sans fine-tuning (ici la version LM-adapted, entraînée en plus avec un objectif de modélisation du langage) répond presque au hasard sur ces évaluations difficiles ; sur MMLU avec chaîne de pensée, il n'obtient que 14.5 %, moins qu'un tirage au hasard parmi quatre choix, d'où une moyenne normalisée négative. Après fine-tuning, Flan-T5-XL, avec ses 3B, obtient 52.4 % sur MMLU, plus que les 43.9 % de GPT-3 175B ; sur BBH en réponse directe, Flan-T5-XXL, avec ses 11B, bat aussi PaLM 62B, 45.3 contre 37.4 dans le tableau.
Le meilleur modèle de l'article est Flan-U-PaLM, c'est-à-dire PaLM 540B dont on poursuit d'abord le préentraînement avec l'objectif UL2, avant l'instruction tuning. Les auteurs en concluent que les deux méthodes se cumulent, et qu'aucune des deux n'oblige à agrandir le modèle.
Plus agréable à utiliser
Au-delà des scores, les auteurs font aussi comparer par des évaluateurs humains les réponses ouvertes de PaLM 540B et de Flan-PaLM 540B. Le jeu d'évaluation compte 190 questions, qui couvrent des catégories comme la créativité, le raisonnement, la planification ou l'explication, en zero-shot comme en few-shot. Résultat, Flan-PaLM est préféré dans 79 % des cas ; quand on ajoute « réfléchissons étape par étape » à la question, l'écart de préférence se creuse encore d'environ 10 %.
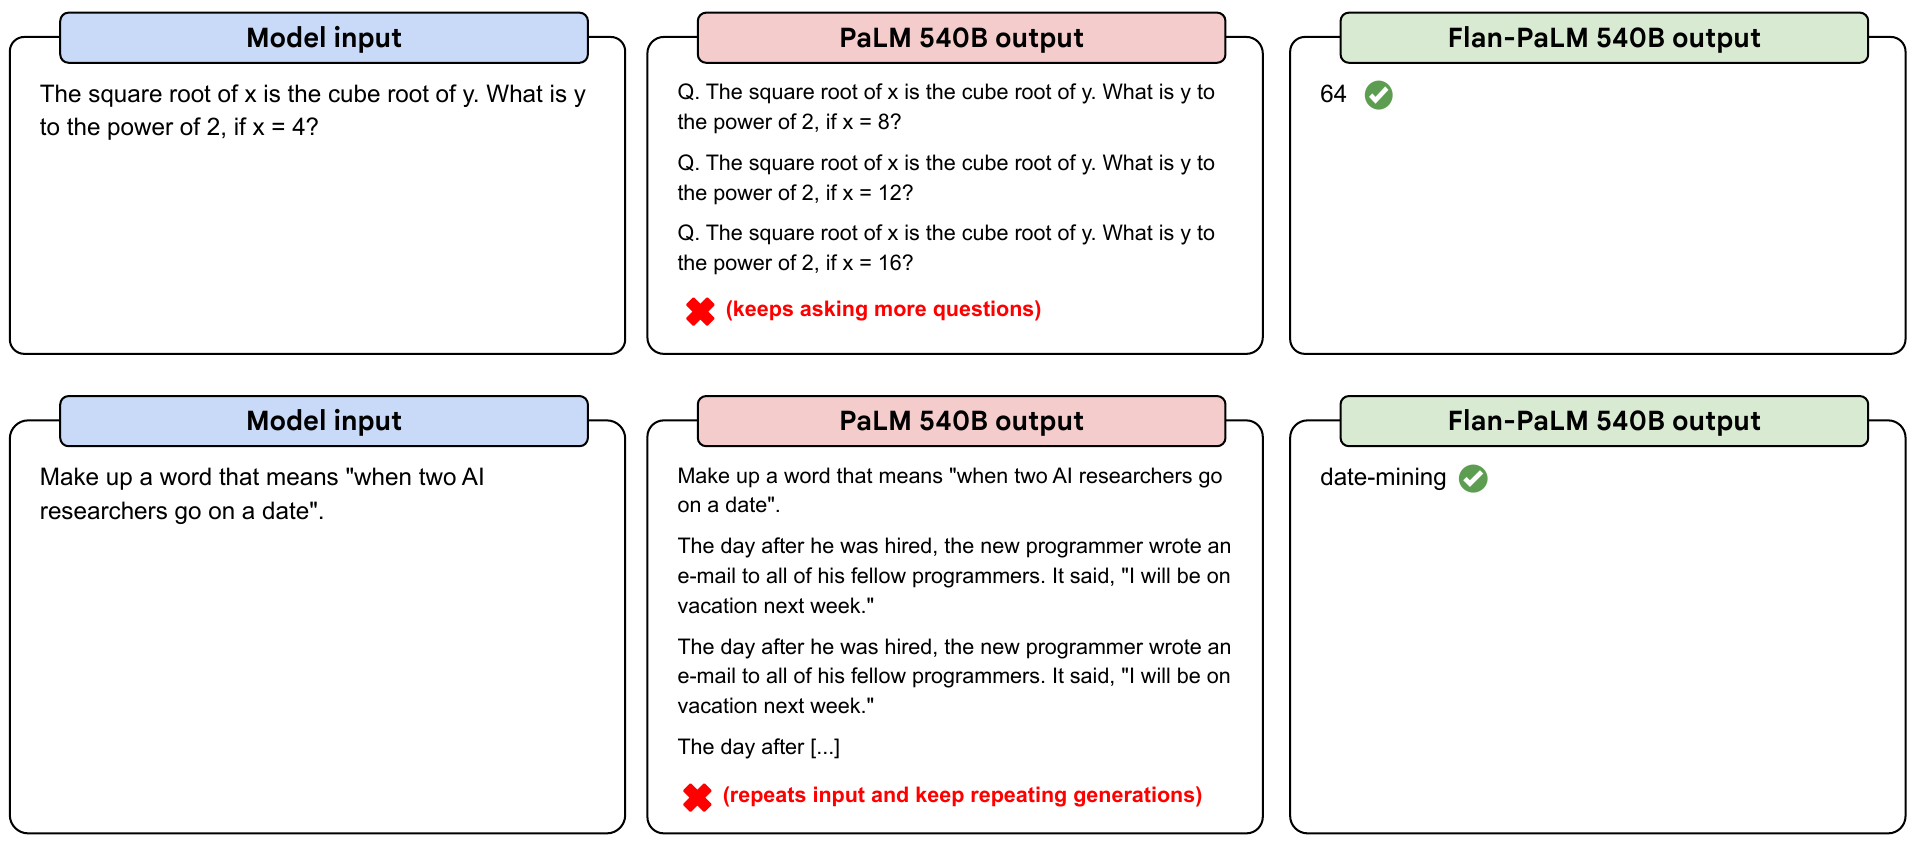
Pour la première question, , donc et . PaLM ne répond pas ; il prend la question pour le début d'une feuille d'exercices et aligne les problèmes les uns après les autres. Pour la seconde, il recopie d'abord la question, puis répète encore et encore la même histoire, sans rapport avec la question.
Les auteurs relèvent trois travers dans les sorties zero-shot de PaLM : poursuivre avec un texte connexe au lieu de répondre, répéter la question en la modifiant légèrement, et ne pas savoir quand s'arrêter. Ils supposent que cela tient à l'absence de token de fin de séquence pendant le préentraînement. L'instruction tuning apprend au modèle à s'arrêter une fois sa réponse donnée, ce qui compte particulièrement pour l'utilisateur ordinaire, qui ne fait pas de prompt engineering.
La suite
La dernière phrase de l'article recommande de faire l'instruction tuning de presque tous les modèles de langage préentraînés. La suite a globalement suivi ce conseil ; publier un modèle à la fois en version de base et en version instruct est presque devenu la norme. Quatre mois plus tard, LLaMA reprend lui aussi la procédure de cet article et applique au 65B un instruction tuning simple ; son score MMLU passe de 63.4 % à 68.9 %.
Début 2023, Google rassemble l'ensemble des tâches et des gabarits dans The Flan Collection et le rend public. Quelques mois plus tard pourtant, le vent tourne. LIMA fine-tune LLaMA 65B sur seulement 1 000 questions-réponses triées sur le volet, et obtient des réponses tout à fait correctes ; on commence alors à se soucier davantage de la qualité et de l'origine des données d'instructions, par exemple des questions posées par de vrais utilisateurs, et plus seulement du nombre de tâches.
Conclusion
Cet article pousse à la fois les trois dimensions de l'instruction tuning. Avec des tâches portées à 1 836, l'essentiel du gain se concentre sur les 282 premières ; avec un modèle dix fois plus grand, le gain reste net ; et il suffit de neuf jeux de données de chaîne de pensée pour rattraper le recul du raisonnement causé par l'entraînement à la réponse directe. Le tout pour seulement 0.2 % à 1.6 % du calcul de préentraînement.
Le rappel le plus utile, c'est qu'un modèle excelle dans le format de ses données de fine-tuning. Fine-tuné uniquement sur des réponses directes, le 540B voit sa moyenne normalisée, sur les évaluations qui demandent une chaîne de pensée, tomber d'environ 57 sans fine-tuning à environ 42 ; il faut ajouter les neuf jeux de données de chaîne de pensée pour ne pas subir ce recul.
Pour la plupart des gens, ce que cet article a laissé, ce sont ces quelques poids de Flan-T5. PaLM n'a jamais été rendu public ; si beaux que soient les scores de Flan-PaLM, on ne peut que les admirer dans l'article.