Article original
Large Batch Training of Convolutional Networks
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:1708.03888
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizerslars2017,
  title = {{Large Batch Training of Convolutional Networks}},
  author = {Yang You and Igor Gitman and Boris Ginsburg},
  year = {2017},
  eprint = {1708.03888},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1708.03888}
}
En juin 2017, Goyal et ses collègues de Facebook entraînent un ResNet-50 sur ImageNet en une heure, avec 256 GPU et une taille de batch de 8 192, sans perte de précision. Leur recette repose sur deux règles. Le taux d'apprentissage est multiplié par le même facteur que le batch ; et les premières époques commencent par un échauffement à petit taux d'apprentissage.
Deux mois plus tard, deux stagiaires de NVIDIA et Boris Ginsburg, de NVIDIA, appliquent la même recette à AlexNet ; dès que le batch dépasse 2K, l'entraînement ne tient plus. Ce rapport technique de 8 pages à peine part de cet échec.
Définir le problème
L'entraînement data-parallèle répartit un batch sur de nombreuses cartes, qui calculent chacune leur gradient avant qu'on en fasse la moyenne. Plus il y a de cartes, chacune devant en outre être pleinement chargée, plus le batch global grossit. À nombre d'époques constant, multiplier le batch par divise par le nombre de mises à jour ; pour compenser, le plus simple est de multiplier aussi le taux d'apprentissage par . L'article illustre cette intuition avec ; deux pas successifs avec un petit batch équivalent à peu près à un pas avec un grand batch et un taux d'apprentissage double, à condition que le gradient du deuxième pas ressemble à celui du premier.
C'est en début d'entraînement que cette condition est la moins fiable, d'où l'échauffement ajouté par Goyal et al. Les auteurs appliquent la même méthode à l'AlexNet de BVLC, entraîné pendant 100 époques :
| Batch | Taux d'apprentissage | top-1 (%) |
|---|---|---|
| 512 | 0.02 | 58.8 |
| 4 096 | 0.05 | 53.1 |
| 8 192 | 0.03 | 44.8 |
D'après la Table 1(a) de l'article ; pour chaque batch, le taux d'apprentissage qui donne la meilleure précision, avec 2.5 époques d'échauffement.
Le taux d'apprentissage refuse tout simplement de monter. Avec un batch de 4K, au-delà de 0.06, l'entraînement diverge même avec échauffement, et il faut s'en tenir à 0.05 ; à 8K, on plafonne à 0.03, alors que selon la mise à l'échelle linéaire, il devrait valoir 16 fois celui du batch 512, soit 0.32.
D'autres se sont heurtés au même mur. Hoffer et al. passent à une mise à l'échelle en racine carrée, plus prudente, accompagnée d'une Ghost BatchNorm sur mesure, et AlexNet n'atteint encore que 53.93 % avec un batch de 8K, loin du niveau des petits batchs. Quand Krizhevsky a lui-même proposé la mise à l'échelle linéaire, il n'a poussé AlexNet que jusqu'à 1K, avec une perte d'environ 1 point.
Les auteurs commencent par remplacer les couches LRN d'AlexNet par BatchNorm, ce qui donne AlexNet-BN. Avec ce seul changement, et même sans échauffement, un batch de 8K accepte un taux d'apprentissage de 0.3 et atteint 58.0 %, à seulement 2.2 points des 60.2 % du batch 512 (contre 14 points auparavant). Les 2.2 points restants sont-ils le fossé de généralisation décrit par Keskar et al. ? Les auteurs comparent les pertes d'entraînement et de test des batchs de 256 et de 8K, et l'écart entre ces deux pertes ne diffère pas sensiblement d'un batch à l'autre ; ils en concluent que le problème vient de l'entraînement lui-même, mal mené, le modèle n'ayant pas encore assez appris.
Alors, pourquoi le taux d'apprentissage ne peut-il pas grandir ?
L'appétit de chaque couche
Après la première itération d'AlexNet-BN, les auteurs comparent, pour chaque couche, la norme des poids et celle du gradient :
| Couche | Rapport | ||
|---|---|---|---|
| conv1 | 0.098 | 0.017 | 5.76 |
| conv2 | 0.16 | 0.002 | 83.5 |
| conv3 | 0.196 | 0.0015 | 127 |
| conv4 | 0.196 | 0.0013 | 148 |
| conv5 | 0.16 | 0.0002 | 69 |
| fc6 | 6.4 | 0.005 | 1345 |
| fc7 | 6.4 | 0.013 | 489 |
| fc8 | 0.316 | 0.016 | 19 |
D'après la Table 2 de l'article, poids uniquement ; pour les biais, le rapport va de 8.48 à 117.
Ce rapport se lit directement comme un taux d'apprentissage, celui pour lequel une mise à jour a exactement la taille des poids eux-mêmes. Avec un taux d'apprentissage de 1, conv1 modifie environ 17 % de ses propres poids en un seul pas (), alors que fc6 ne bouge que de 0.07 % ().
Avec un seul taux d'apprentissage pour tout le réseau, il faut s'aligner sur la couche la plus facile à abîmer. Le plafond de conv1 est plus de deux cents fois plus bas que celui de fc6 ; augmentez un peu le taux d'apprentissage, et conv1 craque la première ; baissez-le pour protéger conv1, et des couches comme fc6 ne bougent presque plus. L'article observe aussi que ce rapport est maximal en début d'entraînement et chute rapidement au bout de quelques époques. Si l'échauffement fonctionne, c'est qu'un petit taux d'apprentissage est sans danger pour toutes les couches ; une fois que les poids ont un peu grandi, on peut le remonter.
Les auteurs prennent une autre direction. Puisque chaque couche a son propre appétit, autant donner à chacune son propre taux d'apprentissage.
Résoudre le problème
À chaque couche sa règle
LARS (Layer-wise Adaptive Rate Scaling) écrit la mise à jour de la couche comme le produit du taux d'apprentissage global et d'un taux propre à cette couche, le local LR :
est appelé trust coefficient (coefficient de confiance), au sens de « dans quelle mesure on accepte que cette couche change en un seul pas ». Toutes les expériences AlexNet de l'article utilisent ; pour ResNet-50, rien n'est précisé.
En combinant les deux formules, calculons la taille de la mise à jour :
La taille du gradient s'est simplifiée. À chaque pas, la mise à jour de chaque couche vaut fois la norme de ses propres poids ; le gradient ne décide plus que de la direction. Avec le qu'utilise AlexNet-BN pour un batch de 8K, tant que le taux d'apprentissage n'a pas décru, chaque pas injecte une mise à jour égale à 1.4 % de la norme des poids de la couche (sans compter l'accumulation du momentum), à égalité pour conv1 et fc6. Les auteurs notent aussi que, la taille de la mise à jour ne suivant plus celle du gradient, le problème de l'évanouissement ou de l'explosion du gradient s'en trouve en partie atténué.
Comparé aux méthodes adaptatives comme Adam ou RMSProp, LARS diffère sur deux points. Le premier est la granularité ; il utilise un taux d'apprentissage par couche, et non par paramètre, ce que l'article juge plus stable. Le second est la référence ; il règle l'amplitude de la mise à jour sur la taille des poids eux-mêmes, alors qu'Adam se fonde sur les statistiques historiques du gradient.
Ajouter la décroissance des poids et le momentum
Avec une décroissance des poids , celle-ci entre aussi au dénominateur :
La procédure d'entraînement complète (Algorithm 1 de l'article, en ajoutant à le de l'équation (6)) effectue, à chaque étape et pour chaque couche :
Le taux d'apprentissage global suit une décroissance polynomiale de degré 2, avec un momentum . Attention à l'ordre ; le trust ratio utilise la norme du gradient de l'étape courante, et ce n'est qu'après cette mise à l'échelle que le résultat s'accumule dans le momentum. Quand l'article LAMB reformulera plus tard LARS, il prendra la norme du momentum ; les deux versions ne sont pas tout à fait identiques.
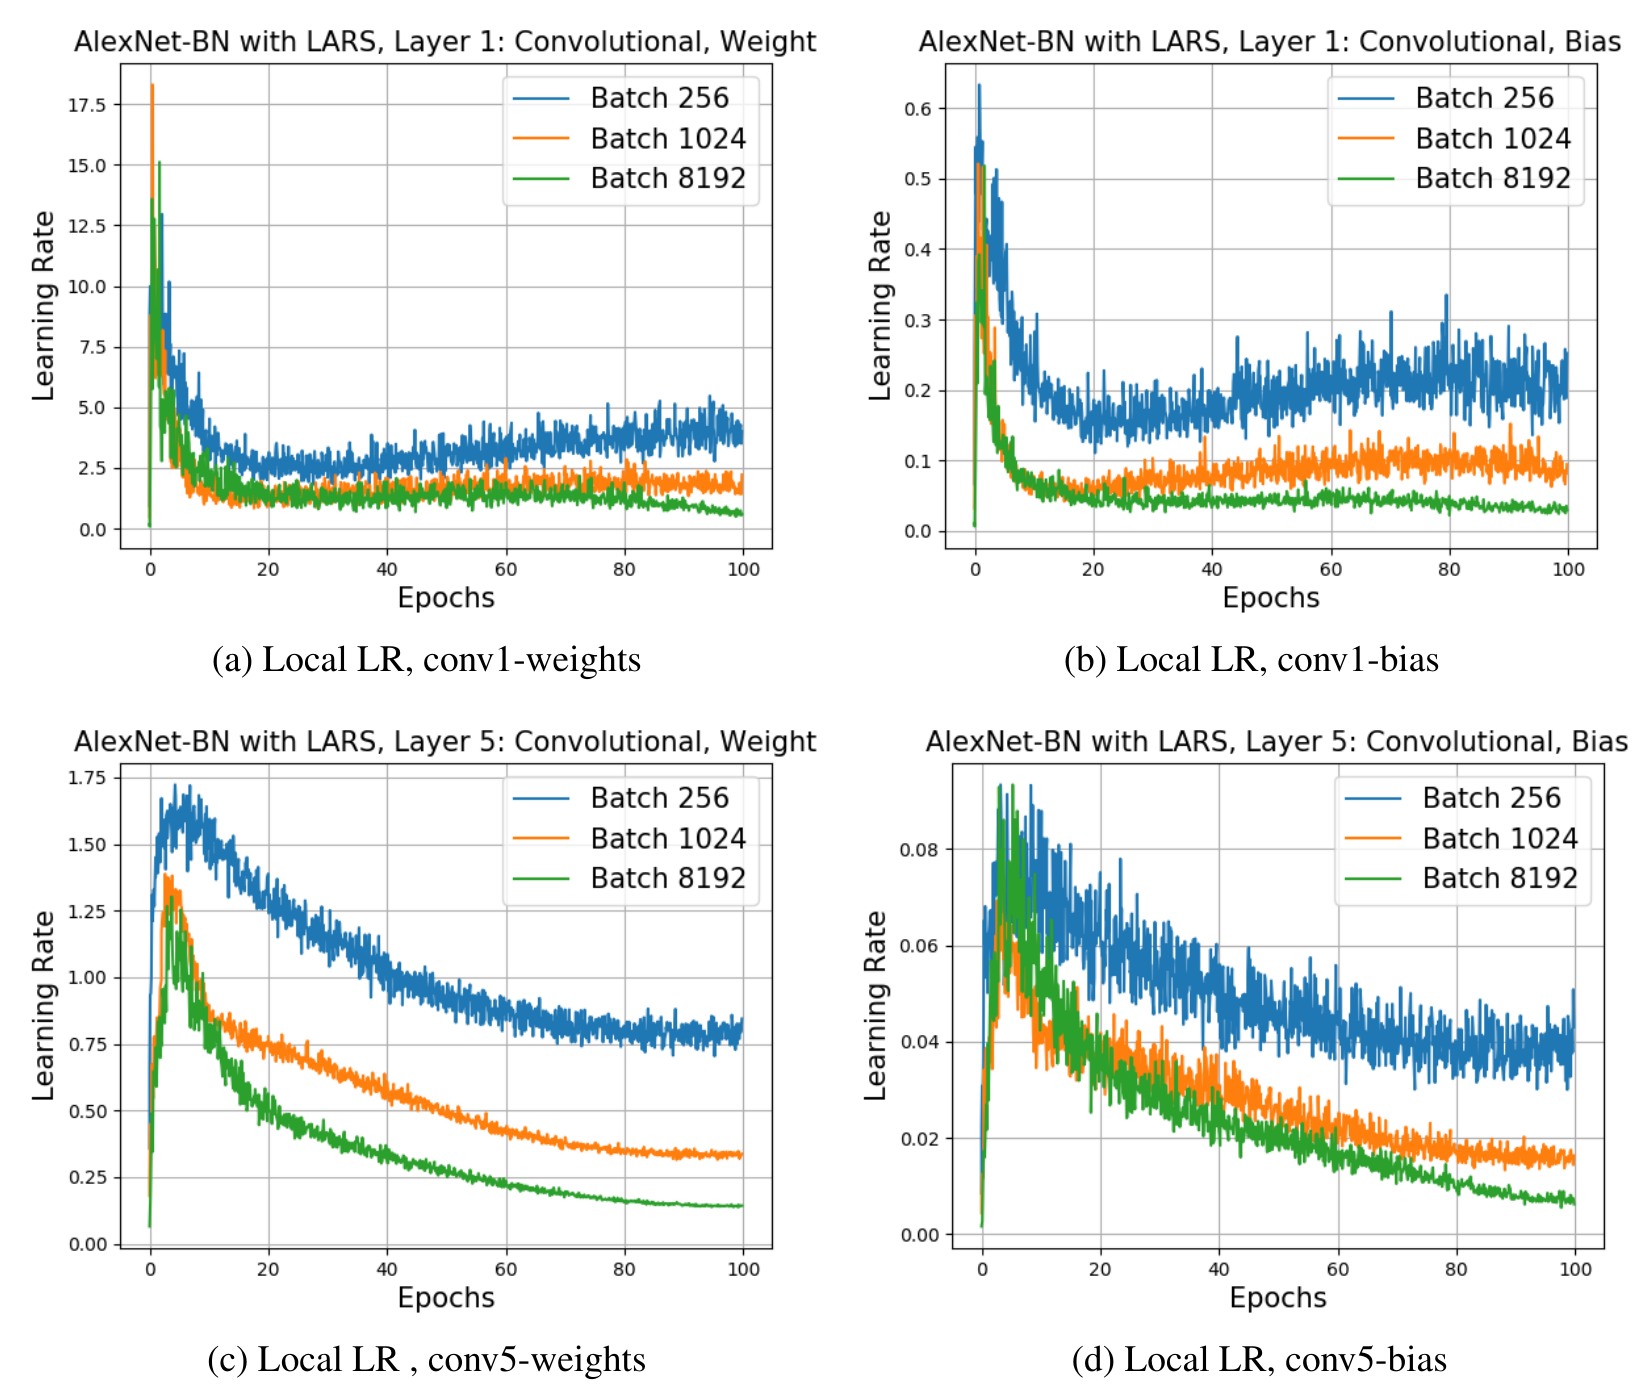
Cette figure montre le local LR calculé automatiquement par LARS. Regardez d'abord l'échelle des ordonnées ; les poids de conv1 montent jusqu'à 17.5, ceux de conv5 restent sous 1.75, et les deux biais sont encore plus petits, à 0.6 et 0.08 au plus. Dans un même réseau, les taux d'apprentissage effectivement utilisés par les différentes couches diffèrent d'un à deux ordres de grandeur. Regardez ensuite les trois courbes ; en fin d'entraînement, plus le batch est grand, plus la courbe est basse. L'article se contente de dire que le local LR « dépend fortement de la couche et de la taille de batch », sans plus d'explication. Un taux d'apprentissage qui varie ainsi selon la couche, le batch et l'avancement de l'entraînement serait bien difficile à reproduire avec une planification écrite à la main.
Discussion
AlexNet poussé jusqu'à 32K
Les auteurs réentraînent les deux réseaux avec LARS, pendant 100 époques chacun, avec SGD à momentum 0.9, une décroissance des poids de 0.0005 et , sur un NVIDIA DGX-1. Les batchs de 16K et de 32K ne tenant pas en mémoire, ils sont simulés en découpant le batch en morceaux et en accumulant les gradients avant chaque mise à jour.
| Batch | Taux AlexNet | AlexNet (%) | Taux AlexNet-BN | AlexNet-BN (%) |
|---|---|---|---|---|
| 512 | 2 | 58.7 | 2 | 60.2 |
| 4K | 10 | 58.5 | 10 | 60.4 |
| 8K | 10 | 58.2 | 14 | 60.1 |
| 16K | 14 | 55.0 | 23 | 59.3 |
| 32K | TBD | TBD | 22 | 57.8 |
D'après la Table 3 de l'article ; échauffement de 2 époques pour AlexNet et de 5 époques pour AlexNet-BN ; les TBD figurent tels quels dans l'article.
Avec un batch de 8K, AlexNet remonte de 44.8 % sans LARS à 58.2 %, à seulement 0.5 point du batch 512. AlexNet-BN tient plus loin encore, avec une perte de 0.9 point à 16K et de 2.4 points à 32K.
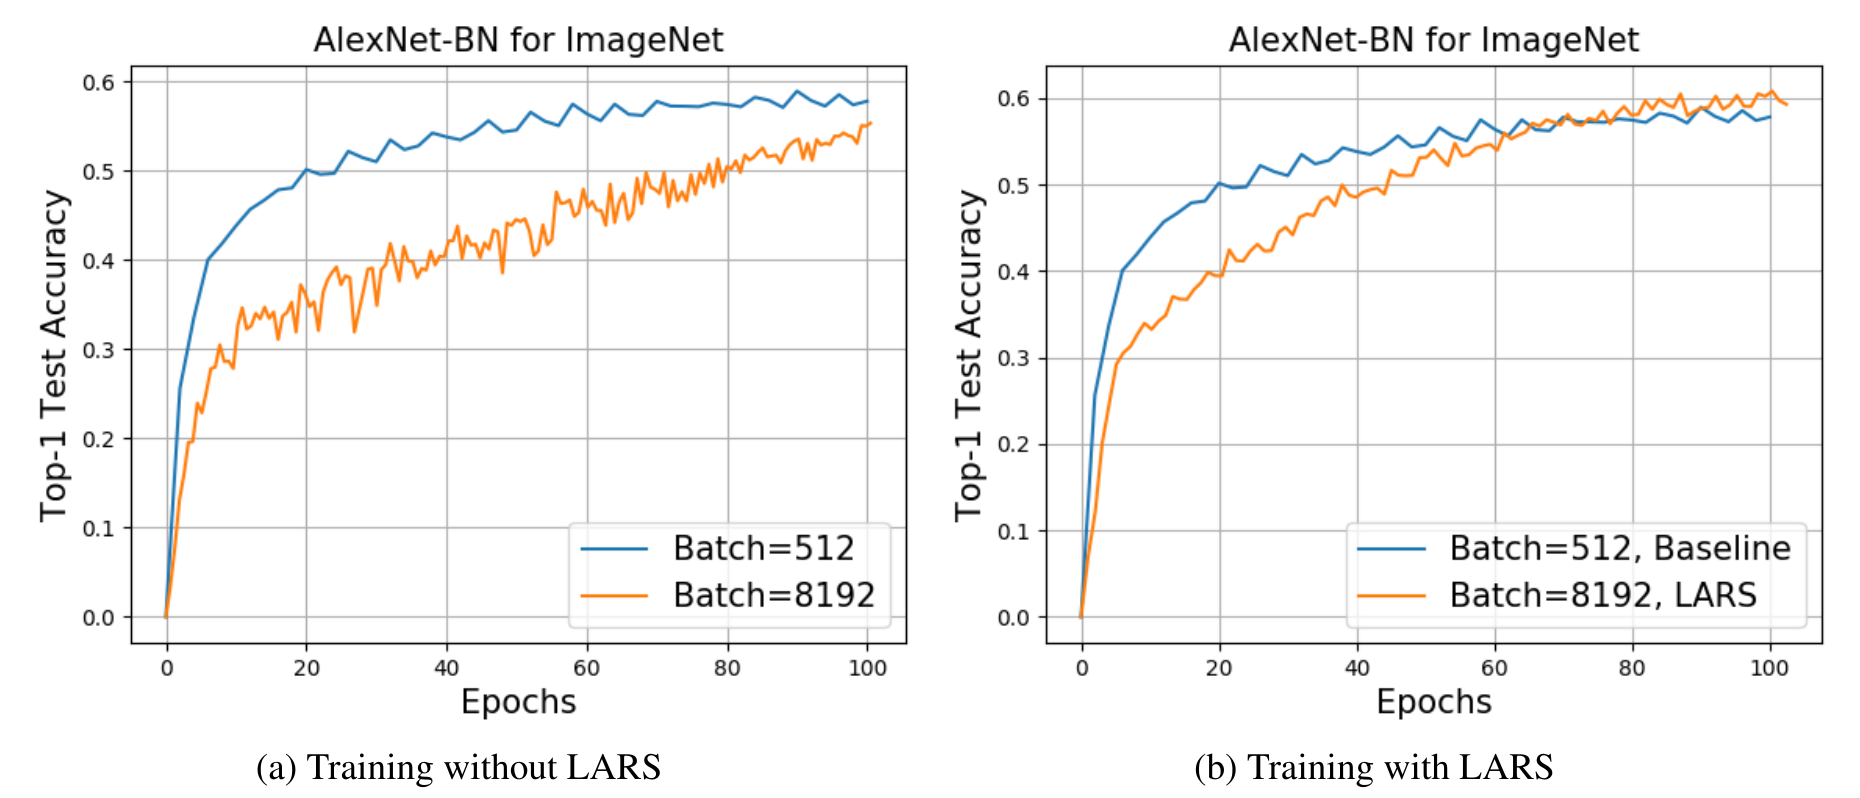
Cette figure montre l'entraînement d'AlexNet-BN avec un batch de 8K. À gauche, sans LARS, la courbe orange est en retrait du début à la fin ; à droite, avec LARS, elle reste en retrait pendant les 60 premières époques, puis rattrape la bleue et la dépasse légèrement. Le grand batch démarre toujours plus lentement, mais LARS lui permet de rattraper son retard dans le même nombre d'époques.
Deux autres observations concernent le réglage. D'abord, la plage de taux d'apprentissage utilisables est large ; pour AlexNet-BN à 16K, un taux de base de 13 à 22 donne partout environ 59.3 %, et à 32K, de 17 à 28, environ 57.5 %. Ensuite, l'écart restant à 32K se comble en entraînant plus longtemps ; 100, 125, 150 et 200 époques donnent respectivement 57.8 %, 59.2 %, 59.5 % et 59.9 %. Selon les auteurs, au-delà d'une certaine taille de batch, le gradient stochastique est déjà très proche du vrai gradient, et augmenter encore le batch n'apporte plus d'information. Notez toutefois que les 59.9 % à 200 époques restent sous les 60.2 %, et que doubler le nombre d'époques n'est de toute façon pas ce qu'on attend d'un grand batch.
ResNet-50
ResNet-50 est entraîné pendant 90 époques, avec un momentum de 0.9, une décroissance des poids de 0.0001, et LARS associé à 5 époques d'échauffement et à une décroissance polynomiale de degré 2 :
| Batch | Taux d'apprentissage global | top-1 (%) |
|---|---|---|
| 256 (sans LARS) | 0.2 | 73.0 |
| 8K | 0.6 | 72.7 |
| 16K | 2.5 | 73.0 |
| 32K | 2.9 | 72.3 |
D'après la Table 4 de l'article.
À 32K, on n'est qu'à 0.7 point sous la référence. Mais cette référence n'est que de 73 %, car les auteurs se limitent à l'augmentation de données la plus simple (redimensionnement en 256×256, puis recadrage aléatoire en 224×224 et retournement horizontal), et testent sur un unique recadrage central ; la référence de Goyal et al. est de 76.4 %. De plus, l'article ne dit pas sur quel matériel tournent les grands batchs de ResNet-50, et il précise que les 16K et 32K d'AlexNet sont simulés par accumulation de gradients ; nulle part il ne présente de temps réel écoulé mesuré en passant effectivement à des milliers de cartes.
LARS ne marche pas non plus pour toutes les tâches. Un an et demi plus tard, le même premier auteur, chez Google, préentraîne BERT avec LARS ; à 16K, le F1 sur SQuAD tombe à 89.6, et à 32K, l'entraînement diverge purement et simplement. Cet échec le mène à l'optimiseur suivant.
Remis à l'épreuve
LARS est ensuite devenu l'équipement standard des grands batchs. Dans l'épreuve ResNet-50 de MLPerf Training, la closed division n'autorise que deux optimiseurs, SGD avec momentum ou LARS, et les vainqueurs de deux éditions utilisent LARS, avec des batchs de 32 768 et de 65 536. L'apprentissage auto-supervisé l'adopte aussi largement ; SimCLR écrit explicitement « pour stabiliser l'entraînement, nous utilisons LARS pour toutes les tailles de batch », et BYOL fait de même.
En 2021, Nado et ses collègues de Google reprennent la question dans « A Large Batch Optimizer Reality Check ». LARS est-il vraiment plus doué que les optimiseurs ordinaires pour les grands batchs ? Ils relèvent que la précision de ResNet-50 dans l'article LARS est faible, et qu'aucune comparaison n'y est faite avec d'autres optimiseurs à batch égal. Ils reprennent le pipeline LARS le plus rapide de MLPerf en ne changeant que l'optimiseur et les hyperparamètres, passent au momentum de Nesterov, et font 50 exécutions dans chaque cas, avec un batch de 32 768 et 2 512 étapes (64 époques). LARS obtient une médiane de 75.97 % et atteint le seuil de 75.9 % dans 35 exécutions sur 50 ; les deux configurations Nesterov obtiennent respectivement 75.97 % (34 fois) et 75.92 % (29 fois).
Égaler LARS n'a rien eu de facile. Ils découvrent que le « LARS » de MLPerf n'applique en fait LARS qu'aux poids ordinaires, confie les paramètres de BatchNorm et les biais à un simple momentum heavy-ball, et n'ajoute pas de régularisation L2 ; ce détail ne figure pas dans l'article LARS, mais s'avère « extrêmement important » pour les deux optimiseurs. Côté Nesterov, il faut encore régler à nouveau le lissage des étiquettes, l'initialisation de BatchNorm et la forme de la courbe d'échauffement pour rattraper LARS. La précision d'entraînement mérite aussi un coup d'œil. Nesterov atteint 78.97 % et LARS 78.07 %, pour une précision de test à peu près identique. Nado et al. estiment donc que la normalisation couche par couche de LARS joue peut-être plutôt un rôle de régularisation. En portant le budget à 6 000 étapes avec la planification cosinus la plus simple, Nesterov obtient 76.7 % et LARS 76.9 %, et plusieurs configurations dépassent sans peine les 75.9 %. Leur conclusion est que les grands batchs ne sont pas si instables en soi ; la difficulté est de régler correctement tous les hyperparamètres avec un budget d'étapes extrêmement serré.
Les auteurs de NFNet sont aussi passés par là. L'écrêtage adaptatif du gradient (AGC) de NFNet regarde lui aussi le rapport entre norme du gradient et norme des poids ; l'article le présente comme une version assouplie des optimiseurs normalisés de type LARS, qui se contente de plafonner la mise à jour sans ignorer complètement la taille du gradient. Ils ont essayé LARS directement ; l'entraînement à grand batch reste stable, mais la précision baisse.
Conclusion
L'apport de LARS tient en un tableau et une ligne de formule. Le tableau montre que le rapport varie d'un facteur de plus de deux cents entre les couches d'AlexNet-BN ; la formule fixe la mise à jour de chaque couche à une fraction de ses propres poids. Grâce à cela, AlexNet remonte de 44.8 % à 58.2 % avec un batch de 8K, et ResNet-50 ne perd que 0.7 point à 32K. LARS n'a pas pour autant démontré que les optimiseurs ordinaires en étaient incapables ; un peu plus de trois ans plus tard, Nado et al. l'égalent avec Nesterov, au même nombre d'étapes.
Si vous implémentez LARS vous-même, excluez les paramètres de BatchNorm et les biais du trust ratio et de la décroissance des poids, comme le font MLPerf et les implémentations auto-supervisées ultérieures. Et si vous le comparez à d'autres optimiseurs, prenez la peine de régler sérieusement un SGD avec momentum au même nombre d'étapes.
Les deux cases TBD d'AlexNet à 32K dans la Table 3 sont restées telles quelles jusqu'à la version finale v3, et n'ont jamais été remplies.