Article original
Adam: A Method for Stochastic Optimization
- Publication
- ICLR 2015Conférence
- Premier dépôt sur arXiv
- arXiv:1412.6980
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizersadam2014,
  title = {{Adam: A Method for Stochastic Optimization}},
  author = {Diederik P. Kingma and Jimmy Ba},
  year = {2014},
  eprint = {1412.6980},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1412.6980}
}
En première page de l'article, une note de bas de page précise que les deux auteurs ont contribué à parts égales, et que l'ordre des noms a été tiré à pile ou face sur Google Hangout.
Après le tirage, Diederik Kingma passe devant, Jimmy Ba derrière, et l'article est mis en ligne sur arXiv en décembre 2014. La légende de l'Algorithm 1 contient la phrase « Good default settings for the tested machine learning problems », suivie de quatre nombres, , , , .
Dix ans plus tard, dans PyTorch, les valeurs par défaut de torch.optim.Adam sont toujours ces quatre nombres.
Cette note décortique l'Algorithm 1 ligne par ligne. Qu'estiment exactement les deux moyennes mobiles ? Pourquoi diviser par ? Quelle distance parcourt-on à chaque pas ? Qu'ont démontré les expériences de l'article, et quelle partie a ensuite été réfutée ?
Définir le problème
Pour entraîner un réseau de neurones, nous n'avons que des gradients calculés sur des mini-lots, et chaque pas est bruité ; les régularisations comme le dropout ajoutent encore une couche d'aléa. Les paramètres se comptent facilement par millions, les méthodes du second ordre coûtent trop cher, et l'article se limite d'emblée aux méthodes du premier ordre.
Le SGD de base utilise le même taux d'apprentissage pour tous les paramètres. Or l'amplitude des gradients peut varier de plusieurs ordres de grandeur d'un paramètre à l'autre ; un même taux d'apprentissage est trop grand pour certains et trop petit pour d'autres.
Deux approches traitaient déjà ce problème.
- AdaGrad garde, pour chaque paramètre, la somme des carrés de tous ses gradients passés, et divise le gradient par sa racine carrée, . Une caractéristique rare a une petite somme de carrés, donc un grand pas ; la méthode est particulièrement efficace sur les données creuses. En contrepartie, la somme ne fait que croître, et le taux d'apprentissage diminue sans cesse.
- RMSProp remplace la somme par une moyenne mobile exponentielle, qui ne regarde que les gradients récents. Le taux d'apprentissage ne diminue plus sans fin, et la méthode s'accommode mieux d'une fonction objectif qui change au fil du temps.
Adam veut réunir les avantages des deux. La section 5 de l'article souligne en outre que RMSProp n'a pas de correction du biais. Quand est proche de 1 (justement le réglage dont les gradients creux ont besoin), RMSProp sans correction fait des pas initiaux énormes, et diverge souvent d'emblée.
L'article cherche donc à savoir si l'on peut construire un optimiseur qui n'utilise que des gradients du premier ordre, dont la mémoire ne demande que deux copies supplémentaires de la taille des paramètres, qui gère à la fois les gradients creux et les objectifs non stationnaires, et qui avance de façon stable dès le début de l'entraînement.
Résoudre le problème
Algorithm 1
Commençons par écrire l'algorithme en entier. Toutes les opérations se font élément par élément ; désigne , et est à la puissance :
Au départ, et ; chaque itération commence par incrémenter .
est la moyenne mobile exponentielle du gradient ; l'article l'appelle estimation du moment d'ordre un, c'est-à-dire de la moyenne du gradient. est la moyenne mobile exponentielle du carré du gradient, une estimation du moment d'ordre deux (la variance non centrée). Le nom Adam vient de adaptive moment estimation (d'après les remerciements, ce sont Ivo Danihelka et Tom Schaul qui l'ont trouvé).
La mise à jour vaut . Le numérateur donne la direction et, comme c'est une moyenne mobile, il a un effet de momentum ; le dénominateur donne à chaque paramètre sa propre échelle. Cela revient à donner à chaque paramètre son propre taux d'apprentissage , simplement réestimé à chaque pas à partir des gradients récents.
L'article propose aussi une écriture un peu plus économe en calcul, qui fusionne les deux corrections en un seul coefficient :
Les deux écritures ne diffèrent que par l'endroit où l'on ajoute ; le ci-dessus et le de l'Algorithm 1 sont deux grandeurs différentes. Cette petite différence est restée dans les frameworks ; nous y reviendrons dans la discussion.
La correction du biais
Les deux divisions du milieu sont la principale différence entre cet article et RMSProp, et c'est précisément ce que dérive la section 3.
En développant la récurrence de , on obtient une somme pondérée de tous les carrés des gradients passés :
Prenons l'espérance des deux côtés. Si l'on suppose que l'espérance du carré du gradient ne change pas dans le temps, on peut sortir , et il reste une série géométrique :
Si le moment d'ordre deux est réellement stationnaire, ; même s'il varie, reste petit tant que donne un poids assez faible aux gradients trop anciens. Le facteur qui reste vient uniquement du départ à ; en divisant par ce facteur, l'estimation retrouve la bonne échelle. La dérivation pour est identique.
Calculons le premier pas avec les valeurs par défaut. À :
- , soit un dixième seulement de la vraie valeur ;
- , ce qui donne après la racine carrée, environ un trentième seulement de la vraie échelle.
Les deux sont trop petits, mais l'est davantage. Sans correction, le premier pas vaut . Avec la correction, et , et le premier pas de chaque paramètre vaut exactement .
Voilà le premier pas d'Adam. Que le gradient vaille ou , chaque paramètre ne se déplace que de .
Et sans correction, combien de temps durent ces pas trop grands ? Si l'on suppose un gradient identique à chaque étape, la longueur du pas sans correction vaut . Traçons-la.
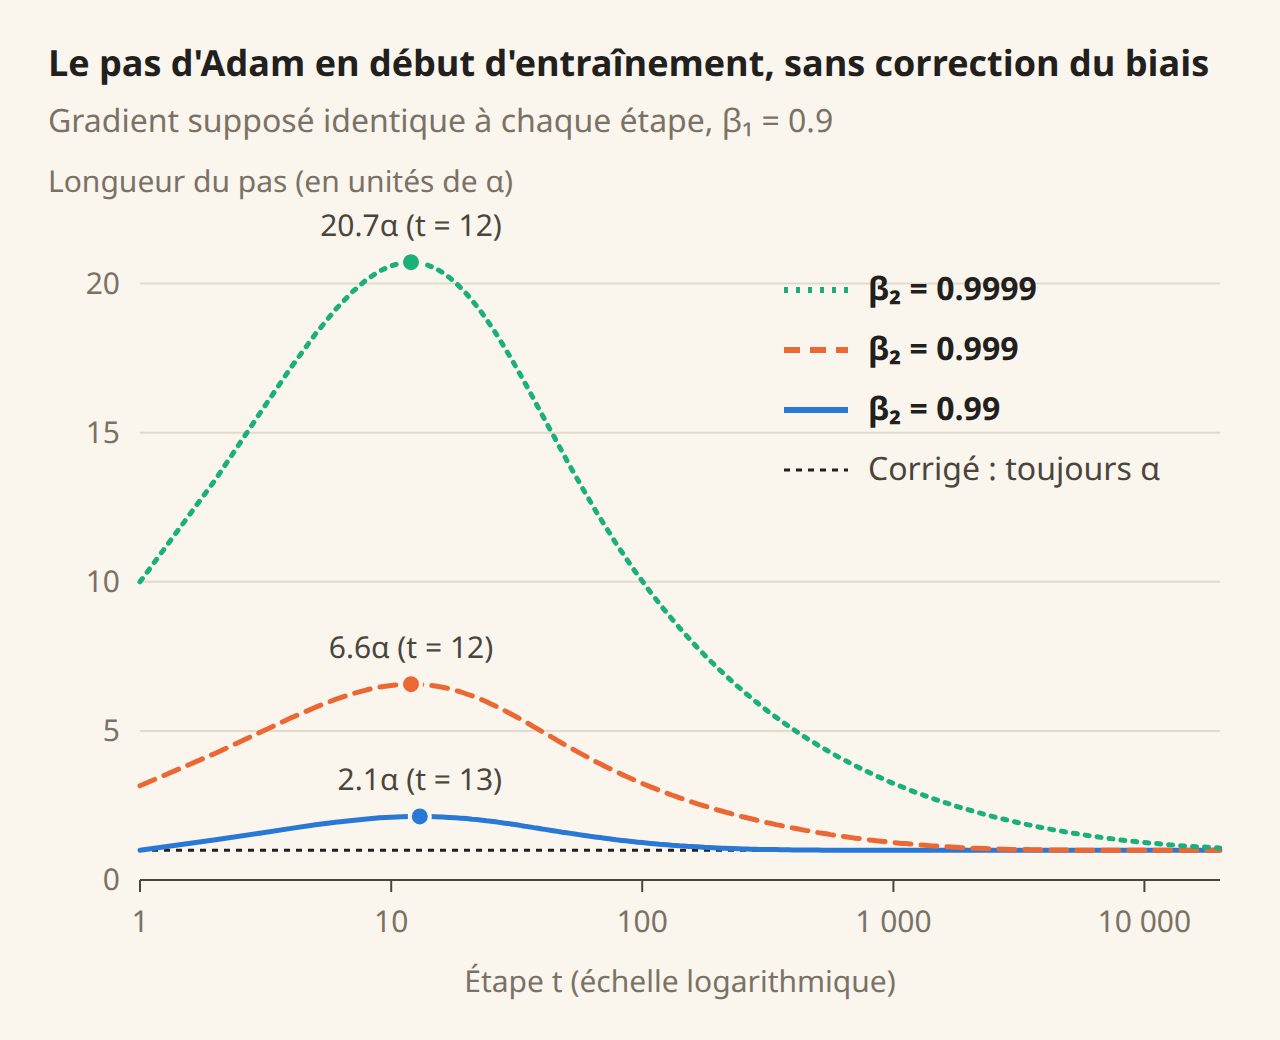
Les trois courbes culminent vers les étapes 12 et 13. À ce moment, a déjà accumulé environ 70 % de sa vraie valeur ; avec , n'en a accumulé qu'environ 1 %, et à peine plus de 10 % après la racine carrée. Le numérateur a rattrapé son retard, pas le dénominateur. Avec , le maximum est de , et il faut plus de 1 700 étapes pour revenir sous ; avec , le maximum est de , et il en faut plus de 17 000.
Si l'on retire en plus le momentum (), le premier pas sans correction vaut , soit pour . Le taux d'apprentissage est réglé à , et le premier pas équivaut pourtant à un taux de .
C'est exactement la situation que décrit l'article. Les gradients creux exigent un très grand pour moyenner assez d'échantillons, et plus est proche de 1, plus le biais initial non corrigé est sévère.
Quelle distance pour un pas ?
La section 2.1 analyse ensuite la mise à jour elle-même. Posons d'abord ; le pas effectif vaut alors .
est la « moyenne du gradient » divisée par la « racine carrée de la moyenne du carré du gradient ». Comme , la valeur absolue de ce rapport ne dépasse généralement pas 1, et est donc à peu près borné par .
Il y a une exception. Si le gradient d'un paramètre a toujours été nul et ne prend une valeur qu'à ce pas-ci, vaut environ et environ , et le rapport devient . La borne supérieure que donne l'article distingue donc deux cas :
Avec les valeurs par défaut, est supérieur à ; le réglage par défaut tombe donc dans le premier cas, et le pire cas vaut . Cela n'arrive que pour des paramètres extrêmement creux ; d'après l'article, quand la parcimonie est moins extrême, le pas effectif est plus petit que cette borne.
Cette propriété a trois conséquences pratiques.
- est la taille du pas. C'est à peu près la distance parcourue à chaque pas dans l'espace des paramètres ; l'article la compare à une région de confiance tracée autour des paramètres courants. Si l'on sait à peu près à quelle distance de l'initialisation se trouve une bonne solution, on peut en déduire l'ordre de grandeur de .
- Indépendance vis-à-vis de l'échelle du gradient. Si l'on multiplie le gradient par , est multiplié par et par , et le rapport ne change pas. Si l'on multiplie la fonction de perte par 1000, le pas de SGD est multiplié par 1000, alors qu'Adam n'est pas affecté du tout.
- Recuit automatique. L'article emprunte l'expression « rapport signal sur bruit » pour désigner . Près de l'optimum, la direction du gradient change souvent de signe ; sa moyenne s'approche de 0 alors que la moyenne de son carré demeure, le rapport diminue, et le pas avec lui.
Liens avec AdaGrad et RMSProp
La section 5 replace Adam dans sa famille d'origine.
Par rapport à RMSProp, il y a deux différences. RMSProp avec momentum divise d'abord le gradient par l'échelle, puis applique le momentum au résultat ; Adam estime séparément les moments d'ordre un et deux du gradient, puis divise l'un par l'autre. L'autre différence est la correction du biais.
Le lien avec AdaGrad est plus intéressant. Avec , tendant vers 0 et un taux d'apprentissage remplacé par , le corrigé devient ; réinjecté dans la mise à jour, il donne exactement AdaGrad. Cette correspondance ne tient que si l'on garde la correction du biais ; sans elle, tendant vers 1 fait tendre vers 0, et la mise à jour devient infinie.
L'article note aussi que peut se voir comme une approximation de la diagonale de la matrice d'information de Fisher ; Adam revient à un préconditionnement (preconditioning) par l'inverse de sa racine carrée. C'est un peu plus prudent que le gradient naturel, qui utilise directement l'inverse de la matrice de Fisher.
AdaMax
La section 7.1 propose une extension. Adam met le gradient à l'échelle avec une norme ; les auteurs généralisent à :
Pour grand, le calcul devient numériquement instable ; mais si l'on fait tendre en posant , seul le plus grand terme survit dans la somme pondérée, et l'on obtient une récurrence très simple :
est « le plus grand gradient passé, atténué au fil du temps ». Si apparaît à un pas, passe à 10, puis est multiplié par 0.999 à chaque pas ; mille pas plus tard, il vaut encore environ 3.7. Il n'a pas besoin de correction du biais, car vaut au moins le courant et ne remonte pas lentement depuis 0. La borne sur le pas est aussi plus simple, . L'article recommande par défaut , avec les mêmes et qu'Adam.
Par ailleurs, la section 7.2 propose une moyenne mobile exponentielle des paramètres, , dont le biais initial est lui aussi corrigé par .
La preuve de convergence
La section 4 analyse Adam dans le cadre de l'optimisation convexe en ligne. À chaque pas, l'algorithme fait face à une fonction convexe inconnue à l'avance ; le critère est le regret, c'est-à-dire l'excès de perte cumulée par rapport au meilleur paramètre fixe choisi a posteriori :
Les conditions du Theorem 4.1 sont nombreuses. Il faut des gradients bornés, des distances bornées entre les itérés, , un taux d'apprentissage décroissant en , et un qui décroît lui aussi dans le temps, selon . Sous ces conditions, l'article obtient un regret en , et le regret moyen tend vers 0.
En pratique, on fait rarement tourner Adam dans ces conditions ; le taux d'apprentissage est souvent fixe ou suit une autre planification, et reste fixé à 0.9. L'article reconnaît lui-même, à la section 6.2, que cette analyse ne s'applique pas aux problèmes non convexes comme les réseaux de neurones.
Ce théorème s'est ensuite révélé faux. En 2018, Reddi, Kale et Kumar montrent qu'à une étape, la preuve en annexe traite comme une quantité qui ne peut pas être négative. Cette quantité mesure la variation dans le temps de « l'inverse du taux d'apprentissage effectif » ; le d'Adam est une moyenne mobile, qui diminue quand les gradients diminuent, et la quantité peut donc être négative. Ils relèvent aussi des problèmes dans les lemmes 10.3 et 10.4, et construisent un problème convexe à une dimension qui satisfait les conditions du théorème, et sur lequel Adam converge vers le pire point.
Discussion
Les trois séries d'expériences, régression logistique, perceptron multicouche et réseau convolutif, utilisent toutes une taille de lot de 128, avec les mêmes paramètres initiaux pour tous les optimiseurs comparés ; les hyperparamètres comme le taux d'apprentissage et le momentum sont cherchés sur une grille dense, et seule la meilleure combinaison est rapportée. L'article ne trace que des courbes de perte ; pour les trois premières séries, il précise qu'il s'agit de la perte d'entraînement, et aucune précision de test n'est donnée. Gardez-le en tête en lisant les figures ; ces expériences comparent « qui fait baisser la perte d'entraînement le plus vite ».
Régression logistique
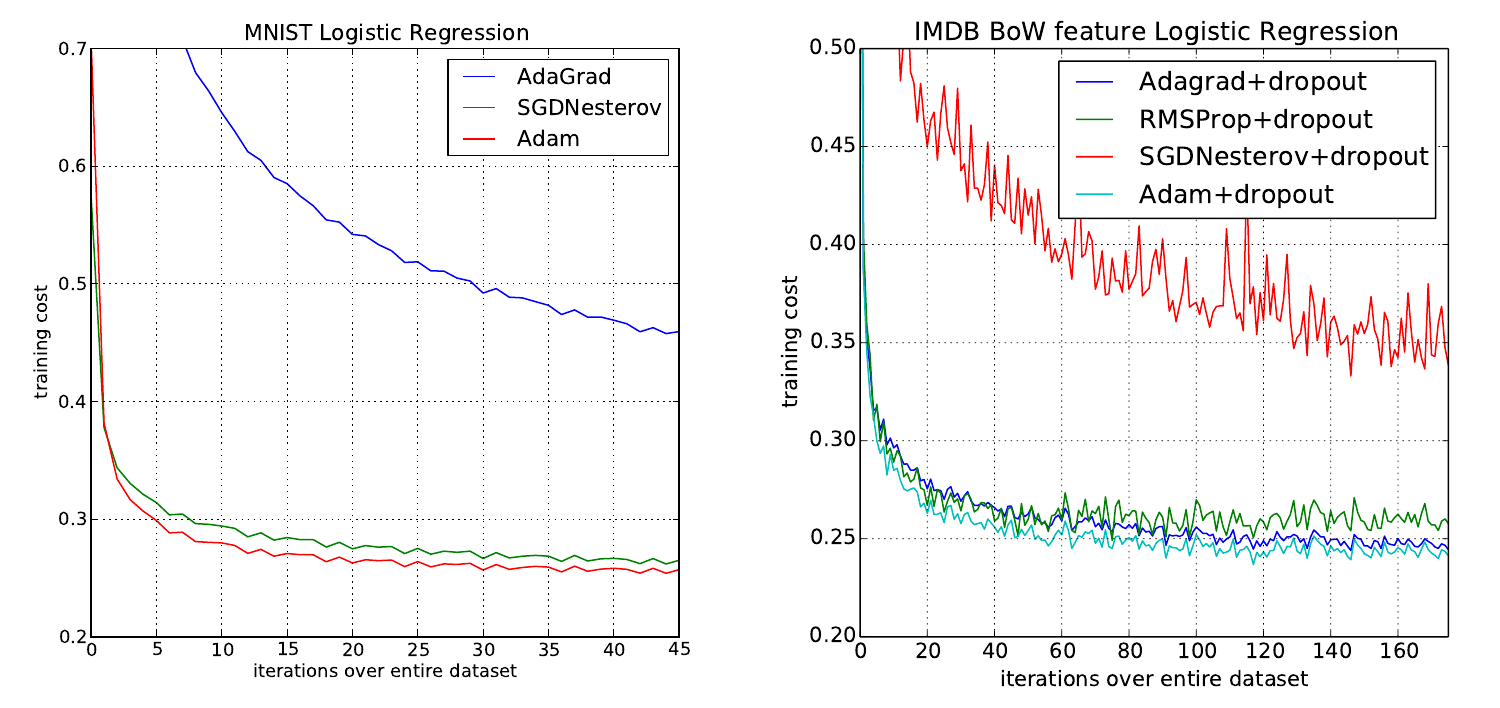
La régression logistique est un problème convexe ; pas de minimum local à craindre, ce qui en fait un bon terrain pour comparer simplement les optimiseurs. Dans cette série, le taux d'apprentissage décroît en , comme le veut la théorie de la section 4.
À gauche, MNIST, où l'on classe directement le vecteur de 784 pixels. Adam et SGD avec momentum font à peu près jeu égal, et tous deux sont bien plus rapides qu'AdaGrad.
C'est le graphique de droite qui montre ce qu'Adam veut prouver. Les auteurs transforment les critiques de films d'IMDB en vecteurs de sac de mots sur les 10 000 mots les plus fréquents ; chaque critique n'utilise que très peu de ces mots, ce qui donne des caractéristiques très creuses. Pour éviter le surapprentissage, 50 % de dropout est appliqué aux caractéristiques. Ici, AdaGrad devance largement SGD, et Adam est aussi rapide qu'AdaGrad. Adam a bien hérité de l'avantage sur les caractéristiques creuses.
Perceptron multicouche
Vient ensuite un réseau entièrement connecté à deux couches de 1000 unités ReLU chacune, toujours sur MNIST. Dans la version avec dropout, la perte d'entraînement d'Adam est inférieure à celles d'AdaGrad, RMSProp, SGD avec momentum et AdaDelta.
Dans la version sans dropout, avec une décroissance des poids L2 à la place, les auteurs comparent aussi Adam à SFO. SFO est une méthode quasi-Newton qui fonctionne par mini-lots et met à jour une information de courbure à chaque pas ; elle est 5 à 10 fois plus lente qu'Adam, et sa mémoire croît linéairement avec le nombre de mini-lots. Adam est plus rapide, qu'on compte en itérations ou en temps réel ; et comme SFO suppose que chaque sous-fonction est déterministe, elle ne converge pas avec du dropout.
Réseau convolutif
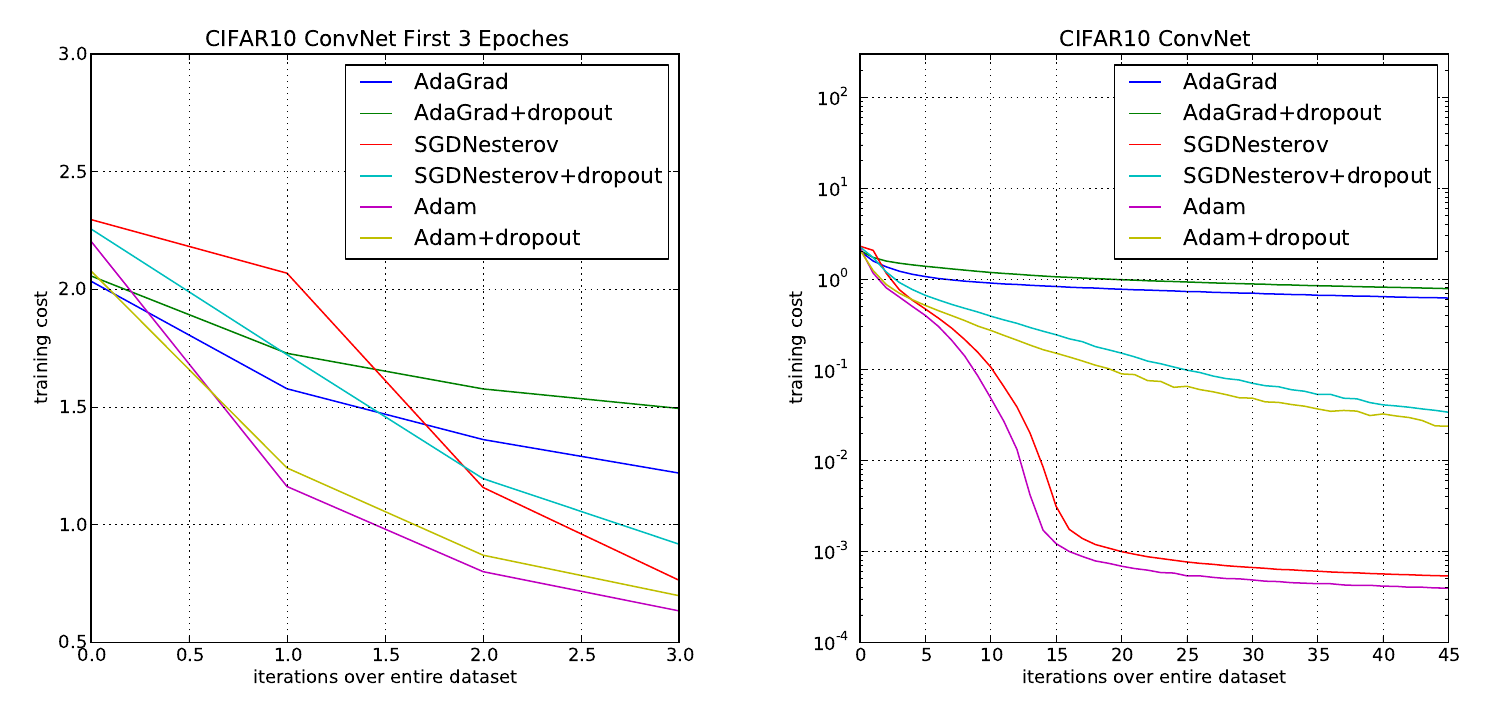
Le réseau comporte trois étages de convolution suivis d'un max-pooling de stride 2, avec 64, 64 et 128 canaux, puis une couche entièrement connectée de 1000 ReLU ; l'entrée est d'abord blanchie, et du dropout est appliqué à la couche d'entrée et à la couche entièrement connectée.
Sur les 3 premières époques, à gauche, Adam et AdaGrad descendent tous deux très vite. Mais à droite, sur 45 époques, AdaGrad s'arrête très tôt, alors qu'Adam et SGD avec momentum descendent jusque sous .
Les auteurs en donnent une explication très concrète. Ils observent qu'après quelques époques, devient si petit qu'il est presque nul ; le dénominateur est dominé par , et le moment d'ordre deux ne décrit plus la géométrie du problème. Sur les réseaux convolutifs, c'est surtout le moment d'ordre un qui agit, en moyennant le bruit des mini-lots. En poussant cette explication plus loin, quand le dénominateur est dominé par , Adam se comporte plutôt comme un SGD avec momentum, ce qui concorde avec la proximité des deux courbes. Les auteurs écrivent aussi, très honnêtement, qu'Adam n'apporte qu'une petite amélioration par rapport à SGD avec momentum ; son avantage est d'ajuster automatiquement l'échelle du taux d'apprentissage pour chaque couche, sans avoir à choisir à la main un taux plus petit pour les couches convolutives.
est présenté comme « une petite constante qui évite la division par zéro », mais dès que devient du même ordre de grandeur que lui, il participe réellement à la mise à jour.
L'expérience sur la correction du biais
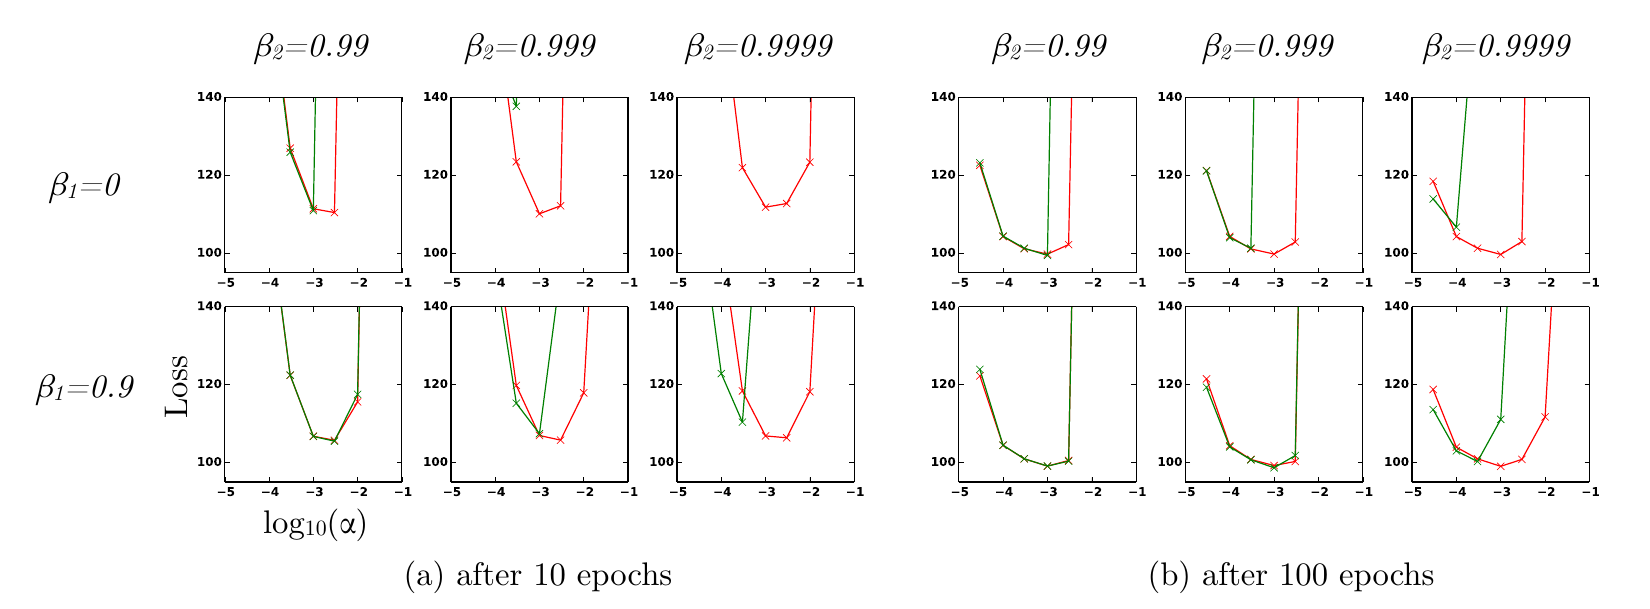
C'est la figure de l'article qui teste la conception le plus directement. Les auteurs entraînent un autoencodeur variationnel (VAE, une seule couche cachée de 500 unités softplus, variable latente gaussienne de dimension 50), en balayant , , et de à . L'article considère Adam sans correction du biais comme une forme de RMSProp avec momentum.
Dans chaque petit graphique, l'abscisse est le taux d'apprentissage et l'ordonnée la perte ; la courbe rouge est avec correction, la verte sans.
- Dans la colonne , les courbes rouge et verte se superposent à peu près ; seule la courbe verte de la ligne sort du graphique, au plus grand taux d'apprentissage. Avec ce réglage, le biais dû à l'absence de correction disparaît en une ou deux centaines de pas, et son effet sur l'ensemble de l'entraînement est faible.
- En allant à droite jusqu'à , la courbe verte sort du graphique dès que le taux d'apprentissage devient assez grand. Le cas le plus grave est la première ligne du groupe de gauche, , où les courbes vertes de et sont presque entièrement hors du graphique ; sans correction, le premier pas de ces deux cases vaut respectivement et .
- Dans le groupe de droite, entraîné 100 époques, le minimum de la courbe rouge est autour de 100 dans les six graphiques ; dans la colonne , ce minimum se situe à . Au même taux d'apprentissage, la courbe verte est déjà hors du graphique pour , et remonte vers 110 pour ; la plage de taux d'apprentissage utilisables est bien plus large pour la courbe rouge.
Les auteurs concluent que, pour proche de 1, l'absence de correction du biais rend l'entraînement instable, surtout pendant les premières époques ; les meilleurs résultats sont obtenus avec un très petit et la correction du biais. Sur tous les hyperparamètres qu'ils ont balayés, Adam fait au moins aussi bien que RMSProp.
Les auteurs ajoutent une observation. En fin d'entraînement, les unités cachées se spécialisent chacune et les gradients deviennent plus creux ; l'avantage d'un grand est alors plus net. Autrement dit, un proche de 1 est justement le réglage souhaité, et la correction du biais permet de l'utiliser sans crainte.
Où ajouter
Revenons à la différence entre les deux écritures. L'Algorithm 1 ajoute au corrigé, alors que l'écriture économe ajoute au non corrigé. En convertissant l'une dans l'autre, ; l'écart est maximal en début d'entraînement.
Les frameworks ont fait des choix différents. PyTorch suit l'Algorithm 1, avec eps=1e-8 par défaut ; la documentation de Keras précise que son epsilon est le de l'article, avec une valeur par défaut de 1e-7. Quand on transporte des hyperparamètres d'un framework à l'autre, les deux s'appellent epsilon, mais ce sont deux grandeurs différentes.
Cette constante en apparence anodine est aussi réglée dans l'entraînement des grands modèles. OLMo 2 a abaissé le d'AdamW de à , et rapporte que la norme du gradient en début d'entraînement est ainsi devenue plus basse et plus stable.
Les années sans correction du biais
La dérivation de la section 3 ressemble à un détail, mais elle a eu une vraie suite.
Dans le code officiel de BERT, l'optimiseur BERTAdam a supprimé les deux lignes de correction du biais ; cette écriture a ensuite été copiée dans Hugging Face Transformers (revenu à l'Adam standard seulement en juillet 2019), AllenNLP et d'autres bibliothèques courantes. En 2020, l'article de Zhang et al., « Revisiting Few-sample BERT Fine-tuning », cherche pourquoi l'affinage de BERT sur de petits jeux de données est instable, et découvre que c'est justement l'une des causes principales.
Ils affinent le modèle sur quatre petits jeux de données, RTE, MRPC, STS-B et CoLA, avec 50 graines aléatoires pour chacun. Sans correction du biais, de nombreux affinages n'apprennent rien du tout ; sur RTE, par exemple, 48 % des exécutions ont une précision inférieure à 55 %, proche du hasard. En rétablissant la correction du biais, la variance des résultats diminue fortement.
La cause est la même que dans le graphique des pas plus haut. L'affinage sur ces petits jeux de données compte généralement moins de mille pas, et tout le processus se déroule dans la phase où le biais est le plus fort. Sur MNLI, où l'entraînement compte bien plus de pas, l'écart avec ou sans correction tombe dans la marge d'erreur (précision sur le jeu de validation, 86.0 sans correction, 85.9 avec).
Trois questions ensuite
Adam est vite devenu l'optimiseur par défaut ; dans les années suivantes, les critiques qui le visent suivent à peu près trois lignes :
- Convergence. L'erreur de preuve mentionnée plus haut. Avec un exemple où un grand gradient apparaît tous les trois pas, Reddi et al. montrent que « oublie » les grands gradients rares, et proposent AMSGrad, qui garde le maximum historique.
- Généralisation. En 2017, Wilson et al. constatent sur plusieurs tâches de vision et de langage que la perte d'entraînement d'Adam baisse vite, mais que ses résultats en test sont souvent inférieurs à ceux d'un SGD bien réglé.
- Régularisation. Loshchilov et Hutter montrent que, dans Adam, écrire la régularisation L2 dans le gradient n'équivaut pas à appliquer directement une décroissance des poids, et proposent AdamW.
Conclusion
Adam estime séparément, avec deux moyennes mobiles exponentielles, la moyenne du gradient et la moyenne de son carré, et leur rapport donne à chaque paramètre son propre pas ; la division par corrige le biais dû au départ à zéro, et place dès le premier pas la mise à jour à l'échelle de . La preuve la plus convaincante de l'article est l'expérience sur le VAE, qui montre que plus est proche de 1, plus la correction du biais compte. Les autres expériences ne comparent que la perte d'entraînement, et sur le réseau convolutif, l'écart avec SGD avec momentum est faible. Quant au théorème de convergence, on a montré trois ans plus tard qu'il était faux.
Si vous implémentez Adam vous-même, ou si vous reprenez le code d'entraînement de quelqu'un d'autre, vérifiez d'abord que les deux lignes de correction du biais sont toujours là, puis si est ajouté avant ou après la correction du biais, et quelle est sa valeur. Moins l'entraînement compte de pas, plus ces deux détails pèsent sur le résultat ; et quand vous transportez des hyperparamètres d'un framework à l'autre, rappelez-vous que les deux epsilon ne sont peut-être pas la même grandeur.
En 2025, l'article a reçu le prix Test of Time d'ICLR, sept ans après qu'on a montré que sa preuve de convergence posait problème. Quant à l'ordre des auteurs, c'est toujours celui qu'a décidé la pièce.