Article original
On the Convergence of Adam and Beyond
- Publication
- ICLR 2018Conférence
- Premier dépôt sur arXiv
- arXiv:1904.09237
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizersamsgrad2019,
  title = {{On the Convergence of Adam and Beyond}},
  author = {Sashank J. Reddi and Satyen Kale and Sanjiv Kumar},
  year = {2019},
  eprint = {1904.09237},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1904.09237}
}
Commençons par un petit jeu.
Le paramètre doit rester entre et . Le jeu se joue en manches de trois pas ; au premier pas, la perte vaut , au deuxième et au troisième, elle vaut . Sur une manche, cela fait ; plus est petit, mieux c'est, et la réponse est .
Les gradients se calculent facilement, au premier pas et aux deux suivants. À chaque manche, SGD fait un pas net vers le négatif, et finit à .
Adam, lui, s'arrête en , le pire point de tout l'intervalle.
Cet exemple vient de Sashank Reddi, Satyen Kale et Sanjiv Kumar, chez Google. Ils s'en servent pour démontrer que le théorème de convergence de l'article original d'Adam est faux, puis, à partir de l'endroit où il se trompe, dérivent une version corrigée qui ne change qu'une ligne, AMSGrad.
Définir le problème
La convergence revendiquée par Adam
L'article d'Adam analyse la convergence dans le cadre de l'optimisation convexe en ligne. À chaque pas, l'algorithme choisit d'abord un paramètre , et ne découvre qu'ensuite la fonction de perte convexe de ce pas. Le critère est le regret, c'est-à-dire l'excès de perte cumulée par rapport au « meilleur paramètre fixe, choisi a posteriori » :
Si le regret moyen tend vers 0, l'algorithme rattrape en moyenne la meilleure solution fixe. Le Theorem 4.1 de l'article d'Adam affirme que, sous des conditions comme des gradients bornés, et un taux d'apprentissage , le regret d'Adam est en , et que le regret moyen tend vers 0.
Le jeu du début est justement un problème d'optimisation convexe en ligne. Chaque est une fonction linéaire, et le domaine admissible est . Adam s'arrête en ; à chaque manche, il subit une perte supérieure d'une quantité fixe à celle de , et son regret moyen ne tend jamais vers 0.
Le taux d'apprentissage effectif peut-il augmenter ?
Reddi et al. pointent une grandeur précise. Si l'on écrit les différentes méthodes adaptatives dans un même cadre, chaque mise à jour prend la forme , et est le taux d'apprentissage effectif de chaque paramètre. Regardons comment son inverse évolue dans le temps :
Pour SGD, est fixe et décroît ; pour AdaGrad, est la moyenne des carrés des gradients passés et, avec , le dénominateur contient en réalité la somme des carrés des gradients, qui ne fait que croître. Dans les deux cas, n'est jamais négatif, et le taux d'apprentissage ne peut que diminuer.
Adam et RMSProp utilisent une moyenne mobile exponentielle. Dès que les gradients récents diminuent, diminue avec eux, le taux d'apprentissage augmente au contraire, et peut être négatif.
L'article commence par décrire ce qu'on observe en pratique. Dans les problèmes à très grand espace de sortie, certains mini-lots apportent des gradients grands et très informatifs, mais rares ; la moyenne mobile exponentielle fait disparaître très vite leur influence, et la convergence est mauvaise. L'article veut transformer cette intuition en un contre-exemple démontrable.
Résoudre le problème
Un contre-exemple : un grand gradient tous les trois pas
Le Theorem 1 de l'article est la version générale du jeu du début. Les fonctions de perte sont, dans l'ordre,
Le gradient total sur une manche vaut , et la solution optimale est . Adam est réglé avec , , , et ; ces paramètres satisfont la condition qu'exige l'article d'Adam. L'annexe de l'article démontre par récurrence qu'en partant de , revient à à la fin de chaque manche.
Pourquoi ? Prenons , ce qui donne , et calculons directement une manche. Après quelques manches, entre dans un cycle fixe ; le tableau ci-dessous montre une manche de ce cycle. Les deux dernières colonnes donnent ; une valeur positive pousse vers , une valeur négative vers . La mise à jour réelle doit encore être multipliée par , mais les des trois pas d'une même manche sont presque égaux, et nous les ignorons ici :
| Pas | Adam | AMSGrad | ||
|---|---|---|---|---|
| 1 | 8.21 | |||
| 2 | 1.72 | |||
| 3 | 1.07 | |||
| Manche |
Calcul fait pour cette note, avec , et , réglages du Theorem 1. Le dénominateur d'AMSGrad utilise le plus grand observé, soit 8.21.
Regardons d'abord la colonne Adam. Au premier pas, le gradient vaut , mais il gonfle en même temps jusqu'à 8.21 ; , et le grand gradient se trouve réduit d'un facteur proche de 3. Quand l'article dit que le grand gradient est réduit « d'un facteur presque », c'est de cela qu'il parle. Aux deux pas suivants, le gradient ne vaut que ; , qui ne garde qu'un dixième de sa valeur à chaque pas, retombe à 1.72 puis à 1.07, le taux d'apprentissage est multiplié par presque trois en deux pas, et les deux petits gradients poussent ensemble de . Sur une manche, l'effet net est un déplacement de dans la mauvaise direction.
Voilà à quoi ressemble concrètement . Deux pas plus tard, la leçon du grand gradient est presque oubliée.
Avec ces réglages et , en itérant réellement trois cent mille pas, Adam s'arrête en avec un regret moyen de , exactement la borne inférieure donnée par l'article ; dans les mêmes conditions, AMSGrad arrive à .
L'article ajoute plusieurs points. L'exemple tient aussi avec un pas fixe ; ajouter au dénominateur ne le sauve pas non plus, car le Theorem 6 de l'annexe construit un contre-exemple semblable pour tout . Sur le même problème, SGD et AdaGrad ont tous deux un regret moyen qui tend vers 0.
Avec des réellement utilisés
est trop artificiel ; en pratique, est toujours proche de 1. L'article démontre ensuite deux résultats plus forts.
Le Theorem 2 dit que, dès que (ce que satisfont presque tous les réglages pratiques), il existe un problème convexe en ligne sur lequel le regret moyen d'Adam ne tend pas vers 0. La construction est la même, mais la période passe de 3 à ; un gradient apparaît une fois tous les pas, et tous les autres valent . doit être assez grand, assez pour que la mémoire de ne tienne pas sur toute une période.
Assez grand, c'est-à-dire ? L'annexe énumère trois conditions, dont . En faisant le calcul, il faut d'au moins 3 218 pour (l'annexe B exige en outre que soit pair ; avec cette seule inégalité, ce serait 3 217), et d'au moins 42 622 pour . Autrement dit, un gradient plus de quarante mille fois plus grand que d'habitude, qui ne revient qu'au bout de plus de quarante mille pas.
Le Theorem 3 transpose le scénario en optimisation stochastique. À chaque pas, on tire indépendamment ; avec une probabilité , on voit , sinon . La perte espérée vaut , et la solution optimale reste ; mais quand est assez grand, l'espérance du déplacement d'Adam à chaque pas est positive, et le paramètre dérive en s'éloignant de l'optimum.
Les auteurs en concluent que, pour éviter ce comportement, , et doivent tous dépendre du problème ; les problèmes de grande dimension exigeraient même un jeu différent pour chaque dimension, ce qui contredit l'idée même des méthodes adaptatives, censées dispenser de régler les hyperparamètres. Ils reconnaissent aussi que leurs exemples sont construits sur mesure, mais estiment que des phénomènes semblables, dans des situations réelles, ralentissent au moins la convergence.
Où la preuve se trompe
Avec un contre-exemple en main, on sait qu'une étape de la preuve originale d'Adam est forcément fausse. L'article montre, à la section 4 et dans l'annexe D, que la preuve d'Adam suppose semi-défini positif, autrement dit que le taux d'apprentissage n'augmente jamais ; cette hypothèse ne tient pas pour Adam. Les lemmes 10.3 et 10.4 de la preuve d'Adam posent en outre problème.
Les taux d'apprentissage de SGD et d'AdaGrad sont par nature non croissants, et ces méthodes échappent donc à ce problème. Cette observation indique directement la marche à suivre pour corriger.
AMSGrad
Puisque le problème vient de ce que peut diminuer, il suffit que le dénominateur se souvienne du maximum historique :
La seule différence avec Adam est la troisième ligne. est toujours mis à jour par moyenne mobile exponentielle, et son estimation de l'échelle du gradient ne regarde donc que la période récente ; mais le réellement utilisé comme dénominateur ne fait que croître, si bien que le taux d'apprentissage est non croissant, et que est garanti semi-défini positif. Le coût supplémentaire se limite à un vecteur de la taille des paramètres.
Revenons à la colonne AMSGrad du tableau. Le dénominateur reste à 8.21, les deux ne poussent chacun que de , et l'effet net d'une manche devient un déplacement de dans la bonne direction.
Les auteurs comparent AMSGrad à Adam et à AdaGrad dans une situation donnée. Supposons qu'à un pas, , c'est-à-dire que le gradient de ce pas est plus petit que la moyenne récente :
- Adam augmente activement le taux d'apprentissage ; c'est précisément ce qui le fait échouer sur le contre-exemple ci-dessus ;
- AdaGrad le diminue légèrement ; à la longue, le taux d'apprentissage peut devenir si petit que les paramètres ne bougent presque plus ;
- AMSGrad ne l'augmente ni ne le diminue.
La garantie de convergence d'AMSGrad (Theorem 4) reprend le cadre d'analyse de l'article d'Adam, en corrigeant le problème ci-dessus. Les conditions sont , , , un domaine admissible de diamètre borné et des gradients bornés ; la borne supérieure du regret gagne un facteur . L'article indique que choisir , ou la décroissance plus douce , garantit un regret en .
Deux détails méritent attention. La preuve exige que décroisse dans le temps, mais les auteurs précisent aussi qu'en pratique, on fixe généralement . Par ailleurs, l'Adam de l'article n'a pas de correction du biais ; une note de bas de page explique que c'est pour simplifier, et que l'argument du contre-exemple vaut aussi pour la version corrigée. L'Algorithm 2 d'AMSGrad n'a pas non plus de correction du biais.
L'article propose aussi une autre voie, AdamNC, qui garde la même structure mais fait croître dans le temps. Avec , est exactement la moyenne de tous les carrés des gradients passés, ce qui revient à un AdaGrad avec momentum.
Discussion
Expériences synthétiques
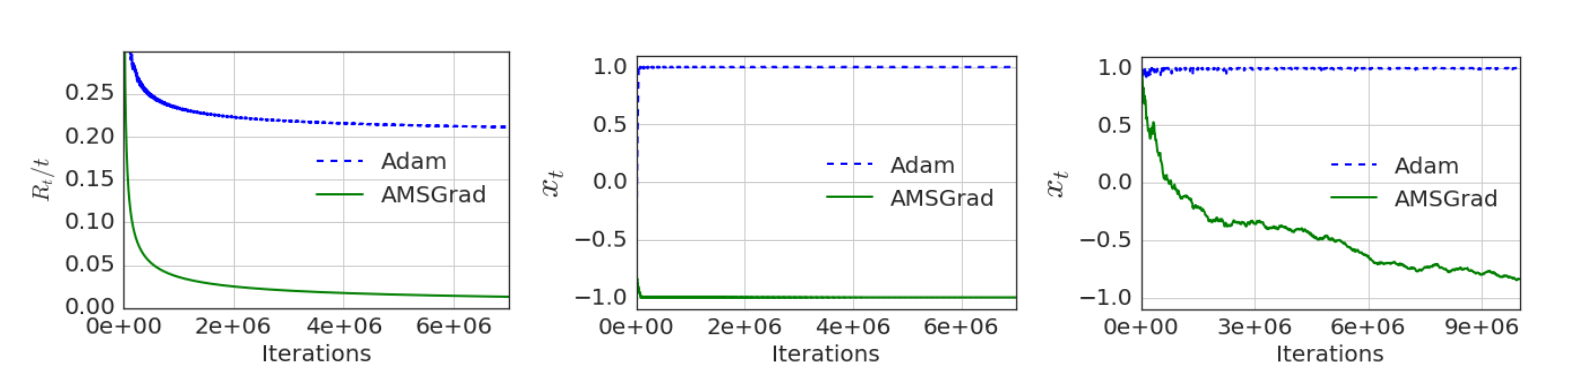
L'expérience utilise une version agrandie du contre-exemple. Une perte apparaît une fois tous les 101 pas, et la perte vaut aux 100 autres ; le gradient total sur une période vaut , et la solution optimale reste . Cette fois, on utilise les réglages ordinaires et , identiques pour les deux méthodes.
À gauche, le regret moyen. Les tirets bleus d'Adam se stabilisent vers 0.21 et ne baissent plus ; la courbe verte d'AMSGrad descend presque jusqu'à 0. Au centre, le paramètre lui-même ; Adam s'arrête en , AMSGrad en .
À droite, la version stochastique, où l'on voit à chaque pas avec une probabilité de 1 %, et sinon. Adam s'arrête encore en . AMSGrad descend très lentement ; à dix millions de pas, il est vers , sans avoir encore atteint .
Données réelles
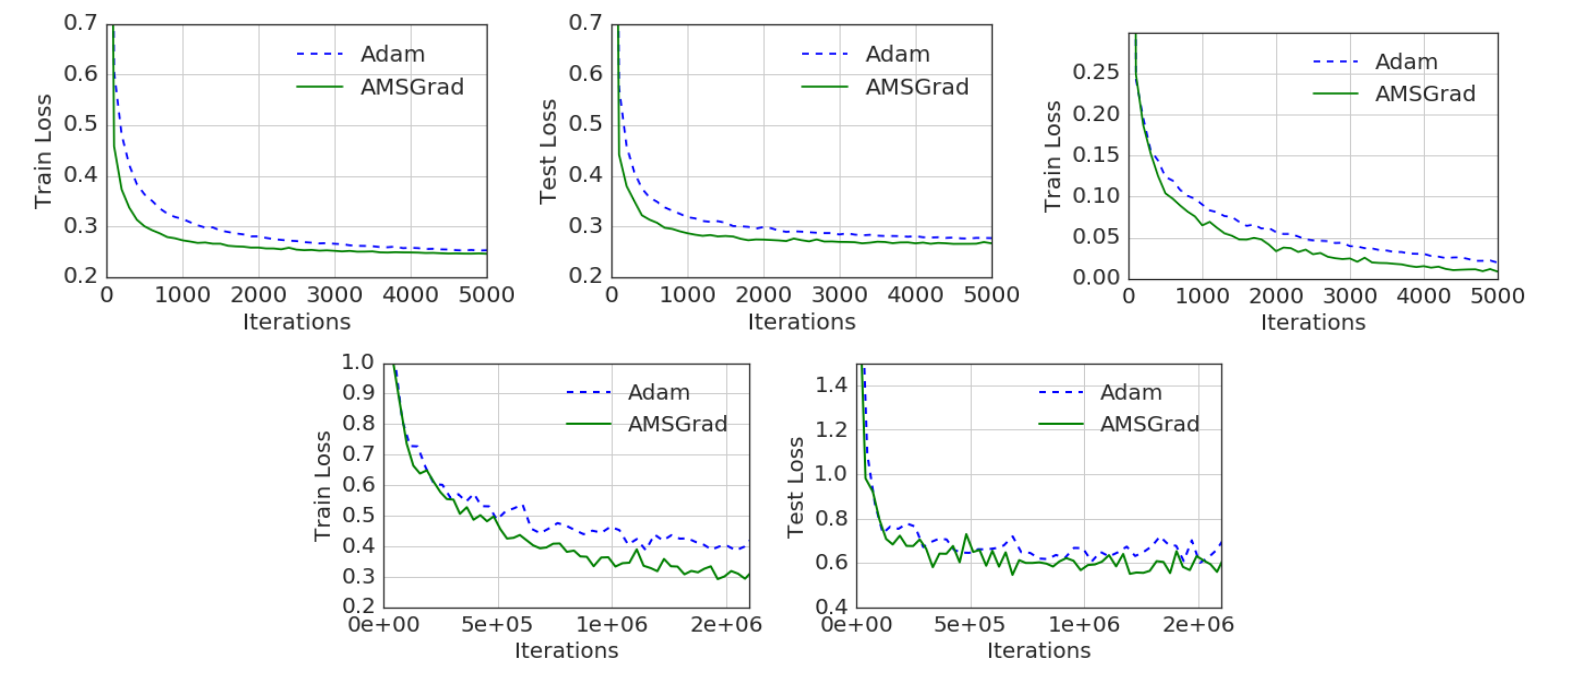
Les expériences sur données réelles forment trois séries, toutes avec une taille de lot de 128, , et choisi dans :
- Régression logistique sur MNIST (en haut à gauche et au centre). Problème convexe ; comme le veut la théorie, le taux d'apprentissage décroît en , et et sont cherchés sur une grille. Les pertes d'entraînement et de test d'AMSGrad sont légèrement plus basses, et les auteurs notent qu'il est moins sensible aux variations des paramètres.
- Réseau à une couche cachée sur MNIST (en haut à droite). 100 ReLU, taux d'apprentissage fixe. La perte d'entraînement d'AMSGrad reste tout du long un peu en dessous de celle d'Adam.
- CIFARNET sur CIFAR-10 (en bas). Deux couches de convolution à 64 canaux, suivies de couches entièrement connectées de 384 et 192, avec, entre les couches, du max-pooling, une normalisation locale des réponses et du dropout. C'est sur la perte d'entraînement que l'écart est le plus net, environ 0.3 contre 0.4 ; les deux pertes de test sont autour de 0.6, AMSGrad légèrement plus bas.
Pour lire ces résultats, il faut connaître leur portée. Les figures ne montrent que des pertes, pas de précision (le texte affirme que la précision d'AMSGrad est aussi meilleure, sans donner de chiffre) ; chaque courbe semble provenir d'une seule exécution, sans marge d'erreur ; et les modèles sont tous petits. Dans leur liste de contributions, les auteurs qualifient eux-mêmes ces expériences de préliminaires.
La réception en pratique
AMSGrad a vite été intégré aux grands frameworks ; l'Adam de PyTorch comme celui de Keras a un paramètre amsgrad, désactivé par défaut.
Ceux qui l'ont essayé n'en sont pas revenus enthousiastes. Dans un article de juillet 2018, Sylvain Gugger et Jeremy Howard, de fast.ai, comparent sur un Wide ResNet pour CIFAR-10, l'affinage d'un ResNet-50 sur Stanford Cars, et des modèles de langage AWD-LSTM et QRNN sur WikiText-2 ; ils écrivent qu'amsgrad n'a jamais apporté le moindre gain, ni en précision ni sur aucune autre métrique, et le jugent « very disappointing ».
La preuve d'AMSGrad elle-même a ensuite été prise en défaut. En 2019, Phuong et Phong montrent que cette preuve traite et comme s'ils étaient égaux, une négligence que l'on retrouve dans la preuve originale d'Adam ; ils donnent une nouvelle preuve et proposent une autre variante, AdamX.
Adam converge-t-il, finalement ?
Le contre-exemple tient, et Adam fonctionne pourtant bien en pratique ; comment concilier les deux ? Les réponses des travaux qui ont suivi diffèrent selon ce qu'ils fixent en premier :
| Travail | Ce qui est fixé d'abord | Conclusion |
|---|---|---|
| Reddi et al. 2018 | d'abord, puis le problème | Adam peut ne pas converger |
| Zhang et al. 2022 | Le problème d'abord, puis | Convergence si est assez grand |
| ADOPT 2024 | On modifie l'algorithme | Convergence pour tout |
Zhang et al. 2022 mettent le doigt sur la question de l'ordre. Reddi et al. choisissent d'abord , puis construisent un mauvais problème pour ce choix ; on l'a calculé plus haut, exige une période de plus de quarante mille pas. En pratique, au contraire, le problème est là d'abord, et c'est ensuite qu'on règle les hyperparamètres. Ils démontrent que, pour un problème fixé, dès que est assez grand (le seuil dépend du problème) et que , Adam, sans aucune modification de sa règle de mise à jour, converge vers un voisinage des points critiques, dont la taille est proportionnelle à la variance du gradient stochastique ; sous des conditions plus fortes, il converge vers les points critiques eux-mêmes. Cette analyse porte sur des problèmes non convexes à somme finie, avec un mélange aléatoire de l'ordre des exemples à chaque époque ; elle ne suppose pas de gradients bornés et couvre le par défaut. À l'inverse, quand est trop petit, il existe une large région de couples qui divergent.
À la même période, Défossez et al. donnent une preuve de convergence courte dans le cas lisse non convexe à gradients bornés, et notent qu'Adam avec ses paramètres par défaut, strictement parlant, ne converge pas, et se comporte plutôt comme un SGD à pas fixe.
ADOPT 2024 revient sur AMSGrad. Il souligne que les preuves de convergence d'AMSGrad sur les problèmes non convexes supposent toutes des gradients stochastiques uniformément bornés ; les modèles qui injectent un bruit gaussien dans le gradient, comme les autoencodeurs variationnels ou les modèles de diffusion, ne satisfont pas cette condition. Le problème vient de l'étape du maximum, dont l'espérance est difficile à contrôler. ADOPT procède autrement ; il normalise le gradient courant avec le du pas précédent, pour que le dénominateur ne contienne pas le gradient courant, et normalise d'abord avant d'accumuler le momentum. Si le moment d'ordre deux du gradient est fini, il atteint un taux de convergence en pour tout .
Reste une note de bas de page. Une prépublication de juillet 2026, « On the Convergence of Adam, Revisited », affirme que, dans le même cadre en ligne que Reddi et al., la condition n'est même pas nécessaire, et que pour tous on trouve des exemples où le regret moyen d'Adam ne tend pas vers zéro, toujours avec le cycle de trois pas de pentes ; le résultat s'étend en outre à des variantes comme AdamW et Muon. Cela n'entre pas en conflit avec le résultat positif de Zhang et al. ; les deux répondent à des questions posées dans un ordre différent.
Conclusion
Avec une fonction linéaire jouée en manches de trois pas, cet article démontre que le théorème de convergence original d'Adam est faux, et attribue le problème au fait que la moyenne mobile exponentielle permet au taux d'apprentissage d'augmenter. AMSGrad prend le maximum historique comme dénominateur, rend le taux d'apprentissage non croissant, et rétablit la garantie de convergence sur les problèmes convexes. L'amélioration sur données réelles est faible, les expériences restent préliminaires, et les tests indépendants qui ont suivi n'ont le plus souvent constaté aucun gain ; ce que l'article laisse aux recherches suivantes, c'est l'angle d'analyse de , et la question de savoir « quel côté on fixe d'abord ».
En pratique, amsgrad=True n'est qu'un interrupteur ; si vous soupçonnez que vos données contiennent de grands gradients rares mais importants, vous pouvez l'inclure dans la comparaison, aux côtés d'un plus grand. Le premier n'ajoute qu'un état de la taille des paramètres, le second ne coûte rien. Zhang et al. démontrent qu'un trop petit ouvre une large région de divergence ; d'après ce résultat, si vous l'avez abaissé pour que l'optimiseur réagisse plus vite et que l'entraînement devient instable, commencez par le ramener près de 1.
Le petit jeu des manches de trois pas, lui, n'a jamais pris sa retraite. Huit ans plus tard, ce sont toujours les mêmes ; cette fois, il n'a même plus besoin de supposer , et il entraîne au passage AdamW et Muon avec lui.