原始論文
Adam: A Method for Stochastic Optimization
- 發表版本
- ICLR 2015會議
- arXiv 首次提交
- arXiv:1412.6980
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizersadam2014,
  title = {{Adam: A Method for Stochastic Optimization}},
  author = {Diederik P. Kingma and Jimmy Ba},
  year = {2014},
  eprint = {1412.6980},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1412.6980}
}
這篇論文第一頁的腳註寫著,兩位作者貢獻相同,作者順序是在 Google Hangout 上丟硬幣決定的。
丟完硬幣之後,Diederik Kingma 排在前面,Jimmy Ba 排在後面,論文在 2014 年 12 月放上 arXiv。Algorithm 1 的說明文字裡有一句「Good default settings for the tested machine learning problems」,後面跟著四個數字,、、、。
十年後打開 PyTorch,torch.optim.Adam 的預設值還是這四個數字。
這篇筆記要把 Algorithm 1 的每一行拆開來看。兩個移動平均各在估計什麼?為什麼要除以 ?一步到底走多遠?論文的實驗證明了哪些事,又有哪一段後來被推翻?
定義問題
訓練神經網路時,我們手上只有小批次算出來的梯度,每一步都帶著雜訊;dropout 之類的正則化又額外加了一層隨機性。參數動輒上百萬,二階方法太貴,論文一開始就把範圍限定在一階方法。
最基本的 SGD 對所有參數用同一個學習率。問題是不同參數的梯度大小可以差好幾個數量級,同一個學習率,對某些參數太大,對另一些太小。
當時已經有兩條路在處理這件事。
- AdaGrad 替每個參數記下歷史梯度平方的總和,用它的平方根去除梯度,。很少出現的特徵,梯度平方和小,步伐就大,在稀疏資料上特別有效。代價是總和只增不減,學習率會一路變小。
- RMSProp 把總和換成指數移動平均,只看最近一段時間的梯度。學習率不會一路變小,也比較能應付目標函數隨時間改變的情況。
Adam 想要兩邊的好處。論文第 5 節還指出,RMSProp 沒有偏差修正。當 接近 1(稀疏梯度正需要這種設定),沒有修正的 RMSProp 一開始的步伐會非常大,常常直接發散。
所以這篇要回答的是,能不能做出一個只用一階梯度、記憶體只多兩份參數大小的優化器,同時處理稀疏梯度與會變動的目標,而且在訓練一開始就走得穩。
解決問題
Algorithm 1
先把整個演算法寫出來。所有運算都是逐元素的, 指 , 是 的 次方:
一開始 、,每一輪先把 加一。
是梯度的指數移動平均,論文稱為一階動差的估計,也就是梯度的平均值; 是梯度平方的指數移動平均,二階動差(未扣平均值的變異數)的估計。Adam 這個名字取自 adaptive moment estimation(致謝裡說,是 Ivo Danihelka 和 Tom Schaul 想出來的)。
更新量是 。分子決定方向,而且因為是移動平均,帶有動量的效果;分母替每個參數換算一個自己的尺度。這等於每個參數有自己的學習率 ,只是這個學習率每一步都會根據最近的梯度重新估計。
論文還給了一個比較省計算的寫法,把兩次修正合併成一個係數:
兩種寫法只差在 加的位置,這裡的 和 Algorithm 1 的 是不同的量。這個小差異後來留在各家框架裡,討論時再回來看。
偏差修正
中間那兩行除法,是這篇論文和 RMSProp 最大的差別,也是第 3 節專門推導的東西。
把 的遞迴展開,它是過去所有梯度平方的加權和:
兩邊取期望值。假設梯度平方的期望值不隨時間改變,就可以把 提出來,剩下的是一個等比級數:
如果二階動差真的不隨時間改變,;就算會變,只要 讓太久以前的梯度權重夠小, 也不會太大。剩下的 完全是從 起跑造成的,除掉它,估計就回到正確的尺度。 的推導一模一樣。
用預設值算一下第一步。 時:
- ,只有真實值的十分之一;
- ,開根號後是 ,只有真實尺度的三十分之一左右。
兩個都偏小,但 偏得更多。如果不修正,第一步的大小是 。修正之後,、,每個參數的第一步剛好是 。
這是 Adam 的第一步。不管梯度是 還是 ,每個參數都只走 。
那不修正的話,偏大的步伐會持續多久?假設每一步的梯度都一樣,沒有修正時的步長就是 。我們把它畫出來。
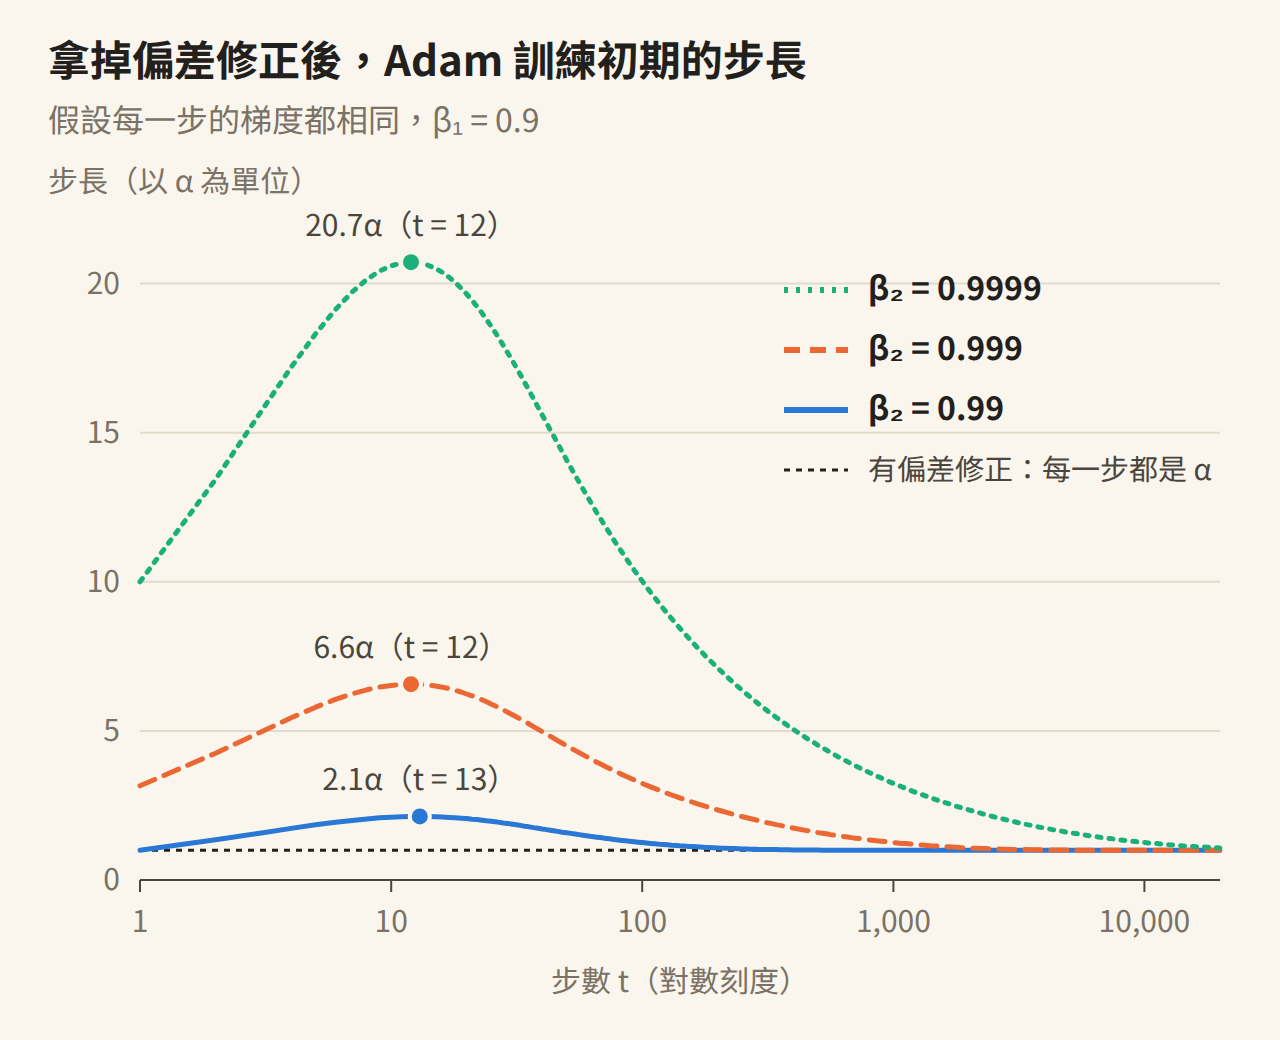
三條線都在第 12、13 步左右到最高點。這時 已經累積到真實值的七成左右; 在 時卻只累積了約 1%,開根號後也只有一成多。分子追上來了,分母還沒。 時最高是 ,要到一千七百多步才回到 以內; 時最高是 ,要一萬七千多步。
如果再把動量拿掉(),沒有修正的第一步就是 , 時是 。學習率明明設成 ,第一步卻等於用了 。
這正是論文說的情況。稀疏梯度需要很大的 才能平均到足夠多的樣本,而 越接近 1,沒有修正的初始偏差就越嚴重。
一步走多遠
第 2.1 節接著分析更新量本身。先令 ,每一步的有效步長是 。
是「梯度平均」除以「梯度平方平均的平方根」。因為 ,這個比值的絕對值通常不超過 1,所以 大約被 限制住。
有一個例外。如果某個參數的梯度一直是 0,只有這一步突然有值, 大約是 , 大約是 ,比值變成 。論文給的上界因此分兩種情況:
用預設值代進去, 大於 ,所以預設設定落在第一種情況,最壞是 。這只會發生在極端稀疏的參數上;論文說,稀疏程度沒那麼極端時,有效步長會比這個小。
這個性質帶來三個實用的結果。
- 就是步伐的大小。 它大致就是每一步在參數空間裡走的距離,論文把它比喻成在目前參數周圍畫一個信任區域。如果我們大概知道好的解離初始值多遠,就能估出 的數量級。
- 和梯度的尺度無關。 把梯度乘上 , 變成 倍, 變成 倍,比值不變。把損失函數乘上 1000,SGD 的步伐跟著放大 1000 倍,Adam 完全不受影響。
- 自動退火。 論文借用「訊噪比」這個詞來稱呼 。靠近最佳解時,梯度方向常常來回變號,平均值接近 0,平方的平均卻還在,比值變小,步伐也跟著變小。
和 AdaGrad、RMSProp 的關係
第 5 節把 Adam 放回原來的家族裡比較。
和 RMSProp 比,有兩個差別。帶動量的 RMSProp 是先把梯度除以尺度,再對除完的結果做動量;Adam 是分別估計梯度的一階與二階動差,再相除。另一個差別就是偏差修正。
和 AdaGrad 比,關係更有意思。令 、讓 趨近 0,並把學習率換成 ,有偏差修正的 會變成 ,代回更新式剛好就是 AdaGrad。這個對應只有在保留偏差修正時才成立;拿掉修正, 趨近 1 會讓 趨近 0,更新量變成無限大。
論文也提到, 可以看成 Fisher 資訊矩陣對角線的近似,Adam 等於用它的平方根倒數做預條件(preconditioning)。比起自然梯度直接用 Fisher 的倒數,這個做法保守一些。
AdaMax
第 7.1 節是一個延伸。Adam 用梯度的 範數縮放,作者把它推廣到 :
大的時候數值不穩定,但讓 ,令 ,加權總和裡只剩最大的那一項,得到一個很簡單的遞迴:
是「打過折的歷史最大梯度」。某一步出現 , 就變成 10,之後每步乘上 0.999,一千步後還剩約 3.7。它不需要偏差修正,因為 至少等於當下的 ,不會從 0 慢慢爬上來。步長的上界也更簡單,。論文建議的預設值是 ,、 和 Adam 相同。
另外,第 7.2 節提了參數的指數移動平均 ,同樣用 修正初始偏差。
收斂證明
第 4 節用線上凸最佳化的框架分析 Adam。每一步面對一個事先未知的凸函數 ,衡量標準是遺憾(regret),也就是累積損失和事後最好的固定參數相比多了多少:
Theorem 4.1 的條件很多。梯度有界、迭代點之間的距離有界、,學習率用 遞減, 也要隨時間以 衰減。在這些條件下,論文得到 的遺憾,平均遺憾 趨近 0。
實務上很少照這組條件跑 Adam,學習率常常固定或用其他排程, 也固定在 0.9。論文自己在第 6.2 節也承認,這個分析不適用於神經網路這類非凸問題。
這個定理後來被證明有誤。2018 年 Reddi、Kale 與 Kumar 指出,附錄的證明在某一步把 當成不會是負數來處理。這個量是「有效學習率的倒數」隨時間的變化,Adam 的 是移動平均,會隨著梯度變小而變小,所以它可以是負的。他們同時指出引理 10.3、10.4 也有問題,並造出一個滿足定理條件的一維凸問題,Adam 在上面收斂到最差的那個點。
討論
邏輯斯迴歸、多層感知器與卷積網路三組實驗都用批次大小 128,比較不同優化器時使用相同的初始參數;學習率、動量等超參數在一個密集的網格上搜尋,回報最好的那組。論文只畫損失曲線,前三組明寫是訓練損失,沒有測試準確率。這一點讀圖時要記住,這些實驗比的是「誰把訓練損失降得快」。
邏輯斯迴歸
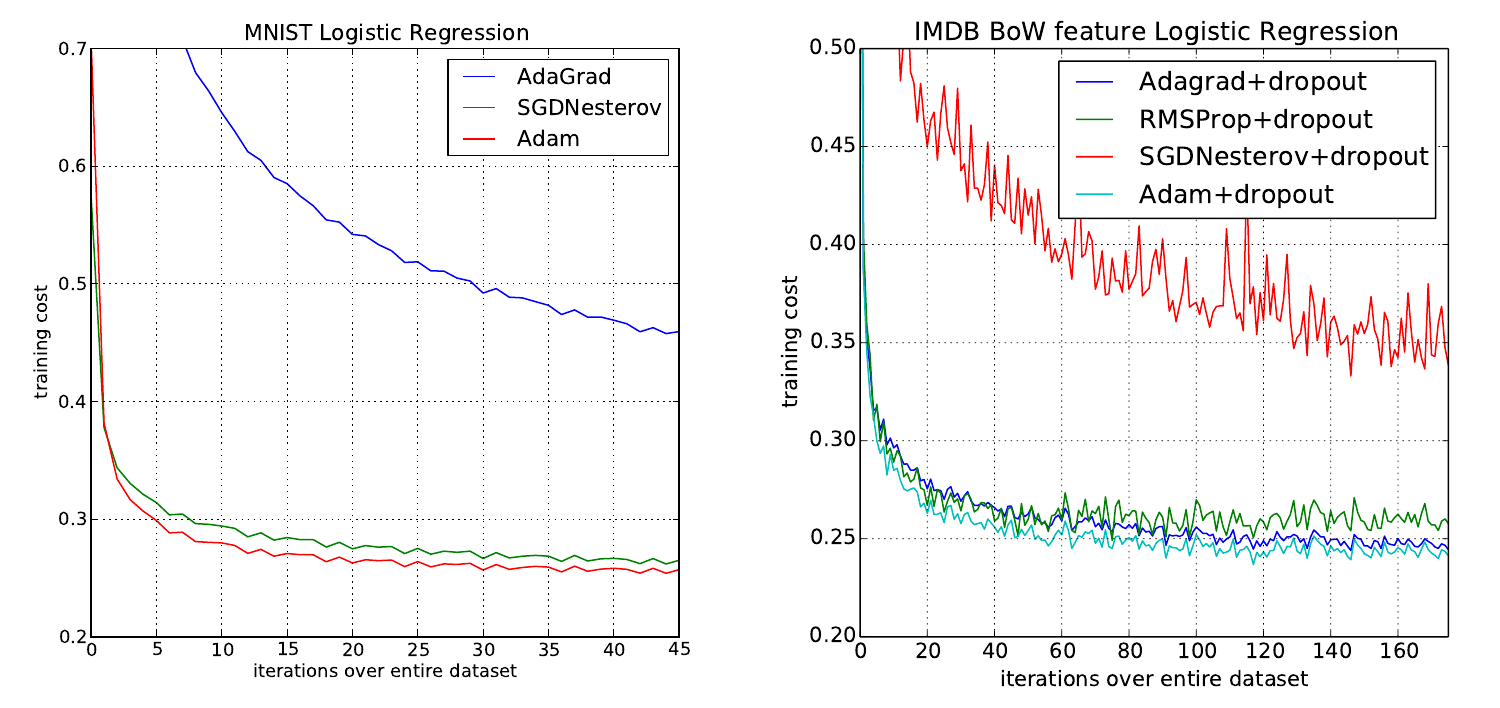
邏輯斯迴歸是凸問題,不必擔心局部極小值,適合單純比較優化器。這組實驗的學習率照第 4 節的理論用 遞減。
左圖是 MNIST,直接拿 784 維的像素向量分類。Adam 和 SGD 動量差不多,兩者都比 AdaGrad 快很多。
右圖才是 Adam 想證明的事。作者把 IMDB 影評轉成前 10,000 個常用字的詞袋向量,每一篇影評只用到其中很少的字,是很稀疏的特徵;為了防止過擬合,特徵上加了 50% 的 dropout。在這裡 AdaGrad 大幅領先 SGD,Adam 和 AdaGrad 一樣快。稀疏特徵上的優勢,Adam 有繼承下來。
多層感知器
接著是兩層、每層 1000 個 ReLU 單元的全連接網路,同樣用 MNIST。加了 dropout 的版本,Adam 的訓練損失低於 AdaGrad、RMSProp、SGD 動量與 AdaDelta。
不加 dropout、改用 L2 權重衰減的版本,作者另外和 SFO 比較。SFO 是一種以小批次運作的擬牛頓法,每一步要更新曲率資訊,速度比 Adam 慢 5 到 10 倍,記憶體還要隨小批次的數量線性增加。Adam 不論以迭代次數或實際時間計算都比它快;而 SFO 假設每個子函數是確定的,遇到 dropout 就不收斂。
卷積網路
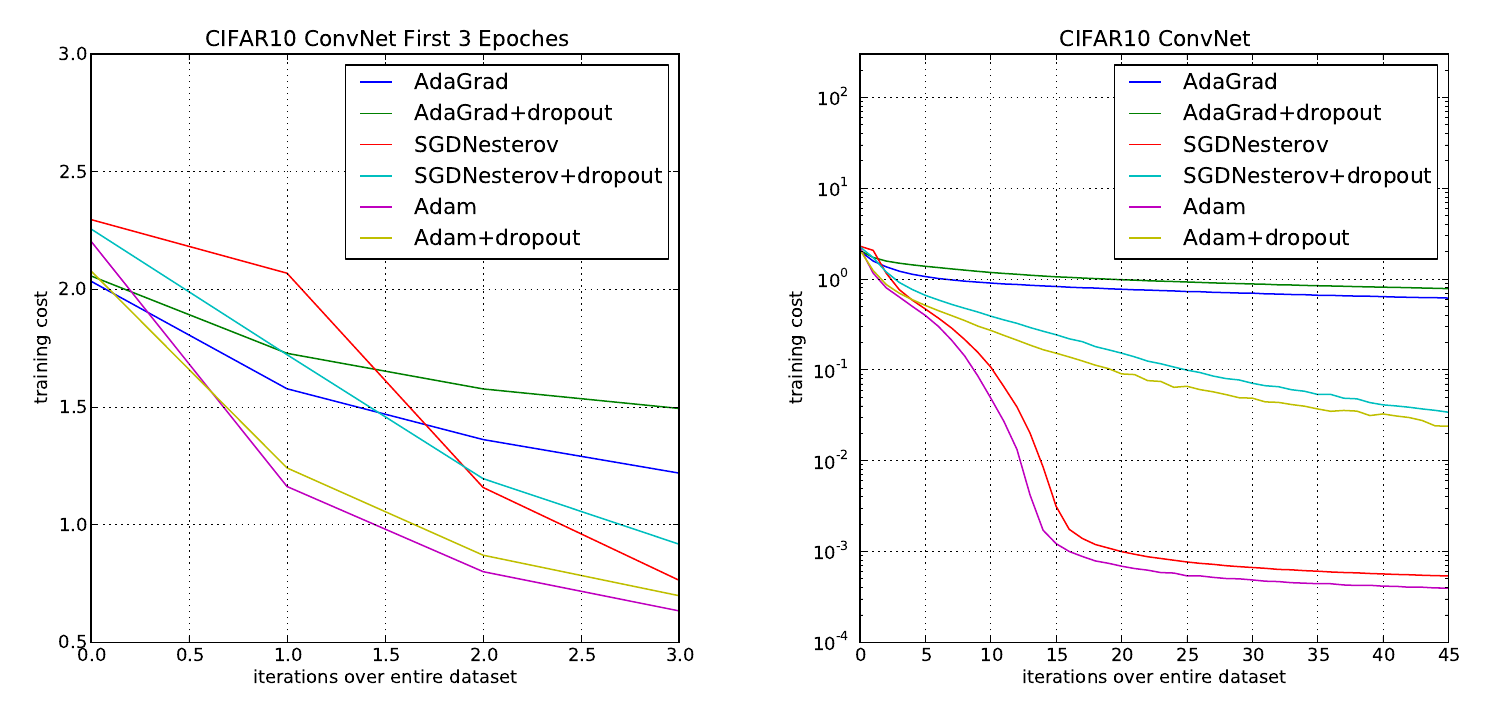
網路是三段 卷積加 、步幅 2 的最大池化,通道數 64、64、128,最後接 1000 個 ReLU 的全連接層;輸入先做白化,輸入層與全連接層加 dropout。
左圖的前 3 個 epoch,Adam 和 AdaGrad 都下降得很快。但右圖拉長到 45 個 epoch,AdaGrad 很早就停住了,Adam 和 SGD 動量一路降到 以下。
作者對這個結果的解釋很具體。他們觀察到,訓練幾個 epoch 之後, 小到幾乎是 0,分母被 主導,二階動差已經無法描述這個問題的幾何形狀;在卷積網路上起作用的主要是一階動差,它把小批次的雜訊平均掉。照這個解釋推下去,分母被 主導時,Adam 的行為更像帶動量的 SGD,這也和兩者曲線很接近的情況相符。作者也很誠實地寫,Adam 相對 SGD 動量只是小幅改善,好處在於它會自動替不同層調整學習率的尺度,不需要手動替卷積層挑一個比較小的學習率。
被寫成「避免除以零的小常數」,但只要 小到和它同一個數量級,它就實際參與了更新。
偏差修正的實驗
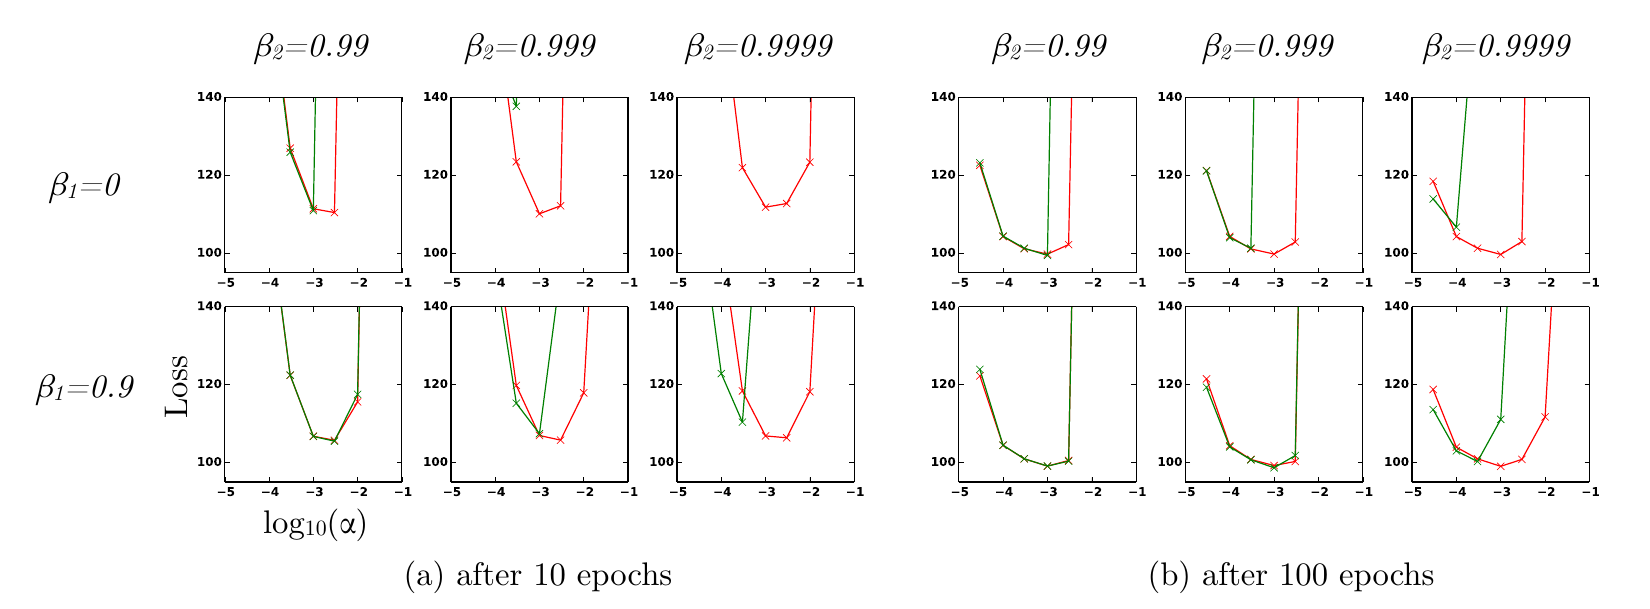
這是整篇論文最直接檢驗設計的一張圖。作者訓練一個變分自編碼器(VAE,單一隱藏層、500 個 softplus 單元、50 維的高斯潛在變數),掃過 、,以及 從 到 。拿掉偏差修正之後的 Adam,論文視為一種帶動量的 RMSProp。
每張小圖的橫軸是學習率,縱軸是損失,紅線是有修正,綠線是沒有。
- 那一欄,紅綠兩條線大致重疊,只有 那一列的綠線在最大的學習率先衝出圖外。這個設定下,沒有修正造成的偏差大約一兩百步就消失,對整個訓練的影響不大。
- 往右看到 ,綠線在比較大的學習率就衝出圖外。最嚴重的是左組第一列 , 和 的綠線幾乎整條都在圖外;這兩格沒有修正時第一步分別是 和 。
- 右組訓練到 100 個 epoch,紅線在六張圖裡的最低點都在 100 附近;在 那一欄,紅線的最低點落在 ,同一個學習率下,綠線在 時已衝出圖外,在 時升到 110 左右,紅線能用的學習率範圍寬得多。
作者的結論是, 接近 1 時,沒有偏差修正會讓訓練不穩定,尤其是最初的幾個 epoch;最好的結果出現在 很小、又有偏差修正的設定。在他們掃過的所有超參數上,Adam 都不比 RMSProp 差。
作者還補了一個觀察。訓練後期隱藏單元各自專門化,梯度變得更稀疏,大 的好處在這時候更明顯。也就是說,接近 1 的 本來就是想要的設定,偏差修正讓我們能放心用它。
加在哪裡
回到前面兩種寫法的差異。Algorithm 1 把 加在修正後的 上,省計算的寫法則把 加在未修正的 上。兩者換算下來,,在訓練初期差最多。
各家框架選了不同的寫法。PyTorch 照 Algorithm 1,預設 eps=1e-8;Keras 的文件寫明它的 epsilon 是論文裡的 ,預設值則是 1e-7。在兩個框架之間搬超參數時,同樣叫 epsilon,其實是兩個量。
這個看似無關緊要的常數,在大模型訓練裡也會被拿出來調。OLMo 2 就把 AdamW 的 從 降到 ,報告說訓練初期的梯度範數因此更低也更穩定。
偏差修正被拿掉的那幾年
第 3 節的推導聽起來像細節,但有一段真實的後續。
BERT 官方程式碼裡的優化器 BERTAdam,把偏差修正那兩行拿掉了;這個寫法跟著被複製進 Hugging Face Transformers(2019 年 7 月才改回標準的 Adam)、AllenNLP 等常用函式庫。2020 年 Zhang 等人的〈Revisiting Few-sample BERT Fine-tuning〉追查 BERT 在小資料集上微調不穩定的原因,發現這正是主因之一。
他們在 RTE、MRPC、STS-B、CoLA 四個小資料集上,各用 50 個隨機種子微調。沒有偏差修正時,很多次微調根本沒訓練起來;以 RTE 為例,48% 的執行準確率低於 55%,接近亂猜。加回偏差修正,結果的變異大幅縮小。
原因和前面那張步長圖是同一件事。這些小資料集的微調通常不到一千步,整個過程都還在偏差最大的那一段。換成訓練步數多的 MNLI,有沒有修正的差距落在誤差範圍內(驗證集準確率,沒有修正 86.0、有修正 85.9)。
後來的三個問題
Adam 很快變成預設的優化器,接下來幾年,針對它的質疑大致分成三條線:
- 收斂。 前面提到的證明錯誤。Reddi 等人用一個每三步出現一次大梯度的例子,說明 會「忘記」罕見的大梯度,提出保留歷史最大值的 AMSGrad。
- 泛化。 2017 年 Wilson 等人在幾個視覺與語言任務上發現,Adam 的訓練損失降得快,測試成績卻常輸給調好的 SGD。
- 正則化。 Loshchilov 與 Hutter 指出,在 Adam 裡把 L2 正則化寫進梯度,和直接做權重衰減並不等價,提出 AdamW。
結論
Adam 用兩個指數移動平均分別估計梯度的平均與平方平均,相除後得到每個參數自己的步長;再用 修正從 0 起跑的偏差,讓第一步就落在 的尺度上。論文最有說服力的證據是 VAE 那組實驗, 越接近 1,偏差修正越重要;其他實驗只比了訓練損失,卷積網路上它和 SGD 動量的差距也很小。收斂定理則在三年後被指出有誤。
如果你要自己實作 Adam,或是沿用別人的訓練程式,先看偏差修正那兩行還在不在,再看 加在偏差修正之前還是之後、值是多少。訓練步數越少,這兩個細節對結果的影響越大;在框架之間搬超參數時,也記得兩邊的 epsilon 可能不是同一個量。
2025 年,這篇論文拿下 ICLR 的時間考驗獎,距離它的收斂證明被指出有問題,已經過了七年。至於作者順序,到現在還是那枚硬幣決定的。