原始論文
Large Batch Training of Convolutional Networks
- 發表版本
- 正式發表資訊尚未核實
- arXiv 首次提交
- arXiv:1708.03888
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizerslars2017,
  title = {{Large Batch Training of Convolutional Networks}},
  author = {Yang You and Igor Gitman and Boris Ginsburg},
  year = {2017},
  eprint = {1708.03888},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1708.03888}
}
2017 年 6 月,Facebook 的 Goyal 等人用 256 張 GPU、batch size 8,192,一小時訓練完 ImageNet 上的 ResNet-50,準確率沒有掉。他們的配方是兩條規則,batch 放大幾倍,學習率就放大幾倍;開頭幾個 epoch 先用小學習率暖身。
兩個月後,兩位 NVIDIA 實習生和 NVIDIA 的 Boris Ginsburg 把同一套配方搬到 AlexNet 上,結果 batch 一過 2K 就訓練不下去。這份只有 8 頁的技術報告,就從這次失敗開始。
定義問題
資料平行訓練的做法是把一個 batch 切給很多張卡,各自算梯度再平均。卡越多,每張卡又得吃滿,global batch 就越大。epoch 數不變的話,batch 放大 倍,更新步數就少 倍;為了補回來,最直接的辦法是把學習率也放大 倍。論文用 說明這個直覺,小 batch 連走兩步,大略等於大 batch 用兩倍學習率走一步,前提是第二步的梯度和第一步差不多。
這個前提在訓練初期最不可靠,Goyal 等人才加了暖身。作者用 BVLC 版的 AlexNet 照做,訓練 100 個 epoch:
| batch | 學習率 | top-1(%) |
|---|---|---|
| 512 | 0.02 | 58.8 |
| 4,096 | 0.05 | 53.1 |
| 8,192 | 0.03 | 44.8 |
整理自原論文 Table 1(a),每個 batch 取準確率最高的學習率,暖身 2.5 個 epoch。
學習率根本放不上去。batch 4K 時學習率超過 0.06,有暖身也照樣發散,只能停在 0.05;8K 則停在 0.03,而照線性縮放,它應該是 batch 512 的 16 倍,0.32。
別人也撞過這面牆。Hoffer 等人改用比較保守的平方根縮放,再配上特製的 Ghost BatchNorm,AlexNet 在 batch 8K 也只有 53.93%,離小 batch 的水準還很遠。Krizhevsky 自己提出線性縮放時,AlexNet 也只推到 1K,掉了約 1 個百分點。
作者先把 AlexNet 的 LRN 層換成 BatchNorm,稱為 AlexNet-BN。這一改,連暖身都不用,batch 8K 能用 0.3 的學習率,準確率 58.0%,和 batch 512 的 60.2% 只差 2.2 個百分點(原本差 14 個)。剩下的 2.2 是不是 Keskar 等人說的泛化落差?作者比較了 batch 256 和 8K 的訓練與測試損失,兩者之間的差距沒有明顯不同,所以判斷問題出在訓練本身沒做好,模型還沒學夠。
那麼學習率為什麼放不大?
每一層的胃口
作者在 AlexNet-BN 跑完第 1 次迭代時,把每一層權重的範數 和梯度的範數 拿出來比:
| 層 | 比值 | ||
|---|---|---|---|
| conv1 | 0.098 | 0.017 | 5.76 |
| conv2 | 0.16 | 0.002 | 83.5 |
| conv3 | 0.196 | 0.0015 | 127 |
| conv4 | 0.196 | 0.0013 | 148 |
| conv5 | 0.16 | 0.0002 | 69 |
| fc6 | 6.4 | 0.005 | 1345 |
| fc7 | 6.4 | 0.013 | 489 |
| fc8 | 0.316 | 0.016 | 19 |
整理自原論文 Table 2,只列權重;偏差項的比值落在 8.48 到 117 之間。
這個比值可以直接讀成一個學習率,也就是讓一步更新的大小剛好等於權重本身的那個值。學習率設成 1,conv1 一步就改掉自己約 17% 的權重(),fc6 只動了 0.07%()。
全網路共用一個學習率,就得遷就最容易被改壞的那一層。conv1 的上限比 fc6 低兩百多倍,學習率稍微放大,conv1 先崩;為了保住 conv1 而壓低學習率,fc6 這種層又幾乎不動。論文也觀察到這個比值在訓練初期最高、幾個 epoch 後快速下降,暖身之所以有效,是因為小學習率對所有層都安全,等權重長大一點,再把學習率拉上去。
作者換了個方向。既然每層的胃口不同,就每層各給一個學習率。
解決問題
一層一把尺
LARS(Layer-wise Adaptive Rate Scaling)把第 層的更新寫成全域學習率 乘上該層自己的 local LR :
叫 trust coefficient,意思是「這一層一步之內,我們願意讓它改動多少」。論文的 AlexNet 實驗都用 ,ResNet-50 沒有另外交代。
把兩式合起來算一下更新的大小:
梯度的大小被消掉了。每一層每一步的更新,都是自己權重範數的 倍;梯度只決定方向。以 AlexNet-BN 在 batch 8K 用的 來說,學習率還沒衰減時,每一步塞進更新的量都是該層權重範數的 1.4%(還沒算動量的累積),conv1 和 fc6 一視同仁。作者也指出,更新大小不再跟著梯度大小走,梯度消失或爆炸的問題可以緩解一部分。
和 Adam、RMSProp 這類自適應方法相比,LARS 有兩點不同。一是粒度,它一層一個學習率,不是每個參數一個,論文認為這樣比較穩。二是參考點,它拿權重本身的大小來控制更新幅度,Adam 拿的是梯度的歷史統計。
加上權重衰減與動量
有權重衰減 時,分母也把它算進去:
完整的訓練流程(原論文 Algorithm 1, 照式 (6) 補上 )每步對每一層做:
全域學習率走二次多項式衰減,動量 。要注意順序,trust ratio 用的是這一步梯度的範數,縮放完才累積進動量。後面 LAMB 論文重新整理 LARS 時,改成對動量取範數,兩者不完全一樣。
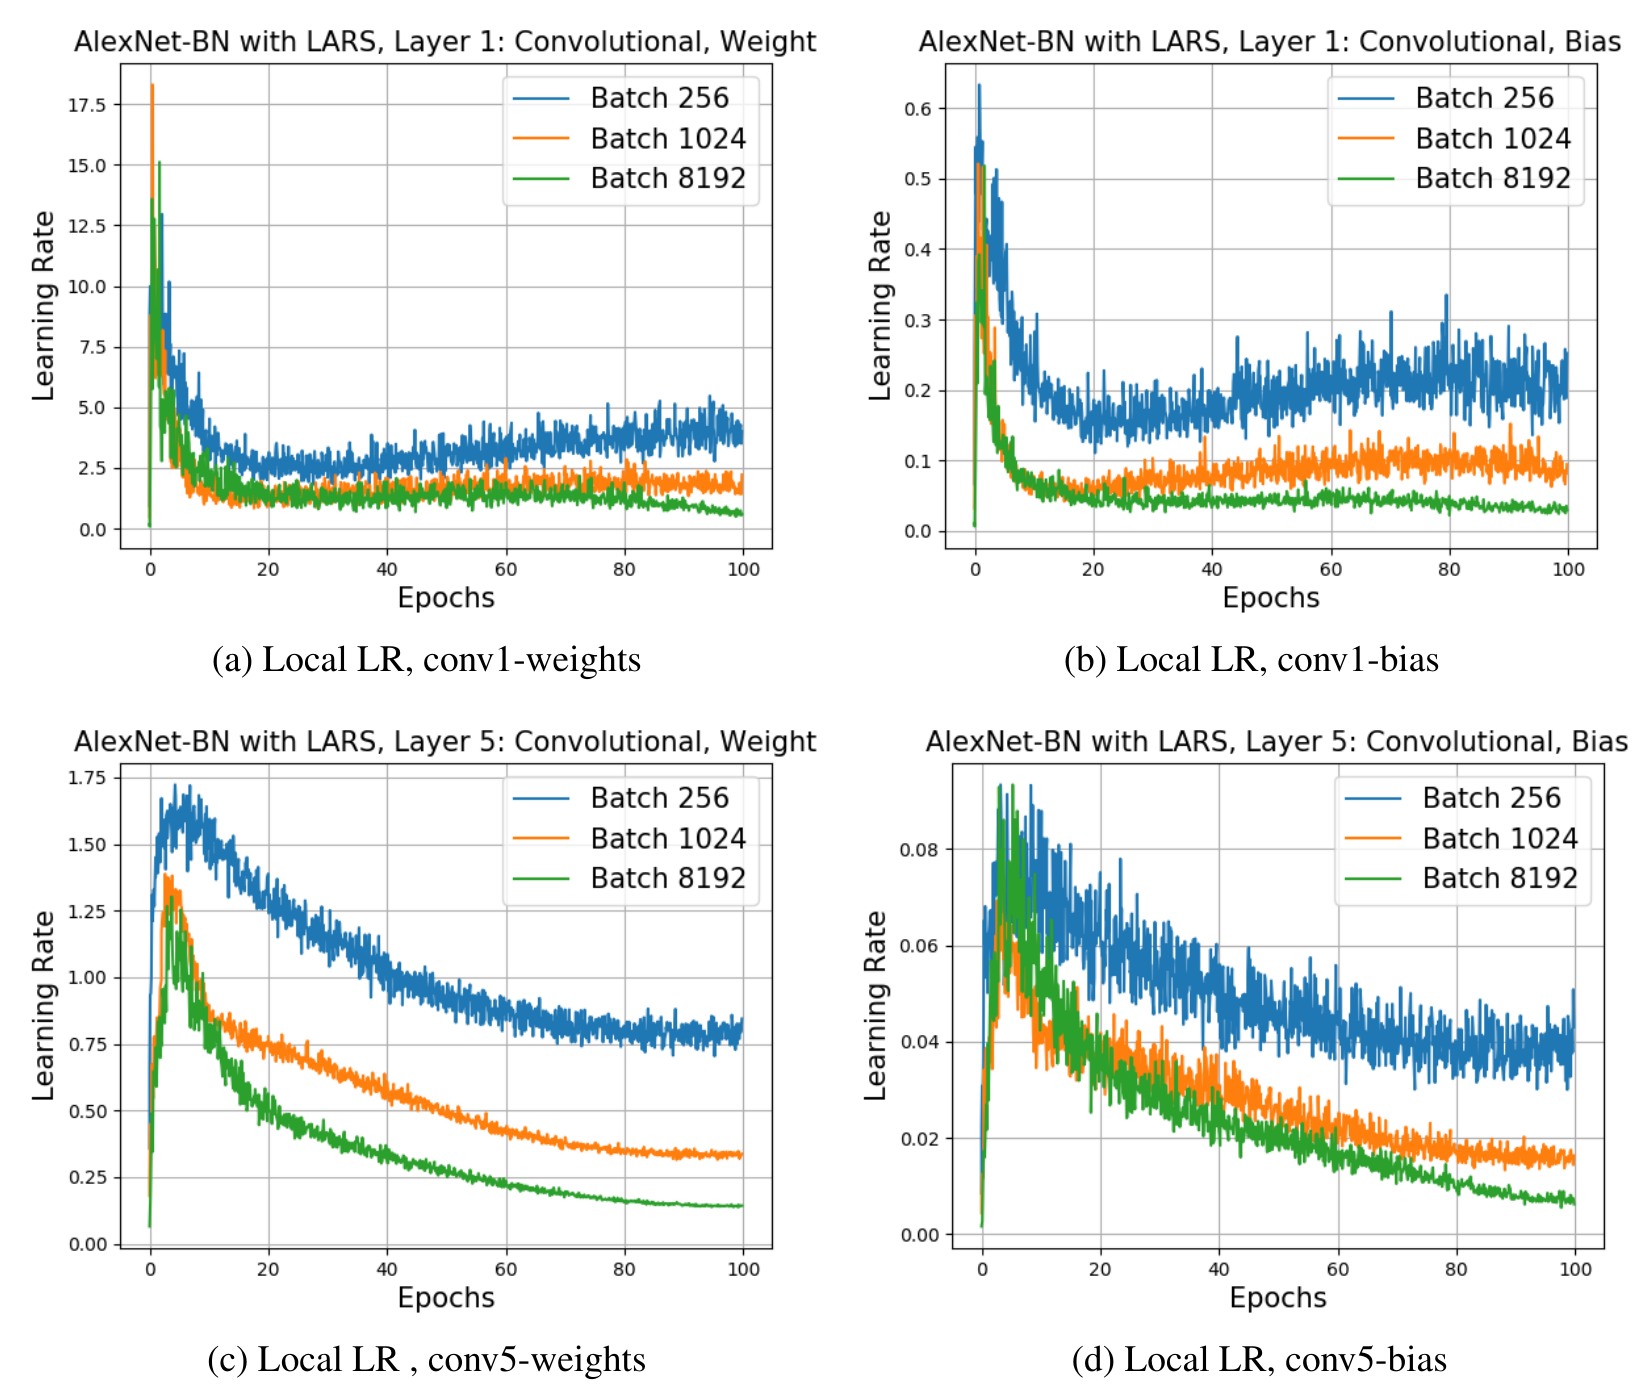
這張圖畫的是 LARS 自動算出來的 local LR。先看縱軸刻度,conv1 權重最高到 17.5,conv5 權重不到 1.75,兩個偏差項更小,最多 0.6 和 0.08。同一個網路裡,各層實際用的學習率差了一到兩個數量級。再看三條線,訓練後期 batch 越大,曲線壓得越低。論文對此只說 local LR「強烈依賴層與 batch size」,沒有進一步解釋。這種隨層、隨 batch、隨訓練進度變化的學習率,很難用手寫的排程做出來。
討論
AlexNet 推到 32K
作者用 LARS 重訓兩個網路,都跑 100 個 epoch,SGD 動量 0.9、權重衰減 0.0005、,在 NVIDIA DGX-1 上完成。batch 16K 和 32K 塞不進去,是把一個 batch 切成幾塊、累積梯度後才更新來模擬的。
| batch | AlexNet 學習率 | AlexNet(%) | AlexNet-BN 學習率 | AlexNet-BN(%) |
|---|---|---|---|---|
| 512 | 2 | 58.7 | 2 | 60.2 |
| 4K | 10 | 58.5 | 10 | 60.4 |
| 8K | 10 | 58.2 | 14 | 60.1 |
| 16K | 14 | 55.0 | 23 | 59.3 |
| 32K | TBD | TBD | 22 | 57.8 |
整理自原論文 Table 3,AlexNet 暖身 2 個 epoch,AlexNet-BN 暖身 5 個 epoch;表中 TBD 為原文所寫。
batch 8K 的 AlexNet,從沒有 LARS 時的 44.8% 拉回 58.2%,和 batch 512 只差 0.5 個百分點。AlexNet-BN 撐得更遠,16K 掉 0.9,32K 掉 2.4。
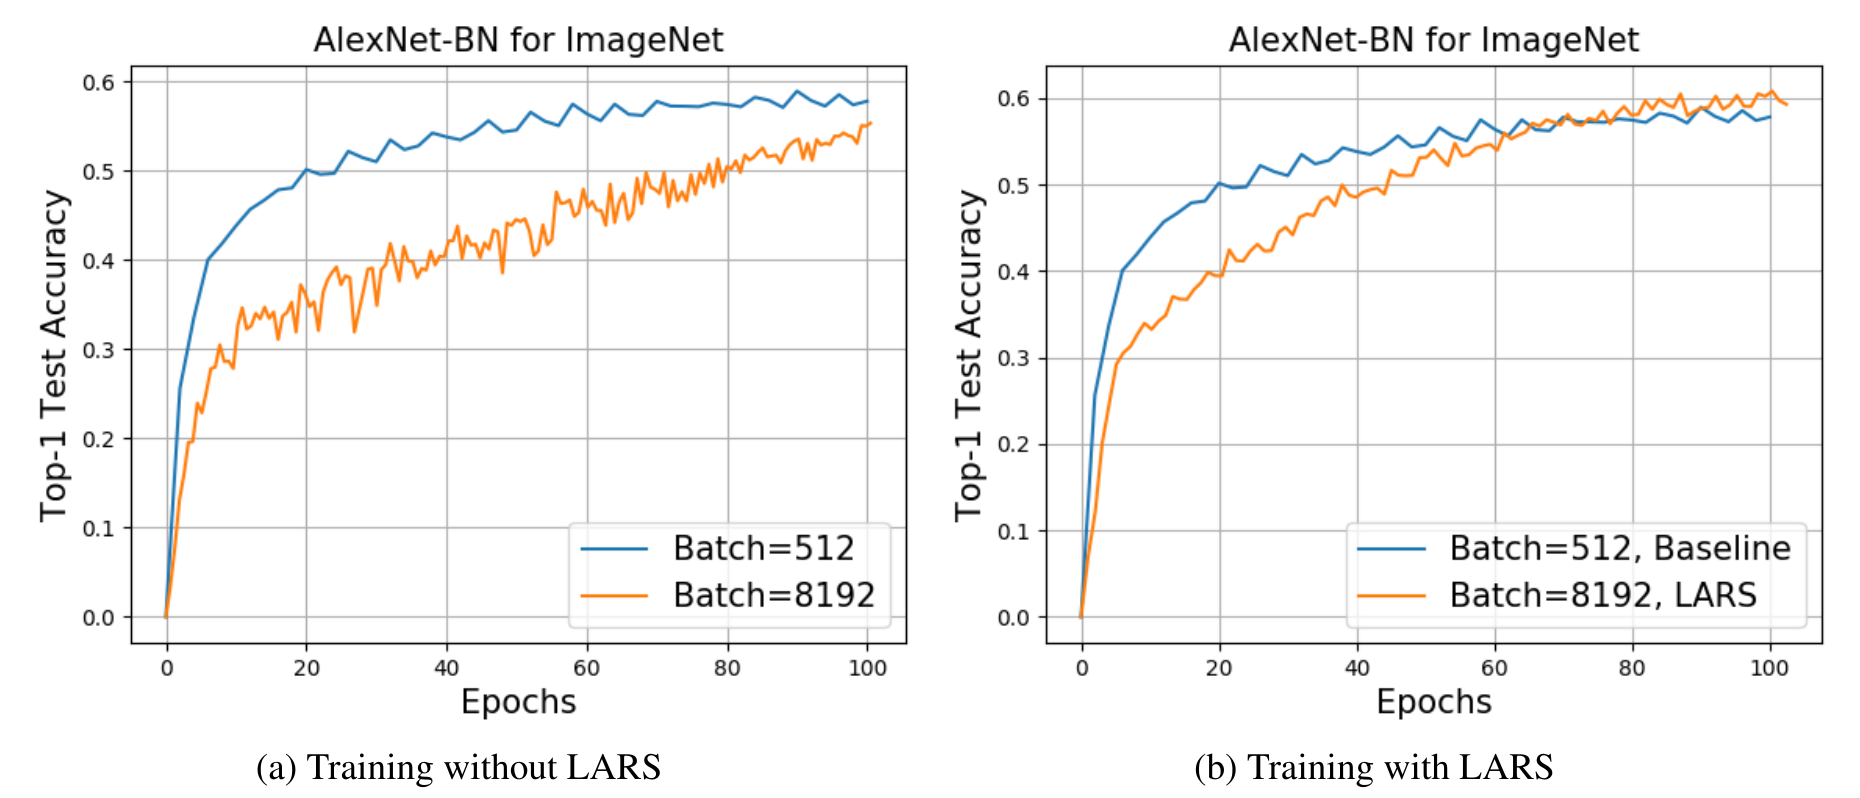
這張圖是 AlexNet-BN 在 batch 8K 的訓練過程。左邊沒有 LARS,橘線從頭落後到尾;右邊有 LARS,前 60 個 epoch 仍然落後,之後追上並稍微超過。大 batch 起步還是比較慢,LARS 讓它在相同的 epoch 數內追回來。
另外兩個觀察和調參有關。一是可用的學習率區間很寬,AlexNet-BN 在 16K 時,基礎學習率從 13 到 22 都有約 59.3%,32K 時從 17 到 28 都有約 57.5%。二是 32K 剩下的落差可以靠多訓練補回來,100、125、150、200 個 epoch 分別是 57.8%、59.2%、59.5%、59.9%。作者的解釋是 batch 大到某個程度後,隨機梯度已經很接近真實梯度,再加大 batch 也拿不到更多資訊。要注意,200 個 epoch 的 59.9% 仍低於 60.2%,而且訓練兩倍的 epoch,本來就不是大 batch 想要的結果。
ResNet-50
ResNet-50 跑 90 個 epoch,動量 0.9、權重衰減 0.0001,LARS 配 5 個 epoch 的暖身和二次多項式衰減:
| batch | 全域學習率 | top-1(%) |
|---|---|---|
| 256(無 LARS) | 0.2 | 73.0 |
| 8K | 0.6 | 72.7 |
| 16K | 2.5 | 73.0 |
| 32K | 2.9 | 72.3 |
整理自原論文 Table 4。
32K 只比基準低 0.7 個百分點。不過這裡的基準只有 73%,因為作者只做了最簡單的資料增強(縮成 256×256 後隨機裁 224×224、水平翻轉),測試也只用單一中心裁切;Goyal 等人的基準是 76.4%。而且論文沒有交代 ResNet-50 的大 batch 用了什麼硬體,AlexNet 的 16K、32K 則明說是梯度累積模擬出來的,整篇沒有真正擴展到上千張卡的牆鐘時間。
LARS 也不是每個任務都管用。一年半後,同一位第一作者在 Google 用 LARS 預訓練 BERT,batch 16K 時 SQuAD 的 F1 掉到 89.6,32K 直接發散。這個失敗把他帶到下一個優化器。
被重新檢驗
LARS 後來成了大 batch 的標準配備。MLPerf Training 的 ResNet-50 項目,closed division 只准用 SGD 動量或 LARS 兩種優化器,兩屆冠軍都用 LARS,batch 分別是 32,768 和 65,536。自監督學習也大量採用,SimCLR 寫明「為了穩定訓練,所有 batch size 都用 LARS」,BYOL 也是。
2021 年,Google 的 Nado 等人在〈A Large Batch Optimizer Reality Check〉回頭追問,LARS 真的比一般的優化器擅長大 batch 嗎?他們指出,LARS 論文的 ResNet-50 準確率偏低,也沒有在同一個 batch 下和其他優化器比過。他們把 MLPerf 上最快的 LARS 管線拿來,只換優化器和超參數,改用 Nesterov 動量,在 batch 32,768、2,512 步(64 個 epoch)的條件下各跑 50 次。LARS 的中位數是 75.97%,50 次中有 35 次達到 75.9% 的門檻;Nesterov 的兩組設定分別是 75.97%(34 次)與 75.92%(29 次)。
追平的過程並不輕鬆。他們發現 MLPerf 版的「LARS」其實只對一般權重用 LARS,BatchNorm 的參數和偏差項交給普通的 heavy-ball 動量,也不加 L2 正則化;這個細節不在 LARS 論文裡,卻對兩種優化器都「極為重要」。Nesterov 這邊還得重調標籤平滑、BatchNorm 初始化與暖身曲線的形狀才追得上。訓練準確率也值得一看。Nesterov 78.97%、LARS 78.07%,測試準確率卻差不多。Nado 等人因此認為,LARS 的逐層正規化或許更像一種正則化。把預算放寬到 6,000 步、改用最簡單的 cosine 排程後,Nesterov 是 76.7%,LARS 是 76.9%,好幾種設定都輕鬆越過 75.9%。他們的結論是,大 batch 本身沒有那麼不穩,難的是在極緊的步數預算裡把所有超參數調到位。
NFNet 的作者也走過這條路。NFNet 的自適應梯度裁剪(AGC)同樣看梯度範數和權重範數的比值,論文把它稱為 LARS 這類正規化優化器的放寬版,只限制更新的上限,不完全忽略梯度大小。他們試過直接用 LARS,大 batch 一樣訓練得穩,只是準確率變差。
結論
LARS 的貢獻是一張表和一行式子。表上顯示 AlexNet-BN 各層的 差了兩百多倍,式子讓每層的更新固定為自身權重的一個比例。靠這個,AlexNet 在 batch 8K 從 44.8% 回到 58.2%,ResNet-50 在 32K 下只掉 0.7 個百分點。它沒有證明一般的優化器做不到,三年多後 Nado 等人就用 Nesterov 在同樣的步數追平了。
自己實作 LARS 時,BatchNorm 的參數和偏差項要排除在 trust ratio 與權重衰減之外,MLPerf 和後來的自監督實作都這麼做。拿它和別的優化器比,也請在同樣的步數下認真調一組動量 SGD。
Table 3 裡 AlexNet 的 32K 那兩格 TBD,一直留到 v3 定稿,再也沒有填上。