原始論文
On the Convergence of Adam and Beyond
- 發表版本
- ICLR 2018會議
- arXiv 首次提交
- arXiv:1904.09237
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizersamsgrad2019,
  title = {{On the Convergence of Adam and Beyond}},
  author = {Sashank J. Reddi and Satyen Kale and Sanjiv Kumar},
  year = {2019},
  eprint = {1904.09237},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1904.09237}
}
先玩一個小遊戲。
參數 只能待在 到 之間。每三步為一輪,第一步的損失是 ,第二步和第三步的損失都是 。一輪加起來是 ,所以 越小越好,答案是 。
梯度很好算,第一步是 ,後兩步是 。SGD 每一輪往負方向淨走一步,最後停在 。
Adam 會停在 ,整個區間裡最差的那一點。
這個例子出自 Google 的 Sashank Reddi、Satyen Kale 與 Sanjiv Kumar。他們用它證明 Adam 原始論文的收斂定理是錯的,再從錯誤的地方推出一個只改一行的修正版,AMSGrad。
定義問題
Adam 宣稱的收斂
Adam 論文用線上凸最佳化的框架分析收斂。每一步,演算法先選一個參數 ,接著才看到這一步的凸損失函數 。衡量標準是遺憾(regret),也就是累積損失比「事後看來最好的固定參數」多出多少:
如果平均遺憾 趨近 0,平均來說演算法就追上了最好的固定解。Adam 論文的 Theorem 4.1 宣稱,在梯度有界、、學習率 等條件下,Adam 的遺憾是 ,平均遺憾趨近 0。
開頭那個遊戲正是線上凸最佳化。每個 都是線性函數,可行域是 。Adam 停在 ,每一輪都比 多付出固定的損失,平均遺憾永遠不會趨近 0。
有效學習率會不會變大
Reddi 等人把問題指向一個量。把各種自適應方法寫成同一個框架,每一步的更新是 , 就是每個參數實際的學習率。看它的倒數怎麼隨時間變化:
SGD 的 固定、 遞減;AdaGrad 的 是歷史梯度平方的平均,配上 ,分母裡實際是梯度平方的總和,只增不減。兩者的 都不會是負的,學習率只會變小。
Adam 和 RMSProp 用的是指數移動平均。最近的梯度一變小, 就跟著變小,學習率反而變大, 可以是負的。
論文開頭描述了實務上看到的情況。在輸出空間很大的問題裡,有些小批次會帶來很大、很有資訊量的梯度,但很少出現;指數移動平均讓它們的影響很快消失,訓練就收斂得很差。這篇要做的,是把這個直覺變成可以證明的反例。
解決問題
反例:每三步一次大梯度
論文的 Theorem 1 就是開頭那個遊戲的一般版本。損失函數依序是
一輪的梯度總和是 ,最佳解是 。Adam 的設定是 、、,而且 ;這組參數滿足 Adam 論文要求的 。論文附錄用歸納法證明,從 出發,每一輪結束時 都會回到 。
為什麼?我們取 ,這時 ,直接算一輪。 經過幾輪後會進入固定的循環,下表是循環中的一輪。表中最後兩欄是 ,正數代表把 往 推,負數代表往 推;實際的更新量還要再乘上 ,同一輪裡三步的 差不多,先忽略:
| 步 | Adam | AMSGrad | ||
|---|---|---|---|---|
| 1 | 8.21 | |||
| 2 | 1.72 | |||
| 3 | 1.07 | |||
| 一輪 |
本文試算,、、,Theorem 1 的設定。AMSGrad 的分母用歷史最大的 ,即 8.21。
先看 Adam 那一欄。第一步的梯度是 ,但 同時被它撐大到 8.21,,大梯度被縮小了將近 3 倍。論文說大梯度 會被縮小「將近 倍」,指的就是這件事。接下來兩步梯度只有 , 以每步保留一成的速度掉回 1.72、1.07,學習率在兩步內放大到將近三倍,兩個小梯度合起來推了 。一輪下來,淨效果是往錯的方向走 。
這就是 的具體樣子。大梯度帶來的教訓,兩步之後就忘得差不多了。
照這組設定、取 實際迭代三十萬步,Adam 停在 ,平均遺憾 ,正好是論文給的下界 ;同樣條件下 AMSGrad 走到 。
論文還補了幾點。這個例子在固定步長 時同樣成立;在分母加上 也救不回來,附錄的 Theorem 6 對任何 都造得出類似的反例。SGD 和 AdaGrad 在同一個問題上,平均遺憾都會趨近 0。
換成實際會用的
太刻意了,實務上 都接近 1。論文接著證明了兩個更強的結果。
Theorem 2 說,只要 (實務設定幾乎都滿足),就存在一個線上凸問題讓 Adam 的平均遺憾不趨近 0。構造方式相同,只是週期從 3 拉長成 :每 步出現一次梯度 ,其餘都是 。 要夠大,大到 的記憶撐不過一個週期。
夠大是多大?附錄列了三個條件,其中一個是 。我們代數字算, 時 至少 3,218(附錄 B 還要求 是偶數;只看這個不等式是 3,217), 時至少 42,622。也就是每四萬多步出現一次、比平常大四萬多倍的梯度。
Theorem 3 把場景換成隨機最佳化。每一步獨立抽樣,以機率 看到 ,否則看到 。期望的損失是 ,最佳解還是 ;但 夠大時,Adam 每一步位移的期望值是正的,參數會往遠離最佳解的方向漂。
作者的結論是,若想避免這種行為,、、 都得依問題而定;高維問題甚至需要每個維度各自一組,這又違背了自適應方法不用調參的初衷。他們也承認例子是刻意構造的,但認為實際情況裡類似的現象至少會拖慢收斂。
證明錯在哪
有了反例,就知道 Adam 原本的證明一定有一步不成立。論文在第 4 節與附錄 D 指出,Adam 的證明假設 是半正定的,也就是學習率不會變大;這個假設在 Adam 上不成立。此外,Adam 證明中的引理 10.3 和 10.4 也有問題。
SGD 與 AdaGrad 的學習率本來就單調不增,所以不會碰到這個問題。這個觀察直接指向修正的方法。
AMSGrad
既然問題出在 會變小,那就讓分母記住歷史最大值:
和 Adam 唯一的差別是第三行。 照樣用指數移動平均更新,所以它對梯度尺度的估計仍然只看最近一段時間;但實際拿去當分母的 只增不減,學習率 因此單調不增, 保證是半正定的。多出來的成本只是一個和參數同大小的向量。
回到上面那張表的 AMSGrad 欄。分母一直停在 8.21,兩個 各只推 ,一輪的淨效果變成往正確方向走 。
作者拿它和 Adam、AdaGrad 比較一個情境。假設某一步 ,也就是這一步的梯度比最近的平均小:
- Adam 會積極地把學習率調大,前面的反例就是被這一點拖垮;
- AdaGrad 會把學習率稍微調小,長期累積下來,學習率可能小到幾乎不動;
- AMSGrad 既不調大也不調小。
AMSGrad 的收斂保證(Theorem 4)沿用 Adam 論文的分析框架並修掉上面的問題。條件是 、、,可行域直徑與梯度有界,遺憾的上界多了一個 ;論文寫道,取 ,或較溫和的 ,都能保證 的遺憾。
有兩個細節要留意。證明需要 隨時間遞減,但作者也寫明實務上通常固定 。另外,論文裡的 Adam 拿掉了偏差修正,註腳說這是為了簡化,反例的論證對有修正的版本同樣適用;AMSGrad 的 Algorithm 2 也沒有偏差修正。
論文也提了另一條路 AdamNC,結構不變,改讓 隨時間增加。取 時, 剛好是所有歷史梯度平方的平均,等於一個帶動量的 AdaGrad。
討論
合成實驗
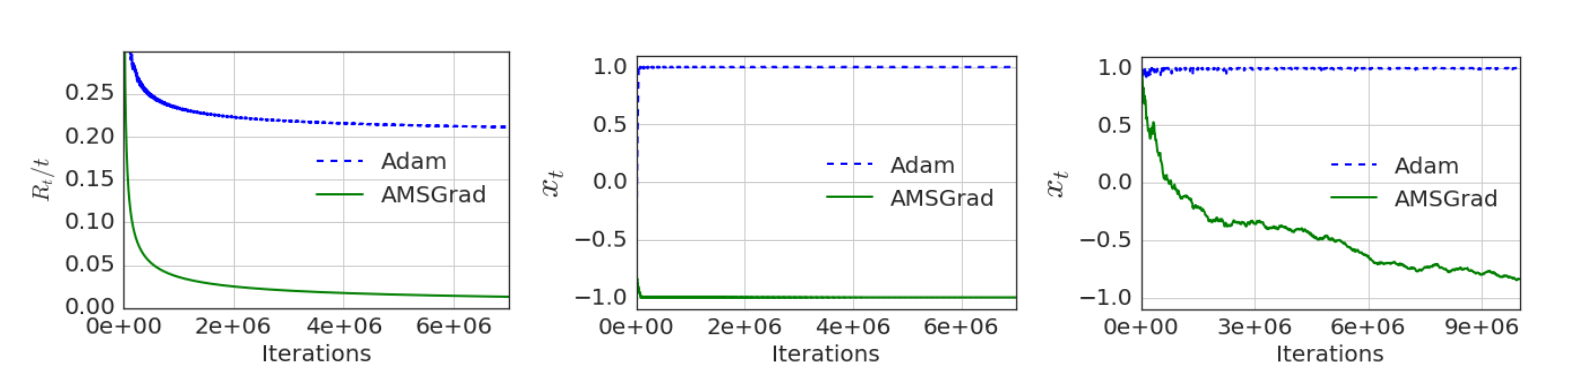
實驗用的是反例的放大版。每 101 步出現一次損失 ,其餘 100 步是 ,一個週期的梯度總和是 ,最佳解仍是 。這次用的是一般的 、,兩個方法參數相同。
左圖是平均遺憾。Adam 的藍色虛線在 0.21 附近變平,不再下降;AMSGrad 的綠線降到接近 0。中圖是參數本身,Adam 停在 ,AMSGrad 停在 。
右圖是隨機版本,每一步以 1% 的機率看到 ,否則是 。Adam 一樣停在 。AMSGrad 往下走得很慢,到一千萬步時大約在 ,還沒到 。
真實資料
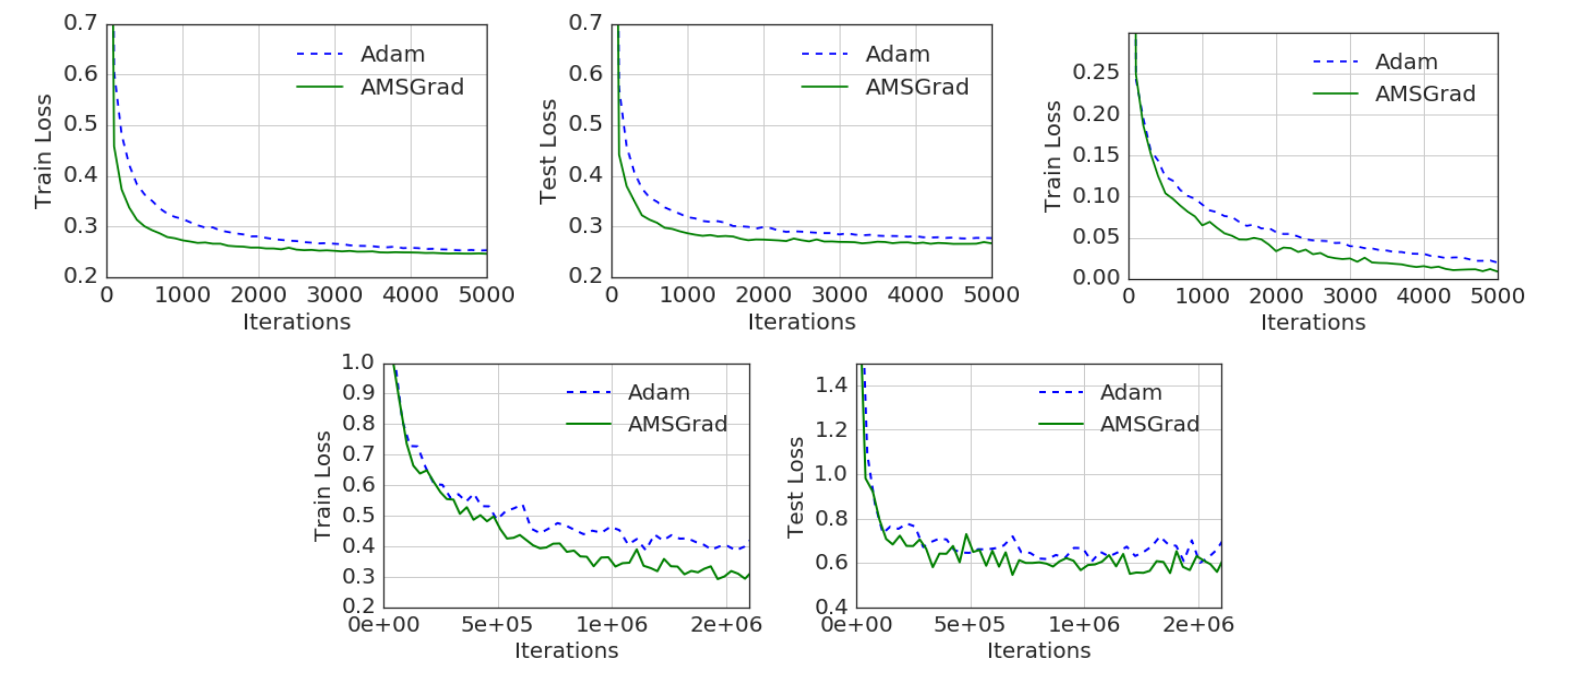
真實資料的實驗有三組,批次大小都是 128,, 從 中挑:
- MNIST 邏輯斯迴歸(上排左、中)。凸問題,學習率照理論用 遞減, 與 用網格搜尋。AMSGrad 的訓練與測試損失都略低,作者也提到它對參數變動比較不敏感。
- MNIST 單隱藏層網路(上排右)。100 個 ReLU,學習率固定。AMSGrad 的訓練損失一路略低於 Adam。
- CIFAR-10 的 CIFARNET(下排)。兩層 64 通道、 卷積,接 384 與 192 的全連接層,中間有最大池化、局部響應正規化與 dropout。訓練損失的差距最明顯,大約 0.3 對 0.4;測試損失兩者都在 0.6 附近,AMSGrad 略低。
讀這組結果要知道它的範圍。圖上只有損失,沒有準確率(正文說 AMSGrad 的準確率也比較好,但沒有給數字);每條曲線看起來是單次執行,沒有誤差範圍;模型也都很小。作者在貢獻清單裡自己稱它為初步的實驗。
實務上的回應
AMSGrad 很快被各大框架收進去,PyTorch 和 Keras 的 Adam 都有 amsgrad 參數,預設關閉。
用的人實際試過之後,回饋並不熱烈。fast.ai 的 Sylvain Gugger 與 Jeremy Howard 在 2018 年 7 月的文章裡,用 CIFAR-10 的 Wide ResNet、Stanford Cars 上微調 ResNet-50、WikiText-2 上的 AWD-LSTM 與 QRNN 語言模型比較,寫道 amsgrad 一直沒有在準確率或其他指標上帶來任何好處,形容它「非常令人失望」。
AMSGrad 自己的證明後來也被挑出問題。Phuong 與 Phong 在 2019 年指出,它的證明在處理 和 時把兩者當成相等,Adam 原本的證明也有同樣的疏漏;他們給了新的證明,也提出另一個變體 AdamX。
Adam 其實會收斂?
反例成立,Adam 在實務上又確實好用,兩者要怎麼放在一起?後續的幾篇工作給出的答案,差在它們先固定了什麼:
| 工作 | 先固定什麼 | 結論 |
|---|---|---|
| Reddi 等人 2018 | 先選 ,再造問題 | Adam 可以不收斂 |
| Zhang 等人 2022 | 先給問題,再選 | 夠大就收斂 |
| ADOPT 2024 | 改演算法 | 任何 都收斂 |
Zhang 等人 2022 點出順序的問題。Reddi 等人是先選定 ,再針對它構造一個壞問題,前面算過, 需要四萬多步的週期;實務上卻是問題先擺在那裡,我們再去調超參數。他們證明,對固定的問題,只要 夠大(門檻依問題而定)且 ,不改任何更新規則的 Adam 會收斂到臨界點附近,範圍大小和隨機梯度的變異數成正比;在更強的條件下會收斂到臨界點本身。這個分析針對非凸的有限和問題,每個 epoch 隨機打亂樣本順序,不需要梯度有界的假設,也涵蓋了預設的 。反過來, 太小時存在一大片會發散的 。
同一時期,Défossez 等人在平滑非凸、梯度有界的條件下給了一個簡短的收斂證明,也指出預設參數的 Adam 嚴格來說不收斂,行為比較像固定步長的 SGD。
ADOPT 2024 回頭檢查 AMSGrad。它指出 AMSGrad 在非凸問題上的收斂證明,都假設隨機梯度一致有界;變分自編碼器、擴散模型這類在梯度裡注入高斯雜訊的模型,並不滿足這個條件。問題出在取最大值這一步,期望值很難控制。ADOPT 換了一個做法,用上一步的 去正規化這一步的梯度,讓分母不含當下的梯度,並且先正規化、再累積動量。在梯度二階動差有限的條件下,它對任何 都達到 的收斂速率。
最後還有一個註腳。2026 年 7 月的一篇預印本〈On the Convergence of Adam, Revisited〉宣稱,在 Reddi 等人同樣的線上設定裡,連 這個條件都不需要,任何 都找得到讓 Adam 平均遺憾不歸零的例子,用的還是斜率 的三步循環,而且可以推廣到 AdamW、Muon 等變體。這和 Zhang 等人的正面結果並不衝突,兩邊回答的是不同順序的問題。
結論
這篇論文用一個三步一輪的線性函數,證明了 Adam 原始的收斂定理有誤,並把問題定位在指數移動平均讓學習率可以變大。AMSGrad 用歷史最大值當分母,讓學習率單調不增,恢復了凸問題上的收斂保證。真實資料上的改善很小,實驗也只到初步的程度,後來獨立的測試多半沒有看到好處;這篇留給後來研究的,是 這個分析角度,以及「先固定哪一邊」這個問題。
實務上,amsgrad=True 只是一個開關,懷疑資料裡有罕見但重要的大梯度時,可以和調大 一起列入比較;前者只多一份和參數同大小的狀態,後者不增加任何成本。Zhang 等人證明 太小時有一大片會發散的區域;照這個結果推,如果為了反應快把它調低,訓練出現不穩定時,先把它調回接近 1 再說。
三步一輪的小遊戲倒是一直沒退休。八年後還是同樣的 ,這次連 都不用假設,順手把 AdamW 和 Muon 也拉了進來。