原始論文
PaLM: Scaling Language Modeling with Pathways
- arXiv 首次提交
- arXiv:2204.02311
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{transformerspalm2022,
  title = {{PaLM: Scaling Language Modeling with Pathways}},
  author = {Aakanksha Chowdhery and Sharan Narang and Jacob Devlin and Maarten Bosma and Gaurav Mishra and Adam Roberts and Paul Barham and Hyung Won Chung and Charles Sutton and Sebastian Gehrmann and Parker Schuh and Kensen Shi and Sasha Tsvyashchenko and Joshua Maynez and Abhishek Rao and Parker Barnes and Yi Tay and Noam Shazeer and Vinodkumar Prabhakaran and Emily Reif and Nan Du and Ben Hutchinson and Reiner Pope and James Bradbury and Jacob Austin and Michael Isard and Guy Gur-Ari and Pengcheng Yin and Toju Duke and Anselm Levskaya and Sanjay Ghemawat and Sunipa Dev and Henryk Michalewski and Xavier Garcia and Vedant Misra and Kevin Robinson and Liam Fedus and Denny Zhou and Daphne Ippolito and David Luan and Hyeontaek Lim and Barret Zoph and Alexander Spiridonov and Ryan Sepassi and David Dohan and Shivani Agrawal and Mark Omernick and Andrew M. Dai and Thanumalayan Sankaranarayana Pillai and Marie Pellat and Aitor Lewkowycz and Erica Moreira and Rewon Child and Oleksandr Polozov and Katherine Lee and Zongwei Zhou and Xuezhi Wang and Brennan Saeta and Mark Diaz and Orhan Firat and Michele Catasta and Jason Wei and Kathy Meier-Hellstern and Douglas Eck and Jeff Dean and Slav Petrov and Noah Fiedel},
  year = {2022},
  eprint = {2204.02311},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2204.02311}
}
「Google 剛僱了一隻口才很好的鯨魚進 TPU 團隊,牠示範了怎麼在兩個不同的 pod 之間溝通!」
這個雙關語要懂兩件事才笑得出來。pod 是一群 TPU 晶片,也是一群鯨魚。2022 年 4 月,Google 在 PaLM 論文的第一張圖裡讓模型解釋這個笑話:
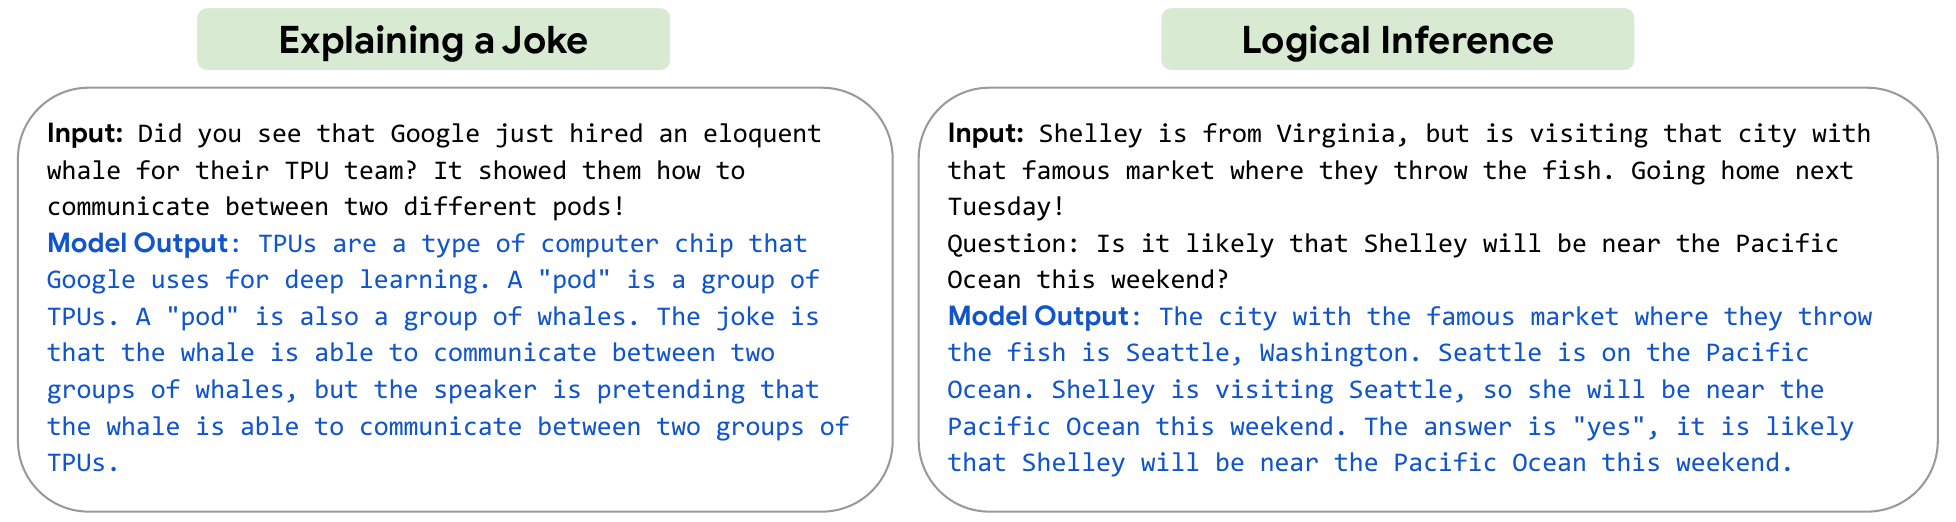
左邊是笑話,模型的回答是,鯨魚能在兩群鯨魚之間溝通,說話的人假裝牠能在兩組 TPU 之間溝通。右邊是另一種題目,模型要先認出「有人丟魚的那座市場」在西雅圖,才能回答 Shelley 週末會不會在太平洋附近。兩個例子都用貪婪解碼,提示裡放了兩個帶解釋的範例,也就是同一年稍早提出的思維鏈提示。
笑話本身也在講這篇論文。PaLM(Pathways Language Model)是一個 5,400 億參數的稠密語言模型,在 6,144 顆 TPU v4 晶片上訓練,橫跨兩座 TPU v4 Pod,靠的是 Google 新的 Pathways 系統。
哎喲,煩死了!要解釋這麼多的笑話一點都不好笑。
定義問題
GPT-3 之後,GLaM、Gopher、Chinchilla、Megatron-Turing NLG、LaMDA 接連推進少樣本學習的成績。作者把這些進步歸納成四個方向:
- 把模型的深度與寬度放大;
- 增加訓練的 token 數;
- 用更乾淨、來源更多元的資料;
- 用稀疏模組增加容量,但不增加計算量。
PaLM 主要沿著第一條走,放大一個所有參數都參與計算的稠密模型,看少樣本能力是否已經飽和。
要做到這點,先得解決工程問題。當時最大的訓練規模是 4,096 顆 TPU v3。Megatron-Turing NLG 用了 2,240 張 A100,Gopher 用了四座 TPU v3 Pod,兩者都靠管線平行(pipeline parallelism)跨越多台機器。管線平行有「氣泡」問題,管線填滿與清空時很多裝置在閒置,也會增加記憶體頻寬的負擔。作者想在不用管線平行的情況下,把訓練擴展到兩座 Pod。
解決問題
架構:一組實用的改動
PaLM 是只有解碼器的 Transformer,加上幾個改動:
- SwiGLU:前饋層的啟動函數改成 。這需要三個矩陣乘法,但 Shazeer 在計算量相同的比較下證明了品質更好。
- 平行層:標準寫法是先過注意力再過前饋,PaLM 讓兩者讀同一個輸入、再把結果相加:
注意力和前饋的輸入矩陣乘法可以合併,大規模下訓練約快 15%。作者的消融顯示,8B 時品質略降,62B 時沒有差別,因此推測 540B 也不受影響。
- Multi-Query Attention:每個注意力頭有自己的 query,但所有頭共用同一組 key 和 value。對訓練品質與速度影響不大,自迴歸解碼時則能省下大量成本。(後來 Llama 2 的 34B 與 70B 改用介於兩者之間的 GQA。)
- RoPE 位置編碼、輸入輸出共用嵌入。
- 不用偏置:所有稠密層與 LayerNorm 都沒有偏置項,作者發現這讓大模型訓練更穩定。
- 256k 的 SentencePiece 詞表:完全可逆,保留所有空白(對程式碼很重要),詞表外的 Unicode 字元拆成 UTF-8 位元組,數字一律拆成單個位數,例如「123.5」變成「1 2 3 . 5」,隔年的 LLaMA 也照著做。
三個大小的配置如下,前饋層寬度固定是 ,每個注意力頭固定 256 維:
| 模型 | 層數 | 注意力頭數 | 參數量 | 批次大小 | |
|---|---|---|---|---|---|
| PaLM 8B | 32 | 16 | 4,096 | 86.3 億 | 256 → 512 |
| PaLM 62B | 64 | 32 | 8,192 | 625 億 | 512 → 1,024 |
| PaLM 540B | 118 | 48 | 18,432 | 5,403.5 億 | 512 → 1,024 → 2,048 |
整理自原論文 Table 1。
資料:7,800 億個 token,只看一遍
訓練資料以 LaMDA 和 GLaM 的資料為基礎,總共 7,800 億個 token:社群媒體對話 50%、過濾後的網頁 27%、英文書籍 13%、GitHub 程式碼 5%、維基百科 4%、英文新聞 1%。網頁依一個品質分類器的分數抽樣,分數越高越常被選到,但低分網頁沒有完全排除。程式碼取自 GitHub 的開源專案,排除 copyleft 授權並限定 24 種常見語言後得到 196GB 原始碼,再以 Levenshtein 距離去除重複檔案。非英文資料約占 22%。
三個模型都只看過這批資料一次,各來源的比例也經過安排,避免任何一部分被重複看到。
基礎設施:不用管線平行,跨兩座 Pod
每座 TPU v4 Pod 有 3,072 顆晶片、768 台主機。Pod 內部,每個權重張量切成 12 份做模型平行,再以 256 路做完全分片的資料平行;每座 Pod 都有一份完整的模型。
兩座 Pod 之間則交給 Pathways 做資料平行。一個 Python 客戶端把批次分成兩半送到兩座 Pod,各自算完前向與反向傳播後交換梯度,再各自加總、更新參數,得到逐位元相同的權重。
困難在跨 Pod 的網路。梯度要等每顆晶片都算完才開始傳,所以 1,536 台主機會在同一瞬間一起傳資料;每對主機每一步要交換約 1.3GB 的梯度,總計瞬間流量達 81 Tbps。作者把梯度切成小塊、分散到多條資料中心網路連結上傳送,最後兩座 Pod 的吞吐量是單座的 1.95 倍。和理論上的 2 倍差的那一點,來自反向傳播與跨 Pod 梯度傳輸沒有重疊。
用模型 FLOPs 利用率量效率
作者認為過去常用的「硬體 FLOPs 利用率」(HFU)不適合拿來比較。它取決於實作,例如用重算(rematerialization)以計算換記憶體時,硬體 FLOPs 會變多,但這不是訓練真正追求的東西。訓練要的是每秒處理多少 token。
所以作者提出模型 FLOPs 利用率(MFU):實際的 token 吞吐量,除以「硬體以峰值算力只做必要計算時」的理論吞吐量。必要計算只算前向與反向傳播,不算重算。一個 參數的解碼器,每個 token 需要 次矩陣運算 FLOPs(前向 、反向 ),注意力再加上 。我們拿 PaLM 540B 的數字算一次:
N = 540.35e9                     # 參數量
L, H, Q, T = 118, 48, 256, 2048  # 層數、注意力頭數、每頭維度、序列長度
chips, peak = 6144, 275e12       # TPU v4 晶片數、每顆的峰值矩陣運算 FLOP/s
tokens_per_sec = 238.3e3         # 實測的訓練吞吐量

flops_per_token = 6 * N + 12 * L * H * Q * T   # 前向 2N + 反向 4N,再加注意力
mfu = tokens_per_sec * flops_per_token / (chips * peak)
print(f"{6 * N:.3e} {12 * L * H * Q * T:.3e}")  # 3.242e+12 3.563e+10
print(f"{mfu:.1%}")                              # 46.2%
注意力那一項只有 的 1% 左右,大模型的計算量幾乎都花在和權重相乘的矩陣乘法上。同樣的算法下,GPT-3 是 21.3%,Gopher 32.5%,Megatron-Turing NLG 30.2%。PaLM 的 46.2% 來自平行策略、XLA 編譯器最佳化與平行層。若把重算的 FLOPs 也算進去,硬體利用率是 57.8%。
訓練設定與損失尖峰
幾個比較特別的設定:
- 最佳化器是不做分解的 Adafactor,效果近似帶「參數縮放」的 Adam。前 1 萬步學習率固定 ,之後按 遞減;二階動差的係數設為 , 是步數,作者發現這比固定 0.99 穩定,因為罕見 token 的嵌入在短窗口內估不準二階動差。
- 額外加一項 z-loss,,讓 softmax 的正規化項 接近 0,提升穩定性。
- 批次大小隨訓練加倍。540B 先用 512 條(約 100 萬 token)到第 5 萬步,再用 1,024 條到第 11.5 萬步,最後用 2,048 條(約 400 萬 token)到第 25.5 萬步結束。早期小批次比較省樣本,後期大批次的梯度估計較準,矩陣也比較大、TPU 效率較高。
- 預訓練不用 dropout,並且從任何 checkpoint 重啟都能逐位元重現。
即使有梯度截斷,540B 在訓練中仍出現了約 20 次損失尖峰,間隔很不規則,有時發生在訓練後期;小模型沒有這個問題。作者沒有找到有原理的解法,最後是從尖峰前約 100 步的 checkpoint 重啟,跳過尖峰前後的 200 到 500 個批次。
他們也檢查了是不是「壞資料」造成的。把尖峰附近的那些批次,拿到更早的 checkpoint 上訓練,並不會出現尖峰。所以尖峰是特定資料與特定參數狀態碰在一起才會發生。前面提到的逐位元重現,也讓這類檢查可以做得乾淨,從同一個 checkpoint 重跑,結果完全相同。
討論
英文 NLP 與 MMLU
在 GPT-3 論文用過的 29 個英文評測上,PaLM 540B 的少樣本成績在 28 個創下新高,比較對象是 GLaM、GPT-3、Megatron-Turing NLG、Gopher、Chinchilla 與 LaMDA 各自的最好成績。MMLU 的 5-shot 平均是 69.3,前一個最佳是 Chinchilla 的 67.5;四大類中只有「其他」這一類輸給 Chinchilla。
BIG-bench:超過人類平均,但不是每一項
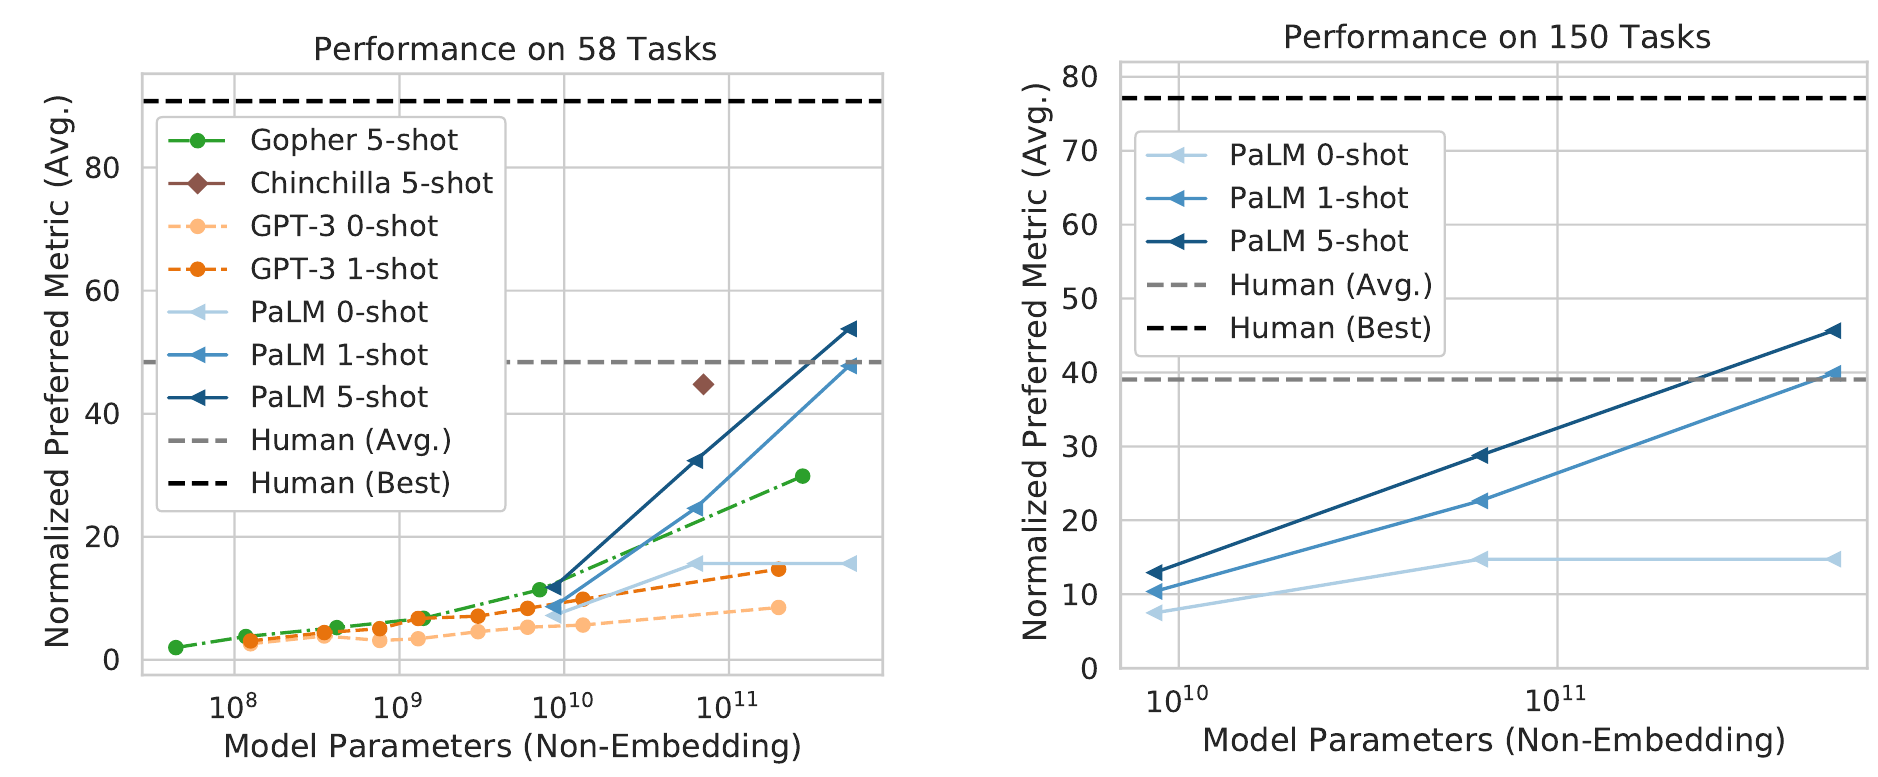
BIG-bench 是一個超過 150 個任務的集體評測。人類基準的取得方式是請群眾外包工人(通常 10 人)看同樣的任務說明與範例作答,可以使用搜尋引擎、計算機等任何工具;「人類平均」是所有人的平均,「人類最佳」是每題取最高分。
左圖只看三個模型家族都評過的 58 個任務。PaLM 540B 的 5-shot 高於人類平均,在其中 44 個任務上超過先前的最佳成績。三個 PaLM 尺寸大致落在一條對數線性的直線上,作者據此認為繼續放大還會更好。右圖是 PaLM 在 150 個任務上的表現,趨勢相似。
離人類最佳還很遠。逐一看任務的話,人類平均仍在 35% 的任務上勝過 PaLM 540B。
不連續的進步
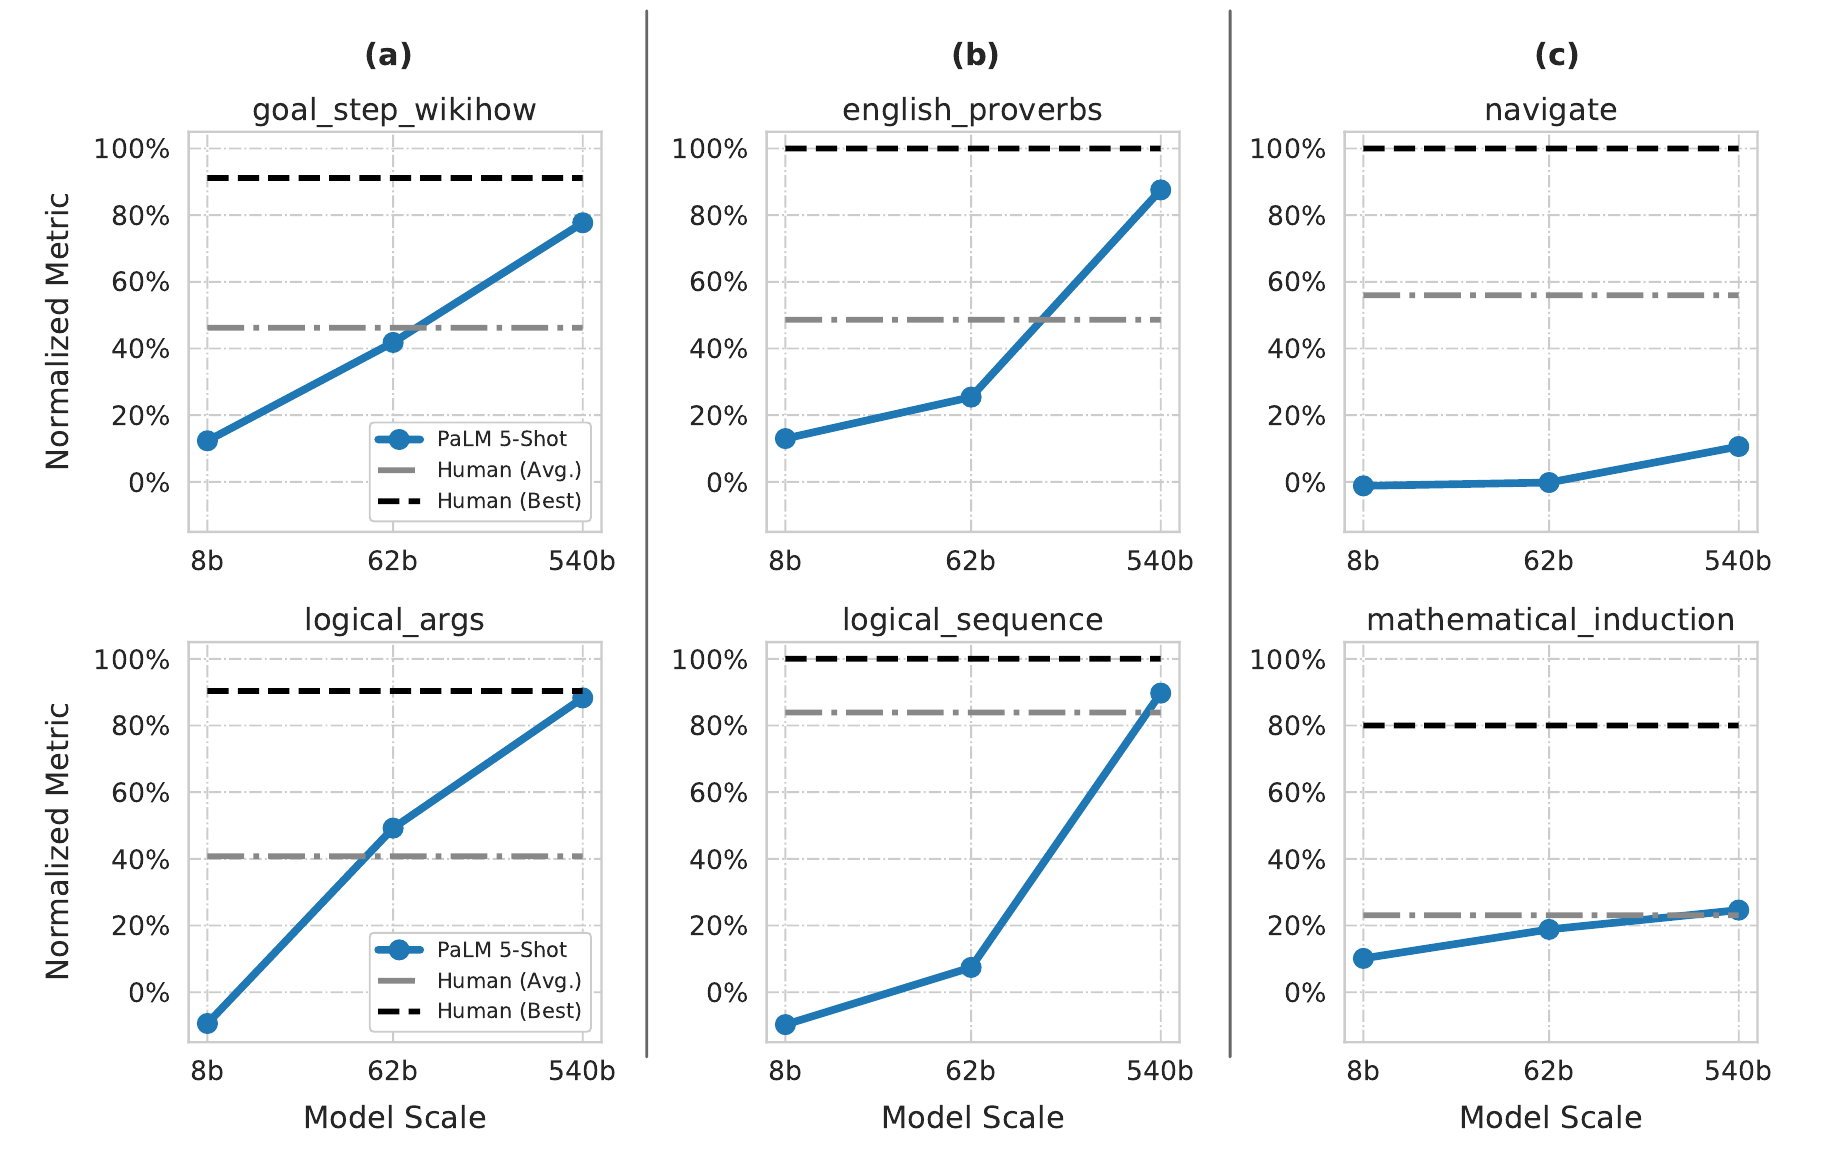
作者挑了六個任務,展示三種不同的規模曲線。(a) 是隨規模穩定上升;(c) 是幾乎沒有進步,540B 只比 62B 好一點,離人類最佳很遠;(b) 則是 8B 到 62B 只進步一點,62B 到 540B 突然大跳。
作者這樣量化「不連續」。以 english_proverbs 為例,三個尺寸的分數約是 13%、25%、87%。從 8B 到 62B 參數大約乘 8 倍,62B 到 540B 也差不多,若照前一段的對數線性趨勢外推,540B 應該是 ,實際卻是 87%,差了 50 個百分點。在全部 150 個任務中,25% 的任務不連續程度超過 10 個百分點,15% 超過 20 個百分點。
english_proverbs 要理解諺語背後的隱喻,作者認為這需要很高的抽象推理能力。mathematical_induction 則相反,題目會給出可能與現實數學矛盾的前提,例如「2 是奇數」,再問歸納推理是否正確;所有 PaLM 尺寸,以及做同一任務的人類,在前提錯誤的題目上都有困難。
推理與程式
PaLM 也用了同一團隊稍早提出的思維鏈提示。8-shot 加思維鏈與外部計算機,GSM8K 達到 58%:
| 模型與技術 | GSM8K 準確率 |
|---|---|
| PaLM 540B,思維鏈 + 計算機 | 58% |
| PaLM 540B,思維鏈 | 54% |
| PaLM 540B,不用思維鏈 | 17% |
| PaLM 62B,思維鏈 | 33% |
| GPT-3,微調 + 思維鏈 + 計算機 | 34% |
| GPT-3,微調 + 思維鏈 + 計算機 + 驗證器 | 55% |
整理自原論文 Table 10。
先前的 55% 需要微調、計算機,再加一個專門訓練的驗證器;PaLM 只靠少樣本提示就超過它。
程式方面,PaLM 540B 沒有特別為程式碼訓練,HumanEval 的 pass@100 是 76.2%,和專門的 Codex 12B(72.3%)相當。PaLM 的訓練資料裡約只有 27 億個 Python token,不到 Codex(約 1,000 億)的三十分之一。作者把這解讀為從其他程式語言與自然語言的遷移,加上大模型樣本效率較高。再用程式碼微調得到的 PaLM-Coder 540B,HumanEval pass@100 達到 88.4%。
記憶與偏見
作者從訓練資料中隨機抽 100 個 token 的片段,給模型前 50 個 token,看它能否用貪婪解碼一字不差地接出後 50 個。8B 有 1.6% 的片段能接出來,540B 有 2.4%,模型越大記得越多。只出現過一次的片段,540B 的記憶率是 0.75%;出現超過 500 次的則超過 40%。程式碼語料裡有大量授權條款與複製貼上的程式片段,最容易被記住;書籍語料多半是獨一無二的文字,最不容易。
偏見分析中,模型在宗教相關的續寫裡,會把伊斯蘭與恐怖主義、極端、暴力這類詞彙連在一起,這個傾向在各個尺寸都存在。毒性方面,62B 與 540B 的整體毒性略高於 8B;模型續寫的毒性和提示本身的毒性高度相關,人類續寫則沒有這麼強的相關。
作者自己留下的問題
論文的「規模化的開放問題」一節很有意思。PaLM 主要放大的是模型大小,但作者坦承沒有做消融去區分「模型更大」和「看更多 token」各自的貢獻。他們問,若用同樣的訓練預算,訓練一個看 7 兆 token 的 62B 模型,或看 3.6 兆 token 的 120B 模型,和看 7,800 億 token 的 540B 比起來會如何?如果小模型表現相當,推論成本會低得多。
DeepMind 的 Chinchilla 在 PaLM 發表前一週,剛處理過同樣的問題。作者把兩邊能對照的結果放在一起看:
| 模型 | 參數(B) | Token(B) | 訓練 FLOPs(ZFLOPs) | 9 項英文評測平均 |
|---|---|---|---|---|
| PaLM 62B | 62 | 795 | 295.7 | 64.8 |
| Chinchilla | 70 | 1,400 | 588.0 | 65.2 |
| Gopher | 280 | 300 | 504.0 | 59.5 |
| PaLM 540B | 540 | 780 | 2,527.2 | 70.3 |
整理自原論文 Table 21。
訓練 FLOPs 約為 Chinchilla 一半的 PaLM 62B,和 Chinchilla 平均只差 0.4 分;Gopher 則明顯落後。作者同意這支持 Chinchilla 的結論,Gopher 以它的大小來說訓練不足。但 PaLM 和 Chinchilla 用的是不同的資料,作者認為無法據此回答「X 大小的模型看 Y 個 token,會不會比 PaLM 540B 好」。
一年後的 PaLM 2 技術報告回答了一部分。它依 Chinchilla 的結論,讓資料量與模型大小大致按 1:1 的比例放大;最大的 PaLM 2-L 比 PaLM 540B 小得多,訓練算力卻更多。
結論
把稠密模型推到 5,400 億參數,少樣本能力還在往上走。29 項英文評測拿下 28 項,GSM8K 只靠提示就超過微調加驗證器,四分之一的 BIG-bench 任務在 62B 到 540B 之間突然開竅。
如果你想知道自己的訓練跑得有多有效率,MFU 是現成的算法。每秒處理的 token 數乘上 ,除以晶片的峰值算力,就能和 PaLM 的 46.2% 放在一起比。
只是照 Chinchilla 每個參數大約 20 個 token 的比例,5,400 億參數該讀約 11 兆個 token,PaLM 只讀了 7,800 億。鯨魚很聰明,就是書讀得少了點。