原始論文
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer
- arXiv 首次提交
- arXiv:1910.10683
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{transformerst52019,
  title = {{Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer}},
  author = {Colin Raffel and Noam Shazeer and Adam Roberts and Katherine Lee and Sharan Narang and Michael Matena and Yanqi Zhou and Wei Li and Peter J. Liu},
  year = {2019},
  eprint = {1910.10683},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1910.10683}
}
2019 年下半年,NLP 的預訓練論文多到讀不完。
BERT 用遮罩語言模型,GPT-2 用從左到右的語言模型,XLNet 用排列語言模型,RoBERTa 說 BERT 只是沒練夠。每一篇都同時換了好幾樣東西:目標函數、模型架構、預訓練資料、訓練步數、微調方式。最後分數變高了,卻很難說清楚是哪一項的功勞。
Google 的 Raffel、Shazeer 等人在這篇論文裡做了一件很笨也很昂貴的事。他們把所有任務改寫成同一種格式,固定一個基準設定,再一次只換一個因素,逐項比較。比完之後,把每一項的最佳選擇組合起來,放大到 110 億參數,訓練約 1 兆個 token(在 2019 年這是巨無霸,放到今天只能算小模型)。
作者在前言就說清楚,這篇的目的不是提出新方法,而是整理出整個領域的現況。這個統一的模型叫 T5(Text-to-Text Transfer Transformer)。論文同時釋出一份清理過的網路語料 C4,之後成了許多語言模型的預訓練資料。
定義問題
遷移學習(transfer learning)在 NLP 的做法,是先在大量無標註文字上預訓練,再拿下游任務的標註資料微調。到了 2019 年,這條流程的每一段都有好幾種選擇,而且彼此很難比較。
BERT 這類只有編碼器的模型,擅長分類或從原文中標出答案的位置,卻沒辦法直接生成翻譯或摘要。GPT 這類語言模型可以生成,但在分類任務上通常要另外接一個分類頭。只要模型、損失函數或解碼方式不同,比較出來的差異就混了其他變數。
所以作者需要一個能同時處理分類、問答、翻譯、摘要的共同框架,讓同一個模型、同一個損失函數、同一套超參數跑完所有任務。有了它,才能一次只改一個因素。
解決問題
文字進,文字出
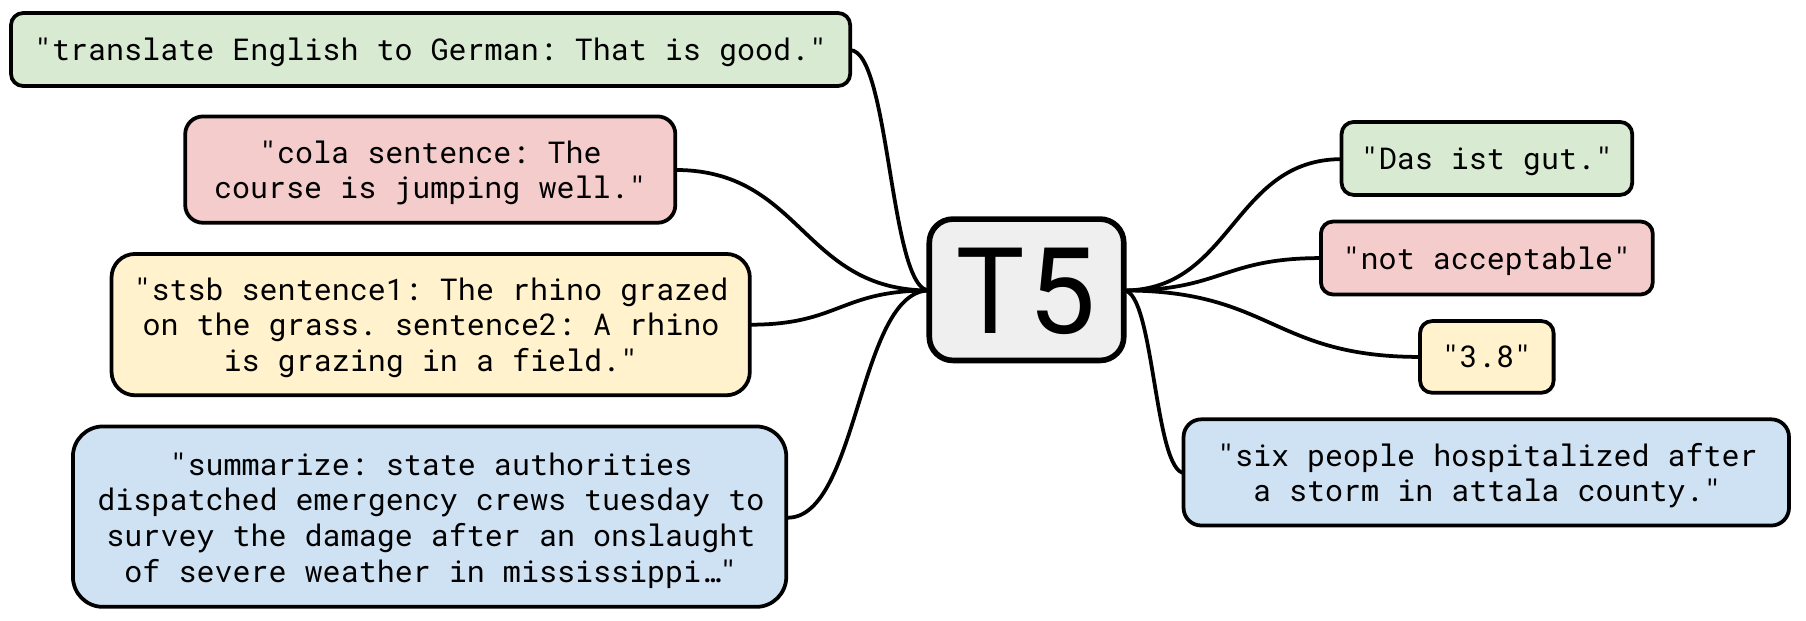
每個任務都改寫成「輸入一段文字,輸出一段文字」,任務名稱直接寫在輸入前面當前綴。翻譯就是輸入「translate English to German: That is good.」,訓練模型輸出「Das ist gut.」。
分類任務也一樣,只是輸出換成類別名稱。MNLI 要判斷前提和假設之間的關係,輸入是:
mnli premise: I hate pigeons. hypothesis: My feelings towards pigeons are filled with animosity.
目標輸出是 entailment 這個字。如果模型輸出了不在選項裡的字,例如「hamburger」,就直接算錯;作者說實際上從沒看過這種情況。
有兩類任務需要多做一點轉換。STS-B 要預測兩句話的相似度,是 1 到 5 的實數。作者發現標註大多以 0.2 為間隔,就把分數四捨五入到最近的 0.2,再轉成字串,例如 2.57 變成「2.6」,回歸問題就變成 21 類的分類。Winograd 類的代名詞消歧任務,則把有歧義的代名詞用星號標出來,請模型輸出它指的名詞:
輸入:The city councilmen refused the demonstrators a permit because *they* feared violence.
輸出:The city councilmen
所有任務都用最大概似估計訓練,也就是一般的交叉熵加上 teacher forcing。前綴的寫法本身算是一個超參數,作者試過換措辭,影響不大。
模型:接近原始的 Transformer
模型是標準的編碼器-解碼器 Transformer,作者只改了三處:
- LayerNorm 只縮放、不加偏置。
- LayerNorm 移到每個子層的輸入端,殘差路徑本身不做正規化,也就是後來常說的 Pre-LN。
- 相對位置編碼簡化成一個純量,直接加在注意力分數上。每個注意力頭各有一組,所有層共用。總共 32 個桶,對應的距離範圍以對數方式增加,超過 128 的距離全部歸到同一個桶。單一層分辨不出 128 以外的位置差異,多層疊起來就可以。
輸出層和輸入嵌入共用權重,這點和原始 Transformer 相同。作者沒有對這三處改動做消融,因為它們和本文要比較的因素無關。
基準模型的編碼器與解碼器各 12 層,大小都和 BERT-Base 相當:、前饋層 、12 個注意力頭,每個頭 。總共約 2.2 億參數,因為有兩疊網路,大約是 BERT-Base 的兩倍。
C4:清理過的網路文字
Common Crawl 每個月會抓下約 20TB 的網頁文字,但大部分是選單、錯誤訊息、重複的樣板或程式碼。作者對 2019 年 4 月的快照套用一連串規則:
- 只保留以句號、驚嘆號、問號或結束引號結尾的行。
- 少於 3 句的頁面整頁丟掉;只保留至少 5 個字的行。
- 頁面裡出現「髒話清單」中任何一個字,就整頁刪除。
- 含有「Javascript」的行刪掉,含有「lorem ipsum」的頁面刪掉。
- 含有大括號
{的頁面刪掉,因為那多半是程式碼。 - 刪掉維基百科的引用標記,以及含有「terms of use」「cookie policy」這類字串的行。
- 去重:任何重複出現的三句連續片段,只保留一份。
- 用 langdetect 只留英文機率至少 0.99 的頁面。
結果約 750GB,作者取名 Colossal Clean Crawled Corpus,簡稱 C4。三年多後 Meta 訓練 LLaMA 時,C4 還占了預訓練資料的 15%。
基準的訓練設定
預訓練跑 步,每批 128 條長度 512 的序列,打包後一批約 個 token,總共約 億個 token。這比 BERT 的約 1,370 億、RoBERTa 的約 2.2 兆都少很多,但足以比較各種設定,而且 C4 夠大,整個過程不會重複任何資料。
最佳化器是 AdaFactor。預訓練前 步固定學習率 0.01,之後按步數的平方根倒數遞減。每個下游任務都微調 步,學習率固定 0.001,每 5,000 步存一次,回報驗證集上最好的那個 checkpoint。詞表是 SentencePiece 訓練的 32,000 個詞片,訓練資料是英文 C4 與德、法、羅馬尼亞文按 10:1:1:1 混合,因為下游有這三種翻譯任務。
預訓練目標:只預測被挖掉的片段
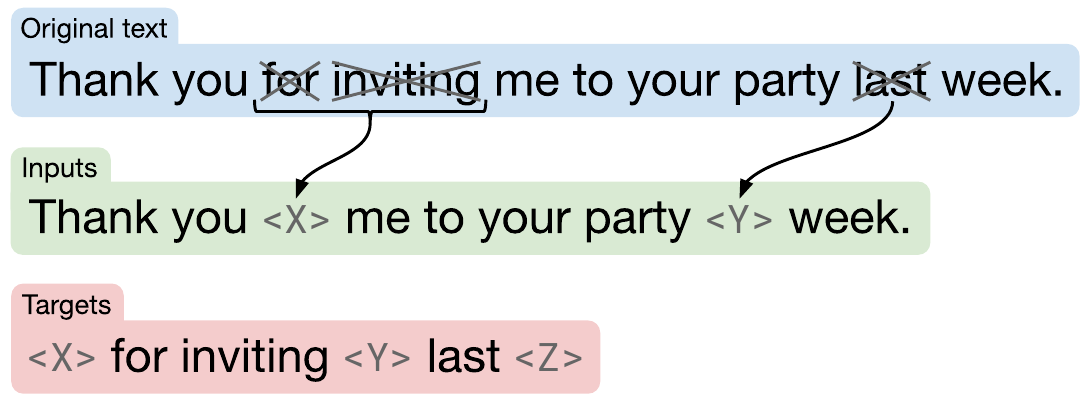
基準目標從 BERT 的遮罩語言模型改來。隨機選 15% 的 token 破壞,連續被選中的 token 合成一段,用一個「哨兵」(sentinel)token 取代;每段的哨兵都不同。輸出只包含被挖掉的片段,各段前面放上同一個哨兵,最後再補一個哨兵當結尾。
我們照著圖上的例子寫一遍:
tokens = "Thank you for inviting me to your party last week .".split()
noise = [0, 0, 1, 1, 0, 0, 0, 0, 1, 0, 0]  # 1 = 被選中要破壞的 token

def span_corrupt(tokens, noise):
    sentinels = iter(["<X>", "<Y>", "<Z>"])
    inputs, targets, prev = [], [], 0
    for tok, n in zip(tokens, noise):
        if n and not prev:          # 一段連續破壞的開頭,放一個哨兵
            s = next(sentinels)
            inputs.append(s)
            targets.append(s)
        if n:
            targets.append(tok)     # 被破壞的 token 只出現在輸出
        else:
            inputs.append(tok)
        prev = n
    targets.append(next(sentinels))  # 最後再補一個哨兵當結尾
    return inputs, targets

inputs, targets = span_corrupt(tokens, noise)
print(" ".join(inputs))    # Thank you <X> me to your party <Y> week .
print(" ".join(targets))   # <X> for inviting <Y> last <Z>
print(len(tokens), len(inputs), len(targets))  # 11 10 6
「for」和「inviting」相鄰,所以共用一個 <X>。原句 11 個 token,輸入剩 10 個,輸出只有 6 個。如果照 BERT 的做法改成「輸出整句原文」,解碼器要生成 11 個 token。作者選擇只預測挖掉的片段,主要是為了省計算,解碼器的序列越短,預訓練越快。
實際的 T5 用 <extra_id_0>、<extra_id_1> 這類特殊 token 當哨兵,它們加在詞表裡,不對應任何詞片。
基準有多穩
每個實驗都重複多次太貴了。作者改成把基準設定從頭訓練 10 次,用這 10 次的標準差當所有變體的參考。多數任務的標準差小於分數的 1%;CoLA、CB、COPA 這類小資料集例外,CB 的驗證集只有 56 筆,F1 的標準差高達 3.2。論文的表格會把與最高分相差兩個標準差以內的結果都標成粗體。
同樣的模型不預訓練、直接訓練 步,GLUE 從 83.28 掉到 66.22,SQuAD 從 80.88 掉到 50.31。英法翻譯則幾乎不受影響(39.82 對 39.77),因為那個資料集本身就夠大。
討論
論文的主體是一連串對照實驗,從架構、目標、資料、訓練策略到規模化。表格裡回報的是 GLUE 與 SuperGLUE 的平均分、CNN/DM 摘要的 ROUGE-2、SQuAD 的完全匹配率,以及三組翻譯的 BLEU,除了最後的總成績外,都是驗證集。
架構:參數量與計算量要分開算
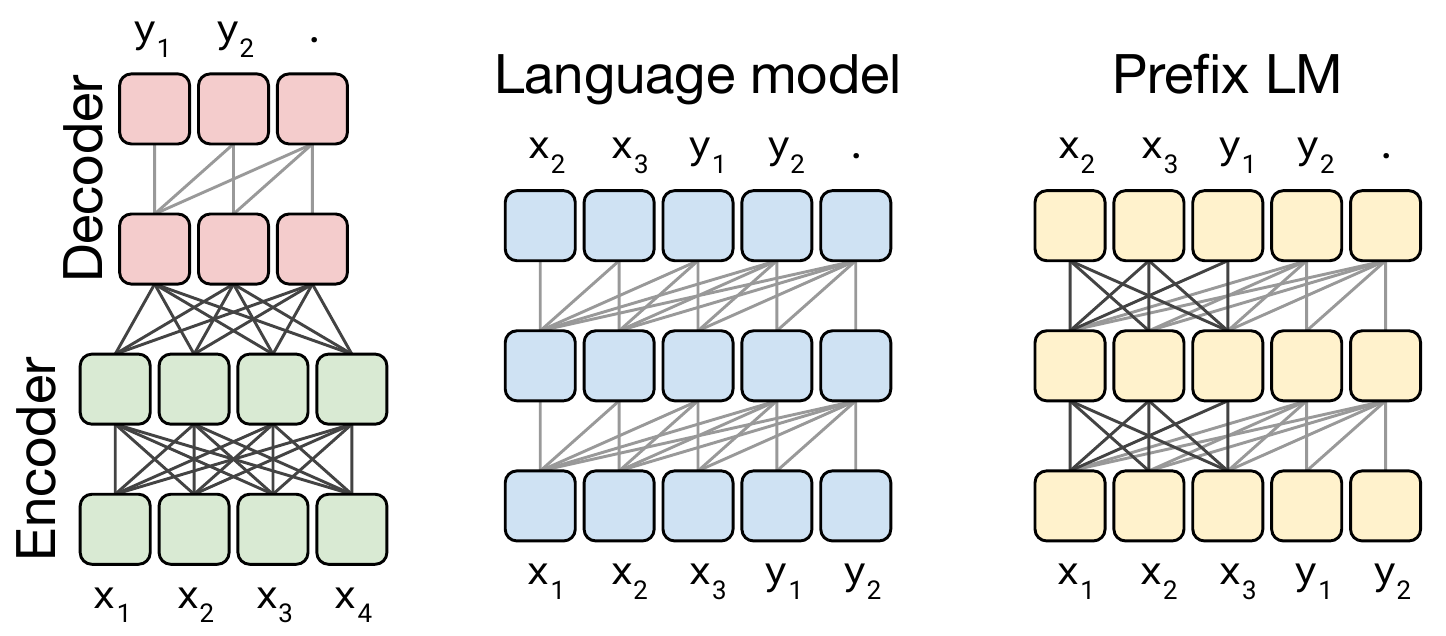
圖中深灰線代表全可見的注意力,淺灰線代表因果遮罩,也就是只能看過去的位置。語言模型處理翻譯時,要把輸入和輸出接成一條序列:「translate English to German: That is good. target: Das ist gut.」。問題在於,因果遮罩讓輸入部分的每個位置也只能看前面,前半句的表示看不到後半句。prefix LM 把輸入那段改成全可見,就解決了這一點。在分類任務上,prefix LM 其實很像 BERT,差別只在分類結果直接由輸出層生成。
比較架構前,得先決定「公平」的標準。編碼器、解碼器各 層的模型,參數量和 層的語言模型差不多;但它的計算量只和 層的語言模型相當,因為編碼器只處理輸入、解碼器只處理輸出,語言模型則要把每一層套在輸入加輸出上。作者實測,兩者每一步的時間幾乎一樣。
設 BERT-Base 大小的一疊網路有 個參數、處理一組輸入輸出需要 FLOPs,結果如下:
| 架構 | 目標 | 參數 | 計算 | GLUE | SuperGLUE | SQuAD | 英德 BLEU |
|---|---|---|---|---|---|---|---|
| 編碼器-解碼器 | 去噪 | 83.28 | 71.36 | 80.88 | 26.98 | ||
| 編碼器-解碼器,共用參數 | 去噪 | 82.81 | 70.73 | 80.63 | 26.72 | ||
| 編碼器-解碼器,各 6 層 | 去噪 | 80.88 | 68.42 | 77.59 | 26.38 | ||
| 語言模型 | 去噪 | 74.70 | 55.02 | 61.14 | 25.09 | ||
| Prefix LM | 去噪 | 81.82 | 68.11 | 78.94 | 26.43 | ||
| 編碼器-解碼器 | 語言模型 | 79.56 | 64.29 | 76.02 | 26.27 |
整理自原論文 Table 2,節錄部分列與欄。
在同樣的計算量下,編碼器-解碼器配去噪目標在所有任務都最好。讓編碼器和解碼器共用參數,參數量減半,分數只掉一點,表現還勝過同樣 個參數的 prefix LM,作者認為顯式的編碼器-解碼器注意力有幫助。把層數減半則明顯變差。另一個一致的結果是,去噪目標在每種架構上都勝過語言模型目標。
預訓練目標:差異不大,選便宜的
目標函數的比較分三輪。第一輪比較三種大方向,prefix 語言模型(GLUE 80.69)、BERT 式遮罩(82.96),以及把句子打亂再還原(73.17)。BERT 式最好,打亂還原明顯落後。
第二輪比 BERT 式的變體:拿掉隨機替換、改用哨兵取代整段、或直接刪掉被破壞的 token。四種變體的分數都很接近。直接刪 token 在 GLUE 上略高,主要來自 CoLA(60.04 對基準的 53.84),作者推測判斷句子是否合乎文法,和察覺哪裡少了字有關;但它在 SuperGLUE 上比哨兵版差。
第三輪調破壞比例和片段長度。10% 到 25% 差別不大,50% 時 GLUE 和 SQuAD 明顯下降。片段破壞用兩個參數描述。一條 500 個 token 的序列,破壞 15% 就是 75 個 token;若規定分成 25 段,平均每段長 3。平均長度 3 的版本在多數非翻譯任務上略勝逐 token 隨機破壞(SuperGLUE 72.53 對 71.36),而且序列更短、訓練更快。
作者的結論是,在他們試過的去噪目標之間,效能差異很小,應該主要依計算成本來選。
預訓練資料:過濾有用,太小會背題
把 C4 的過濾規則全部拿掉(只保留語言偵測),資料變成 6.1TB,所有任務都變差,GLUE 從 83.28 掉到 81.46。
較小但領域集中的資料,在特定任務上會贏。Wikipedia 加上 Toronto Books Corpus(BERT 用的組合,共 20GB)讓 SuperGLUE 升到 73.24,幾乎全來自 MultiRC:它的完全匹配率從 25.78 跳到 50.93,而 MultiRC 最大的資料來源正是小說。只保留新聞網站內容的 RealNews-like 版本,則讓新聞閱讀理解 ReCoRD 從 68.16 升到 73.72。下游任務和預訓練資料的領域越接近,效果越好。
代價是資料量。模仿 GPT-2 WebText 的做法(只留 Reddit 上得分至少 3 的連結),用了 12 個月的 Common Crawl,只得到 17GB。作者再刻意把 C4 截短,讓同樣 340 億 token 的訓練重複看同一批資料。重複 64 次時影響很小;重複 1,024 次,GLUE 掉到 79.55;重複 4,096 次掉到 76.34,訓練損失卻明顯更低,代表模型開始背資料。
訓練策略:微調全部參數仍然最好
只更新部分參數的方法比較吃虧。Adapter 在每個前饋層後加一個小的「全連接-ReLU-全連接」區塊,只訓練它和 LayerNorm。內部維度 時,SQuAD 還有 79.32,英德翻譯卻只剩 13.84 BLEU。資料少的任務用小 adapter 就夠,資料多的任務需要大得多的維度。逐層解凍(gradual unfreezing)則在所有任務上都小幅退步。
多任務學習在 text-to-text 框架下很簡單,把不同資料集的樣本混在同一個批次裡就好;麻煩在於每個任務該占多少比例。作者比了三種混合方式:
- 按資料量比例:資料越多抽得越多,但設一個上限 ,避免無標註資料和英法翻譯這種大資料集把其他任務淹沒。
- 溫度縮放:把各任務比例取 次方再正規化; 等於按比例, 越大越接近平均。
- 平均分配:每個任務抽到的機率相同。
平均分配最差,GLUE 只有 76.13。按比例混合時,多數任務都有一個最佳的 ;溫度縮放以 最好。但沒有任何一種混合方式追上「先無監督預訓練、再個別微調」。
折衷的做法有效。先用多任務混合預訓練,再對個別任務微調,GLUE 83.11,和基準的 83.28 差不多,英羅翻譯還略高。把目標任務排除在預訓練混合之外(leave-one-out),分數只略低,代表見過許多任務的模型仍能適應沒見過的任務。只用有標註任務預訓練、完全不用無標註資料,除了翻譯以外都明顯變差。
給你 4 倍算力,該怎麼用
多了 4 倍算力,要訓練更久、把模型變大,還是做集成?作者實際比了一次。
| 做法 | GLUE | SuperGLUE | SQuAD | CNN/DM | 英德 BLEU |
|---|---|---|---|---|---|
| 基準 | 83.28 | 71.36 | 80.88 | 19.24 | 26.98 |
| 同樣大小,訓練 4 倍步數 | 85.33 | 74.72 | 82.45 | 19.33 | 27.08 |
| 同樣大小,批次大 4 倍 | 84.60 | 74.64 | 82.52 | 19.42 | 27.07 |
| 模型大 2 倍,訓練 2 倍步數 | 86.18 | 77.18 | 84.18 | 19.66 | 27.52 |
| 模型大 4 倍,步數不變 | 85.91 | 78.04 | 83.86 | 19.73 | 27.47 |
| 4 個獨立訓練的模型集成 | 84.77 | 71.74 | 83.09 | 20.10 | 28.05 |
整理自原論文 Table 13,節錄部分列與欄。
四種用法都有幫助。加大模型通常比只增加訓練量更有效;模型大 2 倍訓練 2 倍久,和模型大 4 倍,兩者差不多。集成則在 CNN/DM 摘要和英德、英羅翻譯上勝過所有其他做法,但對 SuperGLUE 幾乎沒幫助。作者也提醒,大模型會讓之後的微調和推論都更貴;小模型多訓練的成本則可以分攤到許多下游任務上。
組合起來:T5
最後的 T5 把研究結論組合起來:
- 目標:片段破壞,破壞 15%、平均片段長度 3。
- 訓練量:100 萬步、每批 條長度 512 的序列,約 1 兆個 token,是基準的 32 倍。領域較集中的資料集太小,會重複數百次,所以仍用 C4。
- 模型大小:Small(6000 萬)、Base(2.2 億)、Large(7.7 億)、3B、11B。3B 與 11B 主要放大前饋層: 分別是 16,384 和 65,536,注意力頭分別為 32 與 128 個。作者說加寬前饋層的原因是 TPU 最擅長大型稠密矩陣乘法。
- 多任務預訓練後再微調,GLUE 與 SuperGLUE 改成逐一子任務微調,批次縮小到 8,避免小資料集過擬合。
- 翻譯與摘要改用寬度 4 的 beam search。
T5 在 24 項任務中的 18 項拿下當時最佳。3B 已經在幾項任務上超越前人,作者認為放大到 11B 是拿到最好成績最重要的一步。GLUE 平均 90.3;SuperGLUE 平均 88.9,前一個最佳是 84.6,人類是 89.8;SQuAD 完全匹配率 91.26,前一個最佳是 90.1。CNN/DM 的 ROUGE-2 是 21.55,前一個最佳是 20.30。
分數背後也有作者自己點出的問題。T5 在 MultiRC 與 ReCoRD 上大幅超過人類,作者認為這比較可能是評估指標偏向機器的輸出;人類在 COPA 與 WSC 上都是 100%,T5 還差一截。翻譯則一項都沒拿下。預訓練只用英文,當時最佳的翻譯系統還用了回譯(back-translation)等資料增強。
最後一個實驗回答 T5 的進步有多少只是規模。基準模型同樣訓練 1 兆個 token(Baseline-1T),GLUE 84.80、SuperGLUE 73.90、SQuAD 83.01;T5-Base 是 85.97、75.64、85.44。兩者大小與訓練量相同,差別只在研究中挑出的那些非規模化改動,而 T5-Base 在所有任務都勝出。
後來的檢驗
C4 釋出後被廣泛使用,Dodge 等人在 2021 年做了第一份較完整的 C4 文件化研究。單一網域中,貢獻最多 token 的是 patents.google.com;內容裡有機器翻譯產生的文字,也有其他 NLP 基準的測試題,例如 XSum 摘要有 15.49% 的參考答案原封不動出現在 C4 裡。
他們特別檢查了被髒話清單刪掉的內容。被刪掉的文件裡,以性內容為主的群集約占三成,其他還有科學、醫學、健康與法律政治類的文件。用方言主題模型分類後,非裔美國人英語與西語裔英語的文件被刪除的比例是 42% 和 32%,白人英語只有 6.2%;提到性傾向的文件最容易被濾掉,人工抽查「gay」相關的被刪文件,36% 既不冒犯也不是色情內容。整頁刪除的關鍵字過濾很便宜,但刪掉的東西並不中性。
架構的結論也值得對照後續研究。T5 的比較是在「預訓練後再對各任務微調」的設定下做的。BigScience 的 Wang 等人在 2022 年換一個設定重新比較,只看預訓練後的零樣本表現時,因果解碼器配自迴歸語言模型目標最好;加上多任務提示微調後,輸入全可見、用遮罩目標訓練的架構最好。換句話說,T5 的結論在它的設定下成立;後來大型模型普遍走向只有解碼器的架構,和越來越看重的零樣本、少樣本用法有關。
結論
這篇讀起來像一份很長的實驗手冊。先把所有任務寫成文字進、文字出,再一次只換一個因素,從架構、目標、資料、微調到規模,每一項都有表格可以查。
如果只想帶走幾條,大概是這些。去噪目標彼此差不多,挑訓練便宜的那個;預訓練資料要先清乾淨,也要大到不必重複看;多出來的算力,先拿去把模型加大。
至於「編碼器-解碼器最好」這一條,兩年後連 Google 自家的 PaLM 都沒有照做。