原始論文
Scaling Instruction-Finetuned Language Models
- arXiv 首次提交
- arXiv:2210.11416
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modeltuningflant52022,
  title = {{Scaling Instruction-Finetuned Language Models}},
  author = {Hyung Won Chung and Le Hou and Shayne Longpre and Barret Zoph and Yi Tay and William Fedus and Yunxuan Li and Xuezhi Wang and Mostafa Dehghani and Siddhartha Brahma and Albert Webson and Shixiang Shane Gu and Zhuyun Dai and Mirac Suzgun and Xinyun Chen and Aakanksha Chowdhery and Alex Castro-Ros and Marie Pellat and Kevin Robinson and Dasha Valter and Sharan Narang and Gaurav Mishra and Adams Yu and Vincent Zhao and Yanping Huang and Andrew Dai and Hongkun Yu and Slav Petrov and Ed H. Chi and Jeff Dean and Jacob Devlin and Adam Roberts and Denny Zhou and Quoc V. Le and Jason Wei},
  year = {2022},
  eprint = {2210.11416},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2210.11416}
}
FLAN 在 2021 年發現,把幾十種 NLP 資料集改寫成指令,拿來微調語言模型,模型就比較會做沒看過的任務。差不多同時,T0 和 InstructGPT 也各自用指令資料微調模型,結果都不錯。
接下來的問題很自然。題目再多一點、模型再大一點,會不會更好?
Google 的 Chung 等人在這篇論文裡把兩邊都推到當時的極限。任務從 FLAN 的 62 種加到 1,836 種,模型最大用到 5,400 億參數的 PaLM,另外還加進了思維鏈(chain-of-thought,CoT)資料。得到的模型叫 Flan-PaLM;同一套流程也拿來微調 T5,從 8,000 萬到 110 億參數,公開了權重,這就是後來很多人用過的 Flan-T5。
定義問題
在這之前的指令微調研究,各自只放大了一個方向。FLAN 用到 137B 的模型,但只有 62 種任務;Natural Instructions v2 收集了 1,600 多種任務,但模型最大只到 11B。兩個方向一起放大會怎樣,沒有人試過。
另一個問題更麻煩。前人的指令資料幾乎都是「直接給答案」的格式,而 PaLM 那一年最受矚目的能力之一,是先寫出推理步驟再回答的思維鏈。拿一堆直接給答案的題目微調,會不會讓模型忘了怎麼一步一步推?
所以這篇要回答三件事:
- 任務數量和模型大小一起放大,效果會怎麼變?
- 指令微調會不會傷害思維鏈推理?如果會,怎麼補?
- 這套做法換到別的架構、別的大小,還有沒有用?
解決問題
1,836 種任務
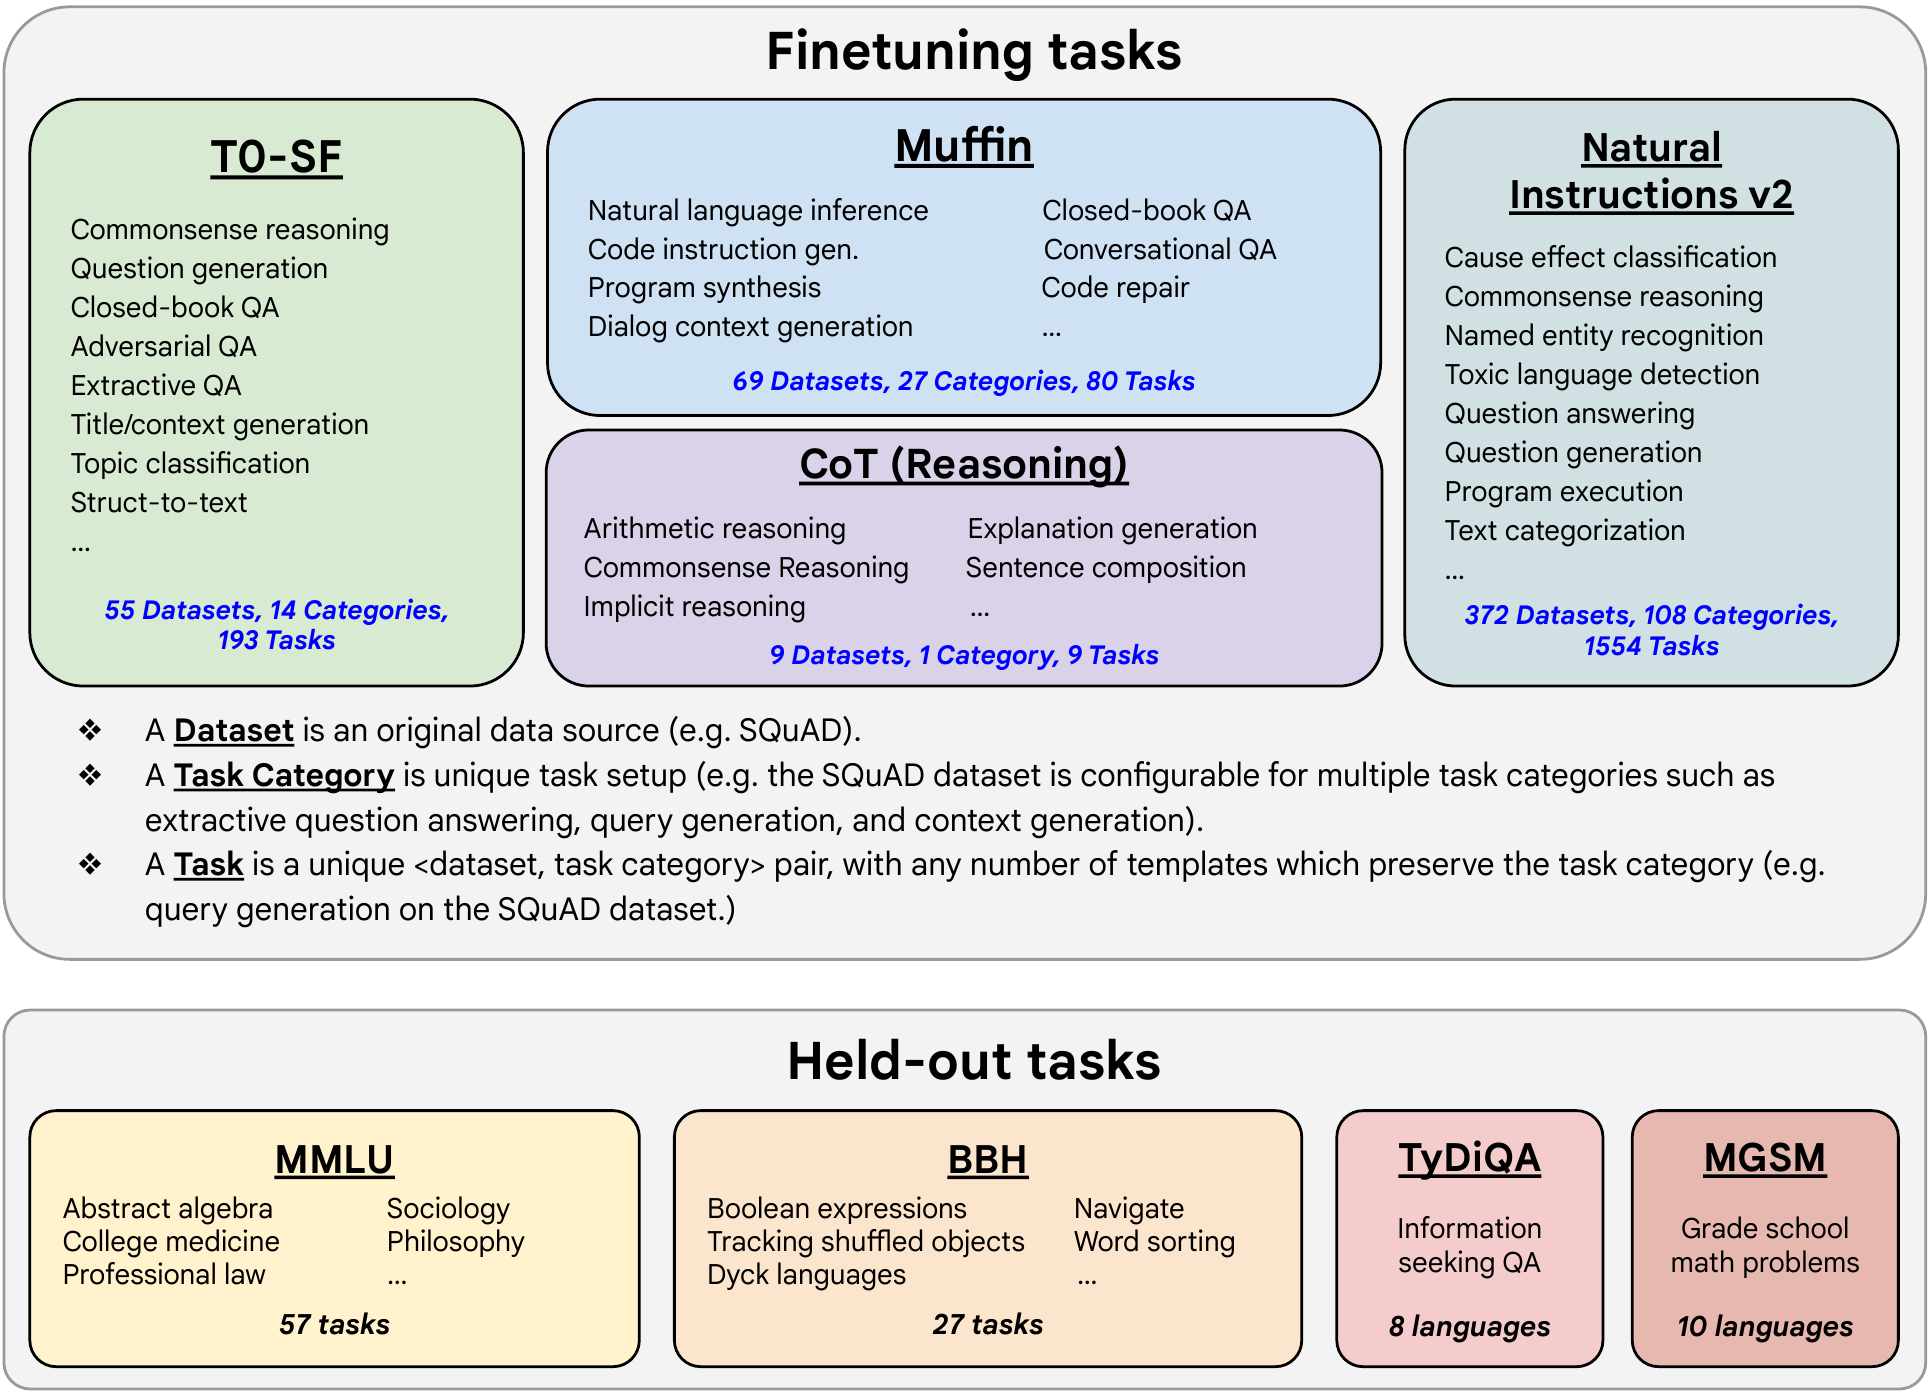
先分清楚圖裡的三個單位。資料集是原始資料來源,例如 SQuAD。任務類別是一種題型,同一個 SQuAD 可以拿來做抽取式問答、出題、生成上下文好幾種。任務是「資料集 × 任務類別」的一個組合,例如「用 SQuAD 出題」。
四組資料各有來源:
- Muffin(80 種):以 FLAN 原本的任務為主,再加上這篇新增的對話與程式生成等任務。
- T0-SF(193 種):T0 的任務裡和 Muffin 不重複的部分,SF 是「sans Flan」,也就是不含 Flan。
- NIV2(1,554 種):Natural Instructions v2,作者先刪掉 44 種和 MMLU 有關的任務,因為 MMLU 要拿來評測。
- CoT(9 種):九個有人工寫好推理過程的資料集,例如算術推理的 GSM8K、多步推理的 StrategyQA,作者替每個資料集各寫了約十個指令模板。
合起來是 473 個資料集、146 個類別、1,836 種任務。
每一題還會以不同格式出現,有沒有範例、要不要寫推理過程,各自組合。以論文的例子來說:
[沒有範例、不寫推理]
Answer the following yes/no question. Can you write a whole Haiku in a single tweet?
→ yes

[有範例、寫推理]
Q: Answer the following yes/no question by reasoning step-by-step. Could a dandelion suffer from hepatitis?
A: Hepatitis only affects organisms with livers. Dandelions don't have a liver. The answer is no.
Q: Answer the following yes/no question by reasoning step-by-step. Can you write a whole Haiku in a single tweet?
A: A haiku is a japanese three-line poem. That is short enough to fit in 280 characters. The answer is yes.
只有那九個 CoT 資料集會用到「寫推理」的格式。
微調本身很便宜
每個模型都用同一套流程,只調學習率、批次大小、dropout 和步數。最佳化器用 Adafactor,學習率固定不衰減;多筆短樣本會打包進同一條序列,並用遮罩擋住樣本之間的注意力。
和預訓練比起來,指令微調花的算力少得可憐。Flan-PaLM 540B 的微調只用了預訓練算力的 0.2%,大約是 512 顆 TPU v4 跑 37 小時;Flan-T5 各個尺寸則在 0.2% 到 1.6% 之間。
怎麼考
評測只用沒出現在微調資料裡的題目:
- MMLU:57 科的考試題,包括數學、歷史、法律、醫學,5-shot。
- BBH:BIG-Bench 裡 23 個 PaLM 還贏不了一般人類評分者的困難任務,3-shot。
- TyDiQA:8 種語言的問答,1-shot。
- MGSM:把 GSM8K 的數學應用題人工翻成 10 種語言,8-shot。
GPT-3 論文用的那一批評測,作者刻意不用,因為那些任務的訓練集幾乎都已經在微調資料裡了。
MMLU 和 BBH 各考兩次,一次直接回答,一次先寫思維鏈再回答。六個分數再合成一個「正規化平均」。正規化的意思是以隨機猜的分數為零點,再把剩下的範圍拉回 0 到 100。例如二選一的題目,隨機猜就有 50%,那麼答對 55% 算 ,答對 45% 則是 −10%。
討論
題目越多越好,但前 282 種最有用
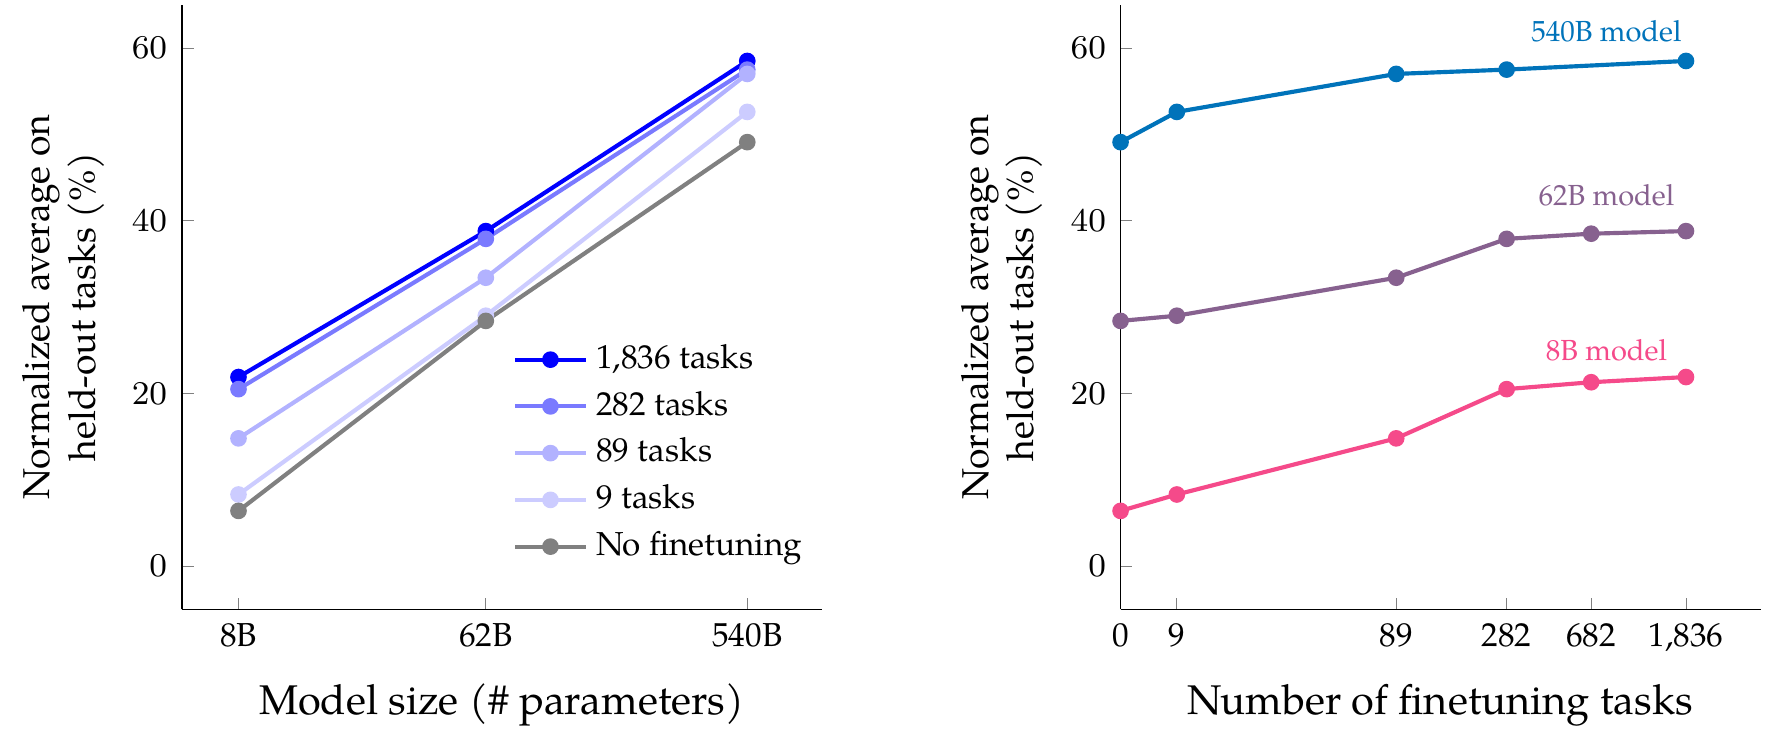
左圖看模型大小。灰線是不微調,其他線是加了不同數量的任務;三種大小下,指令微調都把正規化平均拉高了 9.4 到 15.5 個百分點。模型每放大約十倍,不論有沒有微調,分數都明顯上升。
右圖看任務數量。任務照 CoT、Muffin、T0-SF、NIV2 的順序一組一組加上去,從 0 加到 282 種時,曲線爬得最快;之後再加到 1,836 種,只多了一點點。
作者提了兩個解釋。一個是後面加進來的任務不夠多樣,沒教模型新東西。另一個是指令微調的收穫,主要來自讓模型學會「把預訓練時已經知道的東西說出來」,這種事學到一定程度就飽和了。第二個解釋和數字對得上。PaLM 預訓練讀了 7,800 億個 token,指令微調只用了 14 億個,大約 0.2%。
到底是小模型還是大模型受益比較多,作者也沒有下定論。看絕對分數,8B 多了 15.5,540B 多了 9.4;看錯誤率減少的比例,540B 是 18.4%,8B 是 16.6%。同一組數字,換個算法,結論就反過來。
不練思維鏈,就會忘了怎麼推
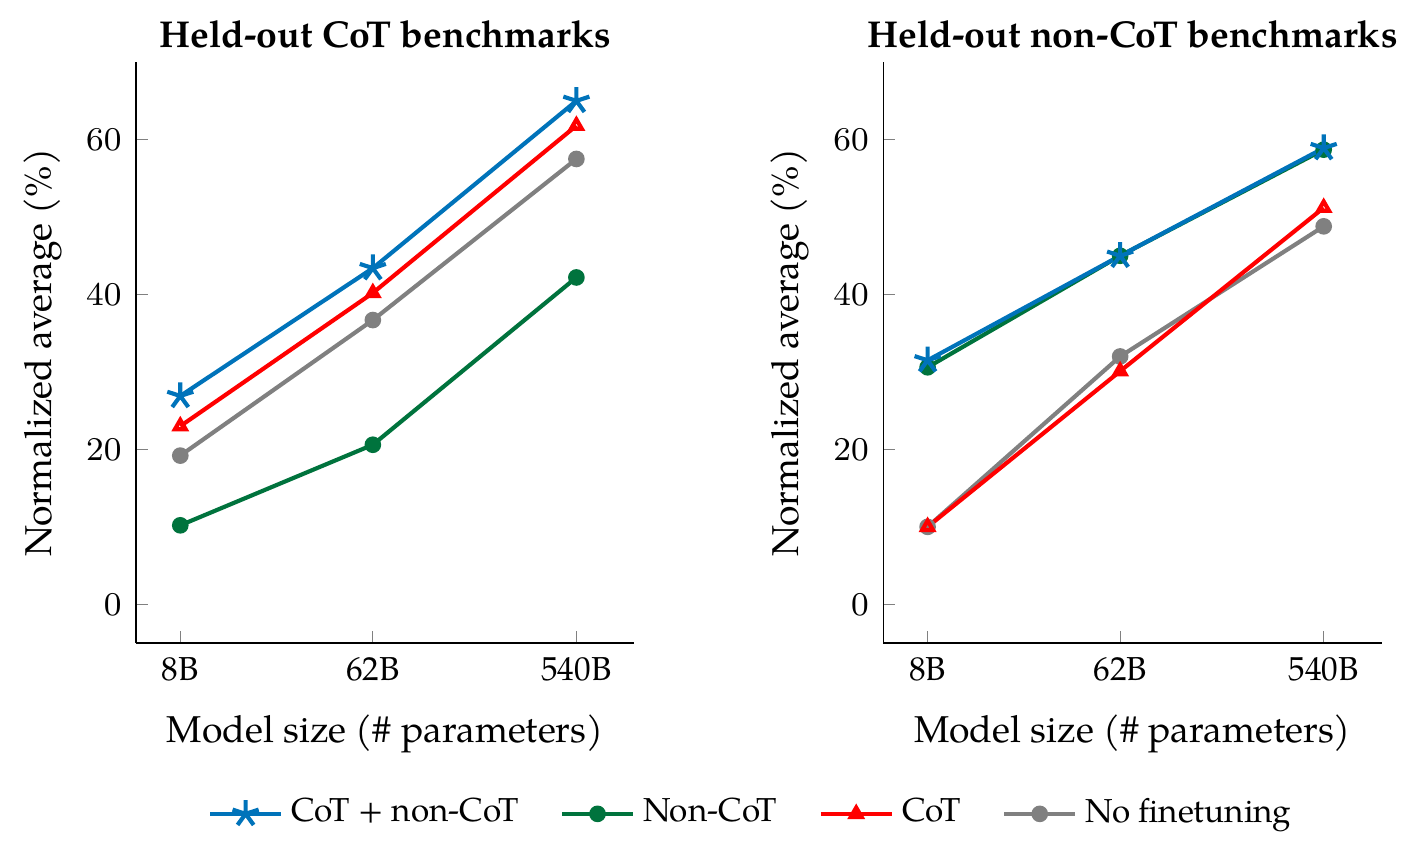
這張圖是整篇最值得看的地方,看左圖的綠線。只用直接給答案的資料微調,模型在需要思維鏈的評測上,反而比完全不微調還差;540B 從 57 左右掉到 42 左右。
這和之前的研究看起來矛盾,FLAN、T0 都說指令微調能幫助沒看過的任務。作者的解釋是,以前的評測只看「沒看過的 NLP 任務」,例如拿掉情感分析訓練、再考情感分析;而且以前的模型太小,本來就做不好思維鏈。換句話說,指令微調幫得上忙的,是和微調時同一種提示格式的新任務。微調時只練直接回答,考思維鏈時就吃虧。
解法只要九個 CoT 資料集。藍線把兩種資料一起微調,左圖是四條線裡最高的;右圖裡,藍線和只用非 CoT 資料的綠線幾乎重疊,加進思維鏈資料並沒有拖累直接回答的題目。
這九個資料集還有一個附帶效果。微調時 CoT 資料有一部分不給範例,所以 Flan-PaLM 學會了零樣本的思維鏈,在題目後面加一句「Let's think step by step」,BBH 的分數就會上升;沒微調的 PaLM 加了這句話卻沒有用。Kojima 等人先前的零樣本思維鏈實驗,成功的例子大多用 InstructGPT,作者推測,那是因為 InstructGPT 的微調資料裡本來就有類似思維鏈的東西。
主要成績
把三件事放在一起,得到的是 Flan-PaLM 540B。MMLU 用思維鏈加上自我一致性(多次取樣再投票),達到 75.2%,比 PaLM 的 69.3%、code-davinci-002 的 68.3%、Chinchilla 的 67.6% 都高。多語言的數學題 MGSM 拿到 72.0%,連孟加拉語都有 69.6%;GSM8K 是 83.9%,不過 GSM8K 的訓練集就在微調資料裡。
也有沒贏的地方。BBH 裡只考符號操作的演算法類任務,例如照順序追蹤被打亂的物件、把單字照字母排序,Flan-PaLM 還是輸給 code-davinci-002。TyDiQA 雖然比 PaLM 多了 14.9 個百分點,仍然比不上直接在 TyDiQA 訓練集上微調的 ByT5。
換個模型也行
作者把同一套流程套到不同架構、不同大小、不同預訓練目標的模型上。以下節錄幾列:
| 模型 | 正規化平均 | MMLU 直接 | MMLU CoT | BBH 直接 | BBH CoT |
|---|---|---|---|---|---|
| T5-XL(3B) | −4.1 | 25.7 | 14.5 | 27.4 | 19.2 |
| Flan-T5-XL(3B) | 19.1 | 52.4 | 45.5 | 41.0 | 35.2 |
| T5-XXL(11B) | −2.9 | 25.9 | 18.7 | 29.5 | 19.3 |
| Flan-T5-XXL(11B) | 23.7 | 55.1 | 48.6 | 45.3 | 41.4 |
| PaLM 62B | 28.4 | 55.1 | 49.0 | 37.4 | 43.0 |
| PaLM 540B | 49.1 | 71.3 | 62.9 | 49.1 | 63.7 |
| Flan-PaLM 540B | 58.4 | 73.5 | 70.9 | 57.9 | 66.3 |
整理自原論文 Table 5,節錄部分列與欄。
T5 受益最多。沒微調的 T5(這裡用的是額外以語言模型目標訓練過的 LM-adapted 版本)在這些困難評測上幾乎是亂猜,MMLU 的思維鏈只有 14.5%,比四選一的隨機猜還低,所以正規化平均是負的。微調之後,3B 的 Flan-T5-XL 在 MMLU 拿到 52.4%,比 GPT-3 175B 的 43.9% 還高;11B 的 Flan-T5-XXL 在 BBH 直接回答上,也勝過 PaLM 62B,表上是 45.3 對 37.4。
整篇最強的模型是 Flan-U-PaLM,也就是先用 UL2 目標繼續預訓練 PaLM 540B,再做指令微調。作者的結論是,這兩種方法可以疊加,都不必把模型變大。
比較好用
分數之外,作者也請人比較 PaLM 540B 和 Flan-PaLM 540B 的開放式回答。評測集有 190 題,涵蓋創意、推理、規劃、解釋等類別,有零樣本也有少樣本。結果 Flan-PaLM 有 79% 的時候被偏好;題目加上「讓我們一步一步想」時,偏好差距再拉大約 10%。
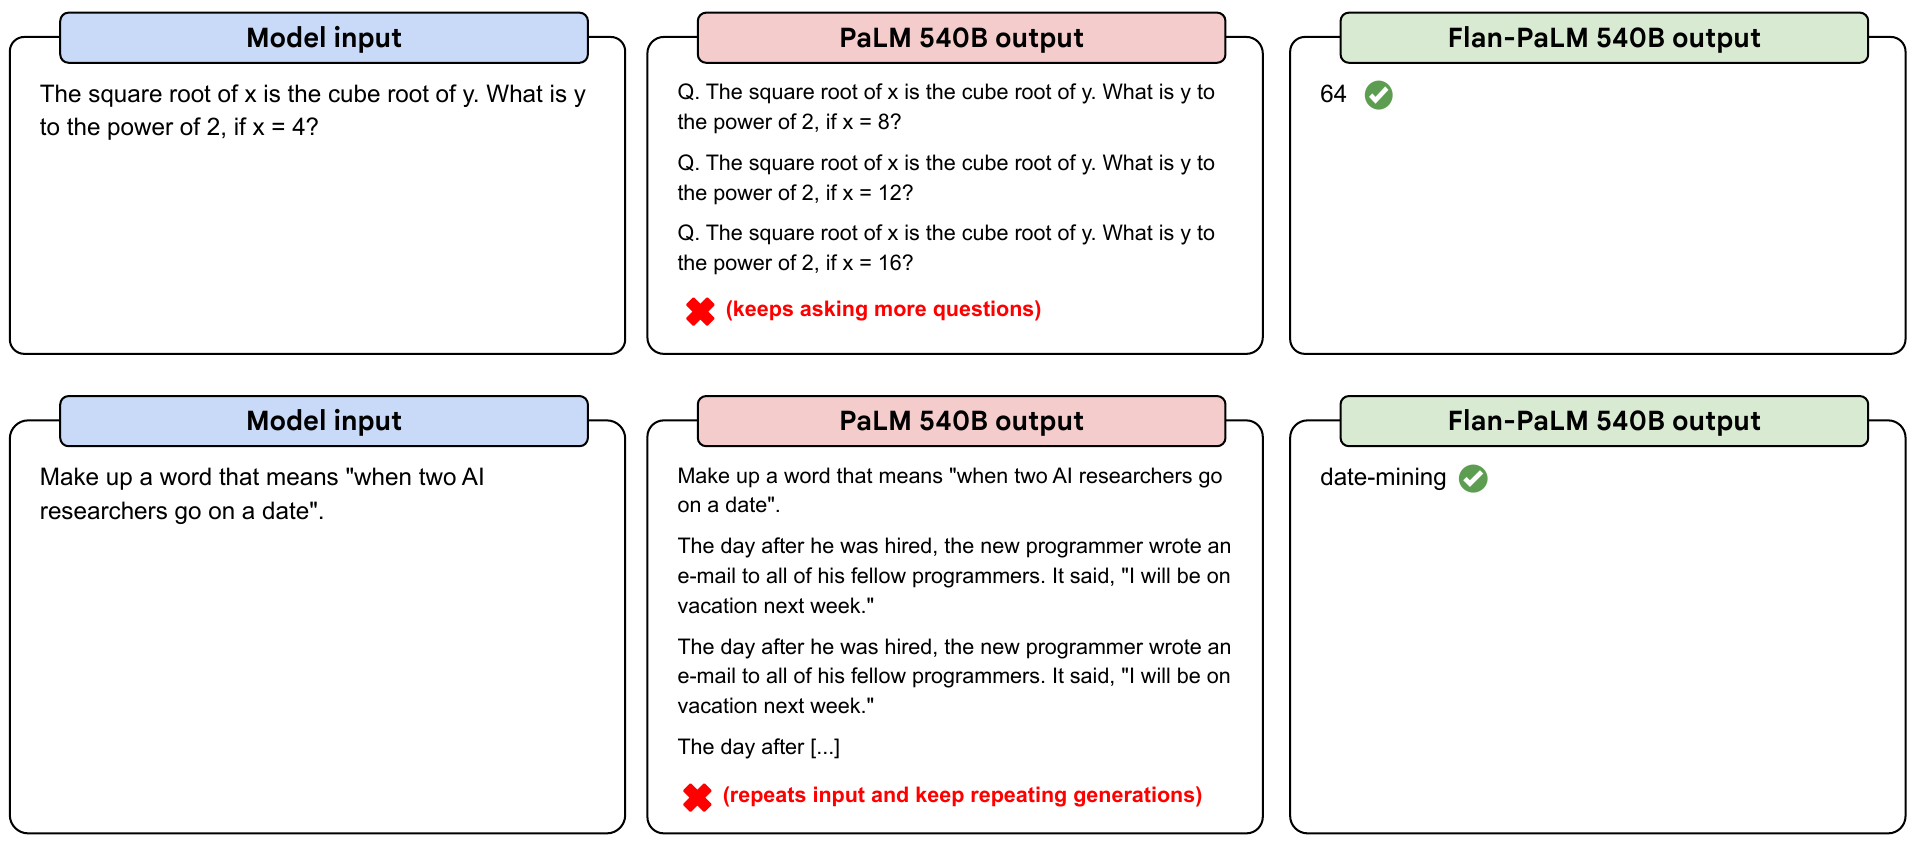
第一題 ,所以 、。PaLM 沒有回答,把這題當成考卷的開頭,一題接一題往下出。第二題它先把題目抄一遍,再把同一段和題目無關的故事重複寫下去。
作者在 PaLM 的零樣本輸出裡看到三種毛病,接著寫相關的文字而不回答、把問題稍微改一下再重複一遍,以及不知道什麼時候該停。他們推測這和預訓練時沒有使用序列結束符號有關。指令微調讓模型學會回答完就停,這一點對沒在寫提示工程的一般使用者特別重要。
後來的事
論文最後一句建議,幾乎所有預訓練語言模型都該做指令微調。後來的發展大致照這句話走,模型發布時同時放出基礎版和指令微調版,幾乎成了慣例。四個月後的 LLaMA 也照這篇的流程,對 65B 做了一次簡單的指令微調,MMLU 從 63.4% 升到 68.9%。
Google 在 2023 年初把整套任務與模板整理成 The Flan Collection 公開。不過幾個月後,風向也有了變化。LIMA 只用 1,000 筆精挑細選的問答微調 LLaMA 65B,就能寫出相當不錯的回答;大家開始更在意指令資料的品質和來源,例如真實使用者的提問,而不只是任務的數量。
結論
這篇把指令微調的三個方向一起推開。任務加到 1,836 種,收穫主要集中在前 282 種;模型放大十倍,收穫依然明顯;思維鏈資料只要九個資料集,就能補回直接回答訓練造成的推理退步。代價只有預訓練算力的 0.2% 到 1.6%。
最實用的提醒是,微調資料長什麼樣,模型就擅長什麼格式。只用直接回答的資料微調,540B 在需要思維鏈的評測上,正規化平均反而從不微調時的約 57 掉到約 42;加進九個思維鏈資料集,才不會吃這個虧。
對多數人來說,這篇留下來的是那幾個 Flan-T5 權重。PaLM 一直沒有公開,Flan-PaLM 的分數再漂亮,也只能在論文裡看看。