原始论文
Sophia: A Scalable Stochastic Second-order Optimizer for Language Model Pre-training
- 发表版本
- ICLR 2024会议
- arXiv 首次提交
- arXiv:2305.14342
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizerssophia2023,
  title = {{Sophia: A Scalable Stochastic Second-order Optimizer for Language Model Pre-training}},
  author = {Hong Liu and Zhiyuan Li and David Hall and Percy Liang and Tengyu Ma},
  year = {2023},
  eprint = {2305.14342},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.14342}
}
说一个优化器「比 Adam 快两倍」,到底要怎么测?
Stanford 的 Hong Liu、Zhiyuan Li、David Hall、Percy Liang 与 Tengyu Ma 在这篇论文里花了一小节回答这件事。基线方法要在预定的总步数 下把学习率和调度调到最好;新方法只跑 步,最终损失必须小于或等于基线,不能「差不多」。他们还特别提醒,cosine 调度会随总步数伸缩,拿 步那次训练的中途检查点来比,结论会有偏差。
在这个标准下,他们宣称 Sophia 在 GPT-2 上用一半的步数,就达到 AdamW 的验证损失,每一步的时间与显存几乎不变。
这篇笔记先看 Sophia 怎么做,再看这个「两倍」后来被别人测成了多少。
定义问题
Adam 只看梯度大小
Adam 的分母是梯度平方移动平均的平方根。梯度方向稳定时, 大约是 ,每个坐标走的步长都接近 ,和那个方向的地形是陡是平没有关系。
可是语言模型的损失地形,各方向的曲率差别很大。作者测了 1.25 亿参数 GPT-2 的对角 Hessian,正值元素的大小分布非常分散。
一个二维的例子
作者用一个二维可分的函数来说明,,其中 很陡、 很平。
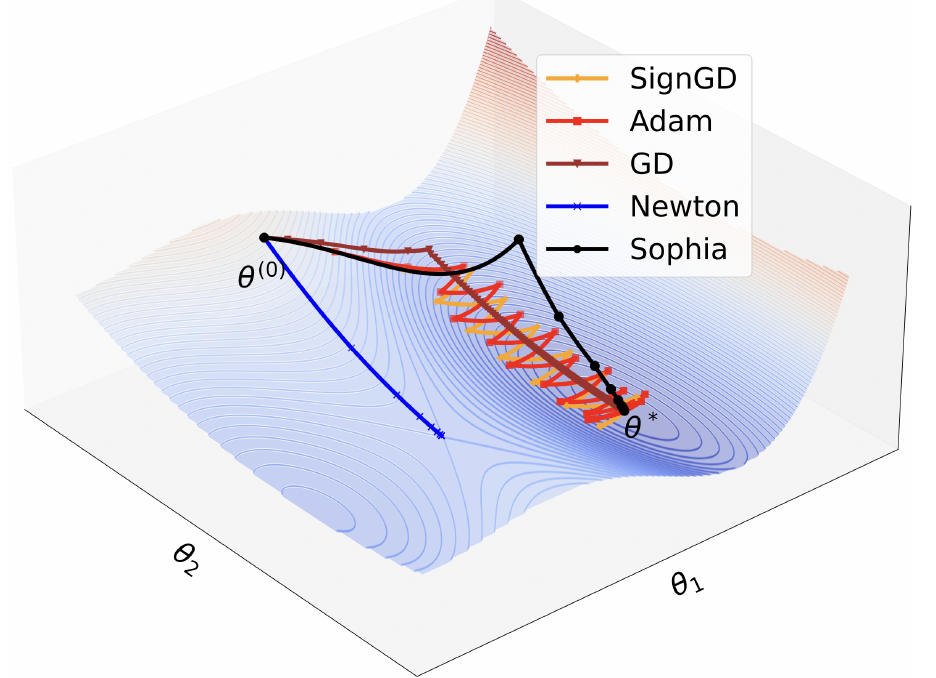
图上的每条线都从左上的 出发,目标是右下的 。
GD 的学习率受限于最陡的方向,最大只能取到陡方向曲率的倒数左右,否则就发散;这个学习率对平坦方向来说太小,所以深红线沿 走得很慢。
Adam 的简化版是 SignGD,两个方向每步都走 。在平坦方向,同样的步长只能让损失降一点点;在陡的方向,三步就到谷底,接着开始来回弹。想让它停下来, 得衰减到 0,平坦方向就更慢了。图上红色的 Adam 和橙色的 SignGD 几乎重叠,都在谷里锯齿状前进。
按凸优化的教科书,最理想的预条件是 Hessian。在这个可分的例子里,Newton 法就是每个方向的梯度除以该方向的曲率,陡的方向步子自动缩小,平的方向自动放大。问题是 有一段曲率是负的,Newton 法在那里会往极大值或鞍点走,蓝线就收敛到了一个鞍点。真实模型的曲率还会沿着训练轨迹快速变化,二阶信息不一定可靠。
二阶方法太贵
已有的二阶方法还有成本问题。K-FAC 这类块对角近似对大型语言模型来说太贵;AdaHessian 也用对角 Hessian 作为预条件,但几乎每一步都要估计,每步成本超过两次梯度计算。作者猜测,它们之所以必须频繁估计,是因为缺少一个能挡住错误估计的保护机制。
所以这篇要找的预条件得同时做到三件事,像 Newton 那样按曲率缩放,在负曲率与估错时不出事,平均每步只多一点点计算。
解决问题
更新式
Sophia 的全名是 Second-order Clipped Stochastic Optimization。Algorithm 3 写成:
分子是梯度的移动平均,和 Adam 一样。分母换成对角 Hessian 的估计 ,每 步才估一次,也做移动平均去噪。 是 decoupled weight decay。所有运算都逐坐标进行, 把每个元素截断在 。
括号里的 是一个打了折扣的 Newton 步。作者把式子改写成
右边比较好读。先算 Newton 步 ,把每个坐标截断在 ,再乘上 。所以 只决定「多少比例的坐标会被截断」,被截断的坐标,最后的步长都是 。
走一遍裁剪
拿 Sophia-H 的默认值 ,假设某几个坐标的动量都是 ,只有曲率估计 不同:
| 曲率 | 实际步长 | |
|---|---|---|
| 20 | 0.01 | |
| 1 | 0.2 | |
| 0.2 | 1 | |
| 0.02 | 10 | (被截断) |
| −3 | (被截断) |
本文整理,按原论文 Eq. (6) 计算。
曲率大的坐标,步长自动缩成 Newton 式的小步;曲率小的坐标本来会得到很大的 Newton 步,被截断在 。最后一行是 Hutchinson 估计器常见的负值, 取到 ,比值暴涨,被截断成 ,也就是带动量的 SignSGD。曲率估得太小时同理。
作者把这种行为描述成「把带动量的 SignSGD 当作后备」。不管 Hessian 估得多离谱,每个坐标每步最多移动 ,这是整个方法敢「每 10 步才估一次 Hessian」的前提。
那 怎么选?作者的建议是在小模型上调,让「没有被截断」的坐标比例落在 10% 到 50%,太多或太少就把 乘 0.5 或 2 重来;同架构、同数据的不同大小模型可以共用。实际训练时,被截断的坐标比例会爬到 60% 左右,也就是大多数坐标其实走的是 sign 步。论文最后用 (Sophia-H)与 (Sophia-G)。
两种对角 Hessian 估计
Hutchinson 估计器(Sophia-H)。抽一个标准正态向量 ,计算
它的期望值正好是 Hessian 的对角。只需要一个 Hessian-vector product,也就是对 再做一次反向传播,不用把 Hessian 组装出来。这个估计是无偏的,但单次估计可能是负的。
Gauss-Newton-Bartlett 估计器(Sophia-G)。交叉熵损失的 Hessian 可以拆成 Gauss-Newton 项 与一个通常较小的剩余项,作者只估计前者。这里 是 logits 对参数的 Jacobian, 是损失对 logits 的二阶导数。对交叉熵来说, 只跟模型输出的概率 有关,跟真实标签无关。再用统计学里的 Bartlett 恒等式, 可以写成「从模型自己的分布抽一个标签,算梯度外积」的期望。
实现只要四步:
- 拿一批输入算 logits;
- 从模型自己的 softmax 抽标签 ;
- 用这些假标签算 mini-batch 损失的梯度 ;
- 返回 , 是批量大小。
乘上 的原因是自动微分只给出平均梯度;Bartlett 第一恒等式说抽样标签下的单个样本梯度期望为 0,平均梯度的平方乘上 ,期望值刚好等于逐样本梯度平方的平均。
这个估计永远非负,所以预条件后的方向一定是下降方向。它看起来很像 Adam 的二阶矩,都是梯度的平方,差别有两处。Adam 用的是真实标签的梯度,Sophia-G 用的是从模型抽样的标签;Adam 对分母开根号,Sophia 直接除。前者在文献里叫 empirical Fisher,作者的消融显示它不如 GNB。
官方代码只实现了 Sophia-G。作者在 GitHub 上也回复过,Sophia-G 的估计不会是负的,负曲率那套保护是为 Sophia-H 准备的。
每 10 步估一次
,而且只用一部分样本估计 Hessian。GPT-2 的批量是 480 条,Sophia-H 只拿其中 32 条,Sophia-G 拿 240 条。在 A100 上测到的每步时间如下:
| 方法 | 355M | 770M |
|---|---|---|
| AdamW | 1.77 s | 3.25 s |
| Sophia-H | 1.88 s | 3.40 s |
| Sophia-G | 1.86 s | 3.42 s |
整理自原论文 Table 1;每步时间已摊入每 10 步一次的 Hessian 估计。
显存方面,Sophia 只存 与 两份状态,和 AdamW 一样。
理论保证在什么设定下
第 4 节证明了一个简化版本的收敛速度。函数必须严格凸,Hessian 在一定半径内变化有限,更新是确定性的;而且分析用的是完整的 Hessian,先转到它的特征基底,在那里逐坐标裁剪,再转回来。在这些条件下,达到误差 所需的步数与条件数(最大曲率除以最小曲率)无关;SignGD 即使在简单的二次函数上,速率也会受条件数影响。
理论为什么不用对角 Hessian?作者的说明是,对一般的函数,曲率方向不一定和坐标轴对齐,对角预条件不一定有效。这句话刚好说中了 Sophia 实现版的弱点。真实模型里斜着的山谷,对角 Hessian 一样转不正,要靠 Shampoo 或 SOAP 那样的矩阵预条件。
讨论
实验设置
GPT-2 有 1.25 亿、3.55 亿、7.7 亿三个尺寸,用 nanoGPT 的代码在 OpenWebText 上训练(训练集约 90 亿 token),上下文 1024,批量 480;另有 3,000 万参数的模型拿来调参。更大的是 GPT NeoX 架构的 15 亿与 66 亿,在 Pile 上用 Levanter 训练,上下文 2048。
基线是 AdamW(,weight decay 0.1)、Lion 与 AdaHessian。除了峰值学习率,所有超参数都在 3,000 万参数的模型上 grid search 后固定。1.25 亿与 3.55 亿的峰值学习率另外做了 grid search;更大的模型则往上找到「再大 1.25 倍就会炸掉」的那个学习率。共用设置是 cosine 衰减到峰值的 0.05 倍、2,000 步预热、梯度范数裁剪 1.0、bf16。Sophia 用 、、weight decay 0.2。
有一个不对称的细节。AdamW 与 Lion 在 3.55 亿以上的模型上不稳定,作者给它们加了一个常见的技巧,把注意力分数除以层的索引;Sophia 不用这个技巧。
两倍从哪里来
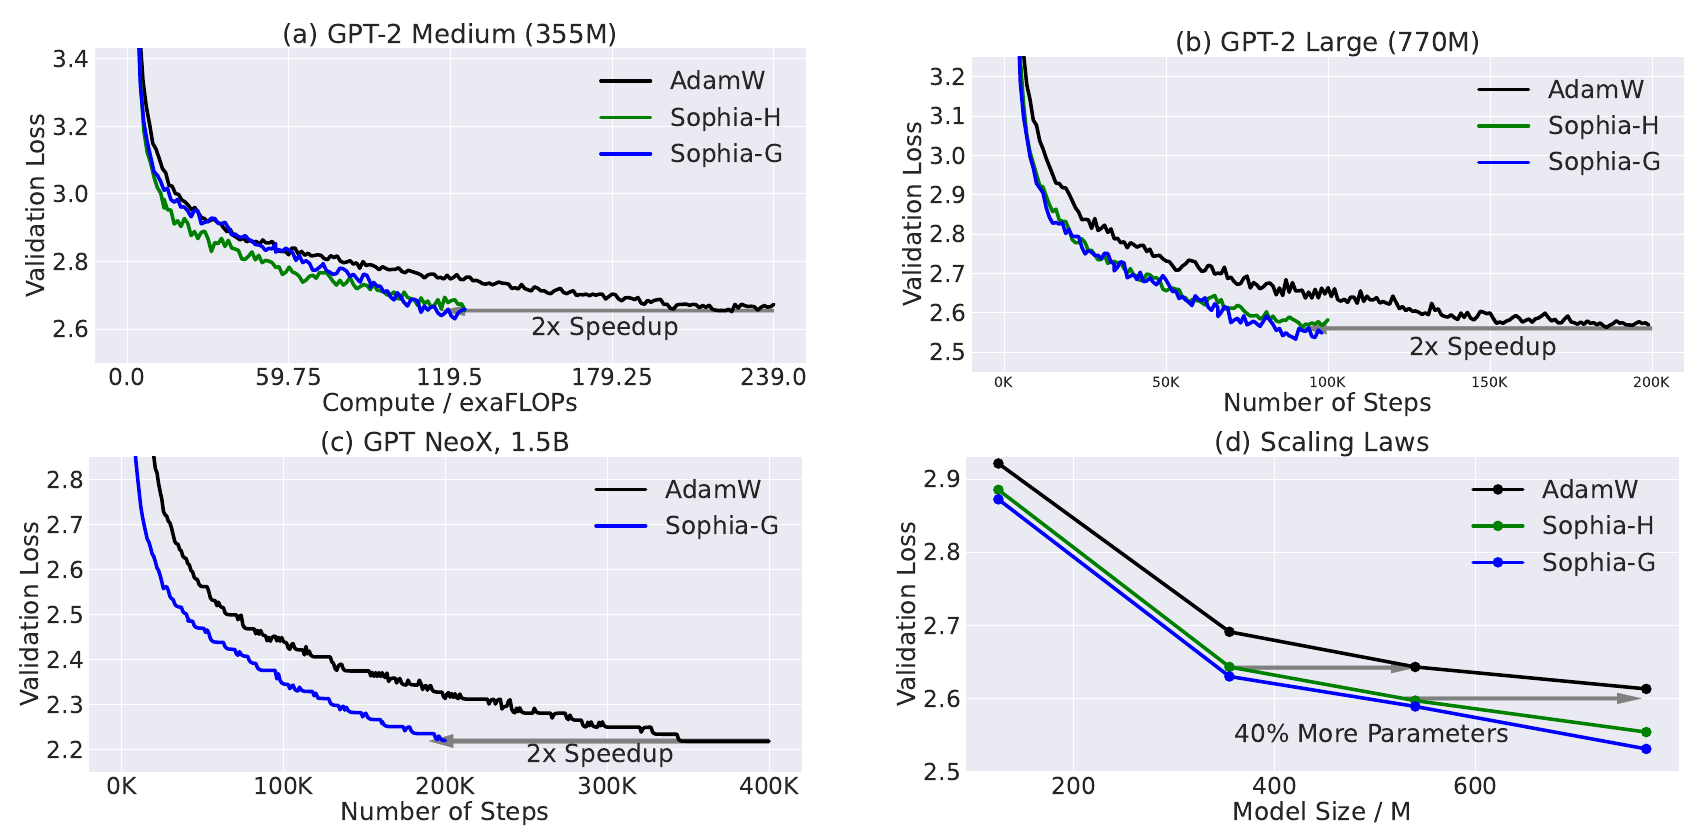
前三张图的读法一样。黑线是 AdamW 跑完整预算,蓝、绿线是 Sophia 只跑一半;灰色箭头从 Sophia 的终点水平拉到 AdamW 的终点,标着「2x Speedup」。图 (d) 换成看模型大小:同样训练 10 万步,Sophia 的 5.4 亿模型比 AdamW 的 7.7 亿模型损失还低,换句话说,AdamW 要多用约 40% 的参数才追得上。
同样步数下的最终损失:
| 模型 | AdamW | Sophia-H | Sophia-G |
|---|---|---|---|
| GPT-2 125M | 2.921 | 2.901 | 2.875 |
| GPT-2 355M | 2.691 | 2.645 | 2.627 |
| GPT-2 770M | 2.613 | 2.554 | 2.524 |
| NeoX 1.5B | 2.250 | – | 2.218 |
| NeoX 6.6B | 1.992 | – | 1.969 |
整理自原论文 Figure 5 图注;GPT-2 为 10 万步,NeoX 1.5B 为 20 万步。
论文说在这个区间,验证损失低 0.05 大约等于省一半步数。770M 的差距是 0.06 到 0.09,对得上;125M 只差 0.02 到 0.05。66 亿参数只有同步数的比较,没有做「一半步数」的对照。下游任务只测了 SuperGLUE 的四个子任务(2-shot),Sophia 跑 20 万步和 AdamW 跑 40 万步的准确率相当。
稳定性与超参数
在 1.25 亿参数的 GPT-2 上,三者都用 1.0 的梯度范数裁剪;AdamW 和 Lion 有超过 10% 的步会触发裁剪,Sophia-H 很少触发。拿掉注意力缩放技巧后,AdamW 在 3.55 亿模型上最大只能用 1.5e-4 的学习率,3e-4 就炸掉,Lion 的上限也从 6e-5 降到 3e-5;Sophia-H 本来就不需要这个技巧。在 3,000 万参数模型上扫 与 的九种组合,损失都在 3.341 到 3.356 之间。
消融
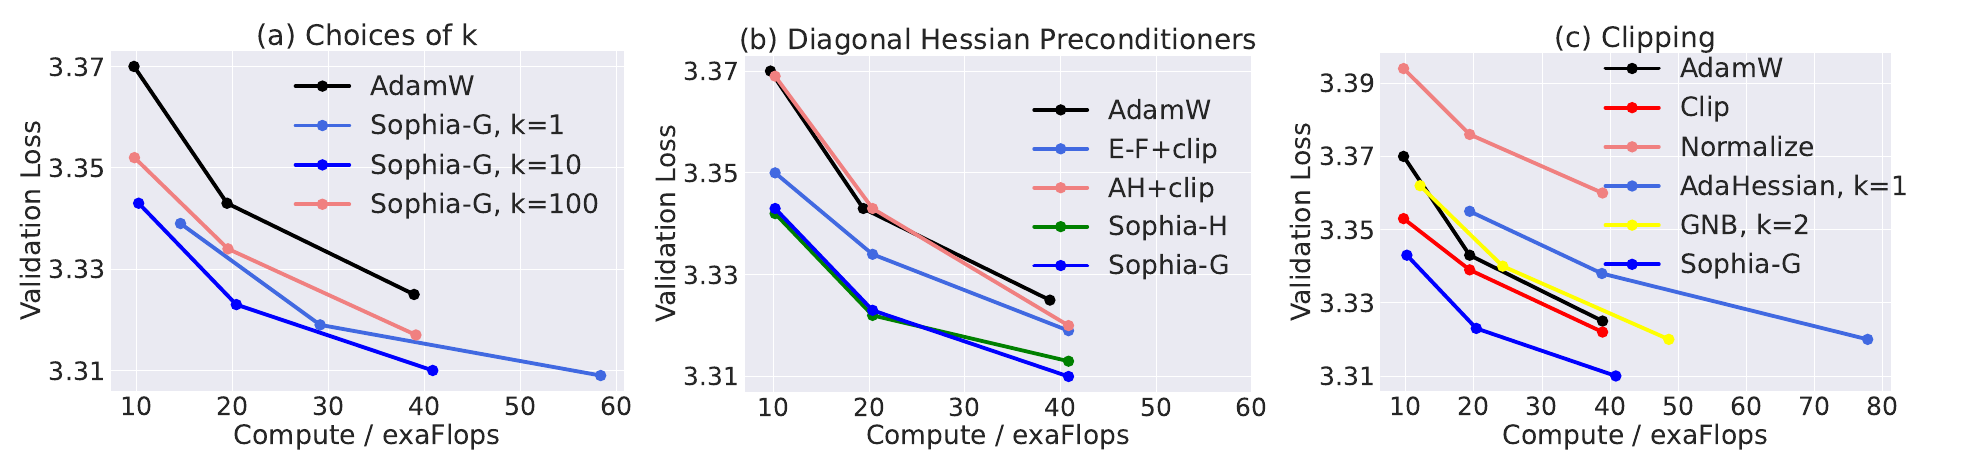
三张图都是越往左下越好,同样的计算量下损失越低。
(a) 每步都估计 Hessian()时,同样步数下的损失最低,但开销多 50%,按计算量算反而输给 ; 仍赢 AdamW,但不如 。
(b) 同样加上裁剪,GNB 胜过 empirical Fisher,Sophia-H 胜过 AdaHessian。作者推测 Sophia-H 对 Hessian 估计做移动平均,AdaHessian 对 Hessian 估计的平方做移动平均,前者去噪效果较好。
(c) 是最值得细看的一张。红线「Clip」完全不用预条件,只对动量逐元素裁剪;作者自己说这「essentially the same as sign momentum, or Lion with a single β」。这条线已经赢过黑色的 AdamW。不裁剪的话,AdaHessian 在 、GNB 在 就发散,只好每一两步估计一次。蓝色的 Sophia-G 再往下一截。
换句话说,Sophia 的增益有一部分来自 sign momentum 本身,Hessian 在上面再加一层;裁剪是让 Hessian 能少估几次的那道保险。
后来被别人测成了多少
论文放上 arXiv 后的几个月内,官方 repo 陆续出现复现不了的 issue。
GitHub 上的复现。 2023 年 6 月 28 日,Aaron Defazio 在官方 repo 开了一个 issue。他在 GPT-2 small 上用 16 张 V100、fp32 训练,并用 Sophia 的训练脚本同时跑 AdamW,排除脚本差异;两者各自扫学习率,最佳都是 1e-3。结果 Sophia-G 2.876、AdamW 2.869,他倾向认为两者的最终损失差不多。第一作者回复,fp32 本身就会让语言模型的损失比 bf16 低,并给了建议设置,他自己的 fp32 Sophia 跑到 2.846;Defazio 照着重跑仍没有复现,便关闭了 issue。11 月另一个 issue 照 README 复现 125M,AdamW 跑 20 万步得到 2.863,比 Sophia-G 跑 10 万步的 2.897 还低;作者在 2024 年 1 月更新了配置文件。
No Train No Gain(Kaddour 等人,2023)。 这篇把 Sophia、Lion 和几种「节省训练」的方法放到 BERT 与 T5 的预训练上,在固定 6、12、24 小时的预算下比较,基线是学习率完全衰减的 AdamW。直接把 Sophia 换进 FP16 的训练流程会出现 NaN,改成 BF16 才稳定;T5 还得加上 RMS 缩放才收敛。24 小时的 BERT,GLUE 平均是 AdamW 77.9、Sophia 72.3;T5 在 SNI 上是 39.5 对 34.1。即使不把 Hessian 估计的时间算进去、跑一样多的步数,作者「still do not observe any speedup」。
Zhao 等人(2024)。 在自回归语言模型上比较 SGD、Adafactor、Adam、Lion、Sophia,结论是除了 SGD 以外都差不多。附录里他们把 Sophia 和 Signum(带动量的 sign 更新,等于 Sophia 把 设成 0)对比,Sophia 没有赢。
Fantastic Pretraining Optimizers(Wen 等人,2025)。 作者群里的 David Hall、Tengyu Ma、Percy Liang 也是 Sophia 的作者。他们在 1.3 亿到 5.2 亿参数上重新调参比较,Sophia 在小计算量时输给 AdamW,模型或数据变大后才稍微领先,0.5B 以下没有显著提速。他们也交代了原因。Sophia 论文的流程「largely follows the correct procedure」,基线的峰值学习率确实调过;但当时代码的 data loader 没有完全打乱数据,在那份代码里 AdamW 的最佳学习率被压得很小。数据一旦完全打乱,AdamW 就能用大得多的学习率。
结论
Sophia 用每 10 步估计一次的对角 Hessian 当分母,再用逐坐标裁剪把每一步的移动上限锁在 。估错、负曲率或曲率太小的坐标,自动退回带动量的 sign 更新。在论文的设置里,GPT-2 与 15 亿参数的 NeoX 都用一半步数追上了 AdamW,每步只慢约 5%。
这篇留给实践者最有用的,反而是那条测量规则。下次看到「快两倍」,先确认基线的学习率是不是在同样的总步数、同样完全打乱的数据下调到最好,再看新方法是不是只比较最终检查点。用 Sophia 的话,盯着被裁剪坐标的比例来调 ,混合精度选 bf16。
(论文自己的消融里,把 Hessian 拿掉、只留裁剪,就已经赢了 AdamW;后来 Zhao 等人的比较里,Sophia 也确实没有胜过 Signum。)