原始论文
SOAP: Improving and Stabilizing Shampoo using Adam
- 发表版本
- ICLR 2025会议
- arXiv 首次提交
- arXiv:2409.11321
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizerssoap2024,
  title = {{SOAP: Improving and Stabilizing Shampoo using Adam}},
  author = {Nikhil Vyas and Depen Morwani and Rosie Zhao and Mujin Kwun and Itai Shapira and David Brandfonbrener and Lucas Janson and Sham Kakade},
  year = {2024},
  eprint = {2409.11321},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2409.11321}
}
用 Shampoo 的人都得决定一件事,最贵的那一步要多久做一次?
Shampoo 每一步都会更新两个统计矩阵 、,但真正拿来乘梯度的是它们的矩阵次方,得做特征分解或迭代求根。这一步太贵,实现上都是每隔 步才算一次,中间沿用旧的。
Harvard 的 Nikhil Vyas、Depen Morwani 等人把这个 拉开来测。在一个 3.6 亿参数的语言模型上, 时 Shampoo 的最终测试损失约 2.824, 变成约 2.868, 约 2.932;同一设置下的 AdamW 约 2.943。为了省计算而拉长间隔,Shampoo 相对 AdamW 的优势几乎全部吐了回去。
2024 年 8 月,Shampoo 才刚拿下 AlgoPerf 外部调参组的冠军。这篇论文想让它便宜一点,也好调一点。
定义问题
Shampoo 为一个 的权重矩阵维护左右两个预条件:
原版的指数是 ,后来的实现大多改成 。真正能用的 Shampoo(例如 Meta 的 DistributedShampoo)除了学习率、动量之外,还要设置统计量的移动平均系数、矩阵求根用的 、一维与二维参数各自的指数、grafting 用哪个优化器决定步长,以及预条件多久更新一次。
问题有两个。第一,频率一拉长效果就变差,因为在两次特征分解之间,整个预条件是冻结的,梯度的尺度怎么变它都不知道。第二,超参数太多。
作者的切入点是先搞懂 Shampoo 在特征基底里到底做了什么。如果能把它拆成「贵的部分」和「便宜的部分」,也许就能让贵的慢慢算,便宜的每一步都更新。
解决问题
Shampoo 是转过去的 Adafactor
先把 Shampoo 理想化。用 次方;、 取整个数据集上的期望 、;再乘上一个以 修正的标量。更新就是
把 和 做特征分解,,,特征值分别是 与 。代进去:
这行式子可以分三步读。先把梯度转到特征基底,;在这个坐标系里,第 个元素乘上 ;最后转回原来的坐标。
中间那一步是逐元素的缩放,而且缩放系数是「第 行的量」乘「第 列的量」,秩为 1。这正是 Adafactor 的做法。Adafactor 为了省显存,不存每个元素的二阶矩,只存每一行的总和 和每一列的总和 ,再用 还原。
如果在转过去的坐标里跑 Adafactor,行总和是多少?令 、 是 、 的第 、 个列向量,
第二个等号用到 是一组正交基。同理 ,。Adafactor 对 的缩放是 ,和上面的 Shampoo 一模一样。
这就是论文的 Claim 1, 次方的 Shampoo,等于在 Shampoo 预条件的特征基底里跑 Adafactor。 贵的部分是找基底(特征分解),便宜的部分是在基底里逐坐标缩放。
从 Adafactor 换成 Adam
有了这个视角,Shampoo 频率问题的病灶就看得出来了。实践中每 步才重算一次,等于把「基底」和「缩放」一起冻结;可是缩放只是几个逐元素的移动平均,每一步更新都很便宜。基底可以慢慢换,缩放没有理由跟着等。
既然要每一步更新缩放,作者干脆把 Adafactor 换成 Adam,用完整的逐元素二阶矩,不做秩 1 分解。算法(Algorithm 3)如下, 是逐元素乘法:
每 步才更新一次基底,用的是一步幂迭代加 QR 分解:, 是 或 , 是上一次的基底。只有第一次用完整的特征分解。
有几个细节值得停下来看。
动量 存在原来的坐标里,每一步再投影过去。因为基底每 步会换,动量如果存在旧坐标里,换基底的那一刻就对不上了。二阶矩 则直接存在转过去的坐标里,换基底时不旋转;摘要把这个基底形容为「slowly changing」。官方代码在换基底时会按特征值大小重新排列 的顺序,让同一个方向对应到同一格。
一维参数(偏置、LayerNorm 的权重)直接跑 AdamW。第一层 embedding 和最后的输出层有一维是词表大小,存一个那么大的特征向量矩阵太贵,那一边的 就固定成单位矩阵。两边都是单位矩阵时,SOAP 就退回 Adam,所以论文说 SOAP 是「在旋转过的空间里跑 Adam」。
少掉的超参数
SOAP 的名字是 ShampoO with Adam in the Preconditioner's eigenbasis。和 AdamW 相比,它只多一个超参数,就是更新基底的频率 。和 Shampoo 相比,下面这些都不需要了:
- 矩阵次方的指数,因为缩放交给了 Adam 的 ;
- 求根时加在特征值上的 ,改用 Adam 本身的 ;
- grafting,Adam 在旋转空间里逐坐标决定步长,不必再向另一个优化器借;
- 、 的移动平均系数,直接共用 Adam 的 。
代价
显存占用和 DistributedShampoo 一样。一个 的层要存 、、、 四个方阵,加上梯度、、,共 ;AdamW 只要 。
Shampoo 每一步是左右各乘一次预条件;SOAP 要先投影过去、再投影回来,多了一轮左右矩阵乘法,所以单步计算量比 Shampoo 略高。换来的是可以把频率拉长。
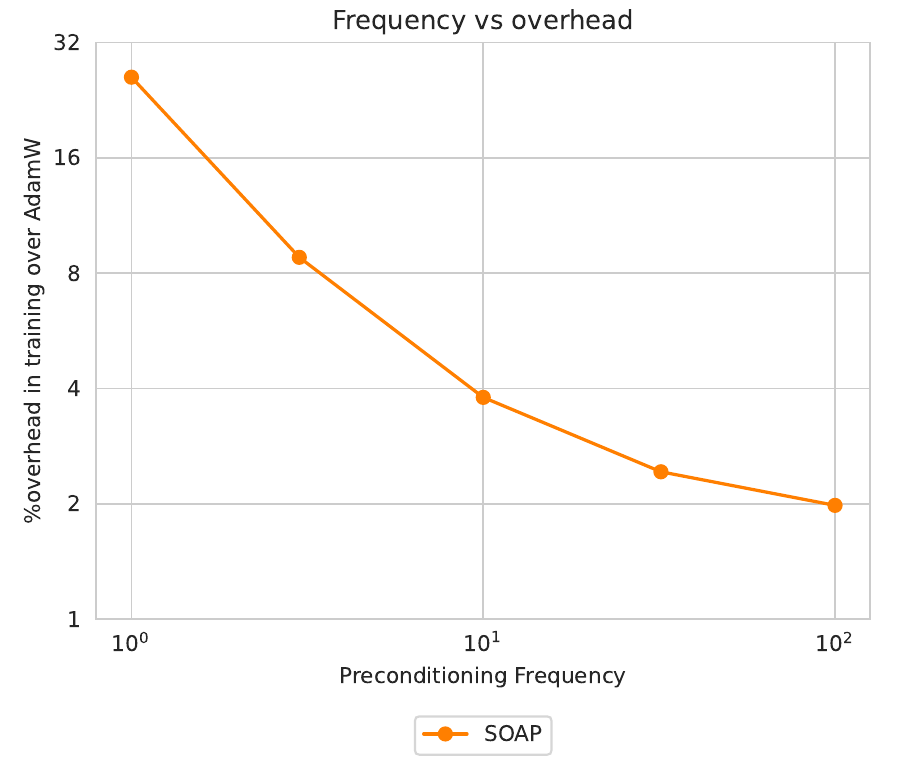
每一步都换基底时,训练时间多出约 27%; 时约 3.7%, 约 2%。曲线不会降到 0,因为不管换不换基底,每一步都要在 fp32 下更新 、 并做两次投影。这组数字是在单张 H100 上、用梯度累积凑出大批量测得的。
讨论
实验设置
实验都是语言模型预训练。数据是 C4,用 T5 的 tokenizer;模型以 OLMo 的代码为基础,decoder-only,有 2.1 亿、3.6 亿、6.6 亿三个尺寸(不含 embedding),宽度 1024、1024、1408,深度 12、24、24,用了 RoPE 与 QK LayerNorm,bf16 混合精度。序列长 1024,每批约 200 万个 token;训练量取约 20 倍参数量的 token 数,360m 跑 3,200 步,660m 跑 6,400 步。
三个优化器都先扫学习率。AdamW 在 360m 上另外扫了 、;Shampoo 用 DistributedShampoo,另外扫了 、统计量的移动平均系数与四组指数,这些扫描带来的损失改善都小于 0.004。SOAP 只扫学习率。共用设置是 、decoupled weight decay 、z-loss 、预热后 cosine 衰减到峰值的 0.1 倍。
「快多少」怎么算,也要交代清楚。cosine 调度依赖总步数,拿同一次训练的中途检查点来比并不公平。作者把 SOAP 另外跑了 0.5、0.625、0.75、0.875 倍长度的完整训练,用 拟合最终损失与步数的关系,再找它在哪个长度追上 AdamW 和 Shampoo 的最终损失。
主结果
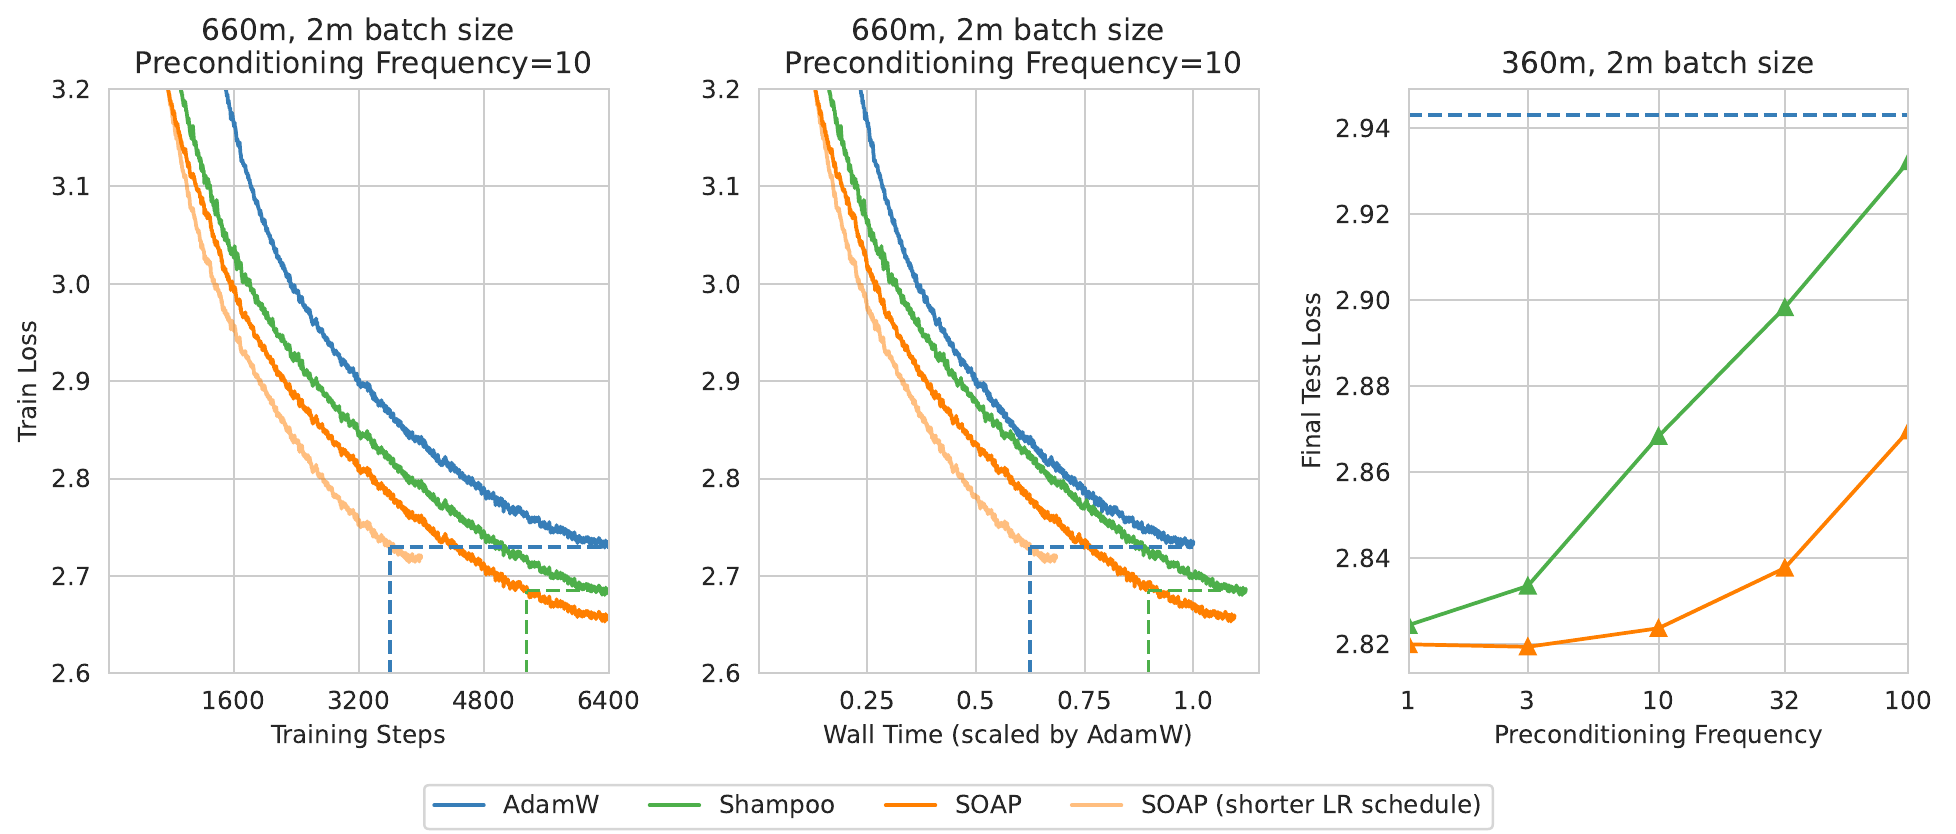
先看左图。蓝、绿、橙三条是同样跑 6,400 步的 AdamW、Shampoo、SOAP,到终点时 SOAP 最低。浅橙色那条是缩短调度的 SOAP,虚线标出它在约 3,600 步就追上了 AdamW 的终点。中图把横轴换成墙钟时间,三条线的间距缩小了一点,这是 SOAP 和 Shampoo 每一步都比 AdamW 贵的结果。
按论文的效率估计,三组设置的数字如下:
| 设置 | 追上 AdamW | 追上 Shampoo |
|---|---|---|
| 360m,200 万 | 0.50/0.52 | 0.75/0.74 |
| 660m,200 万 | 0.565/0.62 | 0.80/0.78 |
| 360m,25.6 万 | 0.72/0.83 | 0.875/0.90 |
整理自原论文 Figure 2 的标注刻度;每格是「步数比/时间比」,第一列的批量单位是 token。对 Shampoo 的时间比为本文换算(Shampoo 全程分别是 AdamW 的 1.06、1.12、1.11 倍)。
大批量时,SOAP 只要 AdamW 50% 到 57% 的步数、约 52% 到 62% 的时间;相对 Shampoo 则省两成多。这就是摘要里「比 AdamW 少 40% 以上迭代、35% 以上墙钟时间,比 Shampoo 少约 20%」的出处。另外把 360m 跑到 100 倍参数量的 token(335 亿),SOAP 相对 AdamW 的优势仍在。
频率的消融
开头的那组数字来自 Figure 1 的右半,这里再放一次。
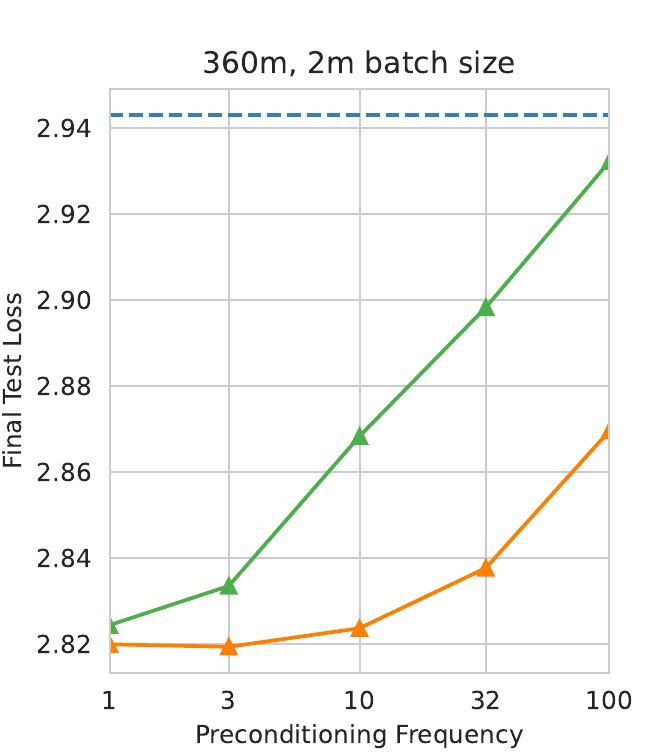
两条线都在 AdamW 的虚线下方,也就是 从 1 到 100,两者都赢 AdamW。 时两者几乎一样(2.820 对 2.824),符合「每步都重算时,两者只差 Adafactor 和 Adam」的预期。之后 Shampoo 一路上升到 2.932,SOAP 在 还是 2.823,到 才升到 2.870。
这组结果支持了作者的解释。SOAP 在 时是 2.823, 比 高约 0.018,仍远低于 Shampoo 同频率的 2.868 与 2.898;真正让 Shampoo 变差的,是缩放也跟着冻结了。
批量大小
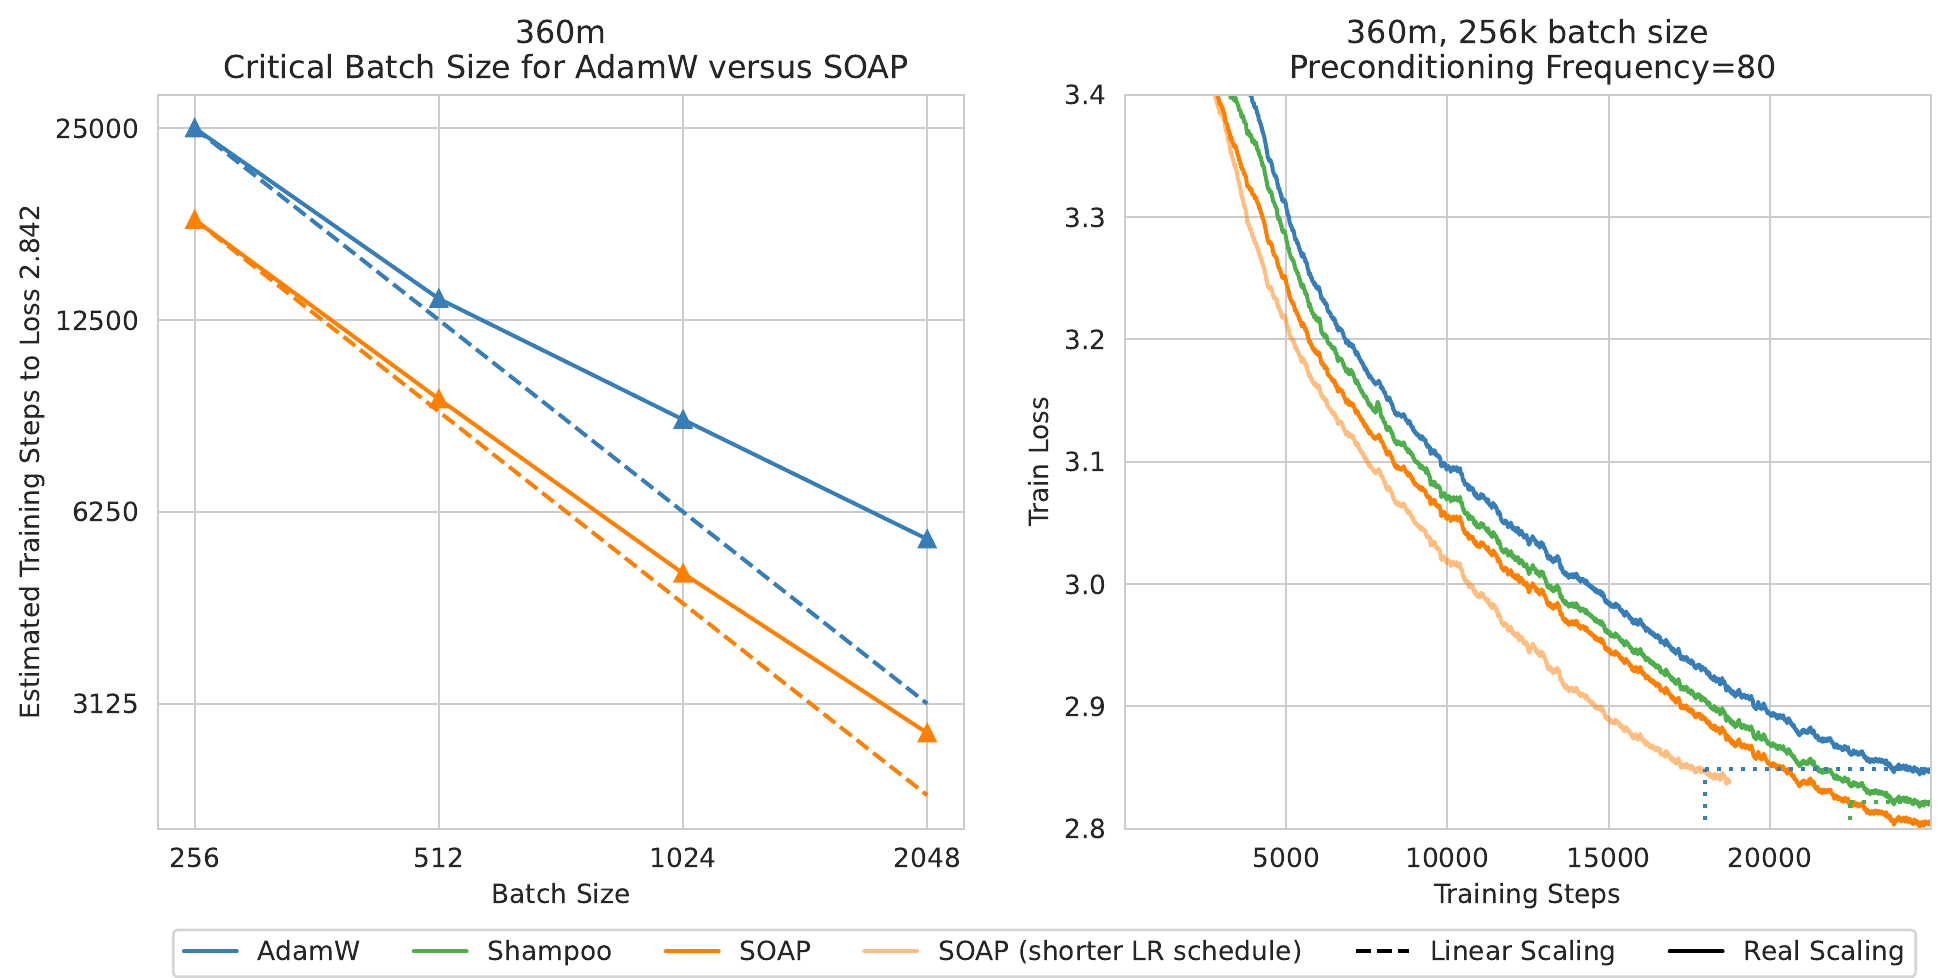
理想情况下,批量大小翻倍,达到同一损失的步数就减半,也就是左图的虚线。实线离虚线越远,说明多出来的批量越浪费。AdamW 的蓝色实线从 512 开始就越偏越远,到 2048 时需要的步数接近理想值的两倍;SOAP 的橙色实线比较贴近自己的虚线,所以作者说 SOAP 的临界批量大小较大。为了公平,批量每缩小 倍,频率就放大 倍,让特征分解的开销比例不变。
右图是最小的 25.6 万批量。SOAP 比 AdamW 少 25% 步数,比 Shampoo 少约 10%。对照上面的表,小批量时的优势明显缩水。作者也说这是初步结果,固定「批量乘频率」未必是最好的取舍;二阶方法在小批量时收益变小,和先前的研究一致。官方 README 也建议尽量用大批量。
省显存的变体与 GaLore
SOAP 比 AdamW 多出 的显存。论文试了两种省法。在旋转后的空间改跑 Adafactor,省下一份 ,损失几乎没变;只旋转较短的那一边,另一边用单位矩阵,损失增加得多一些,但仍和 Shampoo 打平或略好。两招合并后显存是 ,在标准 Transformer 上已经比 AdamW 的 小,仍然赢 AdamW。
GaLore 的全秩版本和 SOAP 很像,主要差在三处。GaLore 的投影来自当前梯度的 SVD,SOAP 用 的移动平均;GaLore 把动量存在投影空间、换基底时不转回,SOAP 存在原空间;GaLore 只投影一边。在 2.1 亿参数的模型上,GaLore 最好的结果是 3.12,赢 AdamW,但输给 Shampoo 的 3.10,所以作者认为 SOAP 的这几处改动都有必要。
这个点子其实早有人写过。Anil 等人在 2020 年 Distributed Shampoo 论文的附录 B,描述了一个在二维层上与 SOAP 本质等价的算法,没有附实验,只说未发表的实验没有看到改善。SOAP 的作者在相关工作里老实交代了这件事,并推测差异来自实现细节。
限制
论文自己列的限制很清楚。模型最大 6.6 亿参数,比当时的大模型小两个数量级;作者假设结论能推广到更大规模,但「remains to be validated」。只测了语言模型。吞吐量是在单张 GPU 上测的,分布式实现的比较留给未来。、 的运算都在 fp32 下进行,而 PyTorch 的 QR 不支持更低的精度,开销的下限暂时压不下去。
一年后的独立检验
2025 年,Stanford 的 Wen、Hall、Ma、Liang 发表〈Fantastic Pretraining Optimizers and Where to Find Them〉,把 AdamW 和十个新优化器放在 1.3 亿到 12 亿参数、1 到 8 倍 Chinchilla 数据量下,每个都仔细调参后再比较。
他们在 3 亿与 5.2 亿参数的模型上,测到 SOAP 比调好的 AdamW 快 1.2 到 1.3 倍;到 12 亿参数时,SOAP 和 Muon 都只剩约 1.1 倍。另一个发现是,数据量与模型的比例拉到 8 倍以上时,SOAP 和 Kron 会超过在少数据时最强的 Muon。他们的 SOAP 实现另外做了权重分块,12 亿参数时动量用 bf16,和原版略有不同。
结论
SOAP 从一个等价关系出发, 次方的 Shampoo,就是在它的特征基底里跑 Adafactor。把贵的基底和便宜的缩放拆开以后,基底可以每 10 步甚至更久才更新,缩放每一步按 Adam 的方式更新;超参数也缩减到只比 AdamW 多一个频率。在 3.6 亿与 6.6 亿参数的语言模型、大批量下,它比 AdamW 少约一半步数、少 38% 到 48% 的墙钟时间。
想试的话,官方的 soap.py 可以直接复制进项目,从 README 的设置开始,、频率 10,先测清楚每一步比 AdamW 慢多少,再决定频率要不要拉长。显存吃紧时,单边旋转和 Adafactor 版本都是论文验证过的退路。
Fantastic 在正文里特别点名,SOAP 是少数为基线单独扫过超参数的论文,报告的提速也最接近他们实测的数字。在优化器论文里,这样的评语不常见。