原始论文
Symbolic Discovery of Optimization Algorithms
- 发表版本
- NeurIPS 2023会议
- arXiv 首次提交
- arXiv:2302.06675
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizerslion2023,
  title = {{Symbolic Discovery of Optimization Algorithms}},
  author = {Xiangning Chen and Chen Liang and Da Huang and Esteban Real and Kaiyuan Wang and Yao Liu and Hieu Pham and Xuanyi Dong and Thang Luong and Cho-Jui Hsieh and Yifeng Lu and Quoc V. Le},
  year = {2023},
  eprint = {2302.06675},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2302.06675}
}
先看一段代码。它把梯度裁剪之后取 arcsin,接着做两次插值,其中一次的系数是 1.109,比 1 还大;算出更新量之后,又把动量变量改成更新量的 cosh。
这段代码不是人写的。Google Brain 的团队从 AdamW 出发,让计算机一句一句地随机修改程序,前后产生了上百万个候选,花掉大约 3,000 个 TPU v2 天,筛出了这一份。把没有作用的语句删掉、化简之后,它只剩四行,名字叫 Lion(EvoLved Sign Momentum)。
这四行只存一份动量,每个参数的更新只看正负号。论文报告它让 ViT 在 ImageNet 上最多高 2%,在 JFT 上省下最多 5 倍的预训练计算,还把 BASIC-L 的零样本 ImageNet 推到 88.3%。
同一篇论文也列出了 Lion 赢不了的地方,而且列得相当诚实。这篇笔记分两半读。前一半看计算机怎么搜出这四行,后一半看「只看正负号」这个设计换来什么、要付出什么,以及它后来在语言模型预训练上的表现。
定义问题
到 2023 年,手工设计的优化器已经很多,大多是自适应方法。可是训练大型语言、视觉、多模态模型时,大家用的还是 AdamW,或是为了省内存改用 Adafactor。
让计算机寻找优化器的尝试也不少,各有卡住的地方。
- 学习如何优化(learning to optimize):训练一个神经网络,让它直接输出参数更新量。这种黑盒优化器只在少数小任务上学过,换到大模型、长训练就泛化不了。
- 在表达式树里搜索:例如 2017 年 Bello 等人用强化学习找出了 PowerSign、AddSign。为了让搜索跑得动,操作数固定、树的大小受限,动量怎么累积、怎么进入更新,这些都改不了。论文特别点出,这恰好是 Lion 最关键的部分。
- AutoML-Zero:连整个机器学习流程都交给搜索,但只在玩具任务上评估。
作者把问题拆成两个。第一,程序空间是无限的,好程序又极度稀疏;他们在便宜的代理任务上随机抽了 200 万个程序,最好的一个还是明显输给 AdamW。第二,搜索只能在小任务上评估,真正要用的任务大一万倍以上,在小任务上赢的程序,到了大任务上常常就不行了。
解决问题
把优化器写成一段程序
搜索的对象是一个 train 函数。输入是权重 w、梯度 g、这一步的学习率 lr,加上两个初始为零的变量 m、v,用来记录历史;输出是这一步要减掉的更新量。AdamW 写成这种形式是这样的(论文的 Program 3,省略偏差修正与 ):
def train(w, g, m, v, lr):
    g2 = square(g)
    m = interp(g, m, 0.9)
    v = interp(g2, v, 0.999)
    sqrt_v = sqrt(v)
    update = m / sqrt_v
    wd = w * 0.01
    update = update + wd
    lr = lr * 0.001
    update = update * lr
    return update, m, v
interp(x, y, a) 等于 (1 - a) * x + a * y,也就是指数移动平均。这个函数签名刻意和 AdamW 一样只留两个额外变量,搜到的算法因此不会比 AdamW 更占内存。
函数体是一串赋值语句,长度和局部变量数都不设上限,每一句调用四十多个常用数学函数之一,大多对应 NumPy 的函数或线性代数运算。条件判断、循环和自定义函数也试过,没有带来更好的结果,就没有放进来。
变异有三种:随机插入一句、删掉一句、改掉某一句的一个参数。参数可以换成已有变量,也可以换成新的常数;已有常数则乘上 , 从标准正态分布中抽取。常数就是算法里的超参数,例如上面的 0.001 是峰值学习率、0.01 是权重衰减。
程序里允许出现对输出没有影响的冗余语句。每次变异只改一句,想做一个需要两三句配合的大改动时,冗余语句可以先当垫脚石。
让搜索跑得动
搜索用的是正则化进化(regularized evolution)。种群维持 1,000 个程序,每一轮随机抽两个,较好的那个复制一份再变异,新程序加进种群,最老的移出。
初始种群全部设成 AdamW,再搭配两种重启。一种是从 AdamW 重新开始,多跑几次来换取探索;另一种是从目前最好的程序重新开始,往下深挖。不同次搜索的成绩方差很大,所以多跑几次是必要的。和花了四倍计算的 AdamW 超参数调整、四倍计算的随机搜索相比,进化搜索都明显胜出。
还有一个省钱的关键,叫抽象执行(abstract execution)。程序真正执行之前,先做三件事:
- 推算每个变量的类型与形状,类型或形状对不上的程序直接丢掉,继续变异,直到生成合法的子程序;
- 从输入到输出算一个函数哈希,语义相同但写法不同的程序查表就好,不必重跑;
- 追踪输出依赖哪些语句,把冗余语句挑出来。
对五次搜索、每次 30 万个程序做统计,到搜索后期约有 70% 的语句是冗余的,删掉后程序平均短了 3 倍;缓存命中率约 89%,搜索成本约降为十分之一。
代理任务都很小。视觉是在 10% 的 ImageNet 上训练一个 3 层、96 维的 ViT,图像缩到 64×64,批量大小(batch size)64、30k 步;语言是在 LM1B 上训练一个 2 层、128 维的 Transformer,20K 步。每个程序在一块 TPU v2 上 20 分钟内评估完,用验证准确率或 perplexity 当 fitness。
每次搜索用 100 块 TPU v2 跑约 72 小时,产生 20 到 30 万个程序,因为有缓存,实际执行的只有 2 到 3 万个。五次搜索再加一轮从最佳程序重启,总成本约 3,000 个 TPU v2 天。
从小任务走到大任务
搜索的 fitness 一直上升,拿到大一点的任务上验证却开始下降,论文把这叫做 meta-overfitting,也就是对代理任务过拟合。作者跑了 50 次搜索,记录每次在哪个进度开始过拟合。一半的搜索很早就过拟合,也有一条长尾到很后面才发生,而越晚过拟合的搜索,找到的程序在大任务上越好。
所以他们在搜索之外又加了一道漏斗筛选(funnel selection)。从代理任务 A 出发,把模型和步数加大,做出大 10 倍的任务 B;只有在 B 上赢过基线的程序,才送去大 100 倍的任务 C。
通过筛选的程序再简化三次。先用抽象执行删掉冗余语句;再删掉那些「有作用但删掉后差别很小」的语句(也可以用禁止插入的进化来做);最后由人工重新排列、改变量名,化成数学上等价的简单形式。
从 Program 4 到四行 Lion
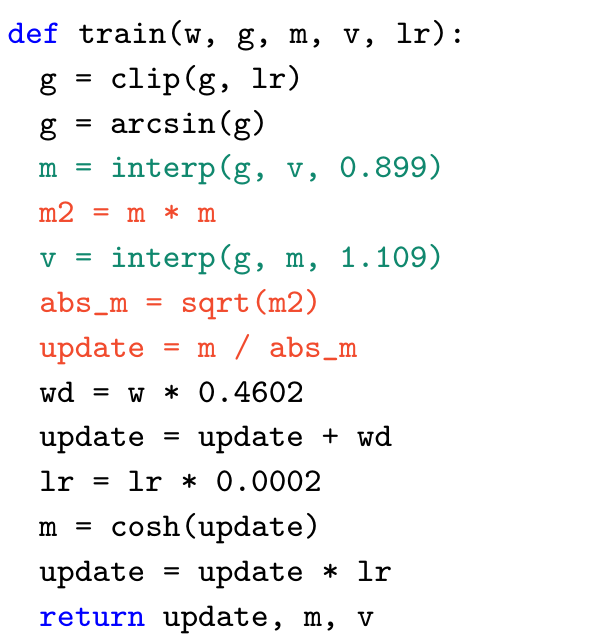
开头那段奇怪的代码就是它。我们一行一行地化简。
- 红色三行:
m2 = m * m、abs_m = sqrt(m2)、update = m / abs_m,就是 ,也就是sign(m)。 clip和arcsin:去掉之后质量没有下降,就删了。这一步和原式并不等价,clip按当步的梯度范数把整个梯度缩小,倍数每步不同,梯度进了动量插值之后,仍会改变当步与历史的相对比重;删掉它们靠的是实验结果。- 最后的
cosh:它写进了m,可是下一轮一开始m就被重新赋值,这一行没有作用。 - 绿色两行:
m是当前梯度和v以 0.899 插值,v又是梯度和这个新m以 1.109 插值。把第一行代进第二行,v变成一个系数接近 1 的移动平均,只是换了一种写法;论文把它整理成 。m则是送进 sign 之前,当前梯度与历史以约 0.9 插值的结果。 - 常数:
0.4602是权重衰减,0.0002是学习率的缩放,化简后变成两个超参数。
另外,Adam 的移动平均从 0 开始,前几步的估计偏小,需要偏差修正才不会让更新的大小失准。论文指出,偏差修正不会改变方向,而 sign 只看方向,所以这一步也去掉了。
整理后的 Lion(论文 Algorithm 2):
默认 、。和 AdamW 比,少了二阶矩 ,少了 ,也少了偏差修正。官方 PyTorch 实现的一步就这几行(google/automl):
p.data.mul_(1 - lr * weight_decay)                # 解耦权重衰减
update = exp_avg * beta1 + grad * (1 - beta1)     # c_t:当前梯度与动量插值
p.add_(update.sign_(), alpha=-lr)                 # 只取正负号
exp_avg.mul_(beta2).add_(grad, alpha=1 - beta2)   # m_t:用 beta2 更新动量
注意最后两行的顺序。更新权重用的是 ,存起来留到下一步的是 ,两者用的系数不同。
两个 β 各管什么
为什么要两个 β?把 展开,可以算出每一个过去的梯度在更新方向里占多少比重。当前梯度 占 ; 步之前的梯度占 ,以默认值算大约是 。下图把最近 步的比重加总起来画出。
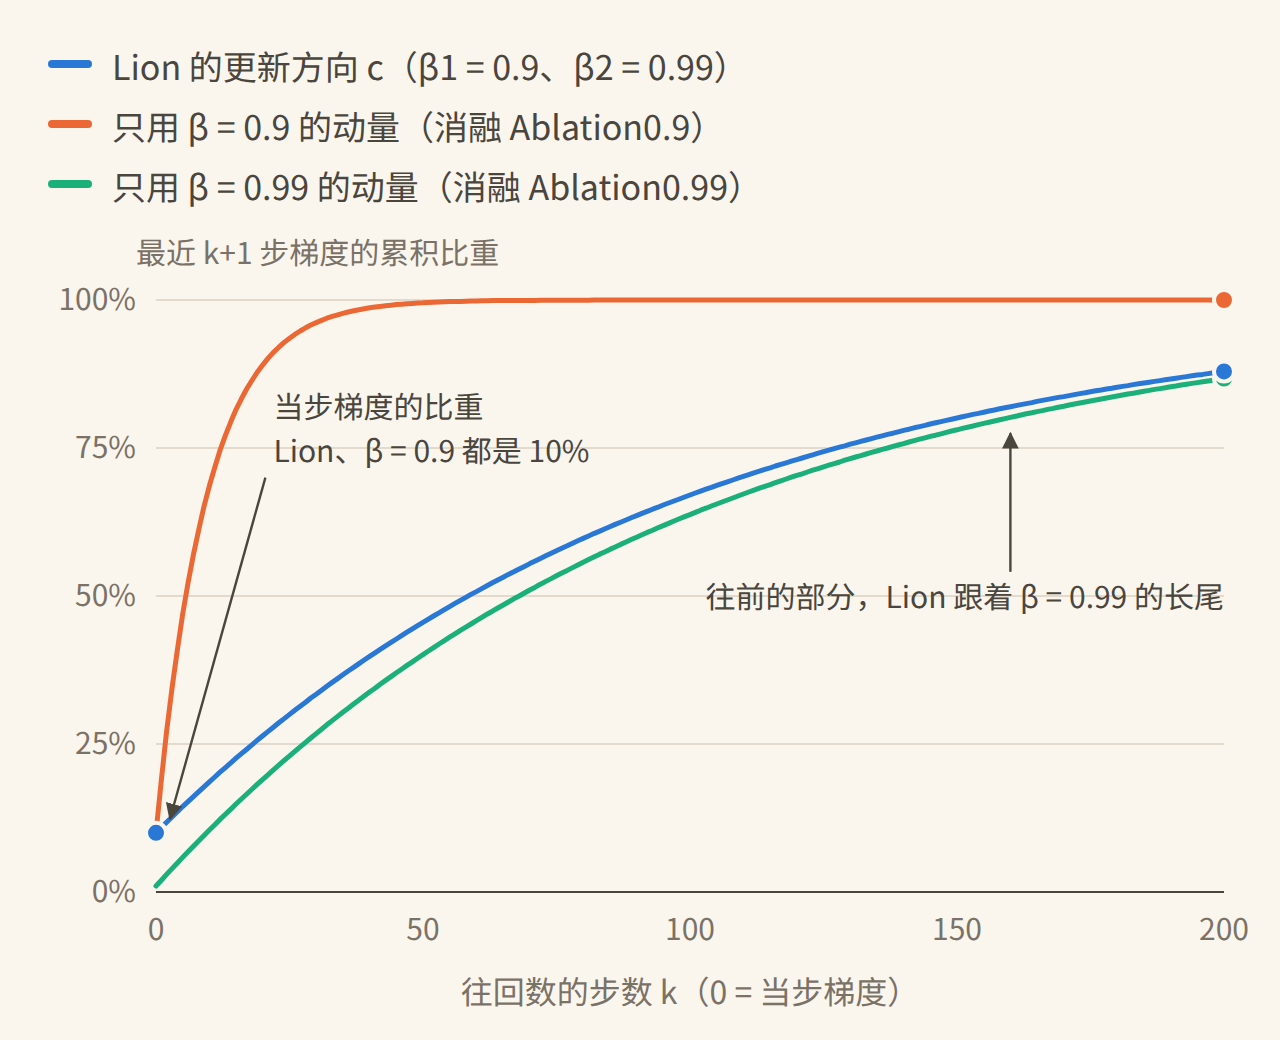
橙线是只用一个 的动量,当步梯度占 10%,但只记得最近二三十步。绿线是只用 ,记得的历史长了约 10 倍,当步梯度却只剩 1%。Lion 的蓝线两边都要。更新时当步梯度占 10%,和橙线一样;往前的部分则跟着绿线的长尾。
论文的消融做的就是橙线和绿线。在 ViT-B/16 上(ImageNet、加 RandAug 与 Mixup),只用一个动量再取 sign 的两个版本,准确率是 79.54%()和 79.90%(),都输给 AdamW 的 80.12%,Lion 是 80.77%。在 PG-19 的语言模型上,结论相同。
Lion 和 2018 年的 signSGD(以及它的动量版)也差在这里。两者都取 sign,但动量的累积规则不同;signSGD 的出发点是降低分布式训练的通信量,在图像分类的卷积网络上表现较差。
取 sign 的代价
sign 让每个坐标的更新大小都一样。不计权重衰减,每个参数每一步不是 就是 。
Adam 的更新 每个坐标大小不同,整体的均方根(RMS)通常小于 1,月之暗面在 Muon 那篇论文里测到的是 0.2 到 0.4;sign 的输出全是 ±1,RMS 就是 1,整个更新向量的范数因此比较大。论文的建议是 Lion 的学习率要比 AdamW 小 3 到 10 倍,初始、峰值、结束学习率都按同一个比例缩小;学习率调度、梯度裁剪这些其他设置都不用改。
学习率一缩小,权重衰减也得跟着调。解耦权重衰减实际作用在权重上的强度是 , 小了 3 到 10 倍, 就要大 3 到 10 倍,才能维持相近的强度。论文列了几组实际用的数字:
| 任务 | Lion(、) | 对照(、) |
|---|---|---|
| ViT-B/16,强增强 | 1e-4、10.0 | AdamW 1e-3、1.0 |
| 扩散模型 | 3e-5、0.1 | AdamW 3e-4、0.01 |
| 7.5B 语言模型 | 1e-4、0.01 | Adafactor 1e-3、0.001 |
整理自原论文 §5。
原则上用默认值即可;只有语言模型实验另外调过,改成 、。作者的经验是 小一点、记得的历史短一点,训练会比较稳定。
好处在内存与速度。Lion 只存一份动量,AdamW 要存两份。以 ViT-B/16、分辨率 224、批量 4,096 为例,AdamW 至少要 16 块 TPU v4 才放得下,Lion 只要 8 块(两者的动量都用 bfloat16 存)。因为运算简单,实验中每秒步数也比 AdamW 和 Adafactor 快 2% 到 15%,视任务、代码与硬件而定。
讨论
所有比较都以 AdamW 为对照,内存吃紧的大模型则以 Adafactor 为对照;动量 SGD 只在 ResNet 上比较。每个优化器都在对数尺度上调过峰值学习率与权重衰减。默认用 cosine 衰减加 10K 步预热,动量以 bfloat16 存储。
图像分类:最好看的一组
在 ImageNet 上从头训练(三次平均,ResNet-50 用批量 1,024 训练 90 个 epoch,其他模型用批量 4,096 训练 300 个 epoch),节选 Top-1:
| 模型 | 增强 | AdamW | Lion |
|---|---|---|---|
| ResNet-50 | 无 | 76.34 | 76.45 |
| Mixer-B/16 | 无 | 68.12 | 70.11 |
| ViT-B/16 | 无 | 75.48 | 77.44 |
| ViT-B/16 | 有 | 80.12 | 80.77 |
| CoAtNet-3 | 有 | 84.45 | 84.87 |
整理自原论文 Table 2;「有」为 RandAug 与 Mixup。ResNet-50 另有动量 SGD 76.22。
趋势很一致。归纳偏置越少的架构,例如 ViT、MLP-Mixer,差距越大;加上强数据增强,差距缩小;在卷积网络 ResNet-50 上,三个优化器几乎打平。
作者对 ViT 的解释是 sign 带来一种噪声,有正则化的效果。Lion 训练的 ViT-B/16 训练损失反而比较高(0.75 对 0.61),验证准确率却高了 2%;对权重加高斯噪声后,Lion 模型的损失(1.37)也远低于 AdamW 模型(3.74),表示它收敛到了比较平坦的区域。这个解释目前只有这些间接证据。
到了 JFT 这种大规模数据,差距更明显。
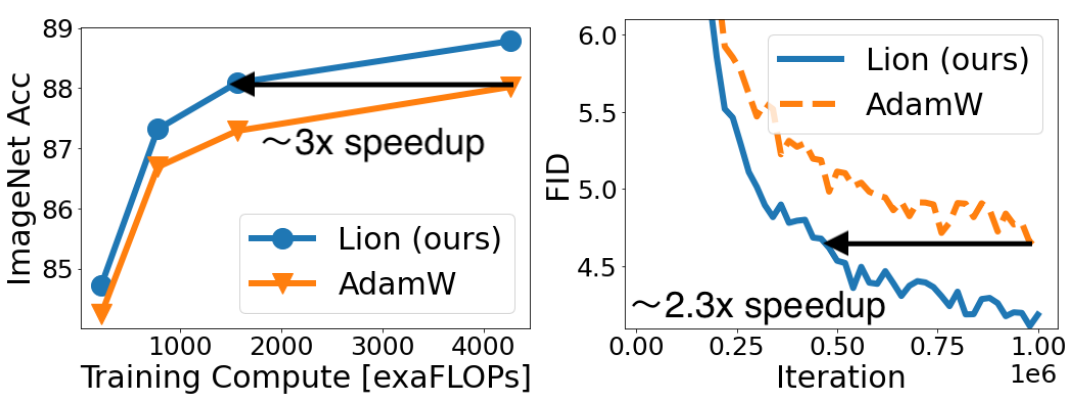
左图横轴是预训练计算量,纵轴是微调后的 ImageNet 准确率,曲线上的点涵盖 ViT-B/16、ViT-L/16、ViT-H/14 与不同的预训练预算。箭头标出的是,Lion 训练的 ViT-L/16 就追上了 AdamW 训练的 ViT-H/14,在 ImageNet 与 ImageNet V2 上省下 3 倍预训练计算,在 ImageNet ReaL 上省下 5 倍。Zhai 等人用 AdamW 把 ViT-L/16 训练到 400 万步,成绩还是比不上 Lion 训练 100 万步。
微调之后,在较难的分布偏移测试集上,Lion 训练的 ViT-L/16 领先得更多,ImageNet-A 高 6.08、ImageNet-R 高 5.54。数据换成 JFT-3B 后,Lion 训练的 ViT-g/14 以少 1.8 倍的参数超过了先前的 ViT-G/14,Lion 的 ViT-G/14 则达到 90.71%。
图文对比学习也有进步。LiT 冻结图像塔、只训练文本塔,零样本 ImageNet 在三种规模上都高约 0.7 到 1.1。BASIC-L 的图像塔预训练和对比学习两个阶段都换成 Lion,零样本 ImageNet 从 Adafactor 的 85.7% 升到 88.3%,比当时的最佳纪录高 2.0;微调后 91.1%,比纪录高 0.1。
扩散模型:分辨率越高差得越多
右图是 ImageNet 256×256 的无条件生成(改良版 U-Net、批量 2,048、常数学习率、DDPM 采样 1,000 步、不用 guidance)。Lion 在 44 万步就达到了 AdamW 的最终 FID,省下 2.3 倍的步数,最终 FID 是 4.1 对 4.7。64×64、128×128 也有改善,但分辨率越高,差距越大。
Imagen 式的文生图则好坏参半。64×64 的基础模型没有明显改善;64→256 的超分辨率模型上,Lion 的 CLIP 分数较高,FID 曲线的噪声也较少。
语言模型:规模一大就打平
小规模实验用 Wiki-40B 与 PG-19,模型 110M、336M、731M,每批 个 token、训练 12.5 万步。Lion 的验证 perplexity 一直比较低,中型模型分别有 1.6 倍、1.5 倍的加速,大型模型在 PG-19 上达到 2 倍。
规模放大之后就不一样了。作者在一个 1.6 万亿 token 的数据集上,按 GPT-3 的做法训练 1.1B、2.1B、7.5B 三个模型,各 300B token、批量 3M token,对照组是 Adafactor。整个训练过程中,两者的 perplexity 没有差别。Lion 只在单样本的 in-context 评测平均分数上小幅领先,例如 7.5B 模型的生成类任务平均 24.1 → 24.7、理解类任务平均 61.3 → 61.7。
掩码语言模型(C4)的 perplexity,Lion 对 AdamW 是 4.18 对 4.25、3.42 对 3.54、3.18 对 3.25;T5 在 GLUE 上微调,三种规模的平均分数各高 0.4 到 0.5。
批量大小与调参的容错
sign 会放大梯度噪声,直觉上 Lion 应该需要比较大的批量,才能把方向估准。作者直接测了。
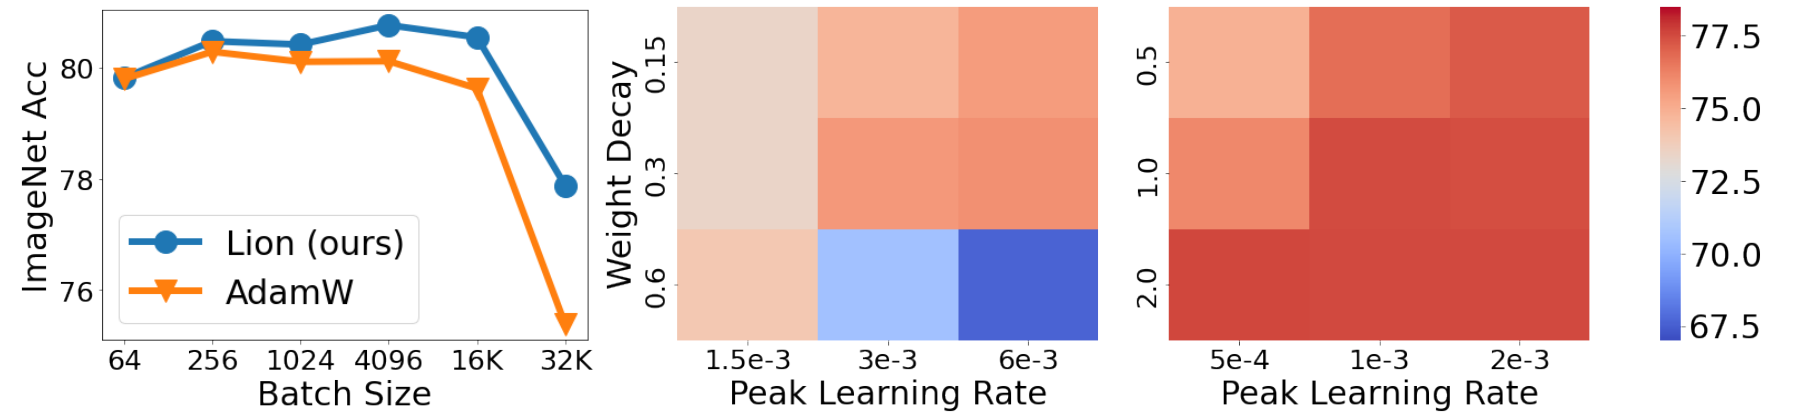
左图固定训练 300 个 epoch,改变批量大小。AdamW 的最佳批量是 256,Lion 是 4,096,确实偏好大批量;不过批量缩到 64,Lion 也没有崩。批量放大到 32K(只剩 1.1 万步)时,Lion 77.9%、AdamW 75.4%。
中、右两张热图各自扫了三个学习率与三个权重衰减。AdamW 在学习率和权重衰减都偏大的角落掉到 67.5% 附近;Lion 的九格里,只有学习率与权重衰减都最小的那一格颜色明显较浅。在这组设置下,Lion 对超参数比较不敏感。要注意两张图的格子是各自按建议范围挑的,Lion 的学习率本来就小 3 到 10 倍。
论文也比较了 RAdam、NAdam、AdaBelief、AMSGrad,以及 AutoML 找到的 PowerSign、AddSign(各自调学习率与权重衰减,其余用 Optax 默认值)。在 ViT-B/16 上,这些基线落在 78.50% 到 80.32% 之间,彼此没有明显的赢家,Lion 是 80.77%。PowerSign、AddSign 是最差的两个,这也符合「自动搜到的优化器很难推广到真实任务」的老经验。
论文自己写的限制
作者在第 6 节把限制列得很清楚。
- 搜索的偏差:搜索空间的设计仍受一阶优化器启发,搜到的东西容易长得像已有算法,也缺少二阶方法需要的函数;搜索成本高,简化还要靠人工。
- 差距很小或没有差距的任务:ResNet 上三种优化器差异很小;强增强会吃掉增益;Imagen 基础模型、大型内部数据集上的语言模型 perplexity、C4 的掩码语言模型,Lion 都和 AdamW 差不多。作者认为共同点是数据量大、质量高。
- 批量太小:批量小于 64 时,Lion 可能不比 AdamW 好。
- 内存:还是要存一份 bfloat16 的动量,对超大模型仍然很贵。
列第 2 点时,作者还补了一句,说 perplexity 可以算是比 in-context 评测更可靠的指标。换句话说,在作者自己认为较可靠的那个指标上,大规模语言模型没有看到差别。
后来的评估
语言模型预训练后来成了优化器的主战场,Lion 被多篇独立研究重新测过,看到的增益都比原论文小。
- Kaddour 等人(NeurIPS 2023):在固定计算预算下预训练 BERT 与 T5,Lion、Sophia 等方法的增益,碰到学习率完全衰减到底的基线就消失了。
- Zhao 等人(ICLR 2025):在 150M 到 1.2B 的自回归语言模型上,除了 SGD,Adam、Adafactor、Lion、Sophia 的最佳表现与对学习率的稳定性都差不多。他们也指出, 的 Lion 就是 Signum(带动量的 signSGD)。
- Semenov 等人(2025 年 9 月):Lion 和 Signum 在小批量时很差,加大批量后大幅改善;可是到了 720M 模型、每批 100 万 token,它们又跟不上其他方法。
- Wen 等人(2025 年 9 月):每个优化器各自做完整的超参数扫描之后,Lion 最多比 AdamW 慢 5%,偶尔稍快,模型越大落后越多。他们扫出的最佳值刚好可以拿来验证上面的建议。130M、1× Chinchilla 的设置上,AdamW 的最佳学习率是 0.008、权重衰减 0.1;Lion 表上的最佳组合是 0.002 和 0.7,单独把学习率改成 0.001 或把权重衰减改成 0.6,loss 还略低 0.003。学习率小 4 到 8 倍、权重衰减大 6 到 7 倍,都落在 Lion 论文「3 到 10 倍」的建议之内。
社区实现的经验也类似。lucidrains 的 lion-pytorch README 记录了一连串使用反馈。沿用 Adam 的学习率时,Lion 比 Adam 差很多;学习率除以 3,早期反而赢;直接按「小 10 倍」的规则,却跑出了最差的一次。README 最后建议只在批量 64 以上使用,也记下了负面结果大多出现在论文没评估过的设置,例如强化学习。
结论
Lion 是一个由程序搜索找到、再由人工化简的优化器。它的更新是 ,动量另外用 累积;每个参数每一步的移动量都是固定的 ,只存一份动量。它在 ViT 与 JFT、图文对比学习、高分辨率扩散模型上的进步最明显,这些进步也都有条件,大批量、Transformer 类架构、没有太强的数据增强。
如果要把 AdamW 换成 Lion,学习率除以 3 到 10,权重衰减乘上同一个倍数,并确认批量不要太小。然后从 3 倍开始扫,不要直接套用 10 倍。语言模型可以先试 、。
搜索从 AdamW 出发,进化了 3,000 个 TPU 天,最后在语言模型预训练上跑出一个和 AdamW 差不多快的优化器。至少优化器状态省了一半。