原始论文
Fantastic Pretraining Optimizers and Where to Find Them
- 发表版本
- ICLR 2026会议
- arXiv 首次提交
- arXiv:2509.02046
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizersfantasticoptimizers2025,
  title = {{Fantastic Pretraining Optimizers and Where to Find Them}},
  author = {Kaiyue Wen and David Hall and Tengyu Ma and Percy Liang},
  year = {2025},
  eprint = {2509.02046},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2509.02046}
}
拿一个 1.3 亿参数的语言模型,按 GPT-3 论文的配方用 AdamW 训练,峰值学习率 6e-4。现在只改一个数字,把学习率换成 8e-3,其他设置都不动。达到同样的 loss,步数少了一半。
这组实验放在论文的第一张图里。GPT-3 配方的这条 AdamW 曲线,正是 Sophia、MARS、Cautious 等新优化器论文拿来比较的基线,这些论文宣称的加速大多是 2 倍。Muon 的大规模版本宣称约 2 倍,SOAP 宣称 1.4 倍,DION 甚至报告了 3 倍。
如果光是把基线的学习率调好就有 2 倍,那这些优化器真正快了多少?Stanford 的 Kaiyue Wen、David Hall、马腾宇(Tengyu Ma)与 Percy Liang 把 11 个优化器放在同一套流程里,每一个都从头调参,从 1.3 亿参数一路比到 12 亿参数。
论文题目套用了电影《神奇动物在哪里》(Fantastic Beasts and Where to Find Them)。这篇笔记要看的是,他们怎么设计一个公平的比较,测到的加速比是多少,又和同期、后来的几份大规模评估差在哪里。
定义问题
作者认为,新优化器迟迟没有取代 AdamW,问题出在评估方法上,主要有两个。
第一个是调参不对等。新方法的作者通常认真调自己的优化器,基线却沿用旧配方,或是让所有优化器共用同一组学习率和权重衰减。
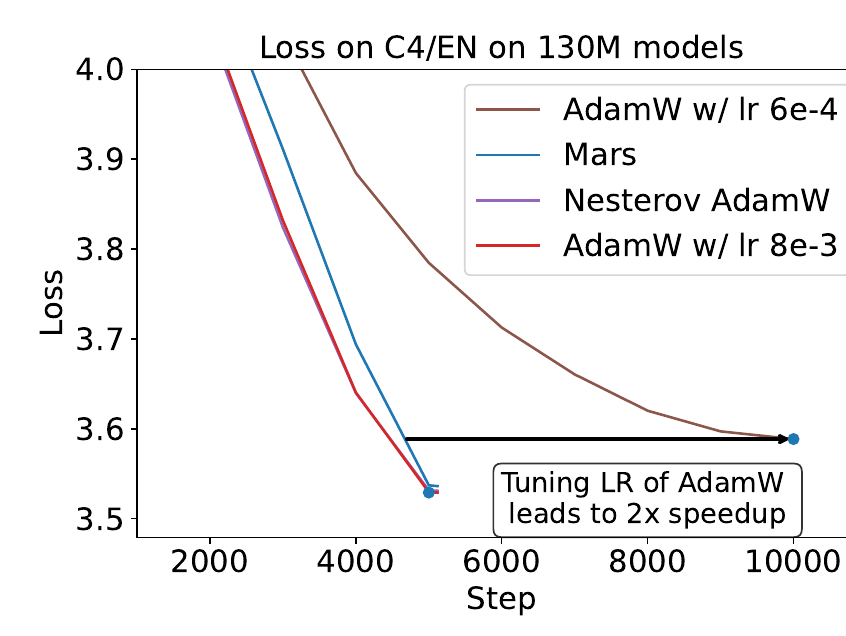
棕线是学习率 6e-4 的 AdamW,红线是 8e-3。红线不到 5,000 步就降到棕线第 10,000 步的终点 loss,最后还停在更低的约 3.53。MARS(蓝线)和 Nesterov AdamW(紫线)也画在图上,终点都和调好的红线很接近。拿棕线当基线,MARS 看起来就有 2 倍加速;换成红线,差距就小得多。
共用超参数也不公平。就算是很像的优化器,最佳超参数也可能差很多。以 Lion 为例,论文的扫描找到它的最佳权重衰减约 0.6,AdamW 约 0.1;两者如果共用同一个值,总有一个会吃亏。
第二个是评估设置太窄。多数论文只在 1× Chinchilla 附近、一两个模型大小上比较,有的还拿训练中途的 checkpoint 来比。所谓 1× Chinchilla,是 Chinchilla 论文推出的计算最优比例,每个参数读约 20 个 token。真实的大模型从 1 倍到 50 倍以上都有,一个在 1× 赢的方法,到了数据多的区间不一定还赢。
这篇论文要回答的就是这两件事。怎么确定每个优化器都调到接近最佳?在不同模型大小、不同数据量下,加速比又是多少?
解决问题
实验场地
数据仿照 OLMo 2,混合 DCLM-baseline(3.8T token)、StarCoder V2(0.25T)与 ProofPile 2(55B),用 Llama 3 的 tokenizer。模型都是 Llama 架构、32 层、序列长 4,096,只改宽度:
| 模型 | 隐藏维度 | 前馈维度 | 注意力头 |
|---|---|---|---|
| 130M | 512 | 2,048 | 8 |
| 300M | 768 | 3,072 | 12 |
| 520M | 1,024 | 4,096 | 16 |
| 1.2B | 1,536 | 6,144 | 24 |
整理自原论文 Table 2。
数据量以 Chinchilla 倍数表示,1×、2×、4×、8×(非嵌入参数量的 20 倍算 1×)。主要指标是 C4 英文子集的验证 loss,另外追踪 HellaSwag、ARC 等十多项下游准确率。实验在 128 块 TPU v5 lite 上用 JAX 跑,作者估算约相当于 12 张 H100。
比较的单位是「达到同一个 loss 需要多少 token」,不计每一步多花的计算时间。作者的理由是,SOAP 与 Kimi 的 Muon 论文都显示,矩阵型优化器实现得当时,每步额外开销可以压到 10% 以下。
11 个优化器分成五类:
- 基线:AdamW
- 降低更新方差的 AdamW 变体:NAdamW(Nesterov 动量)、MARS、Cautious
- 省内存:Lion、Adam-mini
- 矩阵型:Muon、Scion、Kron(PSGD)、SOAP
- 近似 Hessian:Sophia(结果放在附录)
标量型和矩阵型的差别在于预条件怎么作用。AdamW、Lion、MARS 等标量型,对每个参数各自乘上一个标量;Muon、SOAP、Kron 等矩阵型,把整个权重矩阵当成一个整体,用矩阵乘法处理梯度。
三阶段调参
所有组合都完整搜索太贵,作者分三个阶段来做。
第一阶段是坐标下降。 每个超参数都有一组离散的候选值,以 AdamW 为例,包括学习率、权重衰减、预热步数、、、、梯度裁剪上限与批量大小(batch size)。起点是原论文建议的设置。每一轮固定其他超参数,只扫其中一个,若验证 loss 的改善超过 就换成新值;一轮一轮地扫,直到没有任何一个超参数能再显著改善。这个步骤在 6 个设置上各做一次:130M、300M、520M 的 1×,加上 130M 的 2×、4×、8×。
论文给了一个 AdamW 的示例。初始设置是学习率 0.008、权重衰减 0.1、预热 1,000 步、批量 256 条,loss 3.298;第一轮把预热改成 2,000 步,降到 3.282;第二轮把批量改成 128 条,降到 3.263;最后把梯度裁剪上限改成 2,loss 维持 3.263,扫描结束。
第二阶段只调会随规模变化的超参数。 作者观察到两件事。很多超参数只要在最佳值附近,对 loss 几乎没有影响;会影响 loss 的那些,最佳值大多也不随规模改变。
于是他们把 loss 与最佳值相差 以内的设置都算作「接近最佳」。若某个超参数存在一个值,在每个设置下都属于接近最佳,它就是对规模不敏感的,固定下来;否则就是对规模敏感的,带到第二阶段继续调。
结果每个优化器需要重调的超参数都不多。AdamW 是学习率、预热、权重衰减和批量大小,Lion 是学习率和 ,Muon 和 Kron 都只有学习率。第二阶段在 300M、520M 的 2×、4×、8× 共 6 个设置上重做,加上第一阶段,总共 12 个设置。
第三阶段把规律外推。 对每个需要重调的超参数 ,用 12 个设置的最佳值拟合
是参数量, 是 token 数。作者在 1.2B、1× 上对 AdamW 重做一次完整的第一阶段来验证,用拟合式预测的超参数,loss 和真正找到的最佳值相差在 以内。接着用这套预测跑两组更大的案例,一组是 1.2B 模型的 1× 到 8×,另一组是 130M、300M 一路读到 16×。
最佳值随规模的变化,从附录的表格就看得到。AdamW 在 130M、1× 的最佳学习率是 0.008、权重衰减 0.1、批量 128 条;到了 1.2B、1×,变成学习率 0.002、权重衰减 0.2、批量 256 条。Muon 矩阵部分的学习率则从 0.016 降到 0.004(1.2B、1× 时改用 0.008,loss 还略低一些)。模型大了约 9 倍,学习率小了 2 到 4 倍;拿 130M 调好的学习率直接用在 1.2B 上,基线就会吃亏。
加速比怎么测
加速比用 token 数来换算。对每个模型大小,先用 AdamW 在 1×、2×、4×、8× 的四个 loss 拟合一条曲线
某个优化器用 个 token 达到 loss ,就在 AdamW 的曲线上反解,AdamW 要达到同一个 需要 个 token。加速比就是 。
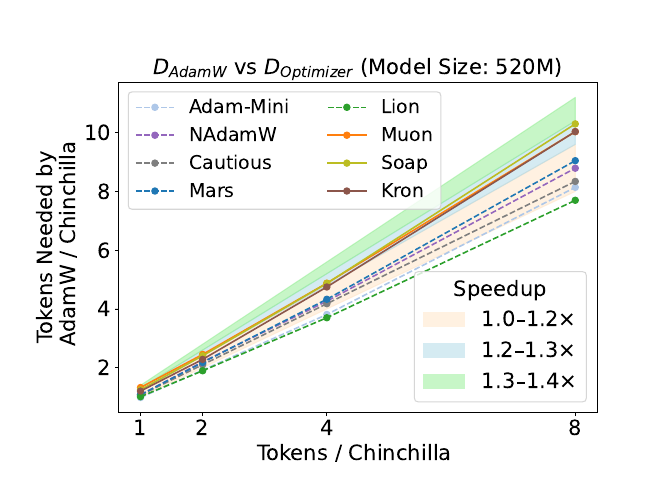
读这张图,看每条线离对角线多远。如果某个优化器和 AdamW 一样快,它的点会落在 上;点越往上,表示 AdamW 要多读越多 token 才追得上。在 520M 上,实线的矩阵型优化器大致落在 1.2 到 1.4 倍的色带里,而且数据量越大,线往上翘得越明显。
讨论
主结果:最多 1.4 倍,而且越大越少
整理三个模型大小、四种数据量的结果,有四条规律。
- 没有任何方法达到 2 倍。相对调好的 AdamW,最高约 1.4 倍。SOAP 是少数自己认真调过基线的论文,它宣称的 1.4 倍和这里测到的最接近,在 300M、520M 上实际是 1.2 到 1.3 倍。
- 矩阵型胜过标量型。每个模型大小下,Muon、SOAP、Kron、Scion 都压过标量型的优化器。1× 时 Muon 最好,到了 8×,SOAP 和 Kron 追上并超过。矩阵型的加速比随数据量增加而增大,随模型变大而减小。
- 标量型调好后都和 AdamW 差不多,平均加速不到 1.2 倍。NAdamW、MARS、Cautious 这些降低方差的变体小幅胜过 AdamW。
- 省内存的 Lion 和 Adam-mini 紧跟 AdamW,最多慢 5%,偶尔稍快。模型变大时,Lion 落后得越来越多,Adam-mini 反而越追越近。
附录里每个设置的最佳 loss 可以直接看出差距有多小,节选几格:
| 优化器 | 130M、1× | 520M、8× | 1.2B、8× |
|---|---|---|---|
| AdamW | 3.529 | 2.913 | 2.752 |
| NAdamW | 3.531 | 2.907 | 2.749 |
| Lion | 3.552 | 2.915 | — |
| Muon | 3.464 | 2.906 | 2.748 |
| SOAP | 3.483 | 2.899 | 2.749 |
本文整理,取自原论文附录 C、D、E 中各设置的最佳配置行;C4/EN 验证 loss,越低越好。1.2B 只跑了四个优化器。
130M、1× 时,Muon 比 AdamW 低 0.065,是整张表最大的差距。到了 1.2B、8×,四个优化器挤在 0.004 之内。
1.2B:降到 1.1 倍
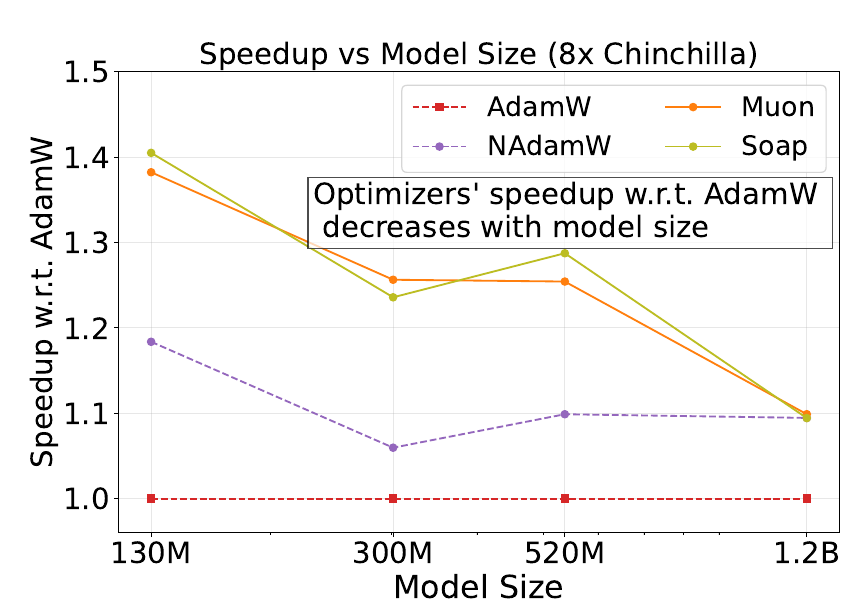
这张图固定在 8× Chinchilla,看加速比怎么随模型大小变化。SOAP 和 Muon 在 130M 时都接近 1.4 倍,到 1.2B 只剩约 1.1 倍,和 NAdamW 几乎一样。
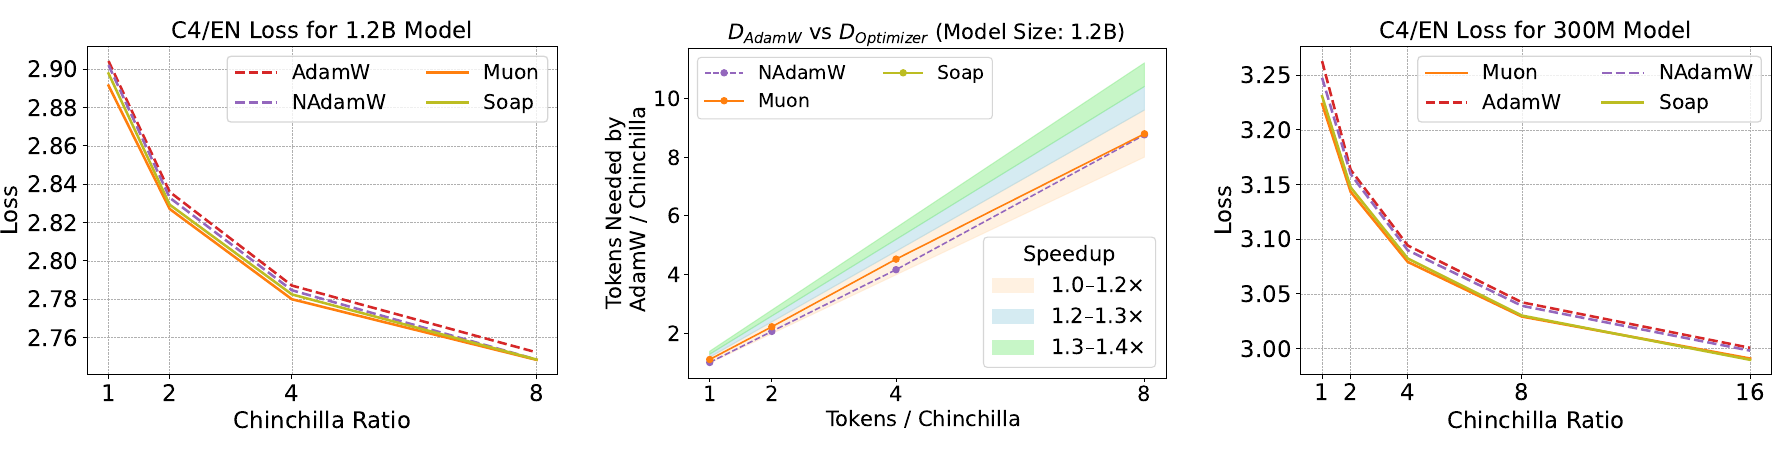
左图是 1.2B 的 loss。NAdamW、Muon、SOAP 仍然比 AdamW 快,但三者之间几乎没有差距;中图换算成加速比,大约 1.1 倍。下游评测也看不出差别,8×(193B token)时十项任务平均 AdamW 67.15、NAdamW 66.70、Muon 66.98。
作者用 16 次训练拟合了 AdamW 与 Muon 的 scaling law,,并预测到了 7B、1× 时,Muon 的 loss 反而会比 AdamW 高。按附录的系数算,7B、1× 时 AdamW 是 2.5706、Muon 是 2.5729,相差 0.002,比 Muon 那条拟合本身 0.005 的 RMS 误差还小。这个预测是在拟合范围之外外推 6 倍,能说的是 Muon 的优势在这条线上会缩到看不见,谁胜谁负还说不准。
右图延伸到 16× Chinchilla。8× 时 SOAP 已经在 130M 和 520M 上超过 Muon,作者在 300M 读到 16× 再确认一次,SOAP 仍然胜出,130M 也一样。他们猜测 SOAP、Kron 保留的二阶动量,在数据量大时更有用。不过附录表格里,300M、16× 的最佳 loss 是 SOAP 2.990、Muon 2.991,只差 0.001,比他们自己在坐标下降时「算作改善」的阈值 0.003 还小。这一段更稳妥的读法是,数据量拉高之后,Muon 原本的领先消失了。
早期曲线会骗人
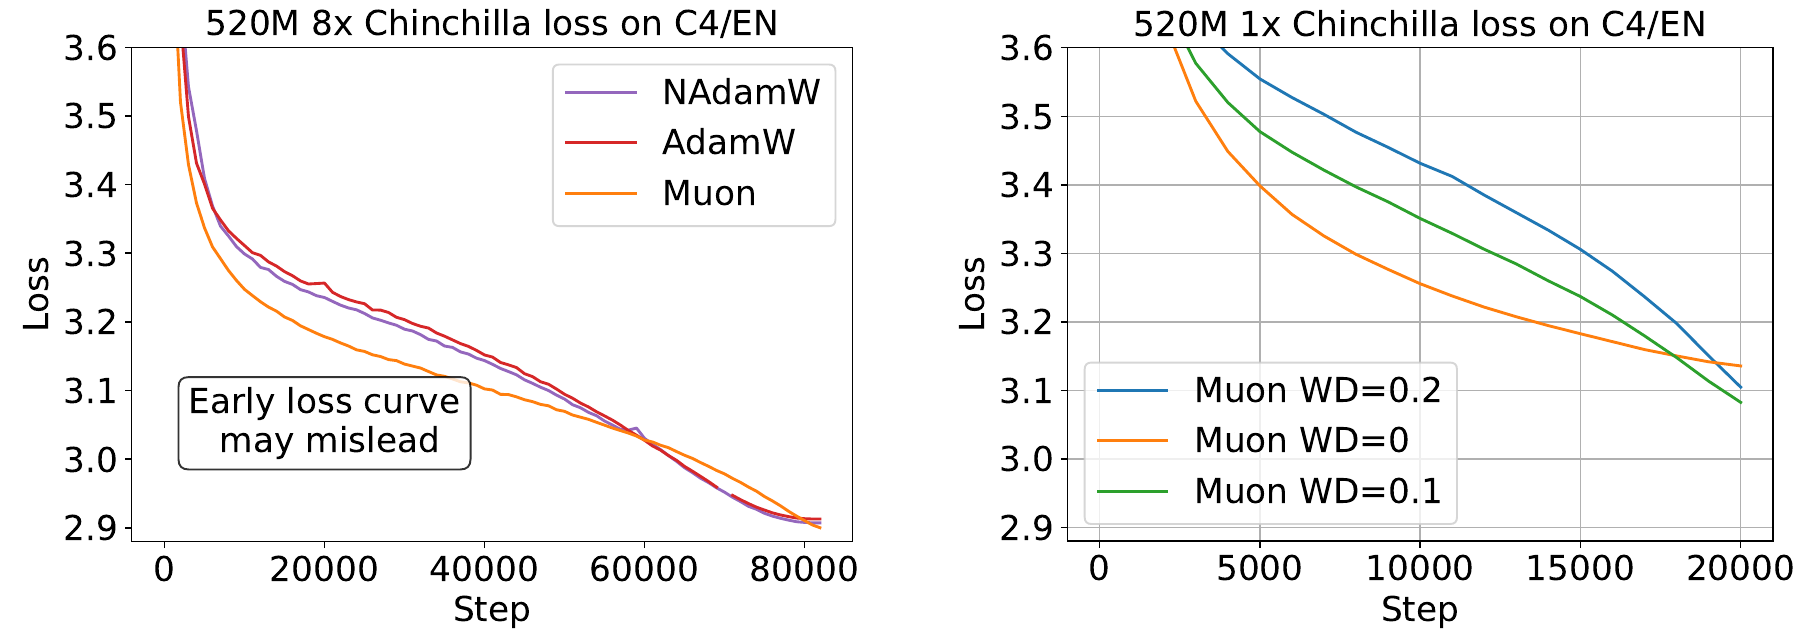
左图是 520M、8× 的完整训练曲线。Muon 前半段大幅领先,如果在第 3 万步停下来比,看起来快得多;学习率开始大幅衰减之后,AdamW 和 NAdamW 追了上来,约 6 万步时三条线交会,终点几乎一样。
右图是同一个优化器换三种权重衰减。不加权重衰减的 Muon 前期最快,后面却停滞,最后是三者中最差的;权重衰减 0.1 的终点最好。
所以作者建议只比较最终的 checkpoint。他们在这里点名了 Kimi 那篇 Muon 论文,那份报告比较 Muon 与 AdamW 的 MoE 模型时,用的正是学习率还没衰减完的中途 checkpoint。
同一节还有两个观察。
- 只差一个超参数就能翻转排名。520M、8× 时,SOAP 的学习率设成最佳值的 2 倍,它对 MARS 的领先就几乎消失。作者统计了只改一个超参数、loss 仍在最佳值 0.02 以内的所有训练,Muon、SOAP、MARS 三者的分布彼此重叠。没有系统的扫描,排名几乎可以是任意的。
- 最佳权重衰减因优化器而异。前面提过 Lion 约 0.6;Kron 约 0.5,这是它能赢过 AdamW 的关键。
先前那些「2 倍」从哪来
附录 G 逐一对照了先前论文的设置,找出加速被高估的原因。
- Sophia(2 倍):峰值学习率低于 6e-4。原因之一是当时使用的 Levanter 数据加载没有完全随机打乱,作者复现时发现,完全打乱才能稳定使用大学习率。在他们的设置下,Sophia 在 0.5B 以下没有显著加速。
- MARS(2 倍):基线和 Sophia 类似。MARS 论文第一版的图其实已经显示,把 AdamW 的学习率拉到 3e-3 会大幅变好。
- Muon(2 倍):NanoGPT speedrun 上是约 1.3 倍。Kimi 测到 2 倍,但他们的 AdamW 学习率偏低,400M 到 1.5B 只用 8e-4 到 9e-4;MoE 的比较又取在学习率未完全衰减时。Essential AI 的独立研究测到的 token 效率是 1.1 到 1.2 倍。
- SWAN、DION(2 到 3 倍):在少于 1× Chinchilla 的区间比较,那里的加速本来就比较大;DION 主打的通信成本,这篇没有计入。
- SPlus(2 倍):用的是固定学习率,不衰减,这不是一般预训练的设置。
同期的另一份评估
比 Fantastic 早一天,EPFL 的 Semenov、Pagliardini 与 Jaggi 也在 arXiv 发布了 Benchmarking Optimizers for Large Language Model Pretraining。他们训练了约 2,900 个模型,花了约 3 万 GPU 小时,同样比较 11 种方法,模型从 124M 到 720M,另有一个 520M 的 MoE;数据是 FineWeb,序列长只有 512,批量从 1.6 万到 200 万 token 不等。
两边有不少共识,例如权重衰减不能是 0、学习率要衰减到足够低,MARS 这类降低方差的 AdamW 变体确实有用。最大的分歧在矩阵型优化器。Semenov 等人发现 AdEMAMix 与 MARS 胜过 Muon,在 720M、每批 100 万 token 时两者遥遥领先;Fantastic 的结果却是 Muon 明显胜过 MARS。
Fantastic 在相关工作一节自己分析了原因。
- 批量大小:Semenov 等人在 124M 上调得最仔细的实验,每批只有 1.6 万与 13 万 token;Fantastic 调出来的批量都不小于约 40 万 token。MARS、AdEMAMix 会对梯度做平均、降低噪声,在噪声主导的小批量区间占优势,批量一大,这个优势就缩小了。
- 硬件:EPFL 看起来主要用 1 到 8 张 H100,小批量比较划算;Fantastic 用 128 块 TPU,大批量才能把并行度用满。
- 调参:在 520M 左右的规模,Fantastic 扫到的最佳学习率是 4e-3 到 8e-3,EPFL 用的是 1e-3 到 2e-3,有些是从小模型直接搬过来、没有重调;Fantastic 还把 Muon 的嵌入层与矩阵权重分开调学习率。
两份研究也有呼应的地方。EPFL 发现 Lion 和 Signum 加大批量后明显改善,模型一大又跟不上;Muon 加上权重衰减的版本在所有设置下都稳定,原版 Muon 则随模型变大而退步。
更大的规模
1.2B 这个上限,论文自己也列为限制。2026 年 7 月,NVIDIA 的 SOAP, Muon, and Beyond: Pushing LLM Pretraining Scales 把比较推到了数十亿参数。
他们的设置和 Fantastic 差很多。
- 模型与数据:8B dense,以及 30B 总参数、3B 激活和 72B 总参数、8B 激活的 MoE;读 1 万亿到 3 万亿 token。
- 批量:基准是每批约 2,500 万 token,再放大到 2 倍、3 倍、4 倍,摘要提到最高约 1 亿 token。
- 调参方式:AdamW 用的是 Nemotron 原本的生产配方,Muon 和 SOAP 的学习率主要靠 Kimi 的更新 RMS 对齐转换过来,放大批量时再按平方根规则调整学习率,没有像 Fantastic 那样逐一扫描。
结果是 Muon 与 SOAP 一致胜过 AdamW,差距在大批量时最明显。批量加大后 AdamW 退化,Muon 仍然稳定。在 30B 的 MoE 上,同样的批量下 Muon 的下游成绩大多持平或较高,例如 MMLU-Pro 58.19 对 54.45、数学类平均 82.52 对 79.65;72B 的 MoE 用 2 倍批量的 Muon 对 1 倍批量的 AdamW,代码类平均高 4.5,数学类平均却低了 3.2。SOAP 修好大批量下的不稳定后,loss 略低于 Muon,他们建议显存允许时优先用它。
这两份结果可以并存。Fantastic 测的是在 AdamW 用得舒服的批量(约 50 万到 100 万 token)下、彻底调好之后的 token 效率;NVIDIA 测的是把批量推到远超 AdamW 临界批量大小时,谁还撑得住。Essential AI 在 100M 到 4B 上看到的情况也一样,Muon 达到同样 loss 少用 10% 到 15% 的 token,而且这个优势在批量加大时维持或扩大。
其他观察与限制
所有优化器还有几个共同现象。有权重衰减时,参数范数都随学习率调度先升后降;学习率衰减期间梯度范数会上升,但 loss 没有跟着变差;各优化器的训练 loss 和验证 loss 走势一致,看不出谁的泛化特别好。
限制方面,作者明确写出最大只到 1.2B。其他条件也要一起记住。这篇只比较 token 效率,不算墙钟时间与通信;只有一套数据配方与 dense Llama 架构;批量都在数十万 token 以上。
结论
这篇论文用三阶段调参,让 11 个优化器各自接近最佳,再在 130M 到 1.2B、1× 到 8× Chinchilla 上换算 token 效率。调好之后,最快的矩阵型优化器在小模型上约 1.3 到 1.4 倍,到 1.2B 只剩约 1.1 倍;标量型和 AdamW 差不多。先前的 2 倍大多来自弱基线与中途 checkpoint。
读优化器论文时,先确认 AdamW 的学习率有没有扫过、比较的是不是训练结束时的 checkpoint,以及实验跨了几种模型大小和数据量。自己换优化器之前,也先把 AdamW 的学习率、权重衰减和预热扫一遍;如果起点是 GPT-3 配方那种偏低的学习率,光这一步就可能省下一半的步数。
至于神奇动物在哪里,看 NVIDIA 2026 年的结果,大概在批量 2,500 万 token 以上的地方。