原始論文
Sophia: A Scalable Stochastic Second-order Optimizer for Language Model Pre-training
- 發表版本
- ICLR 2024會議
- arXiv 首次提交
- arXiv:2305.14342
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizerssophia2023,
  title = {{Sophia: A Scalable Stochastic Second-order Optimizer for Language Model Pre-training}},
  author = {Hong Liu and Zhiyuan Li and David Hall and Percy Liang and Tengyu Ma},
  year = {2023},
  eprint = {2305.14342},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.14342}
}
說一個優化器「比 Adam 快兩倍」,到底要怎麼量?
Stanford 的 Hong Liu、Zhiyuan Li、David Hall、Percy Liang 與 Tengyu Ma 在這篇論文裡花了一小節回答這件事。基準方法要用預定的總步數 把學習率和排程調到最好;新方法只跑 步,最終損失必須小於或等於基準,不能「差不多」。他們還特別提醒,cosine 排程會跟著總步數伸縮,拿 步那次訓練的中途檢查點來比,結論會偏。
在這個標準下,他們宣稱 Sophia 在 GPT-2 上用一半的步數,就達到 AdamW 的驗證損失,每一步的時間與記憶體幾乎不變。
這篇筆記先看 Sophia 怎麼做,再看這個「兩倍」後來被別人量成多少。
定義問題
Adam 只看梯度大小
Adam 的分母是梯度平方移動平均的平方根。梯度方向穩定時, 大約是 ,每個座標走的步長都接近 ,和那個方向的地形是陡是平沒有關係。
可是語言模型的損失地形,各方向的曲率差很多。作者量了 1.25 億參數 GPT-2 的對角 Hessian,正值元素的大小分佈非常散。
一個二維的例子
作者用一個兩維可分的函數說明,,其中 很陡、 很平。
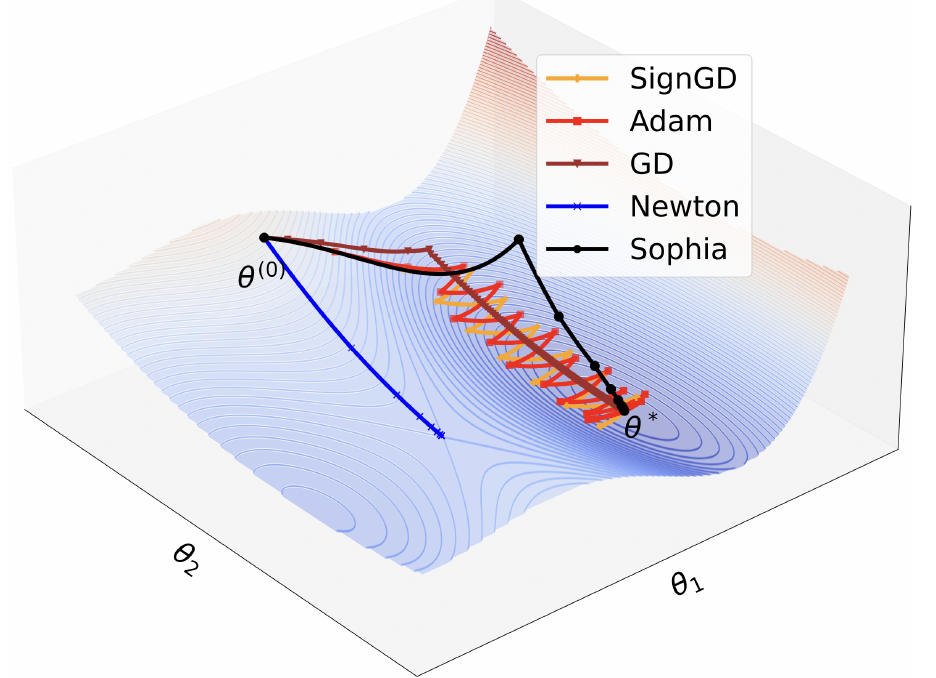
圖上的每條線都從左上的 出發,目標是右下的 。
GD 的學習率受限於最陡的方向,最大只能取到陡方向曲率的倒數左右,否則就發散;這個學習率對平坦方向太小,所以深紅線沿 走得很慢。
Adam 的簡化版是 SignGD,兩個方向每步都走 。在平坦方向,同樣的步長只能降一點點損失;在陡的方向,三步就到谷底,接著開始來回彈。想讓它停下來, 得衰減到 0,平坦方向又更慢了。圖上紅色的 Adam 和橘色的 SignGD 幾乎重疊,都在谷裡鋸齒前進。
照凸最佳化的教科書,最理想的預條件是 Hessian。在這個可分的例子裡,Newton 法就是每個方向的梯度除以該方向的曲率,陡的方向步子自動縮小,平的方向自動放大。問題是 有一段曲率是負的,Newton 法在那裡會往極大值或鞍點走,藍線就收斂到一個鞍點。真實模型的曲率還會沿著訓練軌跡快速變化,二階資訊不一定可靠。
二階方法太貴
既有的二階方法還有成本問題。K-FAC 這類區塊對角近似對大型語言模型太貴;AdaHessian 也用對角 Hessian 當預條件,但幾乎每一步都估計,每步成本超過兩次梯度計算。作者猜測,它們之所以必須頻繁估計,是因為缺少一個能擋住錯誤估計的保護機制。
所以這篇要找的預條件得同時做到三件事,像 Newton 那樣按曲率縮放,在負曲率與估錯時不出事,平均每步只多一點點計算。
解決問題
更新式
Sophia 的全名是 Second-order Clipped Stochastic Optimization。Algorithm 3 寫成:
分子是梯度的移動平均,和 Adam 一樣。分母換成對角 Hessian 的估計 ,每 步才估一次,也做移動平均去噪。 是 decoupled weight decay。所有運算都逐座標進行, 把每個元素截在 。
括號裡的 是一個打了折的 Newton 步。作者把式子改寫成
右邊比較好讀。先算 Newton 步 ,把每個座標截在 ,再乘上 。所以 只決定「多少比例的座標會被截」,被截到的座標,最後的步長都是 。
走一遍裁剪
拿 Sophia-H 的預設 ,假設某幾個座標的動量都是 ,只有曲率估計 不同:
| 曲率 | 實際步長 | |
|---|---|---|
| 20 | 0.01 | |
| 1 | 0.2 | |
| 0.2 | 1 | |
| 0.02 | 10 | (被截) |
| −3 | (被截) |
本文整理,依原論文 Eq. (6) 計算。
曲率大的座標,步長自動縮成 Newton 式的小步;曲率小的座標本來會得到很大的 Newton 步,被截在 。最後一列是 Hutchinson 估計器常見的負值, 取到 ,比值爆大,被截成 ,也就是帶動量的 SignSGD。曲率估得太小時同理。
作者把這種行為描述成「把帶動量的 SignSGD 當備援」。不管 Hessian 估得多離譜,每個座標每步最多移動 ,這是整個方法敢「每 10 步才估一次 Hessian」的前提。
那 怎麼選?作者的建議是在小模型上調,讓「沒有被截」的座標比例落在 10% 到 50%,太多或太少就把 乘 0.5 或 2 重來;同架構、同資料的不同大小模型可以共用。實際訓練時,被截的座標比例會爬到 60% 左右,也就是大多數座標其實走的是 sign 步。論文最後用 (Sophia-H)與 (Sophia-G)。
兩種對角 Hessian 估計
Hutchinson 估計器(Sophia-H)。抽一個標準常態向量 ,計算
它的期望值正好是 Hessian 的對角。只需要一個 Hessian-vector product,也就是對 再做一次反向傳播,不用把 Hessian 組出來。這個估計不偏,但單次估計可能是負的。
Gauss-Newton-Bartlett 估計器(Sophia-G)。交叉熵損失的 Hessian 可以拆成 Gauss-Newton 項 與一個通常較小的剩餘項,作者只估前者。這裡 是 logits 對參數的 Jacobian, 是損失對 logits 的二階導數。對交叉熵, 只跟模型輸出的機率 有關,跟真實標籤無關。再用統計學裡的 Bartlett 恆等式, 可以寫成「從模型自己的分佈抽一個標籤,算梯度外積」的期望。
實作只要四步:
- 拿一批輸入算 logits;
- 從模型自己的 softmax 抽標籤 ;
- 用這些假標籤算 mini-batch 損失的梯度 ;
- 回傳 , 是批次大小。
乘上 的原因是自動微分只給平均梯度;Bartlett 第一恆等式說抽樣標籤下的單筆梯度期望為 0,平均梯度的平方乘上 ,期望值剛好等於逐筆梯度平方的平均。
這個估計永遠非負,所以預條件後的方向一定是下降方向。它看起來很像 Adam 的二階動差,都是梯度的平方,差別有兩處。Adam 用的是真實標籤的梯度,Sophia-G 用的是從模型抽樣的標籤;Adam 對分母開根號,Sophia 直接除。前者在文獻裡叫 empirical Fisher,作者的消融顯示它不如 GNB。
官方程式只實作了 Sophia-G。作者在 GitHub 上也回覆過,Sophia-G 的估計不會是負的,負曲率那套保護是為 Sophia-H 準備的。
每 10 步估一次
,而且只用一部分樣本估 Hessian。GPT-2 的批次是 480 筆,Sophia-H 只拿其中 32 筆,Sophia-G 拿 240 筆。在 A100 上量到的每步時間如下:
| 方法 | 355M | 770M |
|---|---|---|
| AdamW | 1.77 s | 3.25 s |
| Sophia-H | 1.88 s | 3.40 s |
| Sophia-G | 1.86 s | 3.42 s |
整理自原論文 Table 1;每步時間已攤入每 10 步一次的 Hessian 估計。
記憶體方面,Sophia 只存 與 兩份狀態,和 AdamW 一樣。
理論保證在哪個設定
第 4 節證明了一個簡化版本的收斂速度。函數必須嚴格凸,Hessian 在一定半徑內變化有限,更新是確定性的;而且分析用的是完整的 Hessian,先轉到它的特徵基底,在那裡逐座標裁剪,再轉回來。在這些條件下,達到誤差 所需的步數與條件數(最大曲率除以最小曲率)無關;SignGD 即使在簡單的二次函數上,速率也會受條件數影響。
理論為什麼不用對角 Hessian?作者的說明是,對一般的函數,曲率方向不一定和座標軸對齊,對角預條件不一定有效。這句話剛好說中 Sophia 實作版的弱點。真實模型裡斜著的山谷,對角 Hessian 一樣轉不正,要靠 Shampoo 或 SOAP 那樣的矩陣預條件。
討論
實驗設定
GPT-2 有 1.25 億、3.55 億、7.7 億三個尺寸,用 nanoGPT 的程式在 OpenWebText 上訓練(訓練集約 90 億 token),上下文 1024,批次 480;另有 3,000 萬參數的模型拿來調參。更大的是 GPT NeoX 架構的 15 億與 66 億,在 Pile 上用 Levanter 訓練,上下文 2048。
基準是 AdamW(,weight decay 0.1)、Lion 與 AdaHessian。除了峰值學習率,所有超參數都在 3,000 萬參數的模型上 grid search 後固定。1.25 億與 3.55 億的峰值學習率另外 grid search;更大的模型則往上找到「再大 1.25 倍就會爆掉」的那個學習率。共用設定是 cosine 衰減到峰值的 0.05 倍、2,000 步暖身、梯度範數裁剪 1.0、bf16。Sophia 用 、、weight decay 0.2。
有一個不對稱的細節。AdamW 與 Lion 在 3.55 億以上的模型不穩定,作者替它們加了一個常見的技巧,把注意力分數除以層的索引;Sophia 不用這個技巧。
兩倍從哪裡來
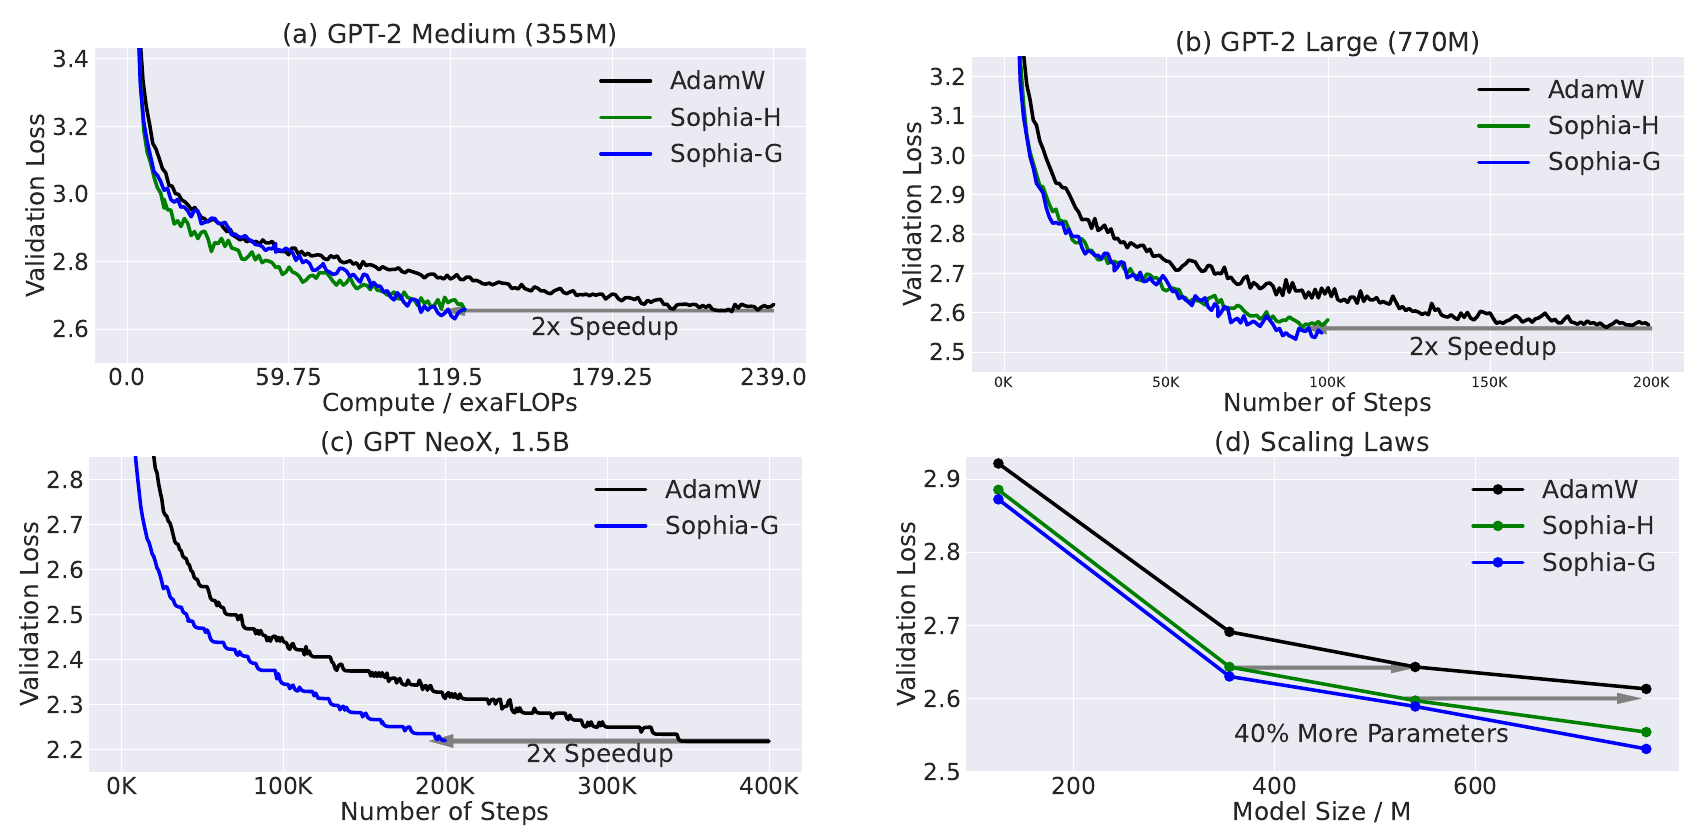
前三張圖的讀法一樣。黑線是 AdamW 跑完整預算,藍、綠線是 Sophia 只跑一半;灰色箭頭從 Sophia 的終點水平拉到 AdamW 的終點,標著「2x Speedup」。圖 (d) 換成看模型大小:同樣訓練 10 萬步,Sophia 的 5.4 億模型比 AdamW 的 7.7 億模型損失還低,換句話說,AdamW 要多用約 40% 的參數才追得上。
同樣步數下的最終損失:
| 模型 | AdamW | Sophia-H | Sophia-G |
|---|---|---|---|
| GPT-2 125M | 2.921 | 2.901 | 2.875 |
| GPT-2 355M | 2.691 | 2.645 | 2.627 |
| GPT-2 770M | 2.613 | 2.554 | 2.524 |
| NeoX 1.5B | 2.250 | – | 2.218 |
| NeoX 6.6B | 1.992 | – | 1.969 |
整理自原論文 Figure 5 圖說;GPT-2 為 10 萬步,NeoX 1.5B 為 20 萬步。
論文說在這個區間,驗證損失低 0.05 大約等於省一半步數。770M 的差距是 0.06 到 0.09,對得上;125M 只差 0.02 到 0.05。66 億參數只有同步數的比較,沒有做「一半步數」的對照。下游任務只測了 SuperGLUE 的四個子任務(2-shot),Sophia 跑 20 萬步和 AdamW 跑 40 萬步的準確率相當。
穩定性與超參數
在 1.25 億參數的 GPT-2 上,三者都用 1.0 的梯度範數裁剪;AdamW 和 Lion 有超過 10% 的步會觸發裁剪,Sophia-H 很少觸發。拿掉注意力縮放技巧後,AdamW 在 3.55 億模型上最大只能用 1.5e-4 的學習率,3e-4 就爆掉,Lion 的上限也從 6e-5 降到 3e-5;Sophia-H 本來就不需要這個技巧。在 3,000 萬參數模型上掃 與 的九種組合,損失都在 3.341 到 3.356 之間。
消融
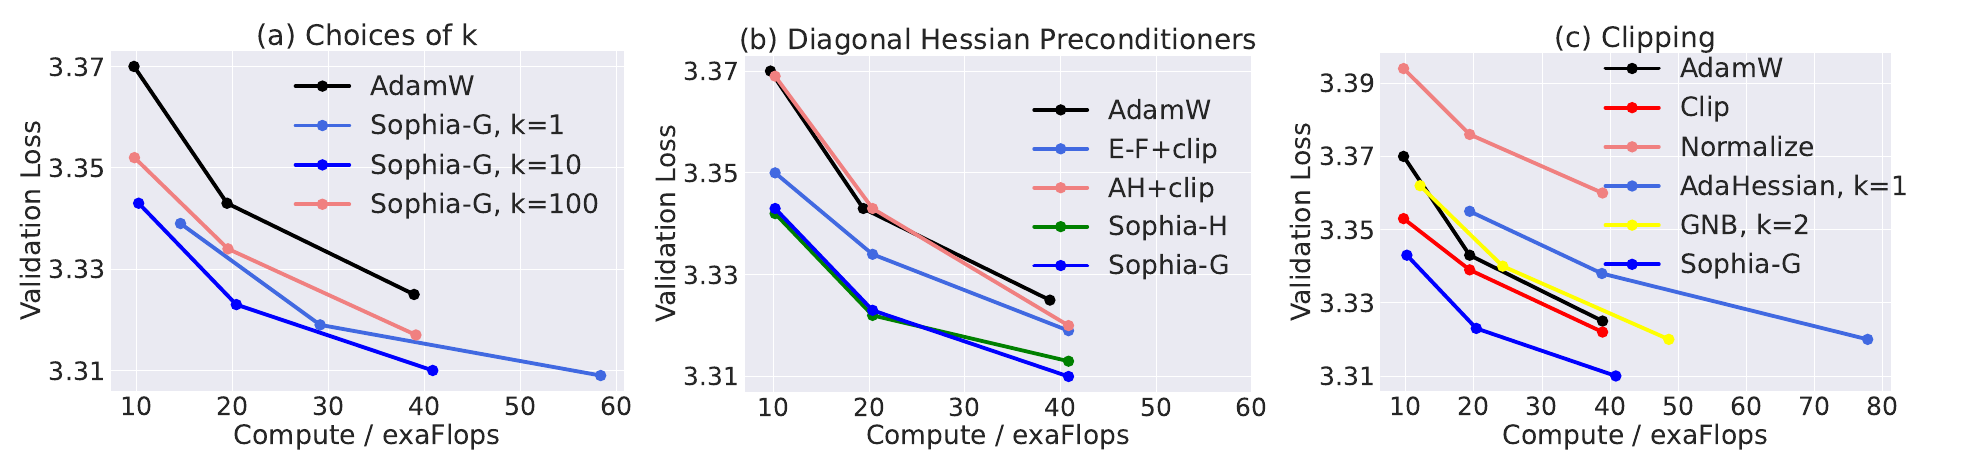
三張圖都是越往左下越好,同樣的計算量損失越低。
(a) 每步都估 Hessian()時,同樣步數的損失最低,但開銷多 50%,以計算量來算反而輸給 ; 仍贏 AdamW,但不如 。
(b) 同樣加上裁剪,GNB 勝過 empirical Fisher,Sophia-H 勝過 AdaHessian。作者推測 Sophia-H 對 Hessian 估計做移動平均,AdaHessian 對 Hessian 估計的平方做移動平均,前者去噪效果較好。
(c) 是最值得細看的一張。紅線「Clip」完全不用預條件,只對動量逐元素裁剪;作者自己說這「essentially the same as sign momentum, or Lion with a single β」。這條線已經贏過黑色的 AdamW。不裁剪的話,AdaHessian 在 、GNB 在 就發散,只好每一兩步估一次。藍色的 Sophia-G 再往下一截。
換句話說,Sophia 的增益有一部分來自 sign momentum 本身,Hessian 再在上面加一層;裁剪是讓 Hessian 能少估幾次的那個保險。
後來被別人量成多少
論文放上 arXiv 後的幾個月內,官方 repo 陸續出現重現不了的 issue。
GitHub 上的重現。 2023 年 6 月 28 日,Aaron Defazio 在官方 repo 開了一個 issue。他在 GPT-2 small 上用 16 張 V100、fp32 訓練,並用 Sophia 的訓練腳本同時跑 AdamW,排除腳本差異;兩者各自掃學習率,最佳都是 1e-3。結果 Sophia-G 2.876、AdamW 2.869,他傾向認為兩者的最終損失差不多。第一作者回覆,fp32 本身就會讓語言模型的損失比 bf16 低,並給了建議設定,他自己的 fp32 Sophia 跑到 2.846;Defazio 照著重跑仍沒有重現,便關了 issue。11 月另一個 issue 照 README 重現 125M,AdamW 跑 20 萬步得到 2.863,比 Sophia-G 跑 10 萬步的 2.897 還低;作者在 2024 年 1 月更新了設定檔。
No Train No Gain(Kaddour 等人,2023)。 這篇把 Sophia、Lion 和幾種「省訓練」的方法放到 BERT 與 T5 的預訓練上,在固定 6、12、24 小時的預算下比較,基準是學習率完全衰減的 AdamW。直接把 Sophia 換進 FP16 的訓練流程會出現 NaN,改成 BF16 才穩;T5 還得加上 RMS 縮放才收斂。24 小時的 BERT,GLUE 平均是 AdamW 77.9、Sophia 72.3;T5 在 SNI 上是 39.5 對 34.1。即使不把 Hessian 估計的時間算進去、跑一樣多步,作者「still do not observe any speedup」。
Zhao 等人(2024)。 在自迴歸語言模型上比較 SGD、Adafactor、Adam、Lion、Sophia,結論是除了 SGD 以外都差不多。附錄裡他們把 Sophia 和 Signum(帶動量的 sign 更新,等於 Sophia 把 設成 0)對比,Sophia 沒有贏。
Fantastic Pretraining Optimizers(Wen 等人,2025)。 作者群裡的 David Hall、Tengyu Ma、Percy Liang 也是 Sophia 的作者。他們在 1.3 億到 5.2 億參數上重新調參比較,Sophia 在小計算量時輸 AdamW,模型或資料變大後才稍微領先,0.5B 以下沒有顯著提速。他們也交代了原因。Sophia 論文的流程「largely follows the correct procedure」,基準的峰值學習率確實調過;但當時程式的 data loader 沒有完全打亂資料,在那個程式裡 AdamW 的最佳學習率被壓得很小。資料一旦完全打亂,AdamW 就能用大得多的學習率。
結論
Sophia 用每 10 步估一次的對角 Hessian 當分母,再用逐座標裁剪把每一步的移動上限鎖在 。估錯、負曲率或曲率太小的座標,自動退回帶動量的 sign 更新。在論文的設定裡,GPT-2 與 15 億參數的 NeoX 都用一半步數追上 AdamW,每步只慢約 5%。
這篇留給實作者最有用的,反而是那條量測規則。下次看到「快兩倍」,先確認基準的學習率是不是在同樣的總步數、同樣完全打亂的資料下調到最好,再看新方法是不是只比較最終檢查點。用 Sophia 的話,盯著被裁剪座標的比例調 ,混合精度選 bf16。
(論文自己的消融裡,把 Hessian 拿掉、只留裁剪,就已經贏 AdamW;後來 Zhao 等人的比較裡,Sophia 也確實沒有勝過 Signum。)