原始论文
Decoupled Weight Decay Regularization
- 发表版本
- ICLR 2019会议
- arXiv 首次提交
- arXiv:1711.05101
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizersadamw2017,
  title = {{Decoupled Weight Decay Regularization}},
  author = {Ilya Loshchilov and Frank Hutter},
  year = {2017},
  eprint = {1711.05101},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1711.05101}
}
下面两行 PyTorch,参数名称一样,数字也一样:
torch.optim.Adam(model.parameters(), lr=1e-3, weight_decay=1e-2)
torch.optim.AdamW(model.parameters(), lr=1e-3, weight_decay=1e-2)
第一行把 1e-2 当成 L2 正则化的系数,加进梯度里,再交给 Adam 处理;第二行则在每一步把参数直接乘上 ,和梯度无关。两者训练出来的模型不一样。
2017 年 11 月,弗莱堡大学的 Ilya Loshchilov 与 Frank Hutter 指出这个区别时,常见的框架实现的都是第一种写法,而且都把它叫做 weight decay。
他们的主张是,Adam 在图像分类上泛化输给 SGD,有很大一部分原因出在这里。
定义问题
两种「衰减」
权重衰减(weight decay)在 Hanson 与 Pratt 1988 年的定义里,是每一步把权重乘上一个略小于 1 的数,再做梯度更新(论文 Eq. 1):
L2 正则化则是在损失函数上加一项 ,它的梯度是 。用 SGD 更新时:
和上一式比对,只要 ,两者完全相同。这是论文的 Proposition 1,也是大家长期把两个名词混用的原因。
但这个等式藏着一件常被忽略的事。如果某个问题有一个最好的衰减量 ,那么最好的 L2 系数 就和学习率绑在一起;学习率一改,L2 系数也得跟着改。就连在 SGD 里,这两个超参数也是耦合的。
换成 Adam 呢?
Adam 会把梯度除以 。若把 L2 写进梯度, 这一项也会被一起除掉。
2017 年 5 月,Wilson 等人发现 Adam 在多个任务上泛化不如 SGD;当时图像分类的最好成绩也都还是用 SGD 加动量训练的。对这个差距有过几种解释,例如尖锐的极小值、自适应方法本身的问题。这篇提出另一个比较具体的假设,问题可能出在框架实现的「weight decay」,在 Adam 里根本不是权重衰减。
解决问题
在 Adam 里不等价
把 Adam 写成一般的形式,, 是预条件矩阵;SGD 的 是单位矩阵,Adam 的是 再加上动量。两种做法的一步分别是:
要两式相等,必须对所有 都有 ,这只有在 是单位矩阵的常数倍时才可能。Adam 的 每个坐标都不一样,所以找不到任何 让 L2 等于权重衰减。这是 Proposition 2。
差在哪里?用两个参数算一下。假设它们当前的值都是 1,梯度的典型大小()一个是 1、一个是 0.01,L2 系数取 。先忽略动量,也假设 小到不影响 :
| 参数 | L2 的衰减量 | AdamW 的衰减量 | |
|---|---|---|---|
| A | 1 | ||
| B | 0.01 |
本文计算。AdamW 一列依 PyTorch 的写法,衰减量是 ,取 。
L2 的衰减量要先除以 ,梯度大的参数 A 被衰减的量只有梯度小的参数 B 的百分之一。论文的说法是,在 L2 之下,历史梯度大的权重被正则化得比较少。权重衰减则让每一个权重以相同比例缩小。
Proposition 3 把这个区别写成一个式子。如果预条件矩阵固定为 ,那么权重衰减等价于一个按梯度尺度加权的 L2:
大的参数(历史梯度大),被正则化得比普通 L2 更多。惩罚项是 ,所以每个坐标的惩罚权重和 成正比。实际的 Adam 每一步都会换预条件,这个命题不能直接套用,但它说明了两种做法在优化什么样的目标。
Algorithm 2 的两种写法
修正的方法是把衰减从梯度里拿出来,直接作用在参数上。论文把两种写法并排放在同一个算法里,用颜色标出各自多出来的那一项;这里改用下方的标注区分:
只保留第一行标着 Adam+L2 的那一项,就是 Adam 加 L2;只保留最后一行标着 AdamW 的那一项,就是 AdamW。默认值和 Adam 相同,、、、。
是学习率调度的倍率,可以固定、递减,或像后面的 AdamWR 一样周期性重启。请留意最后一行,衰减项 乘上了 ,却没有乘上基础学习率 。论文的「解耦」指的就是这件事, 不再随 改变含义。这个细节在框架实现里会有不同的处理,讨论时再回来看。
SGD 版本(SGDW,Algorithm 1)同理。L2 写在梯度里,;SGDW 则在最后一行改成 。在 SGD 里两者本来可以互换,SGDW 的用处是让 不必随 重新调整;带动量时两者也不再完全相同,因为 L2 项会跟着动量累积。
写成代码,区别只在两行。下面照 PyTorch 2.15 文档列出的算法,写一个单一张量的版本:
def adam_step(p, grad, m, v, t, lr=1e-3, betas=(0.9, 0.999), eps=1e-8,
              weight_decay=0.0, decoupled=False):
    b1, b2 = betas
    if weight_decay and not decoupled:
        grad = grad + weight_decay * p        # Adam + L2:衰减项混进梯度,之后会被 sqrt(v_hat) 除掉
    if weight_decay and decoupled:
        p.mul_(1 - lr * weight_decay)         # AdamW:参数直接按比例缩小,不进入 m 和 v
    m.mul_(b1).add_(grad, alpha=1 - b1)
    v.mul_(b2).addcmul_(grad, grad, value=1 - b2)
    m_hat = m / (1 - b1 ** t)
    v_hat = v / (1 - b2 ** t)
    p.add_(-lr * m_hat / (v_hat.sqrt() + eps))
decoupled=True 那一行用的是 lr * weight_decay,论文用的是 。这个差异先记着。
为什么是权重衰减
第 3 节引用 Aitchison 2018 的贝叶斯滤波观点,为权重衰减找了一个理由。把随机优化看成在追踪每个参数的后验分布,状态转移假设为 ;令 ,每一步就是把当前的估计乘上 ,正是解耦的权重衰减。这个衰减作用在先验上,和每个参数的不确定性无关;如果要得到 L2 的效果,衰减量反而得随不确定性改变。作者也说明,这个理论完全归功于 Aitchison,他们只是做了摘要。
归一化的权重衰减
作者在实验中发现,最好的权重衰减会随训练长度改变,训练越久,最好的 越小。附录 B.1 提了一个归一化的写法:
是批量大小, 是训练样本数, 是总 epoch 数。 可以理解成「整个训练只跑一个批量时」的衰减量。
用 CIFAR-10 算一下,、。训练 100 个 epoch 时,;训练 1800 个 epoch 时约 0.0012,实际的 要小 倍。换到 ImageNet32x32,一个 epoch 是 CIFAR-10 的 24 倍长,同样的 epoch 数下 要再小约 倍;作者说,如果直接沿用 CIFAR-10 的原始 ,在 ImageNet32x32 上大约会大 5 倍,结果差很多。用归一化的写法,最佳的 在不同训练长度、不同数据集,甚至 SGDW 和 AdamW 之间都很接近,例如 0.025 与 0.05。
作者也强调,平方根只是少数实验下的一种选择,可靠的结论是「做某种归一化」本身就能大幅改善结果。
AdamWR
最后一个组件是学习率调度。作者先前提出的 SGDR 用余弦退火搭配周期性重启:
是距离上次重启过了几个 epoch,每个批量都会更新,所以不一定是整数; 是这一轮的长度。取 、,学习率倍率在每一轮从 1 沿余弦降到 0,然后跳回 1。第一轮 、每轮长度乘以 ,重启就发生在第 100、300、700、1500 个 epoch,每次重启前的那个模型就是推荐的解。
他们早就试过把重启用在 Adam 上,但当时比不过 SGDR,原因正是 L2 在 Adam 里的效果不如在 SGD 里。修好权重衰减、再加上归一化(让长短不一的每一轮能共用同一组设置),AdamW 加上重启就是 AdamWR。
讨论
实验设置
实验沿用 Shake-Shake 正则化论文的设置与代码,主要模型是深度 26、两个残差分支的 ResNet,第一个残差块宽度 64(2x64d,1,160 万个参数)或 96(2x96d,2,560 万个参数);批量大小固定为 128,用 CIFAR-10 的标准数据增强。另外用 ImageNet32x32,也就是把 ImageNet 的 120 万张图像缩成 。
第一组实验只比较 Adam 与 AdamW,搭配三种学习率调度(固定、在第 30、60、80 个 epoch 降低、余弦退火),各自扫过学习率与衰减量的网格,训练 100 个 epoch。不论哪一种调度,解耦的权重衰减都比 L2 好,调度越好,差距越大;余弦退火明显最好,之后的实验都用它。这个结果也说明,Adam 虽然已经为每个参数调整学习率,再加一个全局的学习率调度仍然有帮助。附录 D 还把传统的 Adam(L2 加固定学习率)训练到 1800 个 epoch,在 4×4 的粗网格上,最好的结果也只和 AdamW 用十八分之一的 epoch、较小的网络差不多。
学习率与权重衰减的热力图
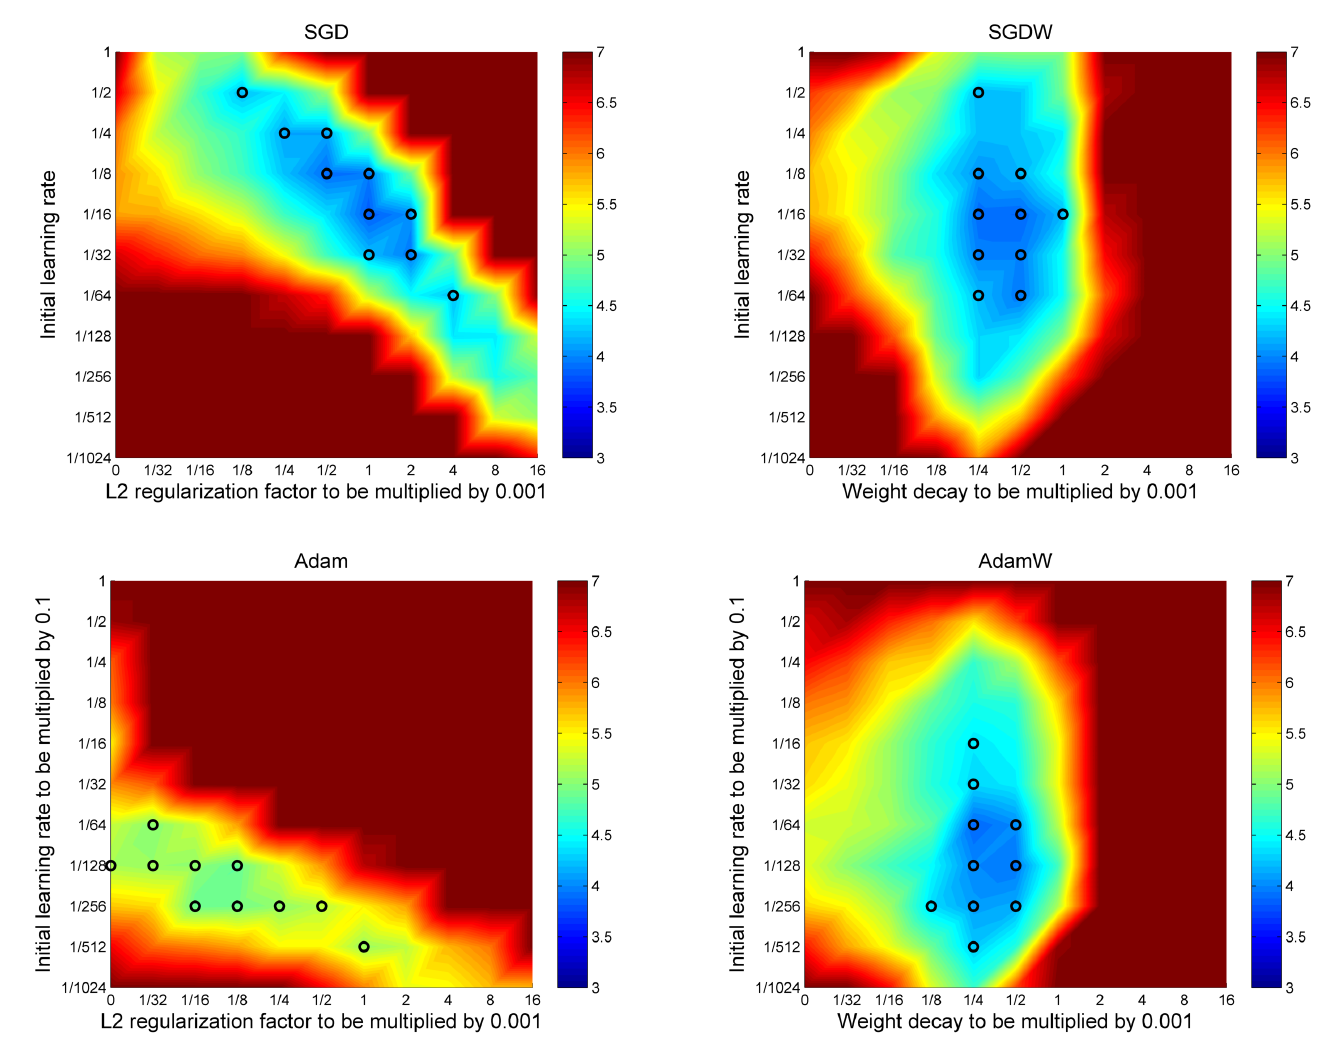
这张图是整篇论文的核心证据。四张图都是 26 2x64d 的 ResNet 在 CIFAR-10 上训练 100 个 epoch 的测试错误率;纵轴是初始学习率,横轴是 L2 系数或权重衰减,颜色越蓝越好,黑圈是最好的 10 组设置。
左上,SGD 加 L2。 好的区域是一条斜带。例如最左上角那个黑圈在 、,只改其中一个都会变差,两个一起改还可能更好。这正是 Proposition 1 说的 ,学习率一变,最好的 L2 系数就跟着变。作者认为,SGD「对超参数很敏感」的名声,可能有一部分来自这种耦合。
右上,SGDW。 好的区域变成竖直的一条,黑圈大多落在衰减量 1/4 到 1/2(再乘 0.001)之间,跨过五个不同的学习率。就算学习率没调好,例如停在 1/1024,只调衰减量也能找到不错的值。
左下,Adam 加 L2。 最好的结果明显比 SGD 差。再看黑圈的位置,L2 系数为 0 的设置也在前十名里,加了 L2 的最好结果和完全不加差不多。换句话说,L2 在这里几乎没有作用,好的区域同样是斜的。
右下,AdamW。 好的区域和 SGDW 一样是竖直的,黑圈集中在衰减量 1/4 到 1/2;最好的结果明显优于 Adam 加 L2,和 SGD、SGDW 不相上下。
所以这张图同时支持两件事。解耦之后,学习率和权重衰减大致可以分开调;Adam 改用解耦的权重衰减后,在这个任务上追上了 SGD。
是泛化变好,还是只是训练得更好
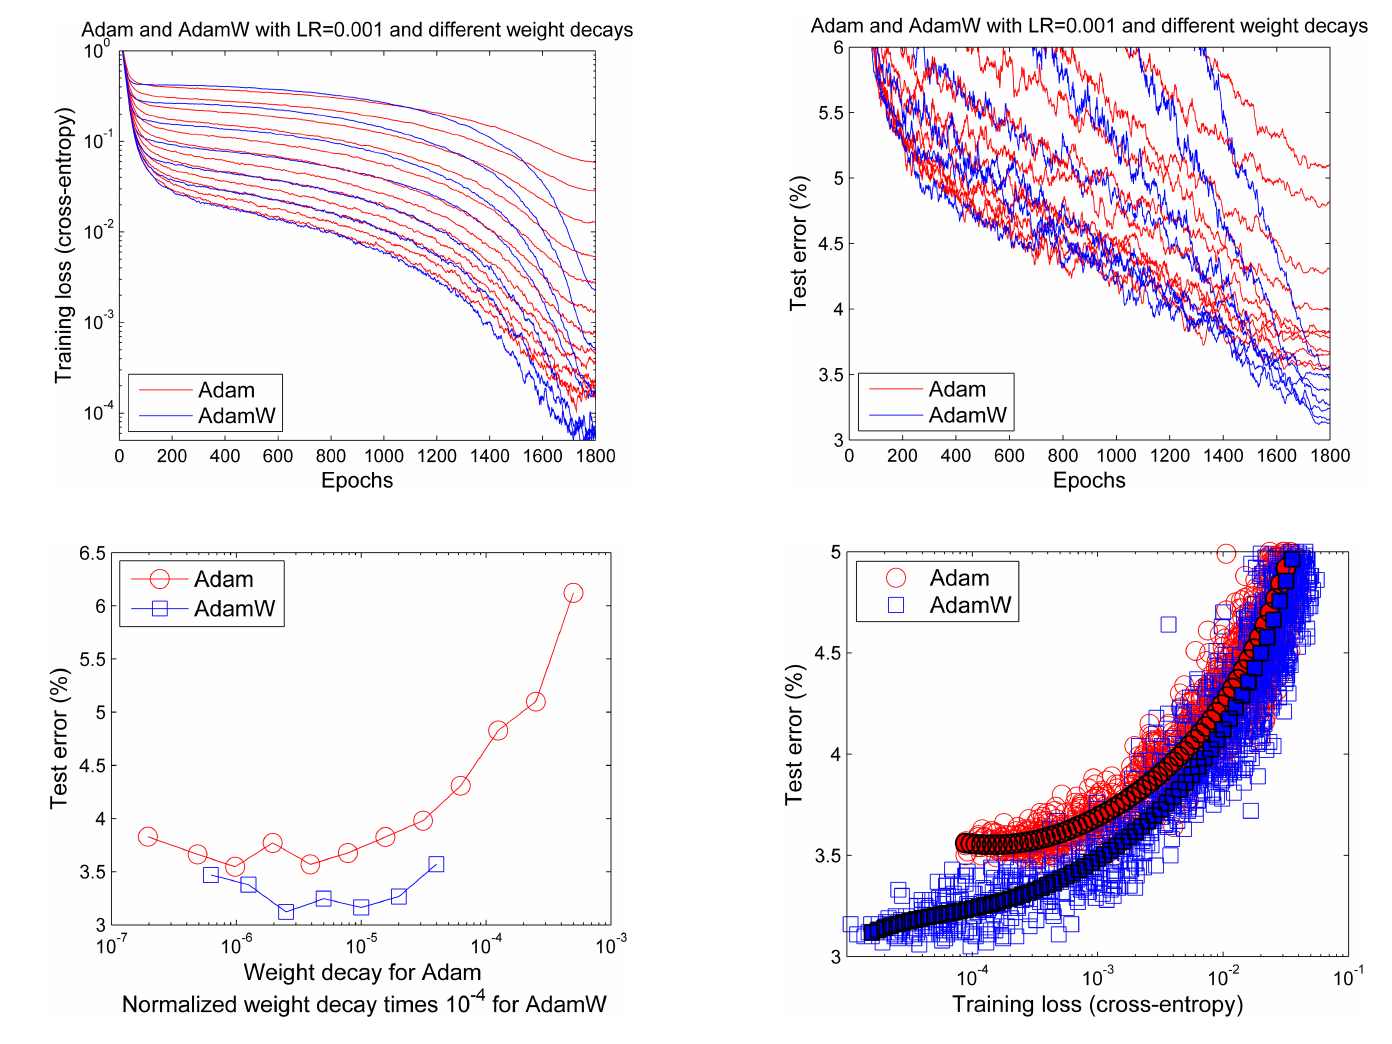
热力图只训练了 100 个 epoch。作者接着把较大的 2x96d 训练到 1800 个 epoch,初始学习率固定在 Adam 的默认值 0.001(调度仍是余弦退火),Adam 加 L2 试 12 种系数,AdamW 试 7 种归一化的衰减量。
上排的学习曲线,前半段两组常常重叠,后半段 AdamW 的训练损失和测试错误率通常比较低。左下是最终的测试错误率,Adam 加 L2 最好约 3.55%,AdamW 最好约 3.1%。
右下这张回答了标题的问题。横轴是训练损失,纵轴是测试错误率;如果 AdamW 只是把训练损失降得更低,两组点应该落在同一条曲线上。实际上,在同样的训练损失下,蓝色 AdamW 的测试错误率比红色 Adam 低。作者据此认为,AdamW 除了训练得更好,泛化也更好。ImageNet32x32 上的结果相同。
热重启与随时可用的结果
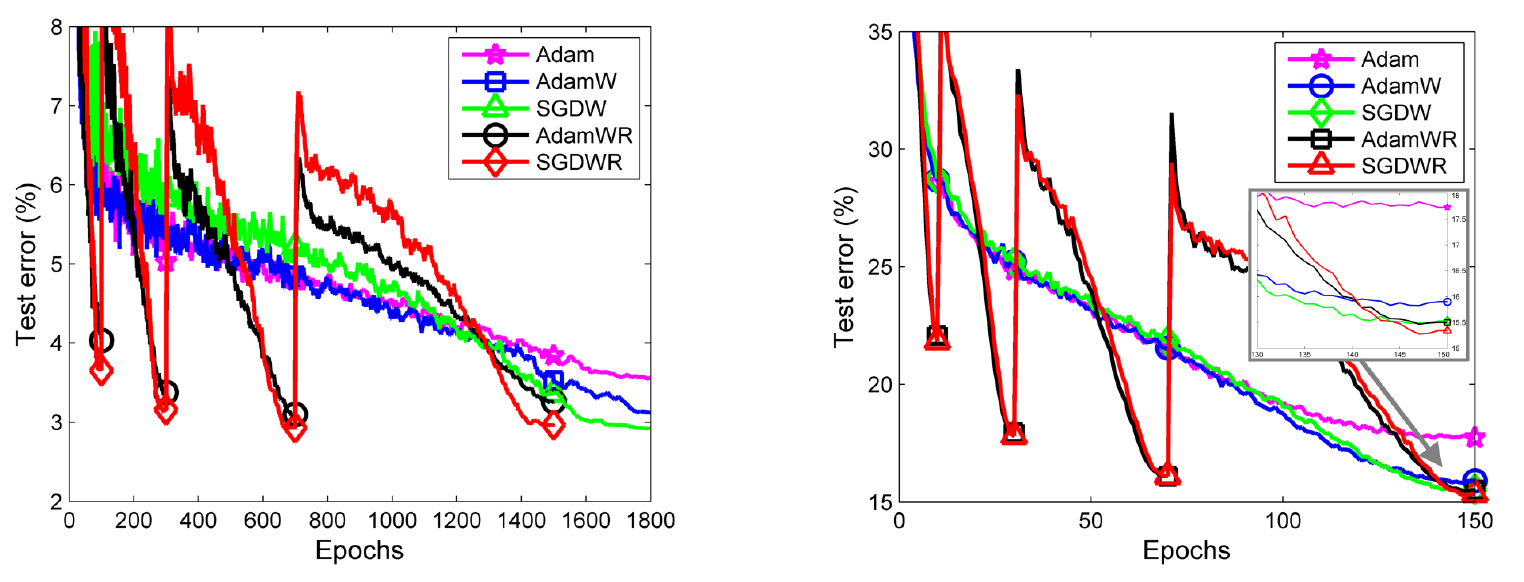
最后比较加上热重启的版本。左图是 CIFAR-10,带 R 的两条线每次重启就跳高,然后很快降到一个低点;第一次重启前(第 100 个 epoch),AdamWR 已经达到约 4.0%,作者说这让 AdamW 的速度最多快了 10 倍。这就是论文说的「随时可用」(anytime),训练到一半停下来,也有一个不错的模型。
论文报告,在默认学习率 0.001 下,AdamW 的测试错误率比 Adam 相对降低 15%,CIFAR-10 和 ImageNet32x32 都是如此;AdamWR 达到同样的结果,而且随时可用。从左图读,CIFAR-10 上 Adam 停在约 3.6%,AdamW 约 3.1%。AdamWR 把 Adam 和 SGDWR 之间的差距缩小了一大半,在 ImageNet32x32 上则两者相当。
其他任务与局限
第 4.5 节收集了其他团队的使用反馈。脑电分类的团队提供了同一组超参数下的直接比较,Deep4Net 从 71.37% 升到 73.68%,ResNet 从 61.34% 升到 72.04%;OpenAI 2018 年的 GPT 用 AdamW 训练 Transformer;Zhang 等人在 CIFAR 上比较 SGD、Adam、K-FAC,凡是 L2 和权重衰减不等价的情况,解耦的权重衰减都比较好。
局限也很清楚。主要实验都是图像分类,作者在结论里写道,这些结果还要在更多任务上验证,尤其是正则化很重要的任务。归一化权重衰减的平方根规则,也只来自少数几组实验。
学习率又乘了回来
回到前面那行 lr * weight_decay。
论文的 AdamW,衰减量是 ,只跟着调度倍率走,不乘基础学习率 。PyTorch 的 AdamW 是 , 是包含调度的实际学习率,所以衰减量是 。Optax 的 adamw 也是如此,它的文档明确写着,这里的权重衰减会乘上学习率,和 PyTorch 一致,但和论文只乘调度倍率的做法不同;Keras 的 AdamW 也是把参数减去 variable * wd * lr。
换算起来,论文的 等于 PyTorch 的 lr × weight_decay。PyTorch 默认 lr=1e-3、weight_decay=1e-2,每步衰减 ,相当于论文写法里的 。各家的默认值也不一样,PyTorch 是 0.01,Optax 是 ,Keras 是 0.004,搬超参数时要先确认是哪一种写法、哪一个默认值。
这个差异带来一个实际的后果。用 PyTorch 的写法,改学习率就等于同时改了衰减量,前面热力图里「两个超参数可以分开调」的性质不再完全成立。Fabian Schaipp 在 2024 年 2 月的一篇博客文章里用一个合成的岭回归问题演示了这件事,建议用 PyTorch 的 AdamW 扫学习率时,让 lr × weight_decay 保持不变,学习率加倍,衰减就减半;他也提到在 timm 上训练 ViT 的经验与此一致,但那部分没有公开实验。Wang 与 Aitchison 2024 年换一个角度看,AdamW 学到的权重可以看成最近更新的指数移动平均,时间尺度大约是 步;他们在 ResNet、ViT 与 NanoGPT 上发现,以 epoch 计的最佳时间尺度大致固定,所以数据集变大时,权重衰减应该跟着变小。这和论文归一化权重衰减的方向一致。
也有框架保留论文的写法,例如 MosaicML Composer 的 DecoupledAdamW,衰减量只乘上「当前学习率除以初始学习率」,也就是调度倍率。另外,PyTorch 的 Adam 本身也有 weight_decay,那是 L2;要在 Adam 里得到 AdamW 的行为,得另外设 decoupled_weight_decay=True。
后来的事
AdamW 后来成了训练 Transformer 的标配。LLaMA 用 AdamW,、权重衰减 0.1;OLMo 2 甚至把嵌入层从权重衰减里排除;DeepSeek-V4 把大部分参数交给 Muon,嵌入层、预测头与归一化层的权重仍然用 AdamW。
结论
这篇论文证明,L2 正则化与权重衰减只在 SGD 里等价,而且要依学习率换算系数;在 Adam 里,L2 的梯度会被 除掉,历史梯度大的权重被正则化得比较少。把衰减移出梯度、直接作用在参数上,就是 AdamW。CIFAR-10 的热力图显示,这让学习率和权重衰减大致可以分开调,Adam 的最好成绩也追上了 SGD;1800 个 epoch 的比较则显示,在同样的训练损失下 AdamW 的测试错误率更低。证据主要来自图像分类的 ResNet,归一化规则也只做了少数实验。
实际用的时候,先确认你用的是哪一个 AdamW。PyTorch、Optax、Keras 的衰减量都是学习率乘上 weight_decay,论文与 Composer 的版本只乘调度倍率;从论文或其他框架搬设置时,记得换算。在 PyTorch 里扫学习率,可以让 lr × weight_decay 固定,而 torch.optim.Adam(weight_decay=...) 从头到尾都是 L2。
论文第一版的题目叫〈Fixing Weight Decay Regularization in Adam〉,修好的版本后来成了大语言模型的标配。只是最普及的几个实现,又把学习率乘回了衰减项里。