原始论文
Adam: A Method for Stochastic Optimization
- 发表版本
- ICLR 2015会议
- arXiv 首次提交
- arXiv:1412.6980
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizersadam2014,
  title = {{Adam: A Method for Stochastic Optimization}},
  author = {Diederik P. Kingma and Jimmy Ba},
  year = {2014},
  eprint = {1412.6980},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1412.6980}
}
这篇论文第一页的脚注写着,两位作者贡献相同,作者顺序是在 Google Hangout 上抛硬币决定的。
抛完硬币之后,Diederik Kingma 排在前面,Jimmy Ba 排在后面,论文在 2014 年 12 月发布到 arXiv。Algorithm 1 的说明文字里有一句「Good default settings for the tested machine learning problems」,后面跟着四个数字,、、、。
十年后打开 PyTorch,torch.optim.Adam 的默认值还是这四个数字。
这篇笔记要把 Algorithm 1 的每一行拆开来看。两个移动平均各在估计什么?为什么要除以 ?一步到底走多远?论文的实验证明了哪些事,又有哪一段后来被推翻?
定义问题
训练神经网络时,我们手上只有小批量算出来的梯度,每一步都带着噪声;dropout 之类的正则化又额外加了一层随机性。参数动辄上百万,二阶方法太贵,论文一开始就把范围限定在一阶方法。
最基本的 SGD 对所有参数用同一个学习率。问题是不同参数的梯度大小可以差好几个数量级,同一个学习率,对某些参数太大,对另一些又太小。
当时已经有两条路在处理这件事。
- AdaGrad 为每个参数记下历史梯度平方的总和,用它的平方根去除梯度,。很少出现的特征,梯度平方和小,步伐就大,在稀疏数据上特别有效。代价是总和只增不减,学习率会一路变小。
- RMSProp 把总和换成指数移动平均,只看最近一段时间的梯度。学习率不会一路变小,也比较能应对目标函数随时间改变的情况。
Adam 想要两边的好处。论文第 5 节还指出,RMSProp 没有偏差修正。当 接近 1(稀疏梯度正需要这种设置),没有修正的 RMSProp 一开始的步伐会非常大,常常直接发散。
所以这篇要回答的是,能不能做出一个只用一阶梯度、内存只多占两份参数大小的优化器,同时处理稀疏梯度与会变动的目标,而且在训练一开始就走得稳。
解决问题
Algorithm 1
先把整个算法写出来。所有运算都是逐元素的, 指 , 是 的 次方:
一开始 、,每一轮先把 加一。
是梯度的指数移动平均,论文称为一阶矩的估计,也就是梯度的均值; 是梯度平方的指数移动平均,是二阶矩(未减去均值的方差)的估计。Adam 这个名字取自 adaptive moment estimation(致谢里说,是 Ivo Danihelka 和 Tom Schaul 想出来的)。
更新量是 。分子决定方向,而且因为是移动平均,带有动量的效果;分母为每个参数换算出一个自己的尺度。这相当于每个参数有自己的学习率 ,只是这个学习率每一步都会根据最近的梯度重新估计。
论文还给了一个计算量更小的写法,把两次修正合并成一个系数:
两种写法只差在 加的位置,这里的 和 Algorithm 1 的 是不同的量。这个小差异后来留在了各家框架里,讨论时再回来看。
偏差修正
中间那两行除法,是这篇论文和 RMSProp 最大的区别,也是第 3 节专门推导的内容。
把 的递推式展开,它是过去所有梯度平方的加权和:
两边取期望。假设梯度平方的期望不随时间改变,就可以把 提出来,剩下的是一个等比数列求和:
如果二阶矩真的不随时间改变,;就算会变,只要 让太久以前的梯度权重足够小, 也不会太大。剩下的 完全是从 起步造成的,除掉它,估计就回到正确的尺度。 的推导一模一样。
用默认值算一下第一步。 时:
- ,只有真实值的十分之一;
- ,开根号后是 ,只有真实尺度的三十分之一左右。
两个都偏小,但 偏得更多。如果不修正,第一步的大小是 。修正之后,、,每个参数的第一步刚好是 。
这就是 Adam 的第一步。不管梯度是 还是 ,每个参数都只走 。
那不修正的话,偏大的步伐会持续多久?假设每一步的梯度都一样,没有修正时的步长就是 。我们把它画出来。
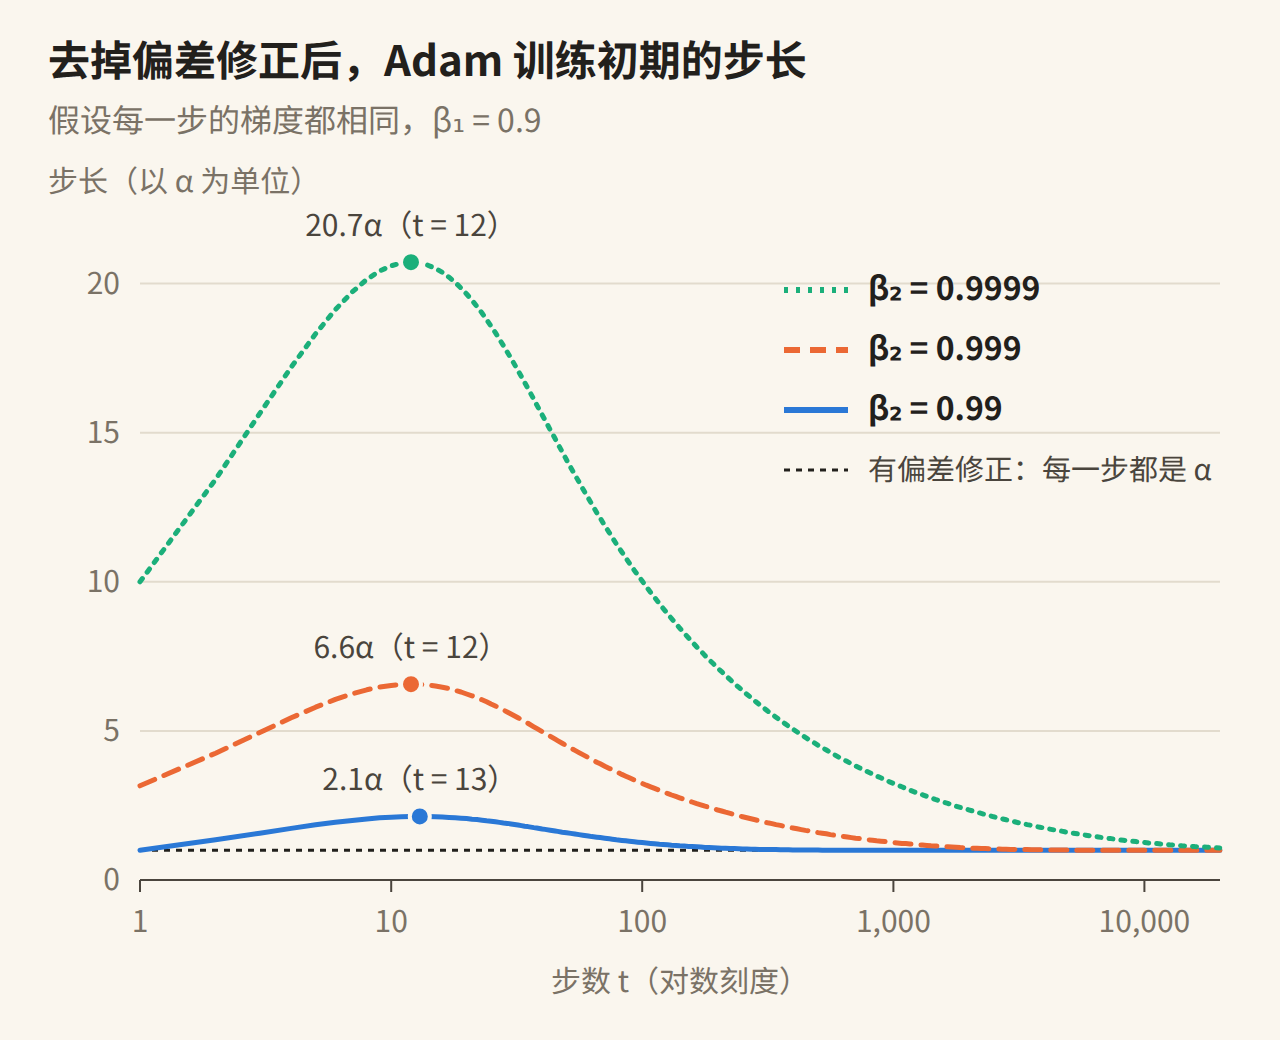
三条线都在第 12、13 步左右到达最高点。这时 已经累积到真实值的七成左右; 在 时却只累积了约 1%,开根号后也只有一成多。分子追上来了,分母还没有。 时最高是 ,要到一千七百多步才回到 以内; 时最高是 ,要一万七千多步。
如果再把动量去掉(),没有修正的第一步就是 , 时是 。学习率明明设成 ,第一步却相当于用了 。
这正是论文说的情况。稀疏梯度需要很大的 才能平均到足够多的样本,而 越接近 1,没有修正的初始偏差就越严重。
一步走多远
第 2.1 节接着分析更新量本身。先令 ,每一步的有效步长是 。
是「梯度的均值」除以「梯度平方均值的平方根」。因为 ,这个比值的绝对值通常不超过 1,所以 大致被 限制住。
有一个例外。如果某个参数的梯度一直是 0,只有这一步突然有值, 大约是 , 大约是 ,比值变成 。论文给的上界因此分两种情况:
用默认值代进去, 大于 ,所以默认设置落在第一种情况,最坏是 。这只会发生在极端稀疏的参数上;论文说,稀疏程度没那么极端时,有效步长会比这个小。
这个性质带来三个实用的结果。
- 就是步伐的大小。 它大致就是每一步在参数空间里走的距离,论文把它比作在当前参数周围画出一个信赖域。如果我们大概知道好的解离初始值有多远,就能估出 的数量级。
- 和梯度的尺度无关。 把梯度乘上 , 变成 倍, 变成 倍,比值不变。把损失函数乘上 1000,SGD 的步伐跟着放大 1000 倍,Adam 完全不受影响。
- 自动退火。 论文借用「信噪比」这个词来称呼 。靠近最优解时,梯度方向常常来回变号,均值接近 0,平方的均值却还在,比值变小,步伐也跟着变小。
和 AdaGrad、RMSProp 的关系
第 5 节把 Adam 放回原来的家族里比较。
和 RMSProp 比,有两个区别。带动量的 RMSProp 是先把梯度除以尺度,再对除完的结果做动量;Adam 是分别估计梯度的一阶矩与二阶矩,再相除。另一个区别就是偏差修正。
和 AdaGrad 比,关系更有意思。令 、让 趋近 0,并把学习率换成 ,有偏差修正的 会变成 ,代回更新式刚好就是 AdaGrad。这个对应只有在保留偏差修正时才成立;去掉修正, 趋近 1 会让 趋近 0,更新量变成无穷大。
论文也提到, 可以看成 Fisher 信息矩阵对角线的近似,Adam 相当于用它的平方根的倒数做预条件(preconditioning)。比起自然梯度直接用 Fisher 矩阵的逆,这个做法保守一些。
AdaMax
第 7.1 节是一个延伸。Adam 用梯度的 范数缩放,作者把它推广到 :
大的时候数值不稳定,但让 ,令 ,加权总和里只剩最大的那一项,得到一个很简单的递推式:
是「打过折的历史最大梯度」。某一步出现 , 就变成 10,之后每步乘上 0.999,一千步后还剩约 3.7。它不需要偏差修正,因为 至少等于当前的 ,不会从 0 慢慢爬上来。步长的上界也更简单,。论文建议的默认值是 ,、 和 Adam 相同。
另外,第 7.2 节提了参数的指数移动平均 ,同样用 修正初始偏差。
收敛证明
第 4 节用在线凸优化的框架分析 Adam。每一步面对一个事先未知的凸函数 ,衡量标准是遗憾(regret),也就是累积损失和事后看来最好的固定参数相比多了多少:
Theorem 4.1 的条件很多。梯度有界、迭代点之间的距离有界、,学习率用 递减, 也要随时间以 衰减。在这些条件下,论文得到 的遗憾,平均遗憾 趋近 0。
实际训练很少照这组条件跑 Adam,学习率常常固定或用其他调度, 也固定在 0.9。论文自己在第 6.2 节也承认,这个分析不适用于神经网络这类非凸问题。
这个定理后来被证明有误。2018 年 Reddi、Kale 与 Kumar 指出,附录的证明在某一步把 当成不会是负数来处理。这个量是「有效学习率的倒数」随时间的变化,Adam 的 是移动平均,会随着梯度变小而变小,所以它可以是负的。他们同时指出引理 10.3、10.4 也有问题,并构造了一个满足定理条件的一维凸问题,Adam 在上面收敛到最差的那个点。
讨论
逻辑回归、多层感知机与卷积网络三组实验都用批量大小 128,比较不同优化器时使用相同的初始参数;学习率、动量等超参数在一个密集的网格上搜索,报告最好的那组。论文只画了损失曲线,前三组明确写的是训练损失,没有测试准确率。读图时要记住这一点,这些实验比的是「谁把训练损失降得快」。
逻辑回归
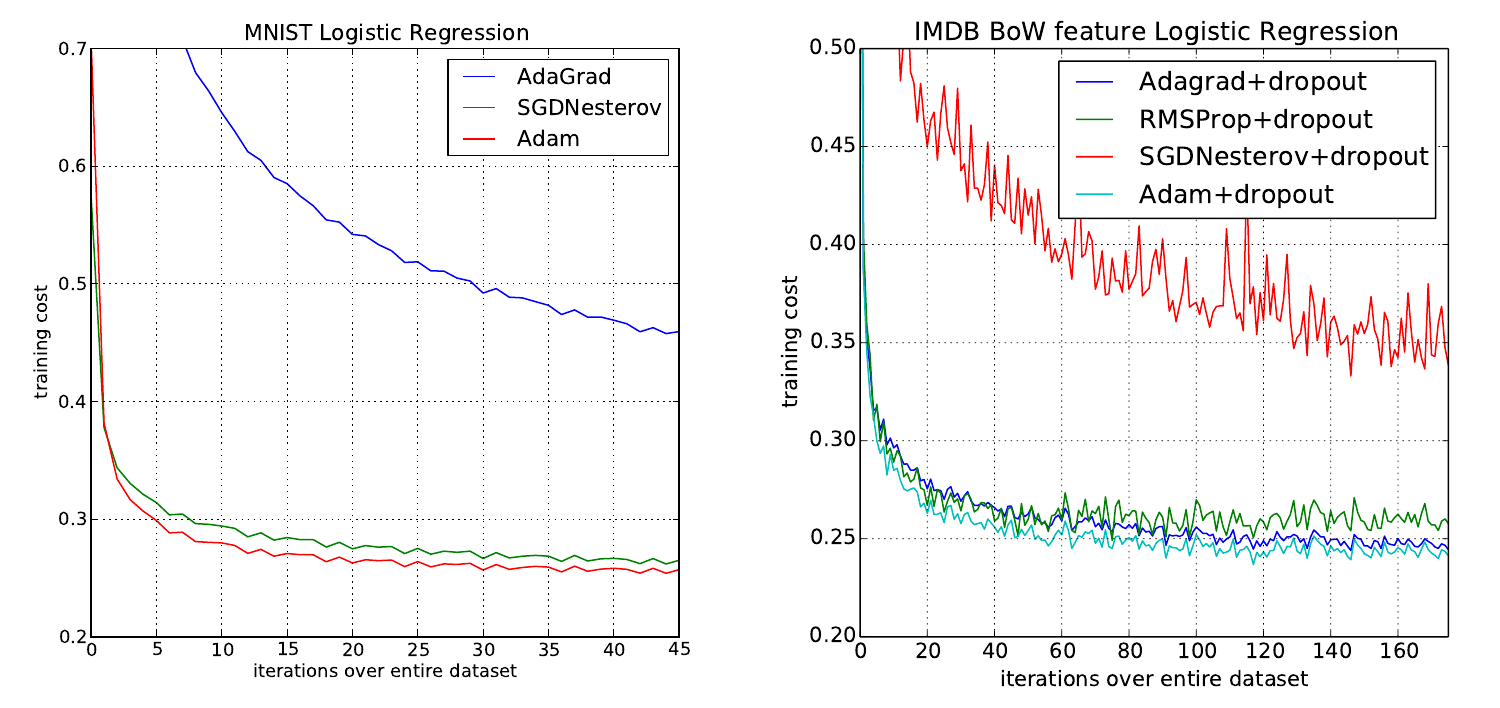
逻辑回归是凸问题,不必担心局部极小值,适合单纯比较优化器。这组实验的学习率照第 4 节的理论用 递减。
左图是 MNIST,直接拿 784 维的像素向量分类。Adam 和 SGD 动量差不多,两者都比 AdaGrad 快很多。
右图才是 Adam 想证明的事。作者把 IMDB 影评转成前 10,000 个常用词的词袋向量,每一篇影评只用到其中很少的词,是很稀疏的特征;为了防止过拟合,特征上加了 50% 的 dropout。在这里 AdaGrad 大幅领先 SGD,Adam 和 AdaGrad 一样快。稀疏特征上的优势,Adam 继承了下来。
多层感知机
接着是两层、每层 1000 个 ReLU 单元的全连接网络,同样用 MNIST。加了 dropout 的版本,Adam 的训练损失低于 AdaGrad、RMSProp、SGD 动量与 AdaDelta。
不加 dropout、改用 L2 权重衰减的版本,作者另外和 SFO 做了比较。SFO 是一种以小批量运行的拟牛顿法,每一步要更新曲率信息,速度比 Adam 慢 5 到 10 倍,内存还要随小批量的数量线性增加。不论按迭代次数还是按实际耗时计算,Adam 都比它快;而 SFO 假设每个子函数是确定性的,遇到 dropout 就不收敛。
卷积网络
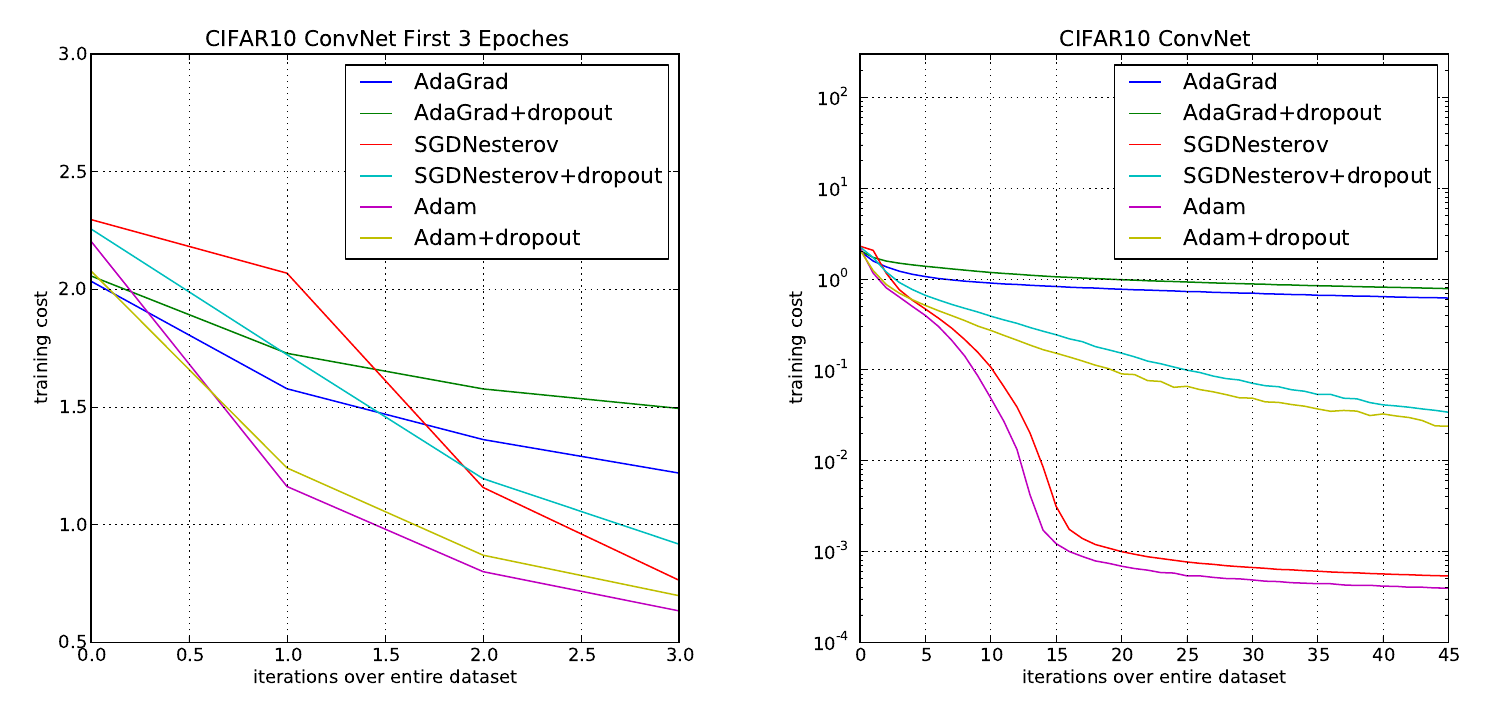
网络是三段 卷积加步长为 2 的 最大池化,通道数 64、64、128,最后接 1000 个 ReLU 的全连接层;输入先做白化,输入层与全连接层加 dropout。
左图的前 3 个 epoch,Adam 和 AdaGrad 都下降得很快。但右图拉长到 45 个 epoch,AdaGrad 很早就停住了,Adam 和 SGD 动量一路降到 以下。
作者对这个结果的解释很具体。他们观察到,训练几个 epoch 之后, 小到几乎是 0,分母被 主导,二阶矩已经无法描述这个问题的几何形状;在卷积网络上起作用的主要是一阶矩,它把小批量的噪声平均掉。照这个解释推下去,分母被 主导时,Adam 的行为更像带动量的 SGD,这也和两者曲线很接近的情况相符。作者也很坦率地写道,Adam 相对 SGD 动量只是小幅改善,好处在于它会自动为不同层调整学习率的尺度,不需要手动为卷积层挑一个比较小的学习率。
被写成「避免除以零的小常数」,但只要 小到和它同一个数量级,它就实际参与了更新。
偏差修正的实验
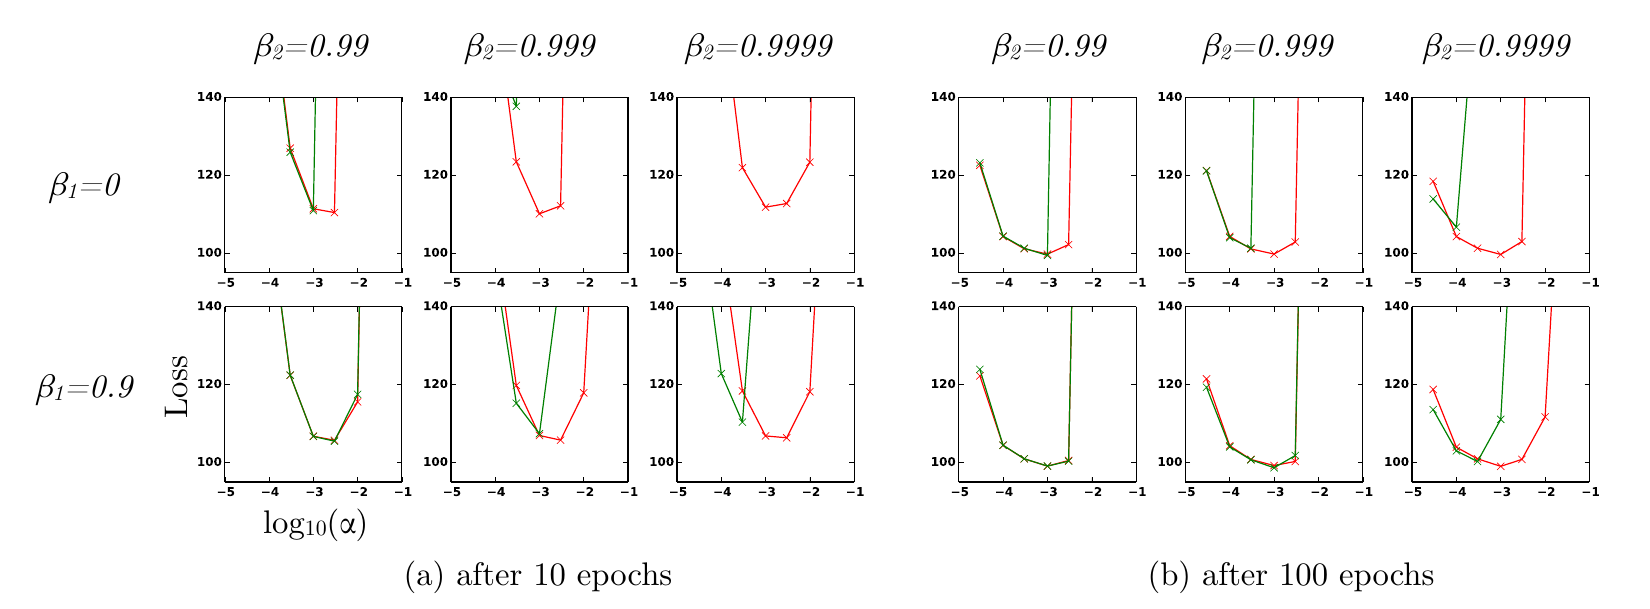
这是整篇论文最直接检验设计的一张图。作者训练一个变分自编码器(VAE,单一隐藏层、500 个 softplus 单元、50 维的高斯潜变量),扫过 、,以及 从 到 。去掉偏差修正之后的 Adam,论文视为一种带动量的 RMSProp。
每张小图的横轴是学习率,纵轴是损失,红线是有修正,绿线是没有。
- 那一列,红绿两条线大致重叠,只有 那一行的绿线在最大的学习率先冲出图外。这个设置下,没有修正造成的偏差大约一两百步就消失,对整个训练的影响不大。
- 往右看到 ,绿线在比较大的学习率就冲出图外。最严重的是左组第一行 , 和 的绿线几乎整条都在图外;这两格没有修正时第一步分别是 和 。
- 右组训练到 100 个 epoch,红线在六张图里的最低点都在 100 附近;在 那一列,红线的最低点落在 ,同一个学习率下,绿线在 时已冲出图外,在 时升到 110 左右,红线能用的学习率范围宽得多。
作者的结论是, 接近 1 时,没有偏差修正会让训练不稳定,尤其是最初的几个 epoch;最好的结果出现在 很小、又有偏差修正的设置。在他们扫过的所有超参数上,Adam 都不比 RMSProp 差。
作者还补了一个观察。训练后期隐藏单元各自专门化,梯度变得更稀疏,大 的好处在这时更明显。也就是说,接近 1 的 本来就是想要的设置,偏差修正让我们能放心用它。
加在哪里
回到前面两种写法的差异。Algorithm 1 把 加在修正后的 上,省计算的写法则把 加在未修正的 上。两者换算下来,,在训练初期差得最多。
各家框架选了不同的写法。PyTorch 照 Algorithm 1,默认 eps=1e-8;Keras 的文档写明它的 epsilon 是论文里的 ,默认值则是 1e-7。在两个框架之间搬超参数时,同样叫 epsilon,其实是两个量。
这个看似无关紧要的常数,在大模型训练里也会被拿出来调。OLMo 2 就把 AdamW 的 从 降到 ,报告称训练初期的梯度范数因此更低,也更稳定。
偏差修正被去掉的那几年
第 3 节的推导听起来像细节,但它有一段真实的后续。
BERT 官方代码里的优化器 BERTAdam,把偏差修正那两行去掉了;这个写法跟着被复制进 Hugging Face Transformers(2019 年 7 月才改回标准的 Adam)、AllenNLP 等常用库。2020 年 Zhang 等人的〈Revisiting Few-sample BERT Fine-tuning〉追查 BERT 在小数据集上微调不稳定的原因,发现这正是主因之一。
他们在 RTE、MRPC、STS-B、CoLA 四个小数据集上,各用 50 个随机种子微调。没有偏差修正时,很多次微调根本没训练起来;以 RTE 为例,48% 的运行准确率低于 55%,接近瞎猜。加回偏差修正,结果的波动大幅缩小。
原因和前面那张步长图是同一件事。这些小数据集的微调通常不到一千步,整个过程都还处在偏差最大的那一段。换成训练步数多的 MNLI,有没有修正的差距落在误差范围内(验证集准确率,没有修正 86.0、有修正 85.9)。
后来的三个问题
Adam 很快成了默认的优化器,接下来几年,针对它的质疑大致分成三条线:
- 收敛。 也就是前面提到的证明错误。Reddi 等人用一个每三步出现一次大梯度的例子,说明 会「忘记」罕见的大梯度,提出保留历史最大值的 AMSGrad。
- 泛化。 2017 年 Wilson 等人在几个视觉与语言任务上发现,Adam 的训练损失降得快,测试成绩却常输给调好的 SGD。
- 正则化。 Loshchilov 与 Hutter 指出,在 Adam 里把 L2 正则化写进梯度,和直接做权重衰减并不等价,提出 AdamW。
结论
Adam 用两个指数移动平均分别估计梯度的均值与平方的均值,相除后得到每个参数自己的步长;再用 修正从 0 起步的偏差,让第一步就落在 的尺度上。论文最有说服力的证据是 VAE 那组实验, 越接近 1,偏差修正越重要;其他实验只比了训练损失,卷积网络上它和 SGD 动量的差距也很小。收敛定理则在三年后被指出有误。
如果你要自己实现 Adam,或是沿用别人的训练代码,先看偏差修正那两行还在不在,再看 加在偏差修正之前还是之后、值是多少。训练步数越少,这两个细节对结果的影响越大;在框架之间搬超参数时,也记得两边的 epsilon 可能不是同一个量。
2025 年,这篇论文拿下了 ICLR 的时间检验奖,距离它的收敛证明被指出有问题,已经过了七年。至于作者顺序,到现在还是那枚硬币决定的。