原始论文
On the Variance of the Adaptive Learning Rate and Beyond
- 发表版本
- ICLR 2020会议
- arXiv 首次提交
- arXiv:1908.03265
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizersradam2019,
  title = {{On the Variance of the Adaptive Learning Rate and Beyond}},
  author = {Liyuan Liu and Haoming Jiang and Pengcheng He and Weizhu Chen and Xiaodong Liu and Jianfeng Gao and Jiawei Han},
  year = {2019},
  eprint = {1908.03265},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1908.03265}
}
If warmup is the answer, what is the question?
这是 RAdam 在 GitHub 上的开场白。预热(warmup)在当时已经是训练 Transformer 的标配,前几千步把学习率从接近 0 慢慢拉上去,Adam 才训练得起来;至于为什么非这样不可,当时缺少理论上的解释,预热要多长,各家大多靠试错。
2019 年 8 月,伊利诺伊大学与微软的 Liyuan Liu 等人发布了这篇论文,说原因出在 Adam 的自适应学习率,训练初期见过的梯度太少,它的方差大到失控。他们顺手提出了一个修正版,叫 Rectified Adam,简称 RAdam。
论文放上 arXiv 大约一周后,Less Wright 在 fast.ai 论坛和 Medium 上把它介绍成「新的 SOTA 优化器」,论坛上很快就有人拿去测试。又过了两个月,Jerry Ma 与 Denis Yarats 发表了一篇反驳,说 RAdam 拆开来看,就是 Adam 加上一段固定的预热。
这篇笔记把两边都看一遍。
定义问题
Adam 的自适应学习率
作者先把各种自适应优化器写成同一个框架(Algorithm 1)。每一步算出动量 与自适应学习率 ,再更新 。所有运算都是逐元素的。Adam 的 是:
也就是二阶矩估计开根号后取倒数,分子的 是偏差修正。梯度一直很大的参数,步子就缩小;梯度一直很小的参数,步子就放大。
不预热会怎样
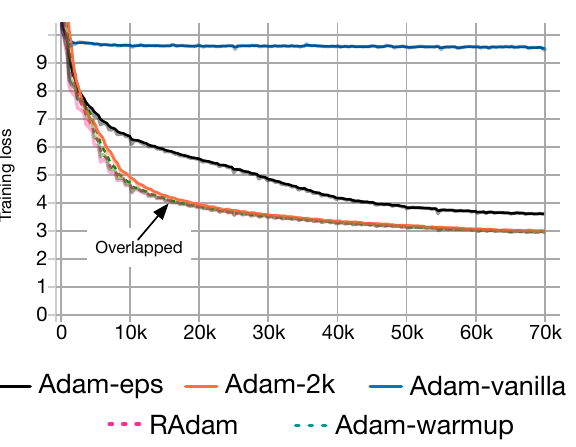
先看蓝线 Adam-vanilla 和最下面的 Adam-warmup。同一个 Transformer、同一份 IWSLT'14 德译英数据,不预热的训练损失停在 10 附近,预热之后降到 3 以下。其他三条线是作者的对照实验,等一下会讲到。
作者把每一步梯度绝对值的分布画出来,发现不预热时,前 10 步之内分布就被扭曲,重心挤到很小的值。他们的解读是,Adam 在最初几步做了有害的更新,把模型带进一个不好的区域,预热的作用是降低这些更新的影响。
那么,最初几步的更新为什么有害?
解决问题
第一步只有一个样本
先看最极端的 。这时 ,整个自适应学习率只靠一个梯度估出来。
假设梯度服从 ,那么 服从自由度为 1 的缩放逆卡方分布, 的方差是发散的。直觉上也不难理解, 只要刚好很接近 0, 就会非常大。
小的学习率可以压住这个方差,因为 。这就是作者对预热的解释,训练初期自适应学习率的方差太大,预热用小的 把它压下来。
两个对照实验
如果问题真的出在方差,那么换个方式降低方差,应该也能解决。作者设计了两个 Adam 的变体。
- Adam-2k:前 2,000 次迭代只更新 ,动量和参数都冻结,相当于先多看 2,000 个样本把二阶矩估准,再开始训练。
- Adam-eps:把分母的 从 加大到 ,直接限制 的上限。
前面那张图里,Adam-2k 没有预热,却和 Adam-warmup 叠在一起;梯度分布也不再被扭曲。Adam-eps 同样避开了卡在 10 的问题,但最后停在 3.6 左右,比预热差。作者推测,太大的 在自适应学习率里引入了偏差,拖慢了优化,所以需要一个更有原则的方法。
方差随样本数下降
接下来要把方差算出来。Adam 用的是指数移动平均(EMA),不好分析,作者把它近似成简单移动平均(SMA),并假设 服从自由度为 的缩放逆卡方分布。这里的 可以理解成「估计二阶矩时,等效用了几个样本」。
Theorem 1 说,在这个假设下, 的方差随 增加而单调递减,并在 时给出闭式表达式(式 (2))。换句话说,样本越少,自适应学习率越不可靠; 时,论文把这一段的方差当成无法处理(intractable)。
EMA 等效于几个样本
那么第 步的 EMA,相当于多长的 SMA?作者要求两者的「重心」相同,也就是各样本的时间位置按权重平均起来要一样,解出:
是 的极限。用默认的 代进去,。前几步的 算出来是:
| 1 | 2 | 3 | 4 | 5 | |
|---|---|---|---|---|---|
| 1.000 | 1.999 | 2.999 | 3.997 | 4.996 |
依原论文的 定义计算,。
训练初期 几乎就等于 ,很符合直觉,看过几个梯度,就等效用了几个样本。 越接近 1,EMA 的记忆越长, 要越久才会接近上限。
整流项
有了 ,作者把目标定为让自适应学习率的方差在每一步都一样,等于 时的最小值 。做法是乘上一个缩放因子 。
式 (2) 的闭式表达式在数值上不稳定,作者改用一阶近似,得到式 (5):
把 和 各代一次再相除, 就消掉了:
这就是 RAdam 名字里的 rectification(整流)。我们算几个点,看看它长什么样:
| 步数 | 5 | 10 | 100 | 1,000 | 2,000 | 5,000 |
|---|---|---|---|---|---|---|
| 0.017 | 0.049 | 0.215 | 0.645 | 0.828 | 0.983 |
依原论文 4.2 节的 计算,。
一开始非常小,一千步时约 0.65,到五千步才接近 1。这条曲线乘在学习率前面,看起来就是一段预热。
完整的算法
整理成 Algorithm 2,每一步做的事情是:
- 算梯度 ,更新二阶矩 与一阶矩 。
- 对一阶矩做偏差修正,。
- 计算 。
- 如果 ,计算 与 ,更新 。
- 否则,不用自适应学习率,直接 。
第 5 步就是 RAdam 退化成动量 SGD 的情况。照前面 的表, 时 的只有 到 4,所以前 4 步是带偏差修正的动量 SGD,第 5 步起才进入整流后的 Adam。后来 Ma 与 Yarats 证明,只要 , 恰好等价于 。论文另外提到,若 ,,RAdam 就整个退化成动量 SGD。
和预热的关系
作者在 4.3 节直接拿 和线性预热比较。线性预热相当于把学习率乘上 ,形式上和 很像,所以他们认为这验证了「预热是一种降低方差的技巧」。差别在于 RAdam 不需要预热长度 这个超参数,而且会随着 自动调整。
他们也强调,这个修正和梯度裁剪、调大 、初始化、归一化层等稳定训练的技巧相互独立,可以一起用。
讨论
实验设置
实验分三类,Adam 类方法的权重衰减都采用 AdamW 的解耦写法。
- 语言模型:One Billion Word,两层 LSTM、2,048 个隐藏单元,学习率 0.001,批量大小 128。
- 图像分类:CIFAR-10 用 ResNet-20(186 个 epoch),ImageNet 用 ResNet-18(90 个 epoch),学习率阶梯式下降,权重衰减 。
- 机器翻译:fairseq 的 Transformer,IWSLT'14 德英互译与 WMT'16 英译德;Adam 用 4,000 步线性预热。
语言模型与图像实验中,Adam 与 RAdam 的 都是 。
和原版 Adam 比
不预热的情况下,RAdam 在三个数据集上都胜过原版 Adam。One Billion Word 的测试困惑度从 36.92 降到 35.70;RAdam 在最初几个 epoch 比 Adam 慢,之后收敛得比较快。图像分类的测试准确率如下:
| 数据集 | SGD | Adam | RAdam |
|---|---|---|---|
| CIFAR-10 | 91.51 | 90.54 | 91.38 |
| ImageNet | 69.86 | 66.54 | 67.62 |
整理自原论文 Table 1(%)。
RAdam 比 Adam 好,但两个数据集上都没有赢过 SGD。作者另外报告了 ImageNet 的训练准确率,SGD、Adam、RAdam 分别是 69.57、69.12、70.30,RAdam 最高。训练得比 SGD 好、测试却比较差,差距看起来出在泛化,不过这是从训练准确率倒推的判断,论文本身没有这样分析。
对学习率不敏感
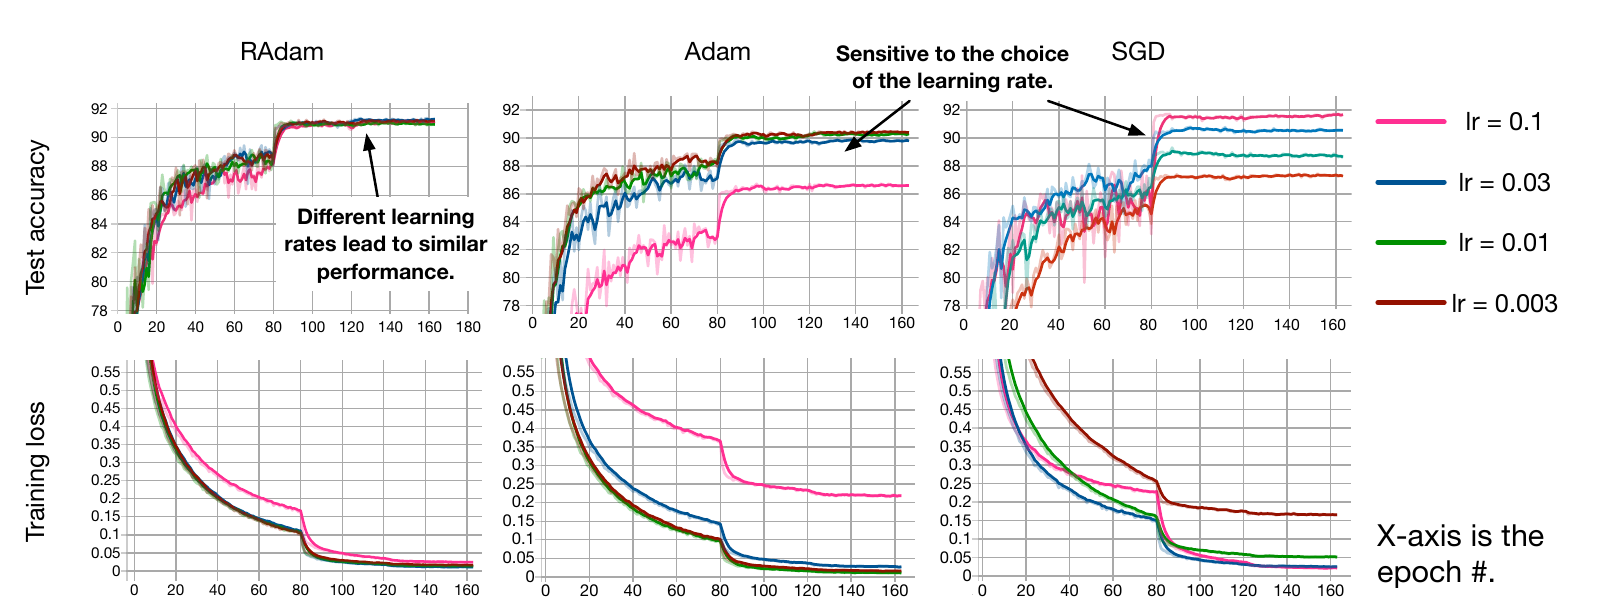
学习率在 0.1 到 0.003 之间变动时,RAdam 的四条测试准确率曲线几乎叠在一起;Adam 在学习率 0.1 时掉到约 86%,SGD 则四条线各走各的。作者把这解读为整流让 RAdam 能适应更大范围的学习率。不过 README 的常见问题也老实写着,RAdam 的稳健性不是无限的,学习率还是要调。
和预热比
翻译是最离不开预热的场景,所以这里的对手换成调好的 Adam 加预热:
| 任务 | Adam + 预热 | RAdam |
|---|---|---|
| IWSLT'14 德→英 | 34.66 | 34.76 |
| IWSLT'14 英→德 | 28.56 | 28.48 |
| WMT'16 英→德 | 27.03 | 27.27 |
整理自原论文 Table 2;BLEU,IWSLT 为 5 个随机种子的平均。
两者打平,作者的结论也是「达到和预热相近的效果」。这里有一个附录里才看得到的设置。翻译实验的 设成 0.9995,附录写的理由是让 。代进 ,正好是 3,999,和 Adam 那组的 4,000 步预热对齐。也就是说,在这组比较里,RAdam 的「自动预热」长度是通过 对齐过的。
CIFAR-10 上,Adam 加预热的最佳准确率是 91.29%,和 RAdam 的 91.38% 相当;但预热长度有 100、200、500、1,000 步可选,学习率 0.1 配 100 步预热时只有 90.13%,同一个学习率下 RAdam 是 91.06%。所以更准确地说,作者的主张是 RAdam 少了一个要调的超参数,最好的成绩本身差不多。
前几步的动量 SGD
退化成动量 SGD 的那几步重要吗?附录 C 在 CIFAR-10、学习率 0.1 下做了替换实验(5 次平均)。全程 RAdam 的测试准确率是 91.08%;把前 4 步换成普通 Adam,掉到 89.98%;前 4 步用 SGD、第 5 到 8 步换成未整流的 Adam,则是 90.29%。作者认为这符合理论,越早的更新伤害越大,但也说明这部分只是算法里次要的设计,重点在预热的机制与整流项的推导。
Ma 与 Yarats 的反驳
2019 年 10 月,Jerry Ma(芝加哥大学)与 Denis Yarats(纽约大学、Facebook AI Research)在 arXiv 上发布了〈On the Adequacy of Untuned Warmup for Adaptive Optimization〉(AAAI 2021)。摘要开门见山,说他们要反驳这份分析。论点有三层。
第一,RAdam 是一段固定的预热。 只跟 和 有关,和梯度实际长什么样完全无关。前面已经提到, 恰好是前 4 步,所以 RAdam 可以用一句话描述,先做 4 步动量 SGD,之后是套上固定预热调度的 Adam。他们也试过把前 4 步换成什么都不做、或用很小学习率的 Adam,差别都可以忽略。
第二,方差的论证有漏洞。 RAdam 假设梯度均值为 0,但训练初期模型离极小值很远,梯度的均值通常比标准差还大;他们在 EMNIST 上测到,大约要到第 50 步,多数参数的变异系数才稳定超过 1。更关键的是,Adam 实际的更新量是 ,而 和 高度相关。第 1 步时两者甚至完全相等,每个参数的更新量都恰好是 ( 时)。换句话说,自适应学习率的方差「发散」的那一步,实际更新量的方差是 0。
第三,该看的是更新量的大小。 他们做了一个模拟,让梯度在一个极小值附近纯粹是零均值的噪声,跑 Adam 看更新量。结果更新量从 开始,大约 40 步后才稳定在 左右。也就是说,即使模型已经停在极小值上,Adam 刚开始的几十步也会迈出偏大的步子;SGD 在同样的情况下不需要预热,这可以部分解释为什么 Adam 比 SGD 更需要预热。
在这些分析之上,他们提出两条不用调的经验法则:
前者的时间常数 是仿照 Adam 二阶矩的偏差修正项 选的,作者自己也说这个直觉纯属推测;后者是 步的线性预热, 时就是 2,000 步。
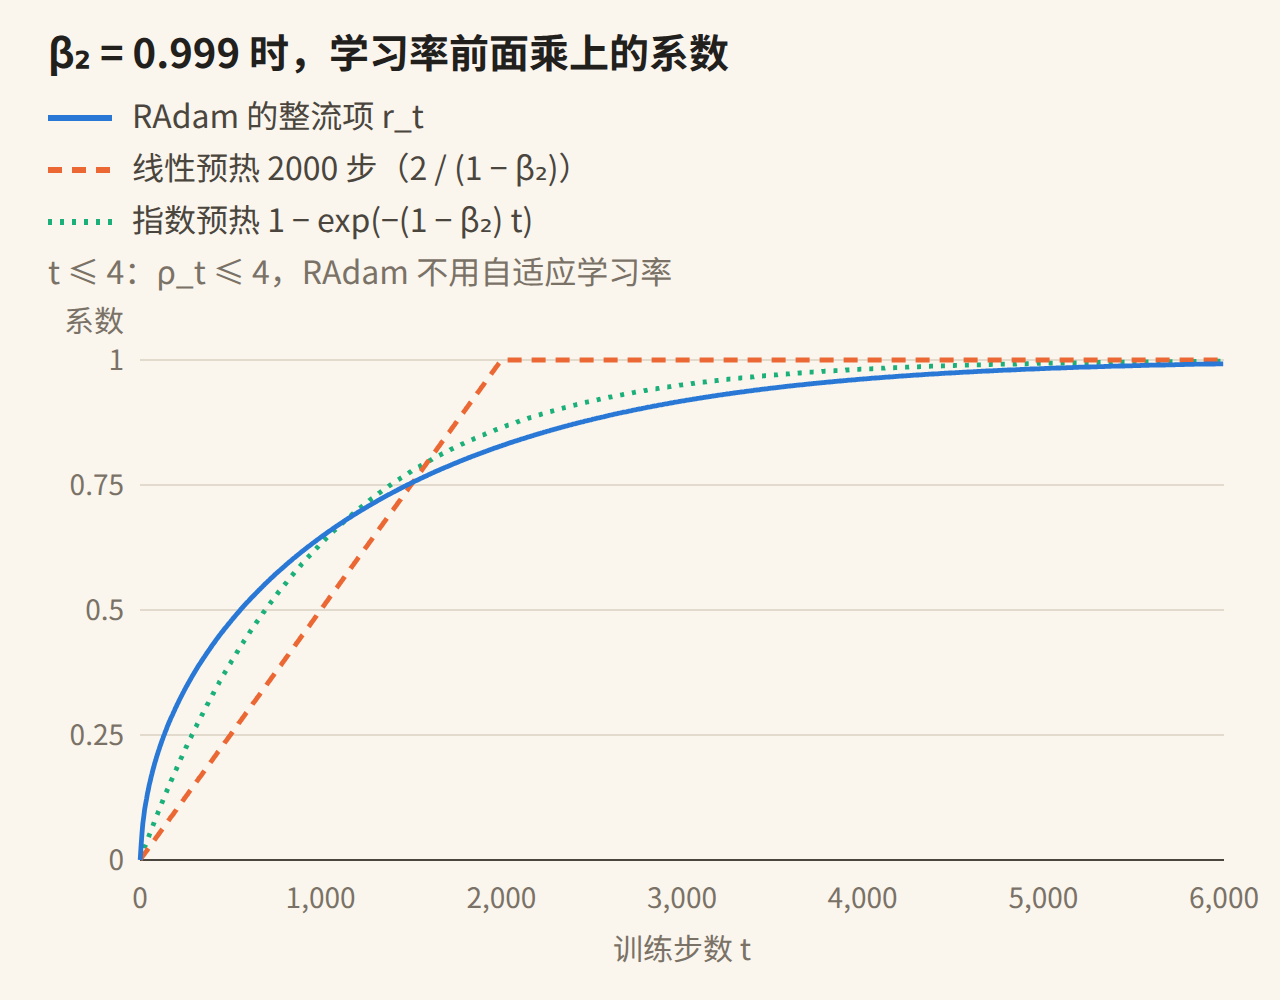
三条曲线的形状不完全一样,RAdam 在前几百步上升得最快,过了 1,500 步左右反而落在最后。Ma 与 Yarats 用「有效预热长度」 来比较,也就是预热总共压掉了多少步的学习率; 时,三者都在 1,000 步左右(按公式算,RAdam 约 1,033 步),而且在各种 下都几乎一样。
实验也支持这个说法。他们在 ImageNet 的 ResNet-50、WikiText-103 的 Transformer 语言模型、WMT16 英译德的 Transformer 上,各扫 9 到 12 组学习率与 ,三种方法的差距大多只有零点几。以 ImageNet 的 top-1 误差为例(5 个随机种子):
| 学习率 | 指数 | 线性 | RAdam | |
|---|---|---|---|---|
| 0.99 | 27.9 | 28.0 | 28.4 | |
| 0.997 | 27.9 | 27.9 | 28.3 | |
| 0.999 | 28.2 | 28.3 | 28.4 |
整理自 Ma & Yarats Table 1,节选学习率 的三行(%)。
这三行里 RAdam 反而略差一点。整张表差得最多的一组是学习率 、,RAdam 的误差比两条经验法则高了约 1 个百分点。他们的建议是,用 Adam 时就做 步的线性预热。
谁比较对?
两篇论文都同意 Adam 在最初几千步需要比较小的学习率,分歧在于为什么。
RAdam 这边的证据,是 Adam-2k 这类对照实验,以及在翻译与图像上和调好的预热打平。Ma 与 Yarats 那边,则指出 只是一个由 决定的固定调度,并用更新量的分析与跨三个任务的实验说明,不用调参的线性预热就能做到一样的事。RAdam 论文的正式版没有回应这篇反驳;README 的常见问题倒是承认,当梯度均值远大于方差时,方差的问题可能不大,并把这当成某些模型更需要预热的一种可能解释。
零均值这个假设,RAdam 论文自己在 5.3 节用模拟检查过。梯度改从 采样, 取 0、0.001、0.01、0.1、1、10 六种,,各跑 5,000 条、每条 6,000 步的轨迹;六种情况下,原始自适应学习率的方差都在初期偏大,整流后大致维持一致。同一节也确认式 (5) 的一阶近似和式 (2) 的闭式表达式几乎重叠。这组模拟测的仍是自适应学习率本身的方差,没有涉及 Ma 与 Yarats 指出的 与 的相关性。
Ma 与 Yarats 也没有把问题完全解决。他们的模拟显示更新量大约 40 步就稳定,照这个逻辑,预热几百步应该就够;可是不论 RAdam 还是他们的经验法则,有效预热都在 1,000 步左右,有些手调的预热甚至拉到一万步。他们在讨论里自己写道,Adam 为什么需要这么长的预热,仍是一个未解的问题。
站在工程的角度,双方在实践上的结论一致,RAdam 等价于一段长度约 步的预热。这也带出一个容易忽略的后果。后来的大语言模型常把 设成 0.95,例如 GPT-3 和 LLaMA;这时 ,按公式算,RAdam 内置的有效预热只有约 24 步,而 LLaMA 实际用的是 2,000 步预热。
整流项本身倒是被保留了下来。PyTorch 内置了 torch.optim.RAdam;Schedule-Free 的官方库在 2024 年底也收进一个社区贡献的 RAdam 版本,说明里写着连预热都可以省掉。
结论
RAdam 从 Adam 的自适应学习率出发,用 SMA 近似估出第 步等效的样本数 ,再用整流项 把方差拉到一致; 的前几步则直接退化成动量 SGD。在翻译与图像分类上,它不必另外设置预热长度(翻译实验的 特别对齐过),就能追上调好的 Adam 加预热。Ma 与 Yarats 随后指出, 只是一段由 决定的固定预热,简单的线性预热就能取得几乎相同的结果。
如果你手上已经有调好的预热,换成 RAdam 多半不会多得到什么;如果没有,RAdam 和「线性预热 步」是两个差不多可靠的起点。只是要记得,用 RAdam 时改 ,等于同时改了预热长度。
README 开头问,如果预热是答案,问题是什么。Ma 与 Yarats 给的答案是 Adam 初期的更新量太大;至于为什么要预热这么久,他们自己也承认还不知道。