原始论文
The Marginal Value of Adaptive Gradient Methods in Machine Learning
- 发表版本
- NeurIPS 2017会议
- arXiv 首次提交
- arXiv:1705.08292
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizersmarginalvalue2017,
  title = {{The Marginal Value of Adaptive Gradient Methods in Machine Learning}},
  author = {Ashia C. Wilson and Rebecca Roelofs and Mitchell Stern and Nathan Srebro and Benjamin Recht},
  year = {2017},
  eprint = {1705.08292},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1705.08292}
}
「These results suggest that practitioners should reconsider the use of adaptive methods to train neural networks.」
这是这篇论文摘要的最后一句,建议大家重新考虑要不要用自适应方法训练神经网络。
2017 年 5 月,Adam 才发表两年多,论文自己的引言就写道,它已经是许多深度学习框架里的默认算法。当时流传着两个说法,一是 AdaGrad、RMSProp、Adam 这类自适应方法收敛得快,二是它们几乎不用调参。伯克利的 Ashia Wilson、Rebecca Roelofs、Mitchell Stern、Benjamin Recht 与 TTIC 的 Nathan Srebro 把这两个说法都拿出来检验。
他们先构造了一个简单的分类问题,SGD 在上面的测试错误率是 0,自适应方法却接近一半;接着在图像分类、字符级语言模型与两种句法分析上做实验,结论都是调好的 SGD 赢。
这篇笔记会先拆解那个构造的例子,再看实验和他们的调参方式,最后看两年后另一组人怎么用同一份代码,把差距调到看不见。
定义问题
深度网络的参数量通常远大于训练样本数,能让训练损失降到 0 的解不只一个,而是一大片。优化器最后停在哪一个,取决于它走的路线;不同的解在训练集上一样好,在新数据上却可能差很多。
这篇要问的是,自适应方法和 SGD 在这种情况下会不会挑到不同的解,而挑到的解泛化能力有没有差别。
为了比较,论文先把各种方法写进同一个框架。SGD 直接沿梯度走;自适应方法则在梯度前面乘上一个对角矩阵的逆,
的选法决定了它是 AdaGrad、RMSProp 还是 Adam,动量项另外加上。SGD 相当于 ,用的是参数空间原本的 几何;自适应方法则依照历史梯度,为每个坐标换一把尺子。
解决问题
SGD 会找到最小范数解
先看最简单的情况,用最小二乘法做二分类:
当 ,只要有一个解让损失为 0,就有无穷多个。
SGD 的每一个梯度都是 的形式,落在 的行空间里。从 出发,只用梯度和过去迭代点的线性组合,就永远离不开这个空间。行空间里满足 的解只有一个,,刚好是所有解里 范数最小的那个,也是间隔(margin)最大的那个。
所以 SGD、动量、小批量 SGD、Nesterov,乃至共轭梯度法,最后都会到达同一个点。论文说,梯度下降自然地找到最大间隔解,是一个令人愉快的意外。
自适应方法会找到符号解
自适应方法的分母每个坐标都不一样,就没有行空间这个限制了。一般情况下很难算出它会收敛到哪里,论文挑了一个能算的特例(Lemma 3.1):
若存在标量 使得 ,则从 出发,AdaGrad、Adam 与 RMSProp 都收敛到唯一的解 。
证明的想法很直接。在 与 成正比的时候,梯度会和 成正比,分母 会和 成正比;两者一除,每个坐标的更新量大小都一样,只差在正负号。所以每一步之后, 仍然和 成正比,归纳下去就得到结论。
换句话说,在这个特例里,自适应方法把每个特征都当成一样重要,每个权重的绝对值都相同。论文的说法是,它们会收敛到 范数小的解,SGD 则收敛到 范数小的解。
构造一组会让它出错的数据
接着论文设计了一组数据,让这个差别变成测试错误率。
每个样本的标签 以概率 是 ,否则是 。特征向量很长,前三维和后面分开看:
- 第 1 维就是标签本身,;
- 第 2、3 维永远是 1;
- 后面每个样本各有一段只属于自己的特征,正例有 1 个、负例有 5 个,值都是 1。
真正有用的只有第 1 维;第 2、3 维是常数,后面那些特征各自只在一个样本身上出现。它们在训练集上看起来很有区分力,每一个都能「认出」某个样本,但对新样本毫无用处。
这组数据刚好满足 Lemma 3.1 的条件,。我们取 10 个训练样本(6 正、4 负)实际算一遍,从 出发,梯度下降和 Adam 都把训练损失降到 0,学到的权重如下:
| 特征 | SGD | Adam |
|---|---|---|
| 第 1 维(标签) | 0.756 | 0.25 |
| 第 2、3 维(常数) | 0.087 | 0.25 |
| 正例的专属特征 | 0.070 | 0.25 |
| 负例的专属特征 | −0.084 | −0.25 |
本文计算。SGD 列是最小范数解,梯度下降迭代到收敛的结果与解析解一致;Adam 列用默认的 、学习率 迭代两万步,AdaGrad 得到相同的权重。
SGD 把大部分的权重放在第 1 维。Adam 给每个特征一样大的权重,正负号跟着该特征在训练集上和标签的关系走。
现在来一个新样本。它的专属特征是全新的,训练时从没出现过,和 重叠的只有前三维:
- SGD:分数是 。正例得 ,负例得 ,两个都分对。
- Adam:分数是 。正例得 ,负例得 ,两个都判成正例。
在这组数据上,自适应方法会把每一个没见过的样本都标成正例,测试错误率就是负例的比例 。 越接近 ,错误率越接近一半;SGD 的错误率则是 0。附录还把它写成从固定分布采样的版本,结论相同。
这个例子的维度不必真的无限大,论文说取 维就够了,而深度网络的参数量常常是样本数的 25 倍以上。作者的解读是,真实数据里也常有少数几个频繁出现、真正有用的特征,加上大量稀疏的特征;在有限的训练集上,稀疏特征看起来很能区分样本,其实只是过拟合。
照 Lemma 3.1 的机制来看(这是本文的解释),自适应方法的分母来自各坐标自己的历史梯度,很少出现的稀疏特征分母小,相对步伐就大,最后被推到和真正有用的特征一样大的权重,正好放大了这个问题。
这个构造有它的前提。它要求从 出发、数据满足 这种特殊结构,分析时也把分母里的 去掉了。它证明了「自适应方法可以泛化得很差」,至于神经网络上会不会发生,要看实验。
讨论
实验设置
论文比较两个非自适应方法(SGD、动量固定为 0.9 的 heavy-ball,下称 HB)和三个自适应方法(AdaGrad、RMSProp、Adam),另外加一条完全用默认值的 Adam。四个任务都用网上能找到的代码,尽量不改架构和预处理:
| 任务 | 模型 | 数据 |
|---|---|---|
| 图像分类 | VGG+BN+Dropout | CIFAR-10 |
| 字符级语言模型 | 2 层 LSTM | 《战争与和平》 |
| 判别式句法分析 | 2 层 LSTM+前馈 | Penn Treebank |
| 生成式句法分析 | 3 层 LSTM | Penn Treebank |
整理自原论文 Table 2。四套代码用了 Torch、DyNet、TensorFlow 三种框架,前两个任务都是 Torch。
句法分析是把句子拆成由子句、短语与词组成的嵌套树状结构。判别式的做法把建树转成一连串动作的序列预测,用 F1 衡量;生成式的做法把树写成深度优先遍历的序列,当成语言模型来打分,用困惑度衡量。
每个设置从随机初始化跑 5 次。训练的 epoch 数事先固定,有验证集的任务,挑在预算内验证成绩最好的设置;CIFAR-10 没有另外切分验证集,改挑训练损失最低的设置。
调参方式
作者发现影响最大的两个超参数是初始学习率和衰减方式,就只调这两个,其他维持各框架的默认值。
学习率在对数尺度上取 5 个点。如果最好的点落在边界,就往外再加点,直到最好的值在中间;例如试过 2、1、0.5、0.25、0.125 而 2 最好,就再试 4,4 更好就试 8。衰减方式有两种:
- dev-decay:记录当前最好的验证成绩,某个 epoch 没有刷新,就把学习率乘上 ;
- fixed-decay:每 个 epoch 乘一次 。
作者建议有验证集时用 dev-decay,它的超参数比较少,结果也不比 fixed-decay 差。附录列了每个方法试过的学习率。以 CIFAR-10 为例,SGD 最好的是 0.5,Adam 最好的是 0.0003,比默认的 0.001 小三倍多。
CIFAR-10
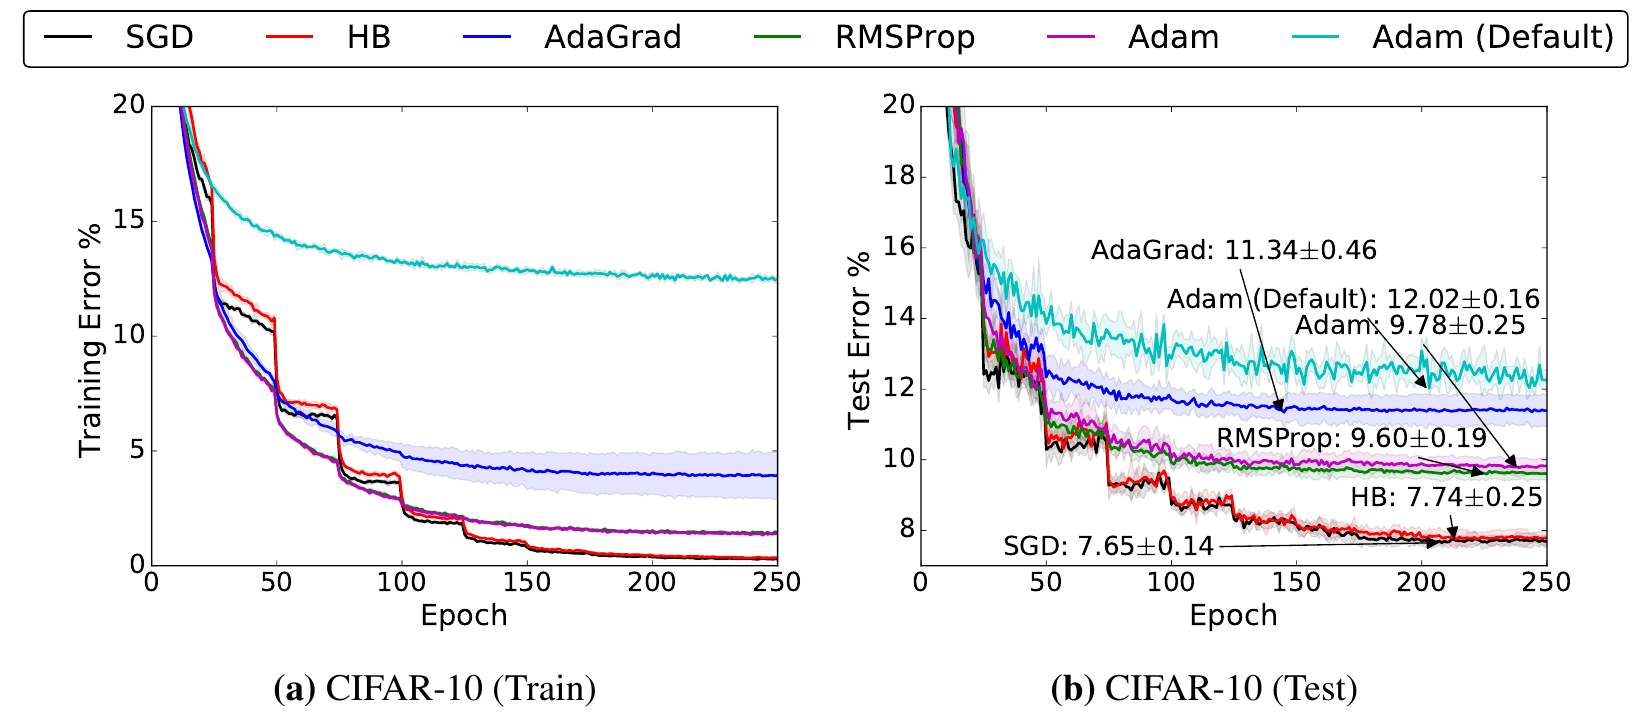
模型是 Torch 博客上的 VGG+BN+Dropout,原本的测试错误率是 7.55%。右图标出每个方法最好的测试错误率,SGD 是 ,自适应方法里最好的 RMSProp 是 ,调过的 Adam 是 ,默认 Adam 是 。
顺着时间看更有意思。前 50 个 epoch,自适应方法的训练错误率明显领先,测试错误率则和 SGD、HB 不相上下。大约从第 50 个 epoch 开始,自适应方法的训练错误率还比较低,SGD 和 HB 的测试错误率却已经开始领先;到第 100 个 epoch,SGD 和 HB 在训练与测试上都赢了。左图 SGD 和 HB 每 25 个 epoch 往下跳一阶,那是学习率衰减;两年后重跑这组实验的 Choi 等人记下的设置,是每 25 个 epoch 把学习率乘以 0.5。自适应方法的曲线在同样的位置平缓得多。
作者也试过给自适应方法加大学习率。前 50 个 epoch 确实会进步,但后面停滞得更严重,换什么衰减方式都救不回来。
三个语言任务
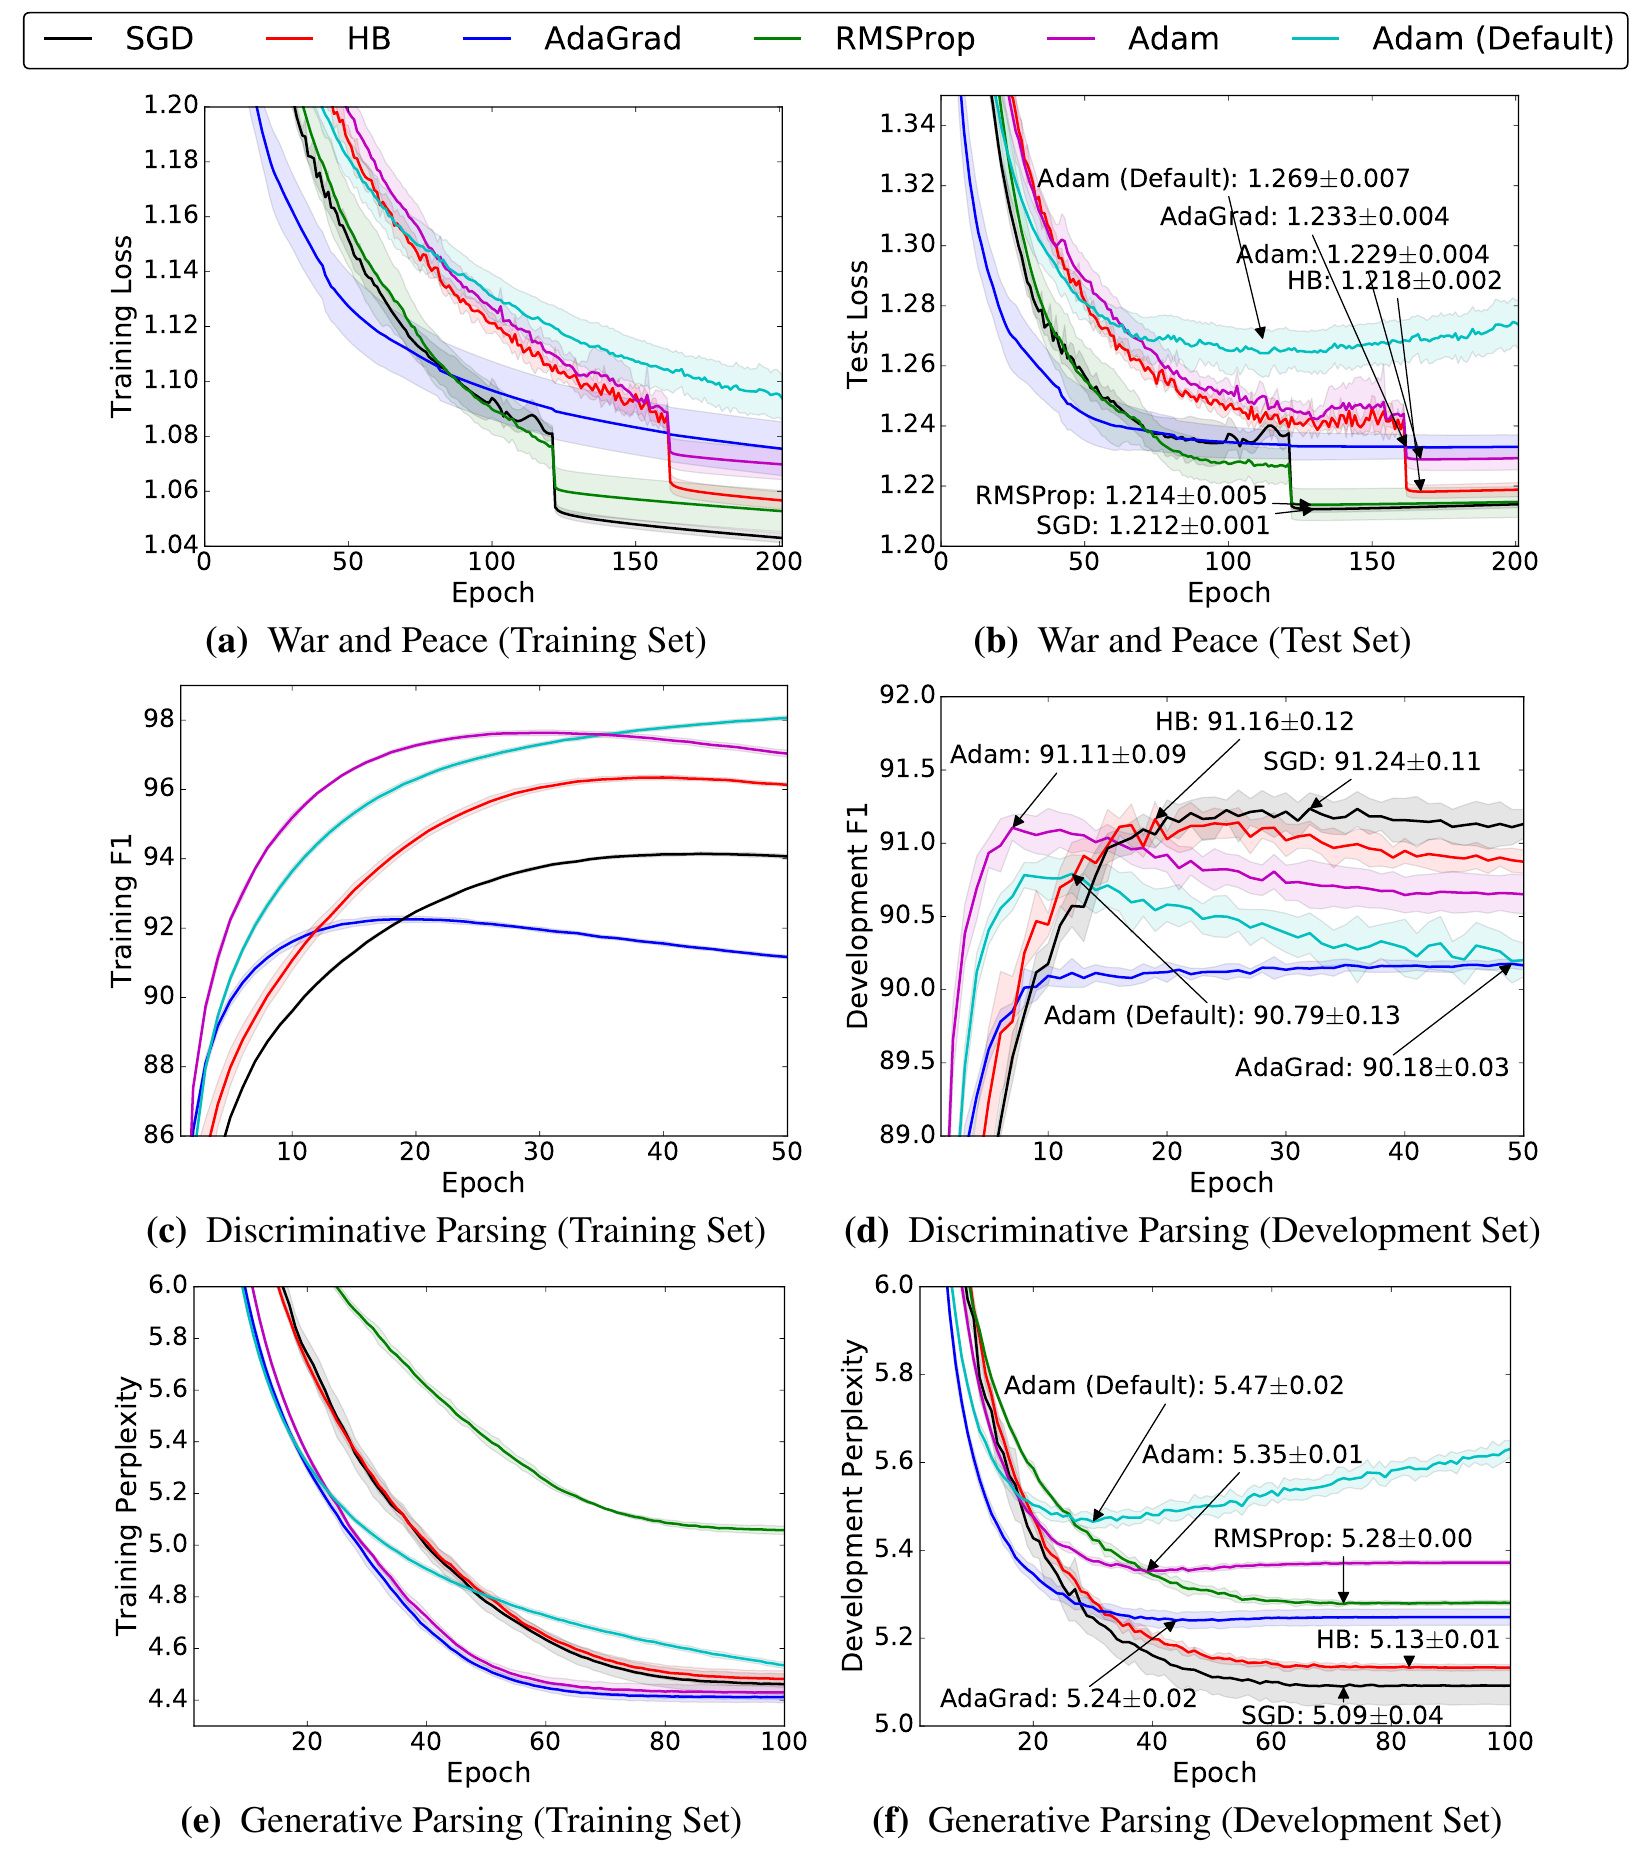
每一行左边是训练集,右边是验证或测试集,标注的是每个方法的最佳值。
- 字符级语言模型(第一行)。用 torch-rnn 在《战争与和平》全文上训练 200 个 epoch。SGD 的测试损失最低,;RMSProp 以 紧随其后,作者特别说明,这证明了自适应方法并非不可能找到泛化好的解。fixed-decay 的搜索还有一个发现,除了 AdaGrad,所有方法最好的设置都是在训练进行到 60% 或 80% 时才一次把学习率除以 10。
- 判别式句法分析(第二行)。Cross 与 Huang 的分析器,在 Penn Treebank 上训练 50 个 epoch,dev-decay 的 ;当时的 DyNet 没有 RMSProp。SGD 的验证 F1 最好,91.24,HB 与 Adam 紧追在后。Adam 只花 6 个 epoch 就达到它的最佳值 91.11,SGD 要 18 个 epoch 才追上这个数字,31 个 epoch 才到 91.24。之后 Adam 在训练集上继续进步,验证成绩却往下掉。
- 生成式句法分析(第三行)。Choe 与 Charniak 的模型,为了节省计算,把 LSTM 的隐藏维度从 1500 降到 500,dropout 从 0.7 降到 0.5,训练 100 个 epoch。SGD 的验证困惑度最好,5.09;Adam 的训练曲线属于最好的一组,验证困惑度却是调过的方法里最差的,5.35。
四个任务归纳起来是四点:
- 自适应方法找到的解,泛化比非自适应方法差。
- 就算训练损失一样低甚至更低,自适应方法的验证或测试成绩还是比较差。
- 自适应方法一开始在训练集上进步得快,但验证成绩很快就停住。
- 调学习率和衰减,对 Adam 的改善在每个任务上都很明显。默认值的 Adam 在四张图上都垫底或接近垫底,「Adam 不用调」的说法站不住。
作者在结论里说,他们不太确定 Adam 为什么还这么受欢迎。和其他研究者聊过之后的猜测是,Adam 在 GAN 与搭配函数近似的 Q-learning 上特别流行,而这两者严格来说都不是在解优化问题,Adam 的动态也许刚好适合它们。
调好 再比一次
两年后,多伦多大学与 Google Brain 的 Dami Choi、Christopher Shallue、George Dahl 等人在〈On Empirical Comparisons of Optimizers for Deep Learning〉里回应了这篇论文。
他们的出发点是优化器之间的包含关系。动量设成 0 就是 SGD,所以调到最好的动量不可能输给调到最好的 SGD。Adam 也能模仿动量。把 设成 0、 调得很大,分母 几乎就是常数 ,再配合学习率的调度抵消偏差修正,Adam 的更新就变成带动量的 SGD。所以只要所有超参数都调,Adam 不该比动量差。
Wilson 等人只调了学习率和衰减, 维持各框架的默认值;构造的例子在分析时也把 去掉了。Choi 等人拿 Wilson 等人公开的 CIFAR-10 代码重跑:
- 照原本的做法只扫学习率,重现了 RMSProp 和 Adam 比较差的结果;
- 用随机搜索多调动量相关参数和 ,SGD、动量、RMSProp、Adam 四者的测试错误率几乎一样;
- 换成他们自己的代码并搜索学习率调度,四者也落在误差范围内。
他们也注意到 Wilson 等人在 CIFAR-10 上是用训练损失挑设置,改成用验证集挑,结论不变。 这个参数的影响比想象中大,他们在四个任务上找到的最佳 横跨 10 个数量级。
两篇论文的结论怎么放在一起看,Choi 等人自己给了说法。如果把「默认 的 Adam」和「调过 的 Adam」看成两个不同的优化器,结论就没有矛盾。这里要多想一步, 调大的 Adam,分母的自适应效果也被冲淡了,越来越接近动量 SGD。Choi 等人在 Wilson 的代码上为 Adam 调 ,最后的搜索范围落在 到 ,比梯度的尺度大了好几个数量级,分母几乎就是常数。所以两篇合起来可以这样读,默认设置下的自适应更新确实可能泛化较差,而把 Adam 调到不输 SGD 的那组超参数,有一部分正是让它变得没那么自适应。
其他的回应
同一时期还有几条路线,从不同角度处理这个差距。
- 把权重衰减写对。 2017 年 11 月,Loshchilov 与 Hutter 引用这篇论文,认为 Adam 泛化差的一大原因是 L2 正则化在 Adam 里没有发挥作用,提出了 AdamW。
- 后段换成 SGD。 Keskar 与 Socher 的 SWATS 先用 Adam 训练,在某个条件触发时切换到 SGD;AdaBound 则让 Adam 每个参数的学习率被一个逐步收窄的上下界夹住,从 Adam 平滑过渡到 SGD。
- 大规模重新比较。 Schmidt 等人用超过五万次训练比较 15 种优化器,没有一种在所有任务上明显胜出,Adam 仍然是很强的选择。
另一个反方向的发展是 Transformer。Choi 等人在 LM1B 的 Transformer 语言模型上就看到明显的排名,Adam 达到目标错误率所需的步数只有动量的 60%,达到同样的最终结果只需 SGD 的 25%。Zhang 等人 2019 年认为,注意力模型的梯度噪声呈重尾分布,是 SGD 表现差的原因之一;Kunstner 等人 2023 年则把批量一路加大到整个数据集,发现噪声减少时 Adam 进步得比 SGD 多,差距并没有因此缩小。这篇论文的实验停在 2017 年的 CNN 与 LSTM,它的结论不能直接外推到这类模型。
结论
这篇论文用一个构造的例子证明,在过度参数化的问题上,自适应方法和 SGD 会走到不同的解;在特定的数据结构下,自适应方法学到的解可以把新数据错判一半,SGD 则完全正确。四个实验里,只调学习率与衰减时,SGD 和 HB 的测试成绩都比较好,默认值的 Adam 更是明显落后。两年后 Choi 等人重跑同一份代码,把 等超参数一起调,CIFAR-10 上的差距就消失了。
读优化器比较的论文时,先找调参的那一段,看调了哪些超参数、各调了几组、用什么挑设置。自己做比较也一样,Adam 至少要调学习率、学习率调度和 ,并像这篇的附录那样,把每个方法实际试过的网格写出来。
Choi 等人在 ImageNet 上训练 ResNet-50,最好的那组 NAdam, 是 9475。这个原本只用来避免除以零的常数,在 Wilson 等人的网格里根本没有位置。