原始论文
On the Convergence of Adam and Beyond
- 发表版本
- ICLR 2018会议
- arXiv 首次提交
- arXiv:1904.09237
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizersamsgrad2019,
  title = {{On the Convergence of Adam and Beyond}},
  author = {Sashank J. Reddi and Satyen Kale and Sanjiv Kumar},
  year = {2019},
  eprint = {1904.09237},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1904.09237}
}
先玩一个小游戏。
参数 只能待在 到 之间。每三步为一轮,第一步的损失是 ,第二步和第三步的损失都是 。一轮加起来是 ,所以 越小越好,答案是 。
梯度很好算,第一步是 ,后两步是 。SGD 每一轮往负方向净走一步,最后停在 。
Adam 会停在 ,整个区间里最差的那一点。
这个例子出自 Google 的 Sashank Reddi、Satyen Kale 与 Sanjiv Kumar。他们用它证明 Adam 原始论文的收敛定理是错的,再从出错的地方推出一个只改一行的修正版,AMSGrad。
定义问题
Adam 宣称的收敛
Adam 论文用在线凸优化的框架分析收敛。每一步,算法先选一个参数 ,接着才看到这一步的凸损失函数 。衡量标准是遗憾(regret),也就是累积损失比「事后看来最好的固定参数」多出多少:
如果平均遗憾 趋近 0,平均来说算法就追上了最好的固定解。Adam 论文的 Theorem 4.1 宣称,在梯度有界、、学习率 等条件下,Adam 的遗憾是 ,平均遗憾趋近 0。
开头那个游戏正是在线凸优化。每个 都是线性函数,可行域是 。Adam 停在 ,每一轮都比 多付出固定的损失,平均遗憾永远不会趋近 0。
有效学习率会不会变大
Reddi 等人把问题指向一个量。把各种自适应方法写进同一个框架,每一步的更新是 , 就是每个参数实际的学习率。看它的倒数怎么随时间变化:
SGD 的 固定、 递减;AdaGrad 的 是历史梯度平方的平均,配上 ,分母里实际是梯度平方的总和,只增不减。两者的 都不会是负的,学习率只会变小。
Adam 和 RMSProp 用的是指数移动平均。最近的梯度一变小, 就跟着变小,学习率反而变大, 可以是负的。
论文开头描述了实际训练中看到的情况。在输出空间很大的问题里,有些小批量会带来很大、信息量很高的梯度,但很少出现;指数移动平均让它们的影响很快消失,训练就收敛得很差。这篇要做的,是把这个直觉变成可以证明的反例。
解决问题
反例:每三步一次大梯度
论文的 Theorem 1 就是开头那个游戏的一般版本。损失函数依次是
一轮的梯度总和是 ,最优解是 。Adam 的设置是 、、,而且 ;这组参数满足 Adam 论文要求的 。论文附录用归纳法证明,从 出发,每一轮结束时 都会回到 。
为什么?我们取 ,这时 ,直接算一轮。 经过几轮后会进入固定的循环,下表是循环中的一轮。表中最后两列是 ,正数代表把 往 推,负数代表往 推;实际的更新量还要再乘上 ,同一轮里三步的 差不多,先忽略:
| 步 | Adam | AMSGrad | ||
|---|---|---|---|---|
| 1 | 8.21 | |||
| 2 | 1.72 | |||
| 3 | 1.07 | |||
| 一轮 |
本文计算,、、,Theorem 1 的设置。AMSGrad 的分母用历史最大的 ,即 8.21。
先看 Adam 那一列。第一步的梯度是 ,但 同时被它撑大到 8.21,,大梯度被缩小了将近 3 倍。论文说大梯度 会被缩小「将近 倍」,指的就是这件事。接下来两步梯度只有 , 以每步只保留一成的速度掉回 1.72、1.07,学习率在两步内放大到将近三倍,两个小梯度合起来推了 。一轮下来,净效果是往错误的方向走了 。
这就是 的具体样子。大梯度带来的教训,两步之后就忘得差不多了。
照这组设置、取 实际迭代三十万步,Adam 停在 ,平均遗憾 ,正好是论文给的下界 ;同样条件下 AMSGrad 走到 。
论文还补了几点。这个例子在固定步长 时同样成立;在分母加上 也救不回来,附录的 Theorem 6 对任何 都能构造出类似的反例。SGD 和 AdaGrad 在同一个问题上,平均遗憾都会趋近 0。
换成实际会用的
太刻意了,实际训练中 都接近 1。论文接着证明了两个更强的结果。
Theorem 2 说,只要 (实际设置几乎都满足),就存在一个在线凸问题让 Adam 的平均遗憾不趋近 0。构造方式相同,只是周期从 3 拉长成 :每 步出现一次梯度 ,其余都是 。 要够大,大到 的记忆撑不过一个周期。
够大是多大?附录列了三个条件,其中一个是 。我们代入数字算, 时 至少 3,218(附录 B 还要求 是偶数;只看这个不等式是 3,217), 时至少 42,622。也就是每四万多步出现一次、比平常大四万多倍的梯度。
Theorem 3 把场景换成随机优化。每一步独立采样,以概率 看到 ,否则看到 。期望的损失是 ,最优解还是 ;但 够大时,Adam 每一步位移的期望值是正的,参数会往远离最优解的方向漂。
作者的结论是,若想避免这种行为,、、 都得依问题而定;高维问题甚至需要每个维度各自一组,这又违背了自适应方法不用调参的初衷。他们也承认例子是刻意构造的,但认为实际情况里类似的现象至少会拖慢收敛。
证明错在哪
有了反例,就知道 Adam 原本的证明一定有一步不成立。论文在第 4 节与附录 D 指出,Adam 的证明假设 是半正定的,也就是学习率不会变大;这个假设在 Adam 上不成立。此外,Adam 证明中的引理 10.3 和 10.4 也有问题。
SGD 与 AdaGrad 的学习率本来就单调不增,所以不会碰到这个问题。这个观察直接指向了修正的方法。
AMSGrad
既然问题出在 会变小,那就让分母记住历史最大值:
和 Adam 唯一的区别是第三行。 照样用指数移动平均更新,所以它对梯度尺度的估计仍然只看最近一段时间;但实际拿去当分母的 只增不减,学习率 因此单调不增, 保证是半正定的。多出来的成本只是一个和参数同样大小的向量。
回到上面那张表的 AMSGrad 列。分母一直停在 8.21,两个 各只推 ,一轮的净效果变成往正确方向走 。
作者拿它和 Adam、AdaGrad 比较了一个情境。假设某一步 ,也就是这一步的梯度比最近的平均小:
- Adam 会积极地把学习率调大,前面的反例就是被这一点拖垮的;
- AdaGrad 会把学习率稍微调小,长期累积下来,学习率可能小到几乎不动;
- AMSGrad 既不调大也不调小。
AMSGrad 的收敛保证(Theorem 4)沿用 Adam 论文的分析框架,并修掉了上面的问题。条件是 、、,可行域直径与梯度有界,遗憾的上界多了一个 ;论文写道,取 ,或较温和的 ,都能保证 的遗憾。
有两个细节要留意。证明需要 随时间递减,但作者也写明实践中通常固定 。另外,论文里的 Adam 去掉了偏差修正,脚注说这是为了简化,反例的论证对有修正的版本同样适用;AMSGrad 的 Algorithm 2 也没有偏差修正。
论文也提了另一条路 AdamNC,结构不变,改让 随时间增加。取 时, 刚好是所有历史梯度平方的平均,相当于一个带动量的 AdaGrad。
讨论
合成实验
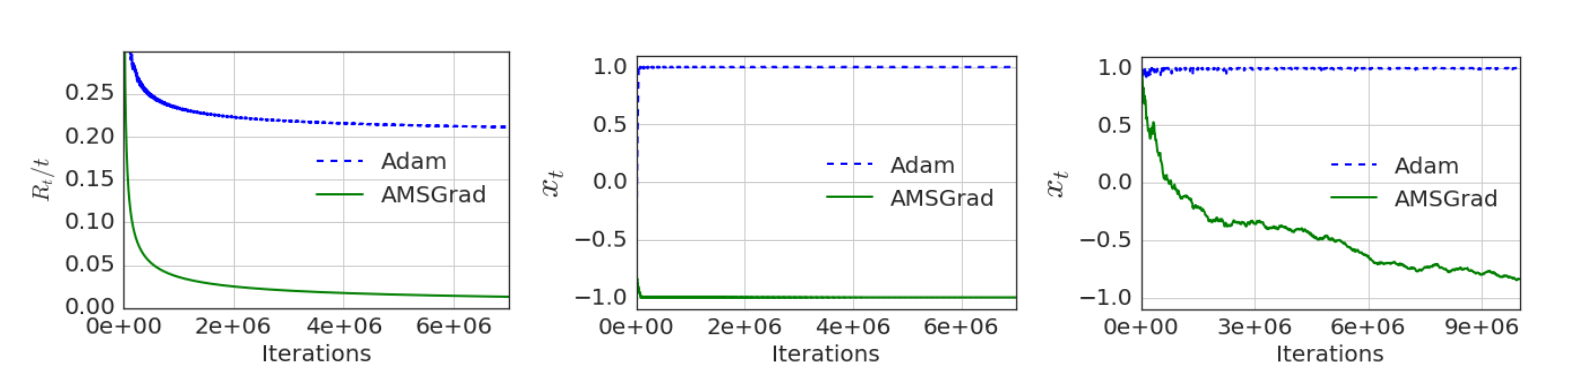
实验用的是反例的放大版。每 101 步出现一次损失 ,其余 100 步是 ,一个周期的梯度总和是 ,最优解仍是 。这次用的是常见的 、,两个方法参数相同。
左图是平均遗憾。Adam 的蓝色虚线在 0.21 附近变平,不再下降;AMSGrad 的绿线降到接近 0。中图是参数本身,Adam 停在 ,AMSGrad 停在 。
右图是随机版本,每一步以 1% 的概率看到 ,否则是 。Adam 一样停在 。AMSGrad 往下走得很慢,到一千万步时大约在 ,还没到 。
真实数据
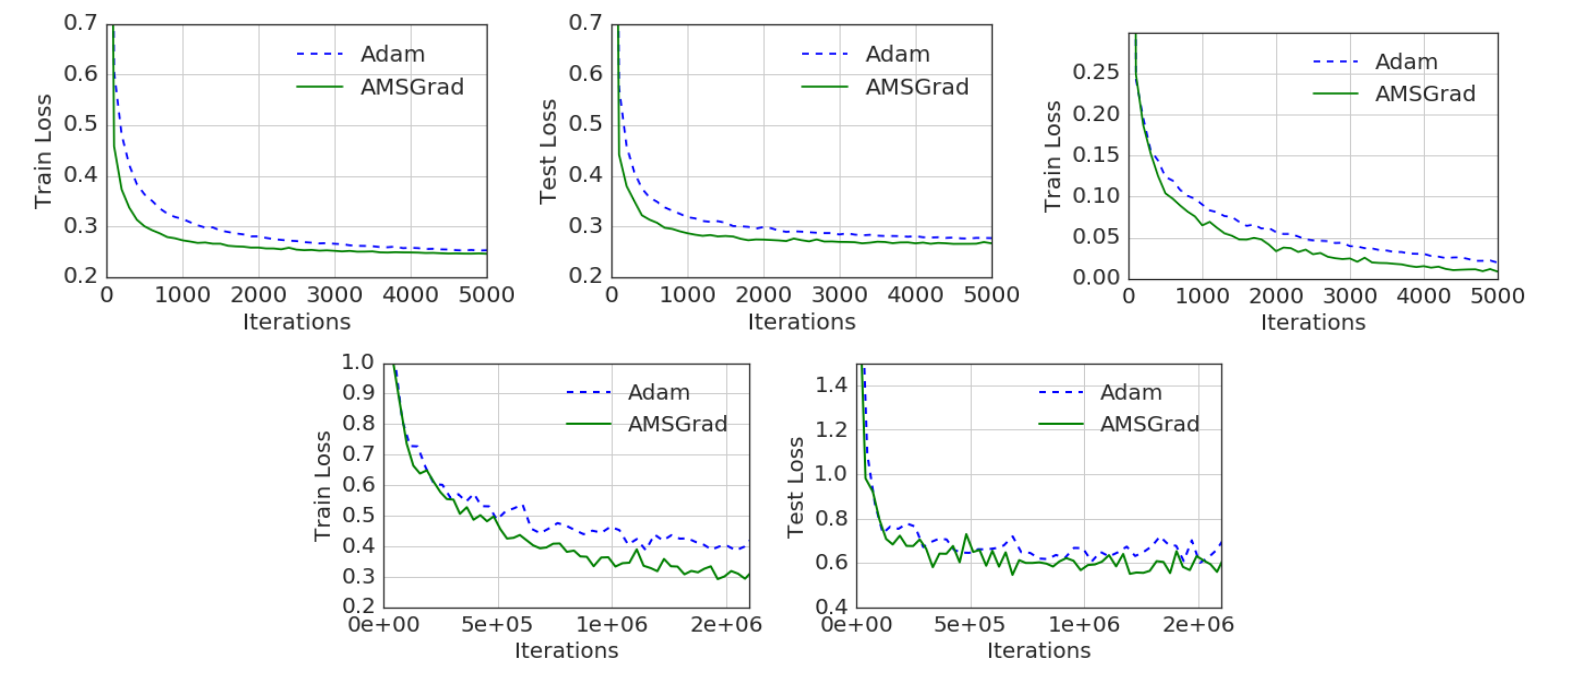
真实数据的实验有三组,批量大小都是 128,, 从 中挑:
- MNIST 逻辑回归(上排左、中)。凸问题,学习率照理论用 递减, 与 用网格搜索。AMSGrad 的训练与测试损失都略低,作者也提到它对参数变动比较不敏感。
- MNIST 单隐藏层网络(上排右)。100 个 ReLU,学习率固定。AMSGrad 的训练损失一路略低于 Adam。
- CIFAR-10 的 CIFARNET(下排)。两层 64 通道、 卷积,接 384 与 192 的全连接层,中间有最大池化、局部响应归一化与 dropout。训练损失的差距最明显,大约 0.3 对 0.4;测试损失两者都在 0.6 附近,AMSGrad 略低。
读这组结果要清楚它的范围。图上只有损失,没有准确率(正文说 AMSGrad 的准确率也比较好,但没有给数字);每条曲线看起来是单次运行,没有误差范围;模型也都很小。作者在贡献清单里自己称它为初步的实验。
实际使用中的反馈
AMSGrad 很快被各大框架收了进去,PyTorch 和 Keras 的 Adam 都有 amsgrad 参数,默认关闭。
用的人实际试过之后,反馈并不热烈。fast.ai 的 Sylvain Gugger 与 Jeremy Howard 在 2018 年 7 月的文章里,用 CIFAR-10 的 Wide ResNet、Stanford Cars 上微调 ResNet-50、WikiText-2 上的 AWD-LSTM 与 QRNN 语言模型做比较,写道 amsgrad 一直没有在准确率或其他指标上带来任何好处,形容它「非常令人失望」。
AMSGrad 自己的证明后来也被挑出问题。Phuong 与 Phong 在 2019 年指出,它的证明在处理 和 时把两者当成相等,Adam 原本的证明也有同样的疏漏;他们给出了新的证明,也提出另一个变体 AdamX。
Adam 其实会收敛?
反例成立,Adam 在实践中又确实好用,两者要怎么放在一起看?后续几篇工作给出的答案,差在它们先固定了什么:
| 工作 | 先固定什么 | 结论 |
|---|---|---|
| Reddi 等人 2018 | 先选 ,再造问题 | Adam 可以不收敛 |
| Zhang 等人 2022 | 先给问题,再选 | 够大就收敛 |
| ADOPT 2024 | 改算法 | 任何 都收敛 |
Zhang 等人 2022 点出了顺序的问题。Reddi 等人是先选定 ,再针对它构造一个坏问题,前面算过, 需要四万多步的周期;实践中却是问题先摆在那里,我们再去调超参数。他们证明,对固定的问题,只要 够大(门槛依问题而定)且 ,不改任何更新规则的 Adam 会收敛到临界点附近,范围大小和随机梯度的方差成正比;在更强的条件下会收敛到临界点本身。这个分析针对非凸的有限和问题,每个 epoch 随机打乱样本顺序,不需要梯度有界的假设,也涵盖了默认的 。反过来, 太小时存在一大片会发散的 。
同一时期,Défossez 等人在光滑非凸、梯度有界的条件下给了一个简短的收敛证明,也指出默认参数的 Adam 严格来说不收敛,行为比较像固定步长的 SGD。
ADOPT 2024 回头检查 AMSGrad。它指出 AMSGrad 在非凸问题上的收敛证明,都假设随机梯度一致有界;变分自编码器、扩散模型这类在梯度里注入高斯噪声的模型,并不满足这个条件。问题出在取最大值这一步,期望值很难控制。ADOPT 换了一个做法,用上一步的 去归一化这一步的梯度,让分母不含当前的梯度,并且先归一化、再累积动量。在梯度二阶矩有限的条件下,它对任何 都达到 的收敛速率。
最后还有一个注脚。2026 年 7 月的一篇预印本〈On the Convergence of Adam, Revisited〉宣称,在 Reddi 等人同样的在线设置里,连 这个条件都不需要,任何 都找得到让 Adam 平均遗憾不归零的例子,用的还是斜率 的三步循环,而且可以推广到 AdamW、Muon 等变体。这和 Zhang 等人的正面结果并不冲突,两边回答的是不同顺序的问题。
结论
这篇论文用一个三步一轮的线性函数,证明了 Adam 原始的收敛定理有误,并把问题定位在指数移动平均让学习率可以变大。AMSGrad 用历史最大值当分母,让学习率单调不增,恢复了凸问题上的收敛保证。真实数据上的改善很小,实验也只到初步的程度,后来独立的测试多半没有看到好处;这篇留给后续研究的,是 这个分析角度,以及「先固定哪一边」这个问题。
实际使用时,amsgrad=True 只是一个开关,怀疑数据里有罕见但重要的大梯度时,可以和调大 一起列入比较;前者只多一份和参数同样大小的状态,后者不增加任何成本。Zhang 等人证明 太小时有一大片会发散的区域;照这个结果推,如果为了反应快把它调低,训练出现不稳定时,先把它调回接近 1 再说。
三步一轮的小游戏倒是一直没退休。八年后还是同样的 ,这次连 都不用假设,顺手把 AdamW 和 Muon 也拉了进来。