原始论文
Adafactor: Adaptive Learning Rates with Sublinear Memory Cost
- 发表版本
- ICML 2018会议
- arXiv 首次提交
- arXiv:1804.04235
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizersadafactor2018,
  title = {{Adafactor: Adaptive Learning Rates with Sublinear Memory Cost}},
  author = {Noam Shazeer and Mitchell Stern},
  year = {2018},
  eprint = {1804.04235},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1804.04235}
}
翻开 T5 论文的训练设置,优化器那一行写着「For optimization, we use AdaFactor」。之后 FLAN、Flan-T5 的微调,PaLM 的 5,400 亿参数预训练,用的也是它。
回到源头,Adafactor 的论文只做了一个实验任务,一个英译德的 Transformer,每次训练在一块 TPU v2 上不到两小时。Noam Shazeer 和 Mitchell Stern 想解决的问题写在第一页,Adam 太吃显存了。
定义问题
Adam 为每个参数多存两个数,一阶矩 和二阶矩 。论文说这让显存占用变成三倍,权重一份、 一份、 一份。拿一个 的前馈层权重来算,它有 4,194,304 个参数,Adam 就得再存 8,388,608 个数。
2018 年时,作者观察到算力的增长远快于显存容量,显存已经是模型大小的上限之一。只算权重与优化器状态的话,Adam 多出来的那两份,让同样的显存只放得下三分之一大的模型。
作者想做到四件事:
- 把二阶矩从 个数压到 个;
- 拿掉一阶矩,;
- 处理拿掉动量之后冒出来的不稳定;
- 把步长改成相对于参数大小的比例。
前两件是省显存,第三件是省出来的麻烦,第四件则是作者顺手的改进。
解决问题
只记行和与列和
假设某一层权重是 的矩阵,Adam 会为它维护同样大小的平方梯度指数平均 。如果只存两个小矩阵 、,让 ,显存就会小很多。问题是要用什么方法分解。
最常见的低秩近似是截断 SVD,在 Frobenius 范数下最优,但它有两个问题。一是前 个奇异向量不能拆开相加,两个矩阵相加之后的奇异向量,和各自的奇异向量没有简单的关系,接不上指数平均;二是近似出来的元素可能是负的,而 Adam 要对 开根号再取倒数。
作者改用非负矩阵分解常用的 generalized KL divergence,又叫 I-divergence:
它永远不小于 0,只在 时等于 0。目标是在 、 都非负的条件下,让 最小。一般的秩 需要交替优化;秩 1 的情况有解析解(论文 Lemma 1):
是每一行(row)的和, 是每一列(column)的和,分母是全部元素的总和。换成白话,第 行、第 列的估计值,等于「第 行的和 × 第 列的和 ÷ 总和」。
我们拿一个 的例子算算看:
左上角是 ,右下角是 ,整个矩阵原封不动地还原了,因为第二行刚好是第一行的三分之一, 本身就是秩 1。把右下角的 2 改成 8,行和变成 ,列和变成 ,总和 30,右下角的估计只剩 。分解记得住每一行、每一列的整体大小,记不住某一格自己特别突出。
这个解只用到行和与列和,两者都是 的线性函数,所以「平均之后再加总」等于「加总之后再平均」。实现上直接对行和、列和各做指数平均就行,不必先还原出完整的 。 的那层权重,二阶矩从 4,194,304 个数变成 5,120 个。
作者把 的版本写成 Algorithm 2:
再照 Adam 的方式用 更新。偏置和向量形式的参数维持原本的逐元素 ,它们本来就不大。
拿掉动量,然后出事
第二步更简单,,连 都不存了。
实验都在 WMT'14 英译德的 Transformer 上做,100,000 步,每个 batch 约 4,096 个源端 token 加 4,096 个目标端 token,大约是原始 Transformer 论文的八分之一。每种设置都跑两次,一次有预热,学习率 ;一次没有,开头直接用 。指标是 newstest2013 开发集的 BLEU。
| 设置 | 有预热 | 无预热 |
|---|---|---|
| (A) Adam, | 25.6 | 0.1 |
| (B) Adam, | 25.4 | 23.1 |
| (C) 分解二阶矩, | 25.4 | 0.2 |
| (D) 只用行平均 | 25.2 | 0.3 |
| (E) 只用列平均 | 0.3 | 0.5 |
整理自原论文 Table 2,所有设置 。
有预热时,拿掉动量(A 对 B)、再分解二阶矩(C),BLEU 只差零点几。(D)、(E) 是两个更省的对照,只存行平均或只存列平均。行平均和基线差不多,列平均直接坏掉。作者的解释是这个模型的词嵌入和输出 softmax 共用同一个权重矩阵,每一行对应一个 token;高频 token 那一行的梯度远大于低频 token,只存列平均就把所有 token 混成同一个尺度。
麻烦在右边那一列。没有预热时,有动量的 (B) 还有 23.1,拿掉动量的 (A) 直接掉到 0.1。
过时的二阶矩
作者怀疑问题出在 。 小,二阶矩衰减快,Reddi 等人已经指出这会造成收敛问题; 大,估计值来自很久以前的梯度,模型变化快的时候就跟不上。
两种情况都看得到。 时有预热 25.6、无预热 0.1; 时两边是 18.4 和 15.6,稳定但学不好。
为了检查「跟不上」,作者定义了一个量:
是还没乘学习率的更新。如果 估得准,每个参数的 都应该在 1 附近,整个矩阵的 RMS 也接近 1。
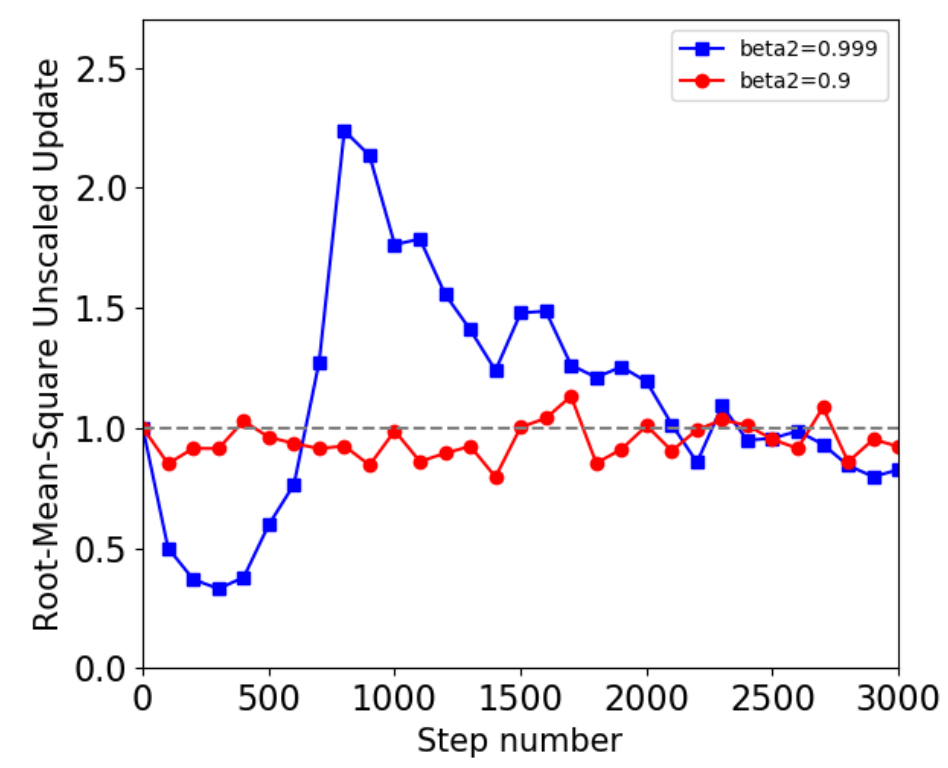
红线是 ,一直在 1 附近。蓝线是 ,前 300 步先掉到 0.33 左右,更新比预期小;接着在第 800 步左右冲到 2.24,更新比预期大了一倍多。这两次训练都有预热,最后都没有发散,所以不是「训练崩了才导致更新变大」;作者认为是过大的更新造成不稳定,并坦承这张图只是支持,还不是证明。
Update clipping
既然问题是更新过大,就直接限制更新:
RMS 超过阈值 ,就把整个矩阵的更新等比例缩回 。这和常见的梯度裁剪不同。梯度裁剪限制的是梯度,但 Adam 这类方法还会逐参数除以 , 一旦过时,裁剪过的梯度照样能被放大成很大的更新;update clipping 直接限制最后真正用上的那一步。
时,没有预热的 0.1 救回到 21.5; 阈值太松,仍然只有 0.2。有预热时,加不加裁剪没有明显差别。
让 随步数上升
另一条路是让 一开始小、后来大。作者先指出,Adam 的偏差修正本身就等价于一个递增的 :
它在 时是 0,之后渐渐逼近 。作者提出另一个调度:
以论文采用的 为例,第 10 步是 0.84,第 100 步 0.975,第 1,000 步 0.996,大约第 5,600 步越过 0.999,第 10,000 步是 0.9994。训练初期像快衰减,稳定;后期像慢衰减,估计更准。
这个调度还有两个好处。,所以所有历史梯度的权重总和恰好是 1,不需要偏差修正。另外,作者用无穷乘积的收敛条件证明, 才能让每一个旧梯度的权重最后都趋近 0; 时 升得太快,早期的梯度会一直留着不小的比重。 正好是所有平方梯度的算术平均。
| 设置 | 有预热 | 无预热 |
|---|---|---|
| (G) | 18.4 | 15.6 |
| (H) ,裁剪 | 25.4 | 21.5 |
| (I) ,裁剪 | 25.7 | 0.2 |
| (J) 分解,,裁剪 | 25.6 | 22.4 |
| (K) | 25.6 | 21.1 |
| (L) | 25.6 | 0.1 |
| (N) ,裁剪 | 25.9 | 22.4 |
整理自原论文 Table 2,皆为 。
单独使用就撑住了无预热的情况; 单独使用还不够,要配上裁剪。(N) 拿到全表有预热时最高的 25.9,(J) 则显示分解二阶矩加上裁剪,也能做到和有动量的 Adam 差不多的稳定。
相对步长
最后一个零件和显存无关。Adam 的学习率是绝对步长,作者认为参数的相对变化比较重要,于是让步长乘上参数本身的大小:
是这个参数矩阵目前的均方根, 是下限,让初始化为 0 的参数也能离开原点。论文的致谢特别提到 Geoffrey Hinton 的看法,每次更新的大小大约是参数大小的 到 倍时,训练会很顺。
作者用三种词嵌入初始化测试(50,000 步,batch 16,384 个 token,词嵌入不和 softmax 共用)。原始 Transformer 的做法是用标准差 初始化、计算时再乘 ,这样同一个绝对学习率对词嵌入和其他权重都合适,Adam 26.4、Adafactor 26.6。换成较天真的初始化,Adam 掉到 25.8 和 24.2,Adafactor 还有 26.4 和 25.4。参数尺度设得不好时,相对步长受的影响比较小。
组起来
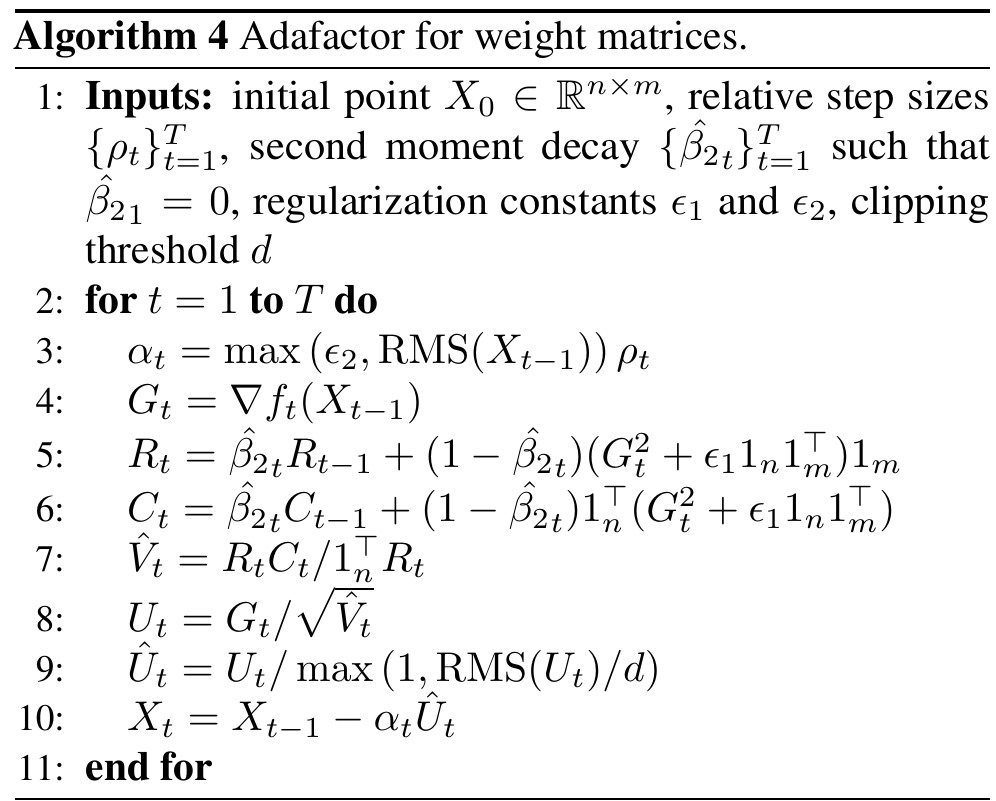
把五个零件串起来就是 Algorithm 4。第 3 行是相对步长,第 5、6 行是加了 的行和、列和平均,第 7 行还原二阶矩,第 9 行是 update clipping。论文建议的超参数是 、、、、,没有动量。整个优化器对一个 矩阵只多存 个数。
讨论
完整版的成绩
| 设置 | 有预热 | 无预热 |
|---|---|---|
| (A) Adam, | 25.6 | 0.1 |
| (B) Adam, | 25.4 | 23.1 |
| (O) Adafactor | 25.0 | 25.5 |
| (P) Adafactor 加回动量 | 24.9 | 25.3 |
| (Q) SGD,最佳学习率 | 24.3 | 9.1 |
整理自原论文 Table 2;(O)、(P) 使用相对步长 ,(Q) 有预热时 、无预热时 ,更大的学习率在无预热时全部发散。
完整的 Adafactor 在没有预热时拿到全表最高的 25.5,有预热时是 25.0,比没有动量的 (A) 低了 0.6,比有动量的 (B) 低 0.4。作者自己也说,相对步长那几行的步长和其他行不能直接比,无法断定稳定性是不是相对步长带来的。SGD 同样不额外占显存,但最好也只有 24.3,而且对学习率很敏感。
这些结果只来自一个翻译任务、一种模型、10 万步,以及比原始设置小八倍的 batch。论文最后说省下的显存「应该」能训练大得多的模型,但没有任何大模型实验,也没有实测显存或速度。
后来的 Adafactor
真正的大规模测试,是别人做的。
T5 直接采用 Adafactor,预训练的学习率「前一万步固定 0.01,之后按平方根倒数衰减」,其实就是这篇的 。T5 公开的训练配置文件也沿用论文的 、update clipping 阈值 1.0、分解二阶矩与参数缩放。
DeepMind 训练 Gopher 时试过另一个方向。在 14 亿参数时 Adafactor 稳定好用,到了 71 亿参数就开始出现小幅的损失发散;Adam 的最大学习率是 ,Adafactor 降到 还是不稳。他们最后仍用 Adafactor 微调 Gopher,因为硬件需求低很多。
Google 训练 20 亿参数的 ViT-G 时,说 Adafactor「不能直接用」,改了三处,加回半精度的一阶矩、停用相对于权重范数的步长缩放,并把 的上限截在 0.999。改完后和 Adam 表现相当或略好。
PaLM 的做法更直接。论文写明用的是「不做分解」的 Adafactor,效果近似带参数缩放的 Adam;动量 ,二阶矩用 ,学习率前一万步 再按 衰减。他们特别说明,这个 调度比固定 0.99 稳定,因为罕见 token 的词嵌入在短时间窗口内估不准二阶矩。
update clipping 也被单独带走了。Wortsman 等人在 2023 年发现大型 CLIP 训练的 loss spike,总在二阶矩低估平方梯度后的 1 到 8 步出现,于是提出 StableAdamW,也就是「加上 Adafactor update clipping 的 AdamW」。他们也写道,大规模训练已经不太用原始形式的 Adafactor,推测原因是分解二阶矩或没有动量。
在库这一边,Hugging Face Transformers 很早就有 Adafactor,PyTorch 则到 2.5 版才加入 torch.optim.Adafactor。两者默认都用相对步长(Hugging Face 可以关掉);PyTorch 的版本把 lr 当作 的上限,并说明 的位置刻意偏离了论文。
结论
Adafactor 用行和与列和的秩 1 分解,把二阶矩从 压到 ,再拿掉动量。拿掉之后的不稳定,作者追到过时的二阶矩,用 update clipping 和 的 调度处理掉。这些在一个翻译任务上成立,后来在 T5 的规模也撑住了;到了数十亿参数,Gopher 报告它不稳,PaLM 和 ViT-G 则把动量加了回来。
在 Hugging Face 里用 Adafactor 又想自己控制学习率的话,记得设 relative_step=False 和 scale_parameter=False。不然优化器会改用内置的 ,或把你的学习率再乘上参数的 RMS,写好的学习率调度就不会照原样生效。
PaLM 用的那个 Adafactor,最后连 factor 都拿掉了。