原始论文
PaLM: Scaling Language Modeling with Pathways
- arXiv 首次提交
- arXiv:2204.02311
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{transformerspalm2022,
  title = {{PaLM: Scaling Language Modeling with Pathways}},
  author = {Aakanksha Chowdhery and Sharan Narang and Jacob Devlin and Maarten Bosma and Gaurav Mishra and Adam Roberts and Paul Barham and Hyung Won Chung and Charles Sutton and Sebastian Gehrmann and Parker Schuh and Kensen Shi and Sasha Tsvyashchenko and Joshua Maynez and Abhishek Rao and Parker Barnes and Yi Tay and Noam Shazeer and Vinodkumar Prabhakaran and Emily Reif and Nan Du and Ben Hutchinson and Reiner Pope and James Bradbury and Jacob Austin and Michael Isard and Guy Gur-Ari and Pengcheng Yin and Toju Duke and Anselm Levskaya and Sanjay Ghemawat and Sunipa Dev and Henryk Michalewski and Xavier Garcia and Vedant Misra and Kevin Robinson and Liam Fedus and Denny Zhou and Daphne Ippolito and David Luan and Hyeontaek Lim and Barret Zoph and Alexander Spiridonov and Ryan Sepassi and David Dohan and Shivani Agrawal and Mark Omernick and Andrew M. Dai and Thanumalayan Sankaranarayana Pillai and Marie Pellat and Aitor Lewkowycz and Erica Moreira and Rewon Child and Oleksandr Polozov and Katherine Lee and Zongwei Zhou and Xuezhi Wang and Brennan Saeta and Mark Diaz and Orhan Firat and Michele Catasta and Jason Wei and Kathy Meier-Hellstern and Douglas Eck and Jeff Dean and Slav Petrov and Noah Fiedel},
  year = {2022},
  eprint = {2204.02311},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2204.02311}
}
「Google 刚雇了一头口才很好的鲸鱼进 TPU 团队,它示范了怎么在两个不同的 pod 之间沟通!」
这个双关语要懂两件事才笑得出来。pod 是一群 TPU 芯片,也是一群鲸鱼。2022 年 4 月,Google 在 PaLM 论文的第一张图里让模型解释这个笑话:
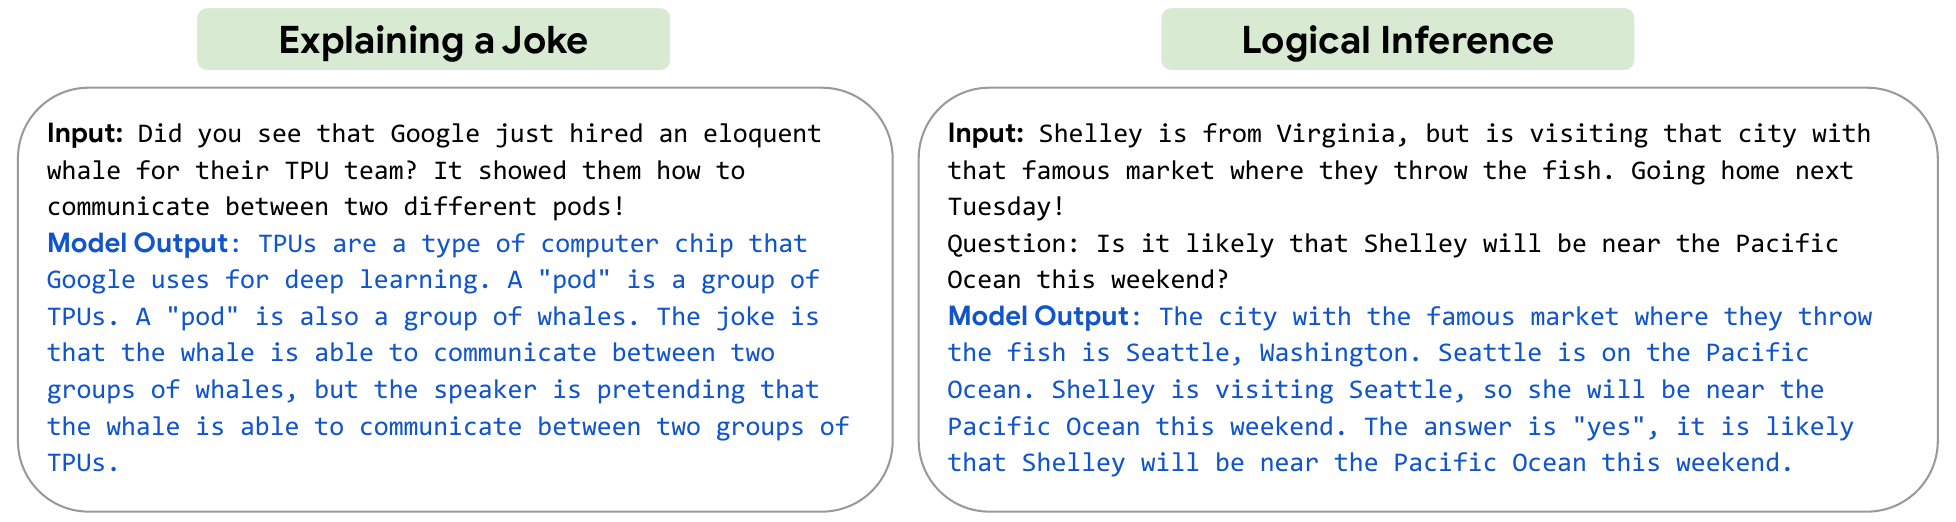
左边是笑话,模型的回答是,鲸鱼能在两群鲸鱼之间沟通,说话的人假装它能在两组 TPU 之间沟通。右边是另一种题目,模型要先认出「有人扔鱼的那座市场」在西雅图,才能回答 Shelley 周末会不会在太平洋附近。两个例子都用贪婪解码,提示词里放了两个带解释的示例,也就是同一年稍早提出的思维链提示。
笑话本身也在讲这篇论文。PaLM(Pathways Language Model)是一个 5,400 亿参数的稠密语言模型,在 6,144 块 TPU v4 芯片上训练,横跨两个 TPU v4 Pod,靠的是 Google 新的 Pathways 系统。
哎哟,烦死了!要解释这么多的笑话一点都不好笑。
定义问题
GPT-3 之后,GLaM、Gopher、Chinchilla、Megatron-Turing NLG、LaMDA 接连刷新少样本学习的成绩。作者把这些进步归纳成四个方向:
- 把模型的深度与宽度放大;
- 增加训练的 token 数;
- 用更干净、来源更多样的数据;
- 用稀疏模块增加容量,但不增加计算量。
PaLM 主要沿着第一条走,放大一个所有参数都参与计算的稠密模型,看少样本能力是否已经饱和。
要做到这一点,先得解决工程问题。当时最大的训练规模是 4,096 块 TPU v3。Megatron-Turing NLG 用了 2,240 张 A100,Gopher 用了四个 TPU v3 Pod,两者都靠流水线并行(pipeline parallelism)跨越多台机器。流水线并行有「气泡」问题,流水线填满与排空时很多设备处于空闲,也会增加内存带宽的负担。作者想在不用流水线并行的情况下,把训练扩展到两个 Pod。
解决问题
架构:一组实用的改动
PaLM 是仅解码器的 Transformer,加上几个改动:
- SwiGLU:前馈层的激活函数改成 。这需要三次矩阵乘法,但 Shazeer 在计算量相同的对比中证明了它的质量更好。
- 并行层:标准写法是先过注意力再过前馈,PaLM 让两者读同一个输入,再把结果相加:
注意力和前馈的输入矩阵乘法可以合并,大规模下训练快约 15%。作者的消融显示,8B 时质量略降,62B 时没有差别,因此推测 540B 也不受影响。
- Multi-Query Attention:每个注意力头有自己的 query,但所有头共用同一组 key 和 value。对训练质量与速度影响不大,自回归解码时则能省下大量成本。(后来 Llama 2 的 34B 与 70B 改用介于两者之间的 GQA。)
- RoPE 位置编码、输入输出共享嵌入。
- 不用偏置:所有稠密层与 LayerNorm 都没有偏置项,作者发现这让大模型训练更稳定。
- 256k 的 SentencePiece 词表:完全可逆,保留所有空白字符(对代码很重要),词表外的 Unicode 字符拆成 UTF-8 字节,数字一律按位拆开,例如「123.5」变成「1 2 3 . 5」,第二年的 LLaMA 也照着做。
三种大小的配置如下,前馈层宽度固定是 ,每个注意力头固定 256 维:
| 模型 | 层数 | 注意力头数 | 参数量 | 批量大小 | |
|---|---|---|---|---|---|
| PaLM 8B | 32 | 16 | 4,096 | 86.3 亿 | 256 → 512 |
| PaLM 62B | 64 | 32 | 8,192 | 625 亿 | 512 → 1,024 |
| PaLM 540B | 118 | 48 | 18,432 | 5,403.5 亿 | 512 → 1,024 → 2,048 |
整理自原论文 Table 1。
数据:7,800 亿个 token,只看一遍
训练数据以 LaMDA 和 GLaM 的数据为基础,总共 7,800 亿个 token:社交媒体对话 50%、过滤后的网页 27%、英文书籍 13%、GitHub 代码 5%、维基百科 4%、英文新闻 1%。网页按一个质量分类器的分数采样,分数越高越常被选中,但低分网页没有被完全排除。代码取自 GitHub 上的开源项目,排除 copyleft 许可证并限定 24 种常见语言后得到 196GB 源代码,再用 Levenshtein 距离去除重复文件。非英文数据约占 22%。
三个模型都只看过这批数据一次,各来源的比例也经过安排,避免任何一部分被重复看到。
基础设施:不用流水线并行,跨两个 Pod
每个 TPU v4 Pod 有 3,072 块芯片、768 台主机。Pod 内部,每个权重张量切成 12 份做模型并行,再以 256 路做完全分片的数据并行;每个 Pod 都有一份完整的模型。
两个 Pod 之间则交给 Pathways 做数据并行。一个 Python 客户端把 batch 分成两半送到两个 Pod,各自算完前向与反向传播后交换梯度,再各自累加、更新参数,得到逐比特相同的权重。
难点在跨 Pod 的网络。梯度要等每块芯片都算完才开始传,所以 1,536 台主机会在同一瞬间一起传数据;每对主机每一步要交换约 1.3GB 的梯度,瞬时总流量达到 81 Tbps。作者把梯度切成小块,分散到多条数据中心网络链路上传送,最后两个 Pod 的吞吐量是单个 Pod 的 1.95 倍。和理论上的 2 倍差的那一点,来自反向传播与跨 Pod 梯度传输没有重叠。
用模型 FLOPs 利用率衡量效率
作者认为过去常用的「硬件 FLOPs 利用率」(HFU)不适合拿来比较。它取决于实现,例如用重计算(rematerialization)拿计算换内存时,硬件 FLOPs 会变多,但这不是训练真正追求的东西。训练要的是每秒处理多少 token。
所以作者提出模型 FLOPs 利用率(MFU):实际的 token 吞吐量,除以「硬件以峰值算力只做必要计算时」的理论吞吐量。必要计算只算前向与反向传播,不算重计算。一个 参数的解码器,每个 token 需要 次矩阵运算 FLOPs(前向 、反向 ),注意力再加上 。我们拿 PaLM 540B 的数字算一次:
N = 540.35e9                     # 参数量
L, H, Q, T = 118, 48, 256, 2048  # 层数、注意力头数、每头维度、序列长度
chips, peak = 6144, 275e12       # TPU v4 芯片数、每块芯片的峰值矩阵运算 FLOP/s
tokens_per_sec = 238.3e3         # 实测的训练吞吐量

flops_per_token = 6 * N + 12 * L * H * Q * T   # 前向 2N + 反向 4N,再加注意力
mfu = tokens_per_sec * flops_per_token / (chips * peak)
print(f"{6 * N:.3e} {12 * L * H * Q * T:.3e}")  # 3.242e+12 3.563e+10
print(f"{mfu:.1%}")                              # 46.2%
注意力那一项只有 的 1% 左右,大模型的计算量几乎都花在和权重相乘的矩阵乘法上。按同样的方式计算,GPT-3 是 21.3%,Gopher 32.5%,Megatron-Turing NLG 30.2%。PaLM 的 46.2% 来自并行策略、XLA 编译器优化与并行层。如果把重计算的 FLOPs 也算进去,硬件利用率是 57.8%。
训练设置与损失尖峰
几个比较特别的设置:
- 优化器是不做因子分解的 Adafactor,效果近似于带「参数缩放」的 Adam。前 1 万步学习率固定为 ,之后按 递减;二阶矩的系数设为 , 是步数,作者发现这比固定 0.99 更稳定,因为罕见 token 的嵌入在短窗口内估不准二阶矩。
- 额外加一项 z-loss,,让 softmax 的归一化项 接近 0,提升稳定性。
- 批量大小随训练加倍。540B 先用 512 条(约 100 万 token)训练到第 5 万步,再用 1,024 条训练到第 11.5 万步,最后用 2,048 条(约 400 万 token)训练到第 25.5 万步结束。早期小批量更省样本,后期大批量的梯度估计更准,矩阵也更大、TPU 效率更高。
- 预训练不用 dropout,而且从任何 checkpoint 重启都能逐比特复现。
即使有梯度裁剪,540B 在训练中仍出现了约 20 次损失尖峰,间隔很不规律,有时出现在训练后期;小模型没有这个问题。作者没有找到有原理支撑的解法,最后是从尖峰前约 100 步的 checkpoint 重启,跳过尖峰前后的 200 到 500 个 batch。
他们也检查了是不是「坏数据」造成的。把尖峰附近的那些 batch 拿到更早的 checkpoint 上训练,并不会出现尖峰。所以尖峰是特定数据与特定参数状态碰在一起才会发生。前面提到的逐比特复现,也让这类检查可以做得很干净,从同一个 checkpoint 重跑,结果完全相同。
讨论
英文 NLP 与 MMLU
在 GPT-3 论文用过的 29 个英文评测上,PaLM 540B 的少样本成绩在 28 个上创下新高,比较对象是 GLaM、GPT-3、Megatron-Turing NLG、Gopher、Chinchilla 与 LaMDA 各自的最好成绩。MMLU 的 5-shot 平均是 69.3,此前的最佳是 Chinchilla 的 67.5;四大类中只有「其他」这一类输给了 Chinchilla。
BIG-bench:超过人类平均,但不是每一项
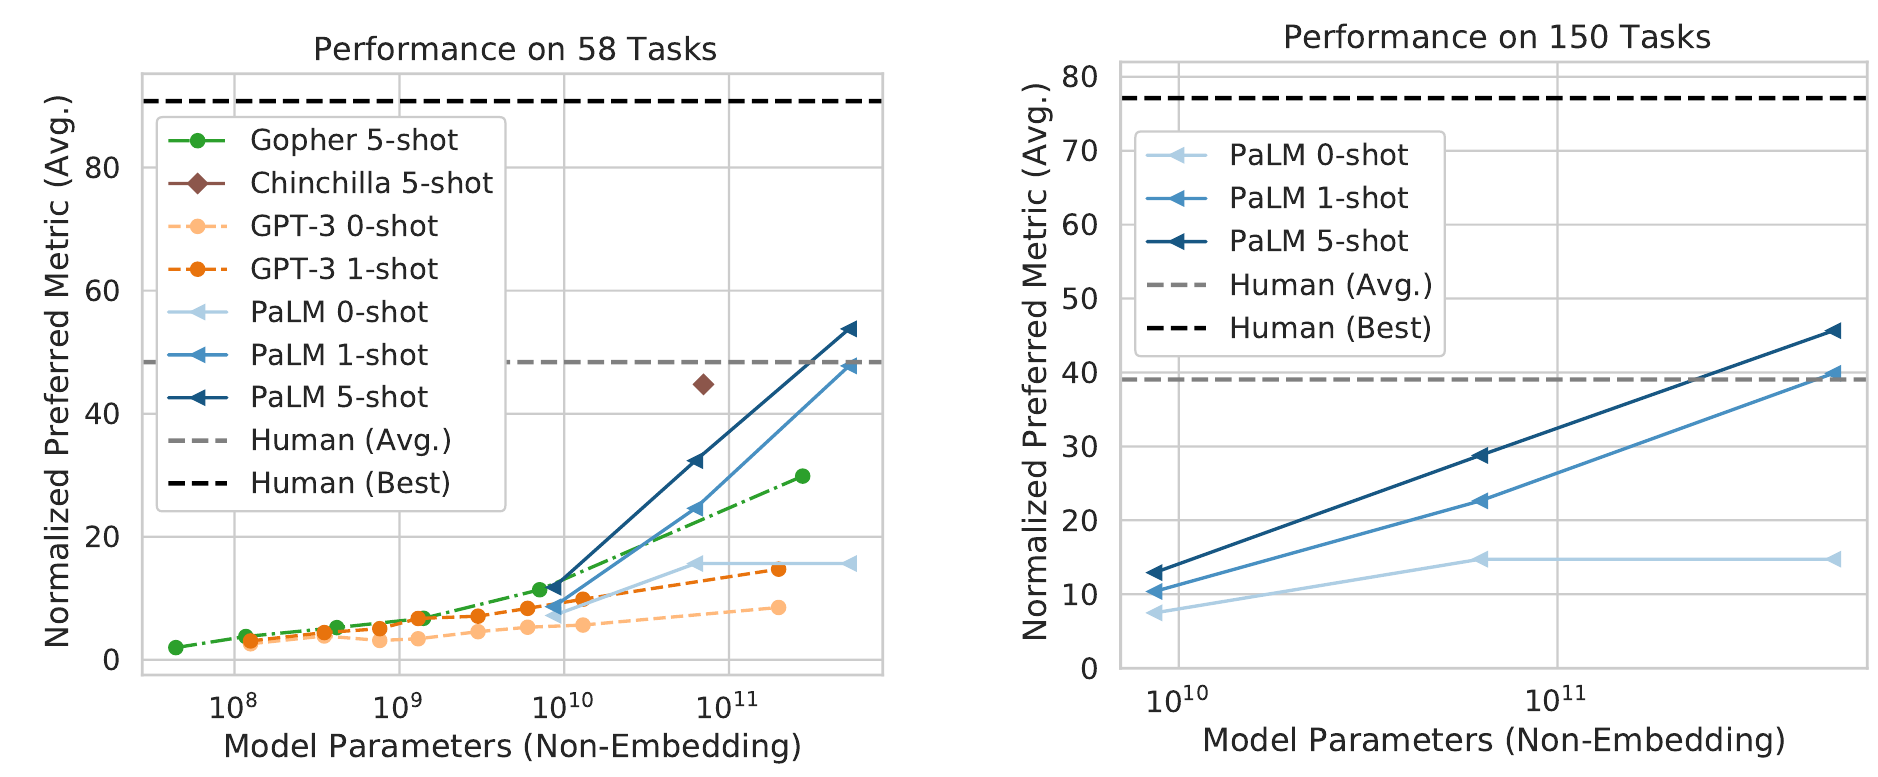
BIG-bench 是一个超过 150 个任务的集体评测。人类基准的获取方式是请众包工人(通常 10 人)看同样的任务说明与示例作答,可以使用搜索引擎、计算器等任何工具;「人类平均」是所有人的平均,「人类最佳」是每题取最高分。
左图只看三个模型家族都评过的 58 个任务。PaLM 540B 的 5-shot 高于人类平均,在其中 44 个任务上超过先前的最佳成绩。三个 PaLM 尺寸大致落在一条对数线性的直线上,作者据此认为继续放大还会更好。右图是 PaLM 在 150 个任务上的表现,趋势相似。
离人类最佳还很远。逐个任务看的话,人类平均仍在 35% 的任务上胜过 PaLM 540B。
不连续的进步
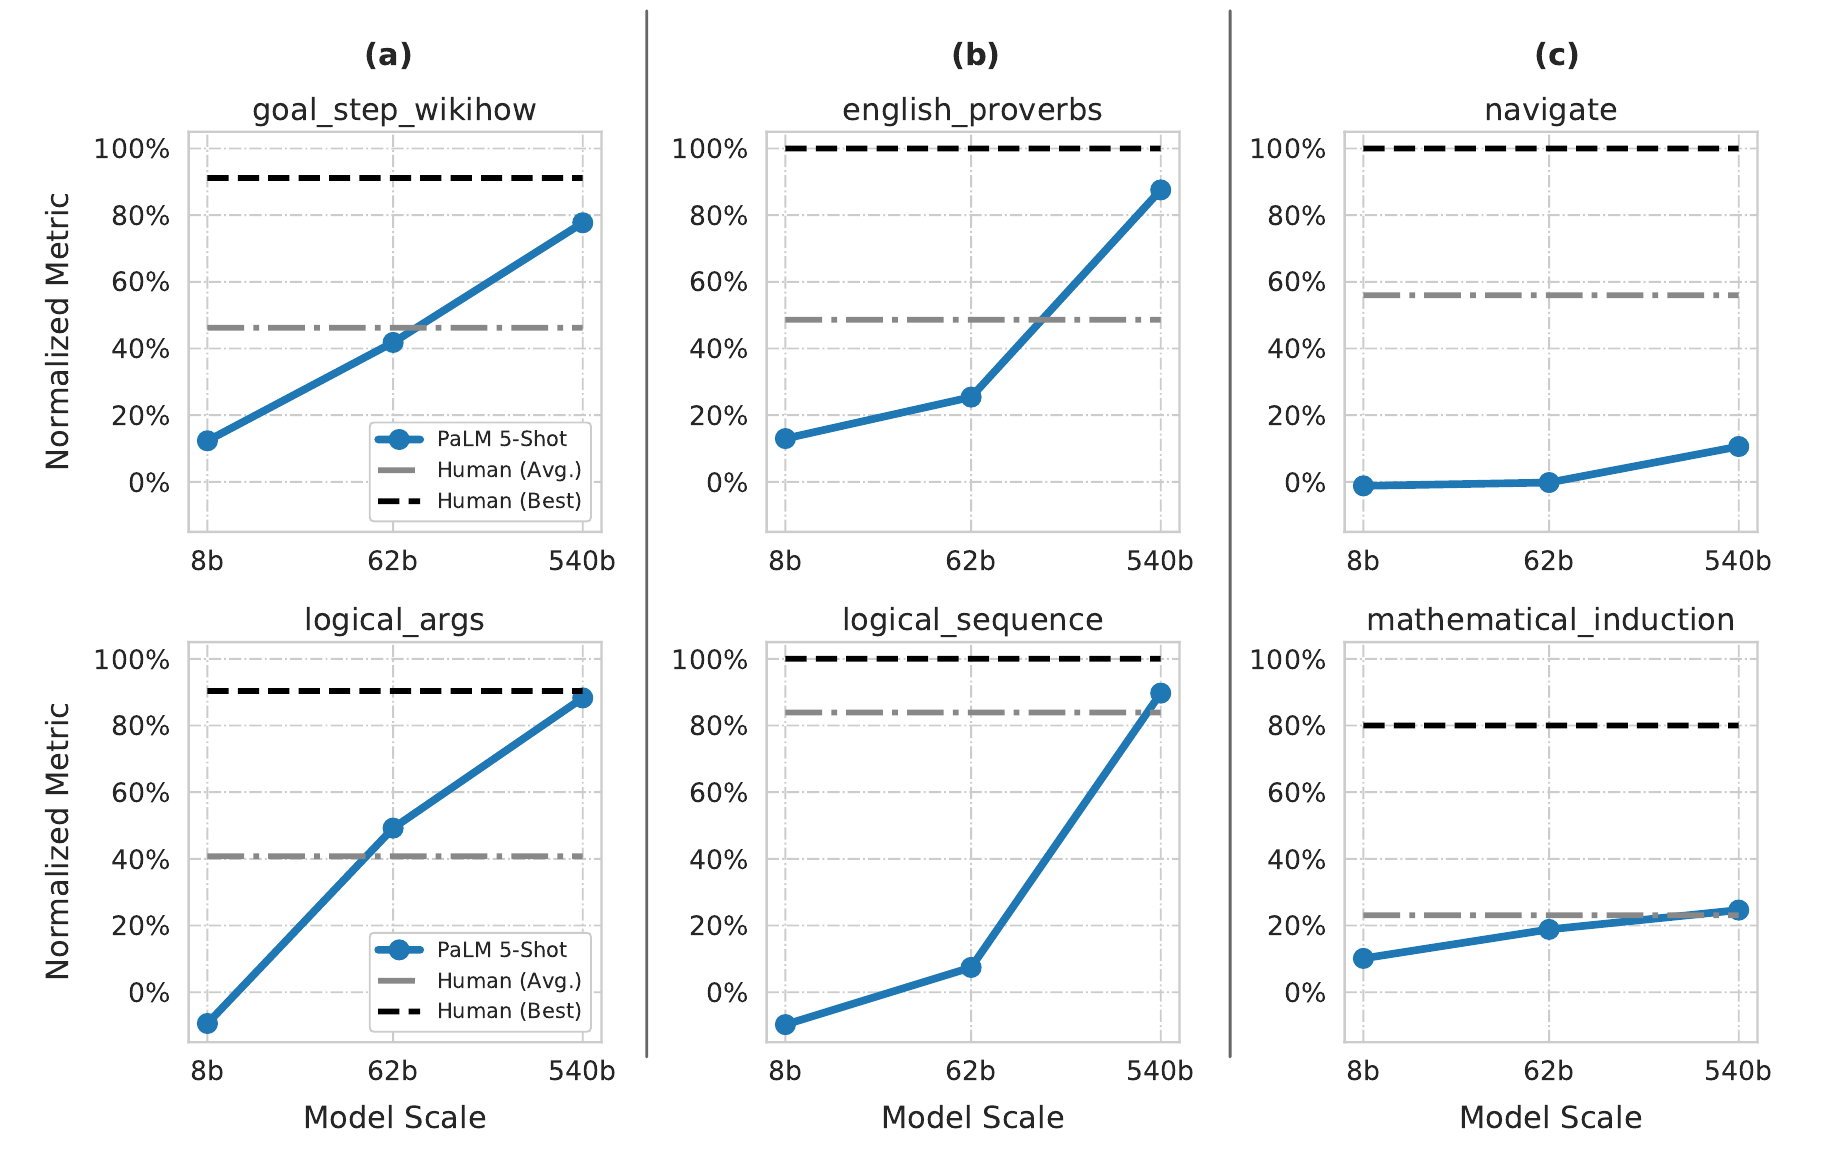
作者挑了六个任务,展示三种不同的规模曲线。(a) 是随规模稳定上升;(c) 是几乎没有进步,540B 只比 62B 好一点,离人类最佳很远;(b) 则是 8B 到 62B 只进步一点,62B 到 540B 突然大跳。
作者这样量化「不连续」。以 english_proverbs 为例,三个尺寸的分数约是 13%、25%、87%。从 8B 到 62B 参数大约乘以 8,62B 到 540B 也差不多,如果按前一段的对数线性趋势外推,540B 应该是 ,实际却是 87%,差了 50 个百分点。在全部 150 个任务中,25% 的任务不连续程度超过 10 个百分点,15% 超过 20 个百分点。
english_proverbs 要理解谚语背后的隐喻,作者认为这需要很强的抽象推理能力。mathematical_induction 则相反,题目会给出可能与现实数学矛盾的前提,例如「2 是奇数」,再问归纳推理是否正确;所有 PaLM 尺寸,以及做同一任务的人类,在前提错误的题目上都有困难。
推理与代码
PaLM 也用了同一团队稍早提出的思维链提示。8-shot 加思维链与外部计算器,GSM8K 达到 58%:
| 模型与技术 | GSM8K 准确率 |
|---|---|
| PaLM 540B,思维链 + 计算器 | 58% |
| PaLM 540B,思维链 | 54% |
| PaLM 540B,不用思维链 | 17% |
| PaLM 62B,思维链 | 33% |
| GPT-3,微调 + 思维链 + 计算器 | 34% |
| GPT-3,微调 + 思维链 + 计算器 + 验证器 | 55% |
整理自原论文 Table 10。
此前的 55% 需要微调、计算器,再加一个专门训练的验证器;PaLM 只靠少样本提示就超过了它。
代码方面,PaLM 540B 没有专门针对代码训练,HumanEval 的 pass@100 是 76.2%,和专门的 Codex 12B(72.3%)相当。PaLM 的训练数据里只有约 27 亿个 Python token,不到 Codex(约 1,000 亿)的三十分之一。作者把这解读为从其他编程语言与自然语言的迁移,加上大模型的样本效率更高。再用代码微调得到的 PaLM-Coder 540B,HumanEval pass@100 达到 88.4%。
记忆与偏见
作者从训练数据中随机抽取 100 个 token 的片段,给模型前 50 个 token,看它能否用贪婪解码一字不差地续写出后 50 个。8B 有 1.6% 的片段能续写出来,540B 有 2.4%,模型越大记得越多。只出现过一次的片段,540B 的记忆率是 0.75%;出现超过 500 次的则超过 40%。代码语料里有大量许可证条款与复制粘贴的代码片段,最容易被记住;书籍语料多半是独一无二的文本,最不容易。
偏见分析中,模型在宗教相关的续写里,会把伊斯兰教与恐怖主义、极端、暴力这类词语联系在一起,这个倾向在各个尺寸上都存在。毒性方面,62B 与 540B 的整体毒性略高于 8B;模型续写的毒性和提示词本身的毒性高度相关,人类续写则没有这么强的相关性。
作者自己留下的问题
论文的「规模化的开放问题」一节很有意思。PaLM 主要放大的是模型大小,但作者坦承没有做消融去区分「模型更大」和「看更多 token」各自的贡献。他们问,如果用同样的训练预算,训练一个看 7 万亿 token 的 62B 模型,或看 3.6 万亿 token 的 120B 模型,和看 7,800 亿 token 的 540B 比起来会怎样?如果小模型表现相当,推理成本会低得多。
DeepMind 的 Chinchilla 在 PaLM 发表前一周,刚处理过同样的问题。作者把两边能对照的结果放在一起看:
| 模型 | 参数(B) | Token(B) | 训练 FLOPs(ZFLOPs) | 9 项英文评测平均 |
|---|---|---|---|---|
| PaLM 62B | 62 | 795 | 295.7 | 64.8 |
| Chinchilla | 70 | 1,400 | 588.0 | 65.2 |
| Gopher | 280 | 300 | 504.0 | 59.5 |
| PaLM 540B | 540 | 780 | 2,527.2 | 70.3 |
整理自原论文 Table 21。
训练 FLOPs 约为 Chinchilla 一半的 PaLM 62B,和 Chinchilla 平均只差 0.4 分;Gopher 则明显落后。作者同意这支持 Chinchilla 的结论,Gopher 就它的规模而言训练不足。但 PaLM 和 Chinchilla 用的是不同的数据,作者认为无法据此回答「X 大小的模型看 Y 个 token,会不会比 PaLM 540B 好」。
一年后的 PaLM 2 技术报告回答了一部分。它按 Chinchilla 的结论,让数据量与模型大小大致按 1:1 的比例放大;最大的 PaLM 2-L 比 PaLM 540B 小得多,训练算力却更多。
结论
把稠密模型推到 5,400 亿参数,少样本能力还在往上走。29 项英文评测拿下 28 项,GSM8K 只靠提示就超过了微调加验证器,四分之一的 BIG-bench 任务在 62B 到 540B 之间突然开窍。
如果你想知道自己的训练跑得有多高效,MFU 是现成的计算方法。每秒处理的 token 数乘以 ,除以芯片的峰值算力,就能和 PaLM 的 46.2% 放在一起比。
只是按 Chinchilla 每个参数大约 20 个 token 的比例,5,400 亿参数该读约 11 万亿个 token,PaLM 只读了 7,800 亿。鲸鱼很聪明,就是书读得少了点。