原始论文
Scaling Instruction-Finetuned Language Models
- arXiv 首次提交
- arXiv:2210.11416
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modeltuningflant52022,
  title = {{Scaling Instruction-Finetuned Language Models}},
  author = {Hyung Won Chung and Le Hou and Shayne Longpre and Barret Zoph and Yi Tay and William Fedus and Yunxuan Li and Xuezhi Wang and Mostafa Dehghani and Siddhartha Brahma and Albert Webson and Shixiang Shane Gu and Zhuyun Dai and Mirac Suzgun and Xinyun Chen and Aakanksha Chowdhery and Alex Castro-Ros and Marie Pellat and Kevin Robinson and Dasha Valter and Sharan Narang and Gaurav Mishra and Adams Yu and Vincent Zhao and Yanping Huang and Andrew Dai and Hongkun Yu and Slav Petrov and Ed H. Chi and Jeff Dean and Jacob Devlin and Adam Roberts and Denny Zhou and Quoc V. Le and Jason Wei},
  year = {2022},
  eprint = {2210.11416},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2210.11416}
}
FLAN 在 2021 年发现,把几十种 NLP 数据集改写成指令,拿来微调语言模型,模型就更会做没见过的任务。差不多同一时间,T0 和 InstructGPT 也各自用指令数据微调模型,结果都不错。
接下来的问题很自然。题目再多一点、模型再大一点,会不会更好?
Google 的 Chung 等人在这篇论文里把两边都推到了当时的极限。任务从 FLAN 的 62 种加到 1,836 种,模型最大用到 5,400 亿参数的 PaLM,另外还加进了思维链(chain-of-thought,CoT)数据。得到的模型叫 Flan-PaLM;同一套流程也拿来微调 T5,从 8,000 万到 110 亿参数,公开了权重,这就是后来很多人用过的 Flan-T5。
定义问题
在这之前的指令微调研究,各自只放大了一个方向。FLAN 用到 137B 的模型,但只有 62 种任务;Natural Instructions v2 收集了 1,600 多种任务,但模型最大只到 11B。两个方向一起放大会怎样,没有人试过。
另一个问题更麻烦。前人的指令数据几乎都是「直接给答案」的格式,而 PaLM 那一年最受瞩目的能力之一,是先写出推理步骤再回答的思维链。拿一堆直接给答案的题目微调,会不会让模型忘了怎么一步一步推?
所以这篇要回答三件事:
- 任务数量和模型大小一起放大,效果会怎么变?
- 指令微调会不会伤害思维链推理?如果会,怎么补?
- 这套做法换到别的架构、别的大小,还有没有用?
解决问题
1,836 种任务
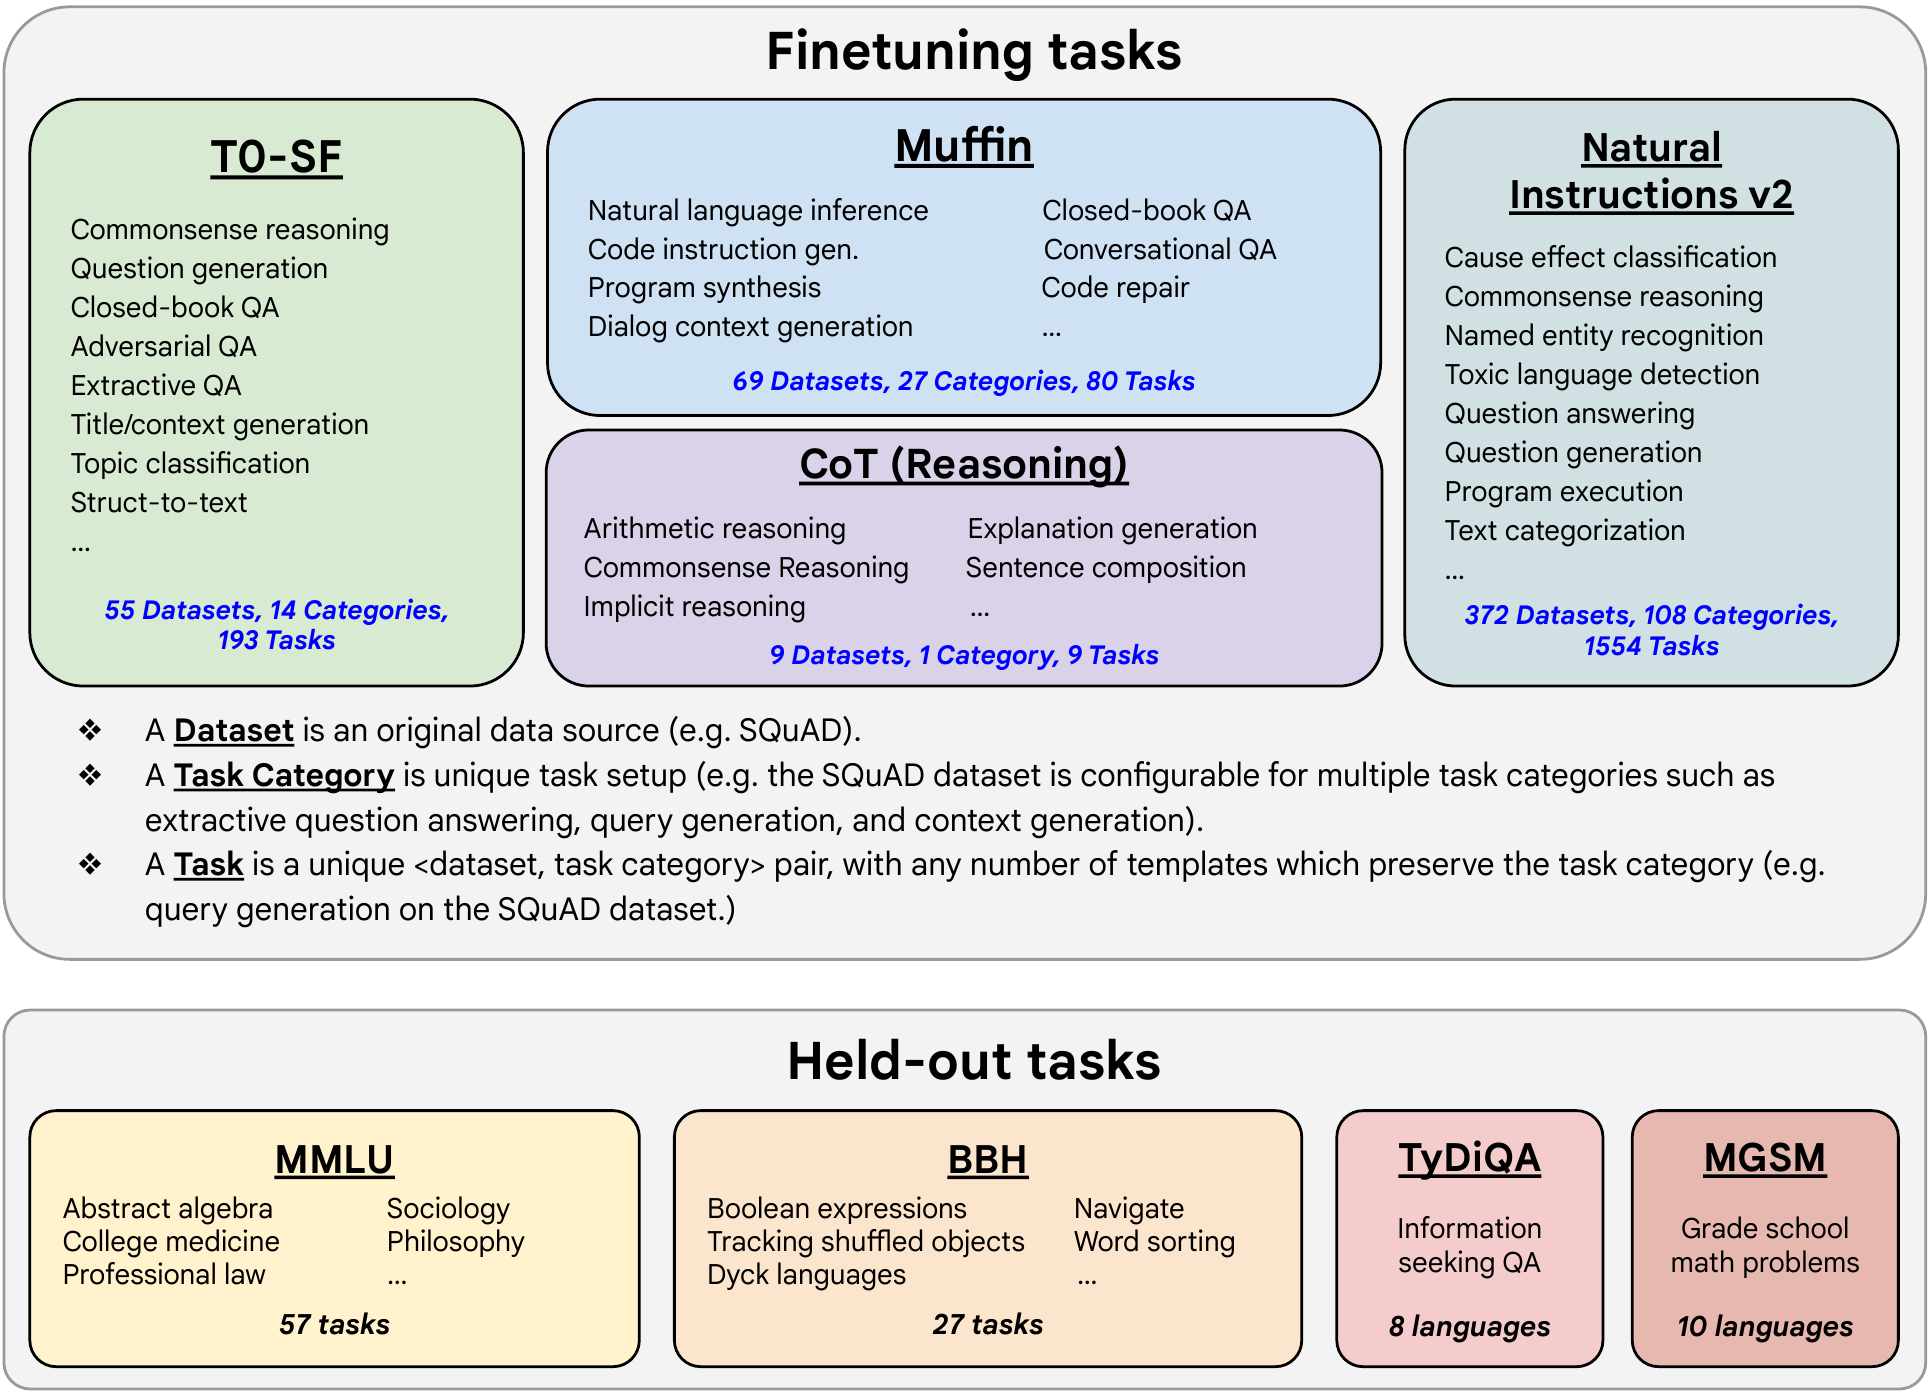
先分清楚图里的三个单位。数据集是原始数据来源,例如 SQuAD。任务类别是一种题型,同一个 SQuAD 可以拿来做抽取式问答、出题、生成上下文等好几种。任务是「数据集 × 任务类别」的一个组合,例如「用 SQuAD 出题」。
四组数据各有来源:
- Muffin(80 种):以 FLAN 原本的任务为主,再加上这篇新增的对话与代码生成等任务。
- T0-SF(193 种):T0 的任务里和 Muffin 不重复的部分,SF 是「sans Flan」,也就是不含 Flan。
- NIV2(1,554 种):Natural Instructions v2,作者先删掉了 44 种和 MMLU 有关的任务,因为 MMLU 要拿来评测。
- CoT(9 种):九个有人工写好推理过程的数据集,例如算术推理的 GSM8K、多步推理的 StrategyQA,作者为每个数据集各写了约十个指令模板。
合起来是 473 个数据集、146 个类别、1,836 种任务。
每一题还会以不同格式出现,有没有示例、要不要写推理过程,各自组合。以论文的例子来说:
[没有示例、不写推理]
Answer the following yes/no question. Can you write a whole Haiku in a single tweet?
→ yes

[有示例、写推理]
Q: Answer the following yes/no question by reasoning step-by-step. Could a dandelion suffer from hepatitis?
A: Hepatitis only affects organisms with livers. Dandelions don't have a liver. The answer is no.
Q: Answer the following yes/no question by reasoning step-by-step. Can you write a whole Haiku in a single tweet?
A: A haiku is a japanese three-line poem. That is short enough to fit in 280 characters. The answer is yes.
只有那九个 CoT 数据集会用到「写推理」的格式。
微调本身很便宜
每个模型都用同一套流程,只调学习率、批量大小、dropout 和步数。优化器用 Adafactor,学习率固定不衰减;多条短样本会打包进同一条序列,并用掩码挡住样本之间的注意力。
和预训练比起来,指令微调花的算力少得可怜。Flan-PaLM 540B 的微调只用了预训练算力的 0.2%,大约是 512 块 TPU v4 跑 37 小时;Flan-T5 各个尺寸则在 0.2% 到 1.6% 之间。
怎么考
评测只用没出现在微调数据里的题目:
- MMLU:57 个科目的考试题,包括数学、历史、法律、医学,5-shot。
- BBH:BIG-Bench 里 23 个 PaLM 还赢不了普通人类评分员的困难任务,3-shot。
- TyDiQA:8 种语言的问答,1-shot。
- MGSM:把 GSM8K 的数学应用题人工翻译成 10 种语言,8-shot。
GPT-3 论文用的那一批评测,作者刻意不用,因为那些任务的训练集几乎都已经在微调数据里了。
MMLU 和 BBH 各考两次,一次直接回答,一次先写思维链再回答。六个分数再合成一个「归一化平均」。归一化的意思是以随机猜的分数为零点,再把剩下的范围拉回 0 到 100。例如二选一的题目,随机猜就有 50%,那么答对 55% 算 ,答对 45% 则是 −10%。
讨论
题目越多越好,但前 282 种最有用
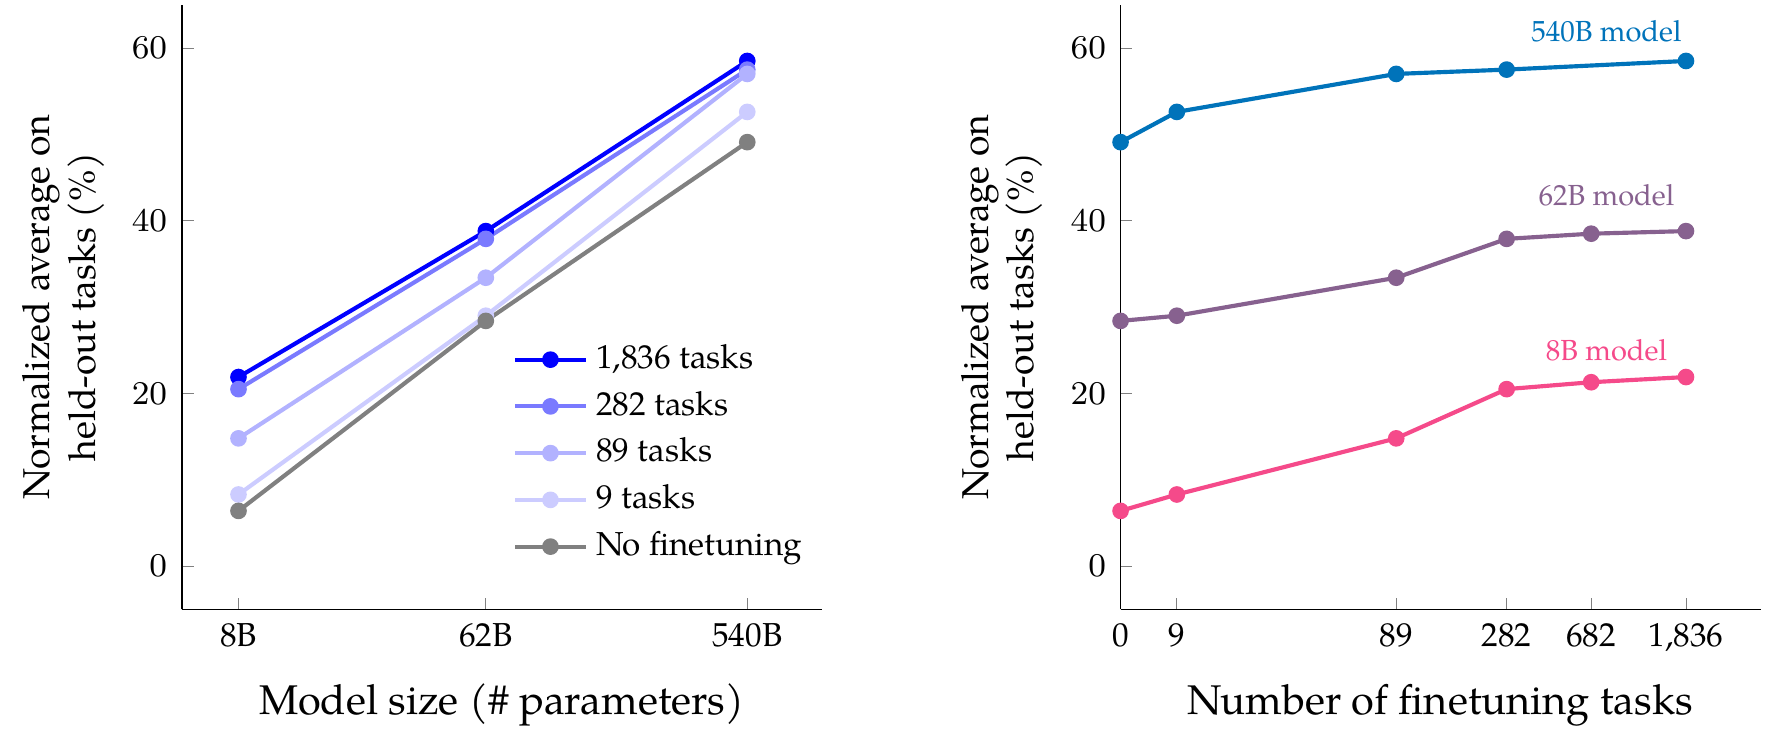
左图看模型大小。灰线是不微调,其他线是加了不同数量的任务;三种大小下,指令微调都把归一化平均拉高了 9.4 到 15.5 个百分点。模型每放大约十倍,不论有没有微调,分数都明显上升。
右图看任务数量。任务按 CoT、Muffin、T0-SF、NIV2 的顺序一组一组加上去,从 0 加到 282 种时,曲线爬得最快;之后再加到 1,836 种,只多了一点点。
作者提了两个解释。一个是后面加进来的任务不够多样,没教给模型新东西。另一个是指令微调的收获,主要来自让模型学会「把预训练时已经知道的东西说出来」,这种事学到一定程度就饱和了。第二个解释和数字对得上。PaLM 预训练读了 7,800 亿个 token,指令微调只用了 14 亿个,大约 0.2%。
到底是小模型还是大模型受益更多,作者也没有下定论。看绝对分数,8B 多了 15.5,540B 多了 9.4;看错误率减少的比例,540B 是 18.4%,8B 是 16.6%。同一组数字,换个算法,结论就反过来。
不练思维链,就会忘了怎么推
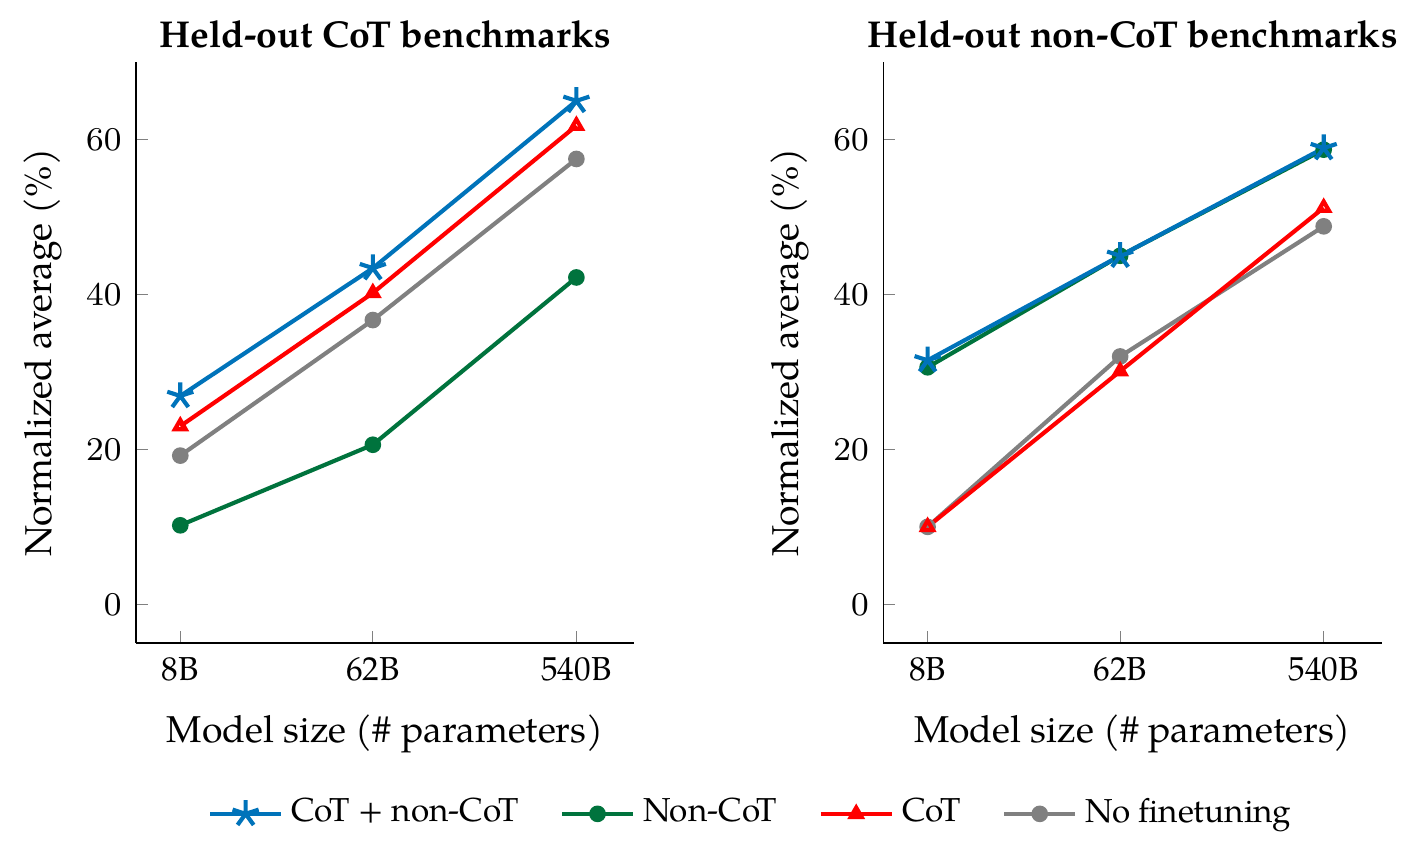
这张图是整篇最值得看的地方,看左图的绿线。只用直接给答案的数据微调,模型在需要思维链的评测上,反而比完全不微调还差;540B 从 57 左右掉到 42 左右。
这和之前的研究看起来矛盾,FLAN、T0 都说指令微调能帮助没见过的任务。作者的解释是,以前的评测只看「没见过的 NLP 任务」,例如拿掉情感分析的训练、再考情感分析;而且以前的模型太小,本来就做不好思维链。换句话说,指令微调帮得上忙的,是和微调时同一种提示格式的新任务。微调时只练直接回答,考思维链时就吃亏。
解法只要九个 CoT 数据集。蓝线把两种数据一起微调,在左图是四条线里最高的;右图里,蓝线和只用非 CoT 数据的绿线几乎重叠,加进思维链数据并没有拖累直接回答的题目。
这九个数据集还有一个附带效果。微调时 CoT 数据有一部分不给示例,所以 Flan-PaLM 学会了零样本的思维链,在题目后面加一句「Let's think step by step」,BBH 的分数就会上升;没微调的 PaLM 加了这句话却没有用。Kojima 等人先前的零样本思维链实验,成功的例子大多用的是 InstructGPT,作者推测,那是因为 InstructGPT 的微调数据里本来就有类似思维链的东西。
主要成绩
把三件事放在一起,得到的是 Flan-PaLM 540B。MMLU 用思维链加上自我一致性(多次采样再投票),达到 75.2%,比 PaLM 的 69.3%、code-davinci-002 的 68.3%、Chinchilla 的 67.6% 都高。多语言数学题 MGSM 拿到 72.0%,连孟加拉语都有 69.6%;GSM8K 是 83.9%,不过 GSM8K 的训练集就在微调数据里。
也有没赢的地方。BBH 里只考符号操作的算法类任务,例如按顺序追踪被打乱的物体、把单词按字母排序,Flan-PaLM 还是输给 code-davinci-002。TyDiQA 虽然比 PaLM 多了 14.9 个百分点,仍然比不上直接在 TyDiQA 训练集上微调的 ByT5。
换个模型也行
作者把同一套流程套到不同架构、不同大小、不同预训练目标的模型上。以下节选几行:
| 模型 | 归一化平均 | MMLU 直接 | MMLU CoT | BBH 直接 | BBH CoT |
|---|---|---|---|---|---|
| T5-XL(3B) | −4.1 | 25.7 | 14.5 | 27.4 | 19.2 |
| Flan-T5-XL(3B) | 19.1 | 52.4 | 45.5 | 41.0 | 35.2 |
| T5-XXL(11B) | −2.9 | 25.9 | 18.7 | 29.5 | 19.3 |
| Flan-T5-XXL(11B) | 23.7 | 55.1 | 48.6 | 45.3 | 41.4 |
| PaLM 62B | 28.4 | 55.1 | 49.0 | 37.4 | 43.0 |
| PaLM 540B | 49.1 | 71.3 | 62.9 | 49.1 | 63.7 |
| Flan-PaLM 540B | 58.4 | 73.5 | 70.9 | 57.9 | 66.3 |
整理自原论文 Table 5,节选部分行与列。
T5 受益最多。没微调的 T5(这里用的是额外以语言模型目标训练过的 LM-adapted 版本)在这些困难评测上几乎是乱猜,MMLU 的思维链只有 14.5%,比四选一的随机猜还低,所以归一化平均是负的。微调之后,3B 的 Flan-T5-XL 在 MMLU 上拿到 52.4%,比 GPT-3 175B 的 43.9% 还高;11B 的 Flan-T5-XXL 在 BBH 直接回答上,也胜过 PaLM 62B,表上是 45.3 对 37.4。
整篇最强的模型是 Flan-U-PaLM,也就是先用 UL2 目标继续预训练 PaLM 540B,再做指令微调。作者的结论是,这两种方法可以叠加,都不必把模型变大。
更好用
分数之外,作者也请人比较 PaLM 540B 和 Flan-PaLM 540B 的开放式回答。评测集有 190 题,涵盖创意、推理、规划、解释等类别,有零样本也有少样本。结果 Flan-PaLM 在 79% 的情况下更受偏好;题目加上「让我们一步一步想」时,偏好差距再拉大约 10%。
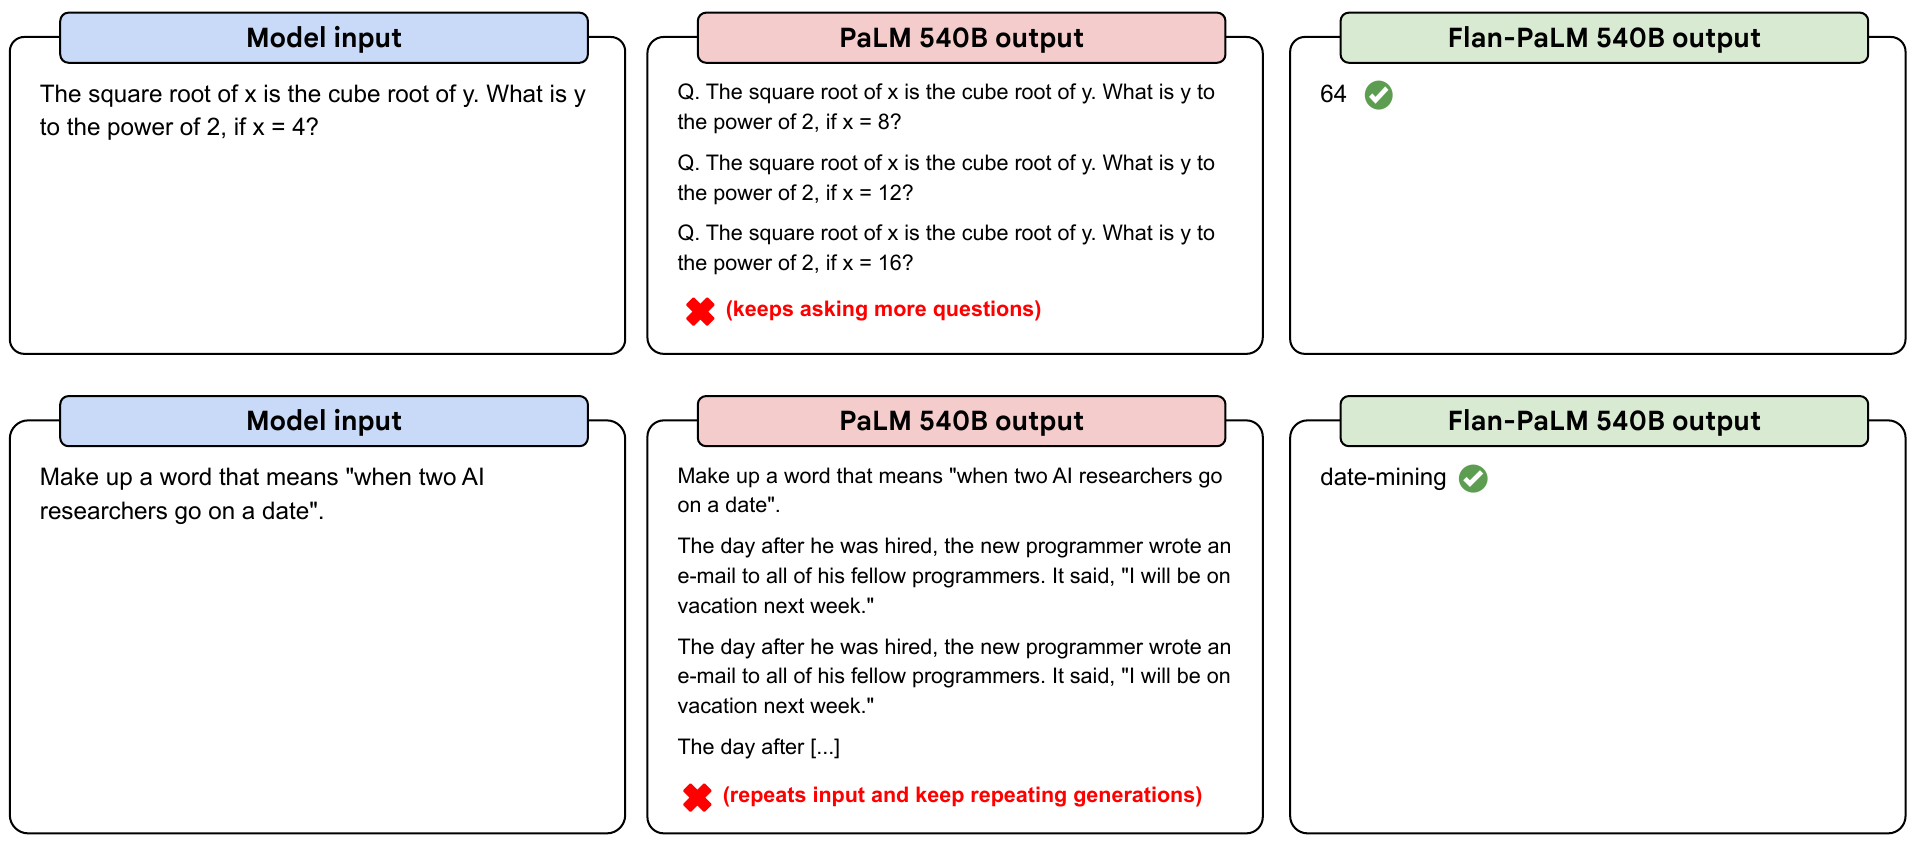
第一题 ,所以 、。PaLM 没有回答,而是把这题当成试卷的开头,一题接一题往下出。第二题它先把题目抄一遍,再把同一段和题目无关的故事重复写下去。
作者在 PaLM 的零样本输出里看到三种毛病,接着写相关的文字而不回答、把问题稍微改一下再重复一遍,以及不知道什么时候该停。他们推测这和预训练时没有使用序列结束符有关。指令微调让模型学会回答完就停,这一点对不做提示工程的普通用户特别重要。
后来的事
论文最后一句建议,几乎所有预训练语言模型都该做指令微调。后来的发展大致照这句话走,模型发布时同时放出基底版和指令微调版,几乎成了惯例。四个月后的 LLaMA 也照这篇的流程,对 65B 做了一次简单的指令微调,MMLU 从 63.4% 升到 68.9%。
Google 在 2023 年初把整套任务与模板整理成 The Flan Collection 公开。不过几个月后,风向也变了。LIMA 只用 1,000 条精挑细选的问答微调 LLaMA 65B,就能写出相当不错的回答;大家开始更在意指令数据的质量和来源,例如真实用户的提问,而不只是任务的数量。
结论
这篇把指令微调的三个方向一起推开。任务加到 1,836 种,收获主要集中在前 282 种;模型放大十倍,收获依然明显;思维链数据只要九个数据集,就能补回直接回答训练造成的推理退步。代价只有预训练算力的 0.2% 到 1.6%。
最实用的提醒是,微调数据长什么样,模型就擅长什么格式。只用直接回答的数据微调,540B 在需要思维链的评测上,归一化平均反而从不微调时的约 57 掉到约 42;加进九个思维链数据集,才不会吃这个亏。
对多数人来说,这篇留下来的是那几个 Flan-T5 权重。PaLM 一直没有公开,Flan-PaLM 的分数再漂亮,也只能在论文里看看。