原始论文
Large Batch Training of Convolutional Networks
- 发表版本
- 正式发表信息尚未核实
- arXiv 首次提交
- arXiv:1708.03888
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizerslars2017,
  title = {{Large Batch Training of Convolutional Networks}},
  author = {Yang You and Igor Gitman and Boris Ginsburg},
  year = {2017},
  eprint = {1708.03888},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1708.03888}
}
2017 年 6 月,Facebook 的 Goyal 等人用 256 张 GPU、batch size 8,192,一小时训练完 ImageNet 上的 ResNet-50,准确率没有掉。他们的配方是两条规则,batch 放大几倍,学习率就放大几倍;开头几个 epoch 先用小学习率预热。
两个月后,两位 NVIDIA 实习生和 NVIDIA 的 Boris Ginsburg 把同一套配方搬到 AlexNet 上,结果 batch 一过 2K 就训练不下去。这份只有 8 页的技术报告,就从这次失败开始。
定义问题
数据并行训练的做法是把一个 batch 切给很多张卡,各自算梯度再平均。卡越多,每张卡又得喂饱,global batch 就越大。epoch 数不变的话,batch 放大 倍,更新步数就少 倍;为了补回来,最直接的办法是把学习率也放大 倍。论文用 说明这个直觉,小 batch 连走两步,大致等于大 batch 用两倍学习率走一步,前提是第二步的梯度和第一步差不多。
这个前提在训练初期最不可靠,Goyal 等人才加了预热。作者用 BVLC 版的 AlexNet 照做,训练 100 个 epoch:
| batch | 学习率 | top-1(%) |
|---|---|---|
| 512 | 0.02 | 58.8 |
| 4,096 | 0.05 | 53.1 |
| 8,192 | 0.03 | 44.8 |
整理自原论文 Table 1(a),每个 batch 取准确率最高的学习率,预热 2.5 个 epoch。
学习率根本放不上去。batch 4K 时学习率超过 0.06,有预热也照样发散,只能停在 0.05;8K 则停在 0.03,而照线性缩放,它应该是 batch 512 的 16 倍,0.32。
别人也撞过这堵墙。Hoffer 等人改用比较保守的平方根缩放,再配上特制的 Ghost BatchNorm,AlexNet 在 batch 8K 也只有 53.93%,离小 batch 的水平还很远。Krizhevsky 自己提出线性缩放时,AlexNet 也只推到 1K,掉了约 1 个百分点。
作者先把 AlexNet 的 LRN 层换成 BatchNorm,称为 AlexNet-BN。这一改,连预热都不用,batch 8K 能用 0.3 的学习率,准确率 58.0%,和 batch 512 的 60.2% 只差 2.2 个百分点(原本差 14 个)。剩下的 2.2 是不是 Keskar 等人说的泛化差距?作者比较了 batch 256 和 8K 的训练与测试损失,两者之间的差距没有明显不同,所以判断问题出在训练本身没做好,模型还没学够。
那么学习率为什么放不大?
每一层的胃口
作者在 AlexNet-BN 跑完第 1 次迭代时,把每一层权重的范数 和梯度的范数 拿出来比:
| 层 | 比值 | ||
|---|---|---|---|
| conv1 | 0.098 | 0.017 | 5.76 |
| conv2 | 0.16 | 0.002 | 83.5 |
| conv3 | 0.196 | 0.0015 | 127 |
| conv4 | 0.196 | 0.0013 | 148 |
| conv5 | 0.16 | 0.0002 | 69 |
| fc6 | 6.4 | 0.005 | 1345 |
| fc7 | 6.4 | 0.013 | 489 |
| fc8 | 0.316 | 0.016 | 19 |
整理自原论文 Table 2,只列权重;偏置项的比值落在 8.48 到 117 之间。
这个比值可以直接读成一个学习率,也就是让一步更新的大小刚好等于权重本身的那个值。学习率设成 1,conv1 一步就改掉自己约 17% 的权重(),fc6 只动了 0.07%()。
全网络共用一个学习率,就得迁就最容易被改坏的那一层。conv1 的上限比 fc6 低两百多倍,学习率稍微放大,conv1 先崩;为了保住 conv1 而压低学习率,fc6 这种层又几乎不动。论文也观察到这个比值在训练初期最高、几个 epoch 后快速下降,预热之所以有效,是因为小学习率对所有层都安全,等权重长大一点,再把学习率拉上去。
作者换了个方向。既然每层的胃口不同,就每层各给一个学习率。
解决问题
一层一把尺
LARS(Layer-wise Adaptive Rate Scaling)把第 层的更新写成全局学习率 乘上该层自己的 local LR :
叫 trust coefficient,意思是「这一层一步之内,我们愿意让它改动多少」。论文的 AlexNet 实验都用 ,ResNet-50 没有另外交代。
把两式合起来算一下更新的大小:
梯度的大小被消掉了。每一层每一步的更新,都是自己权重范数的 倍;梯度只决定方向。以 AlexNet-BN 在 batch 8K 用的 来说,学习率还没衰减时,每一步塞进更新的量都是该层权重范数的 1.4%(还没算动量的累积),conv1 和 fc6 一视同仁。作者也指出,更新大小不再跟着梯度大小走,梯度消失或爆炸的问题可以缓解一部分。
和 Adam、RMSProp 这类自适应方法相比,LARS 有两点不同。一是粒度,它一层一个学习率,不是每个参数一个,论文认为这样比较稳。二是参考点,它拿权重本身的大小来控制更新幅度,Adam 拿的是梯度的历史统计。
加上权重衰减与动量
有权重衰减 时,分母也把它算进去:
完整的训练流程(原论文 Algorithm 1, 按式 (6) 补上 )每步对每一层做:
全局学习率按二次多项式衰减,动量 。要注意顺序,trust ratio 用的是这一步梯度的范数,缩放完才累积进动量。后来 LAMB 论文重新整理 LARS 时,改成对动量取范数,两者不完全一样。
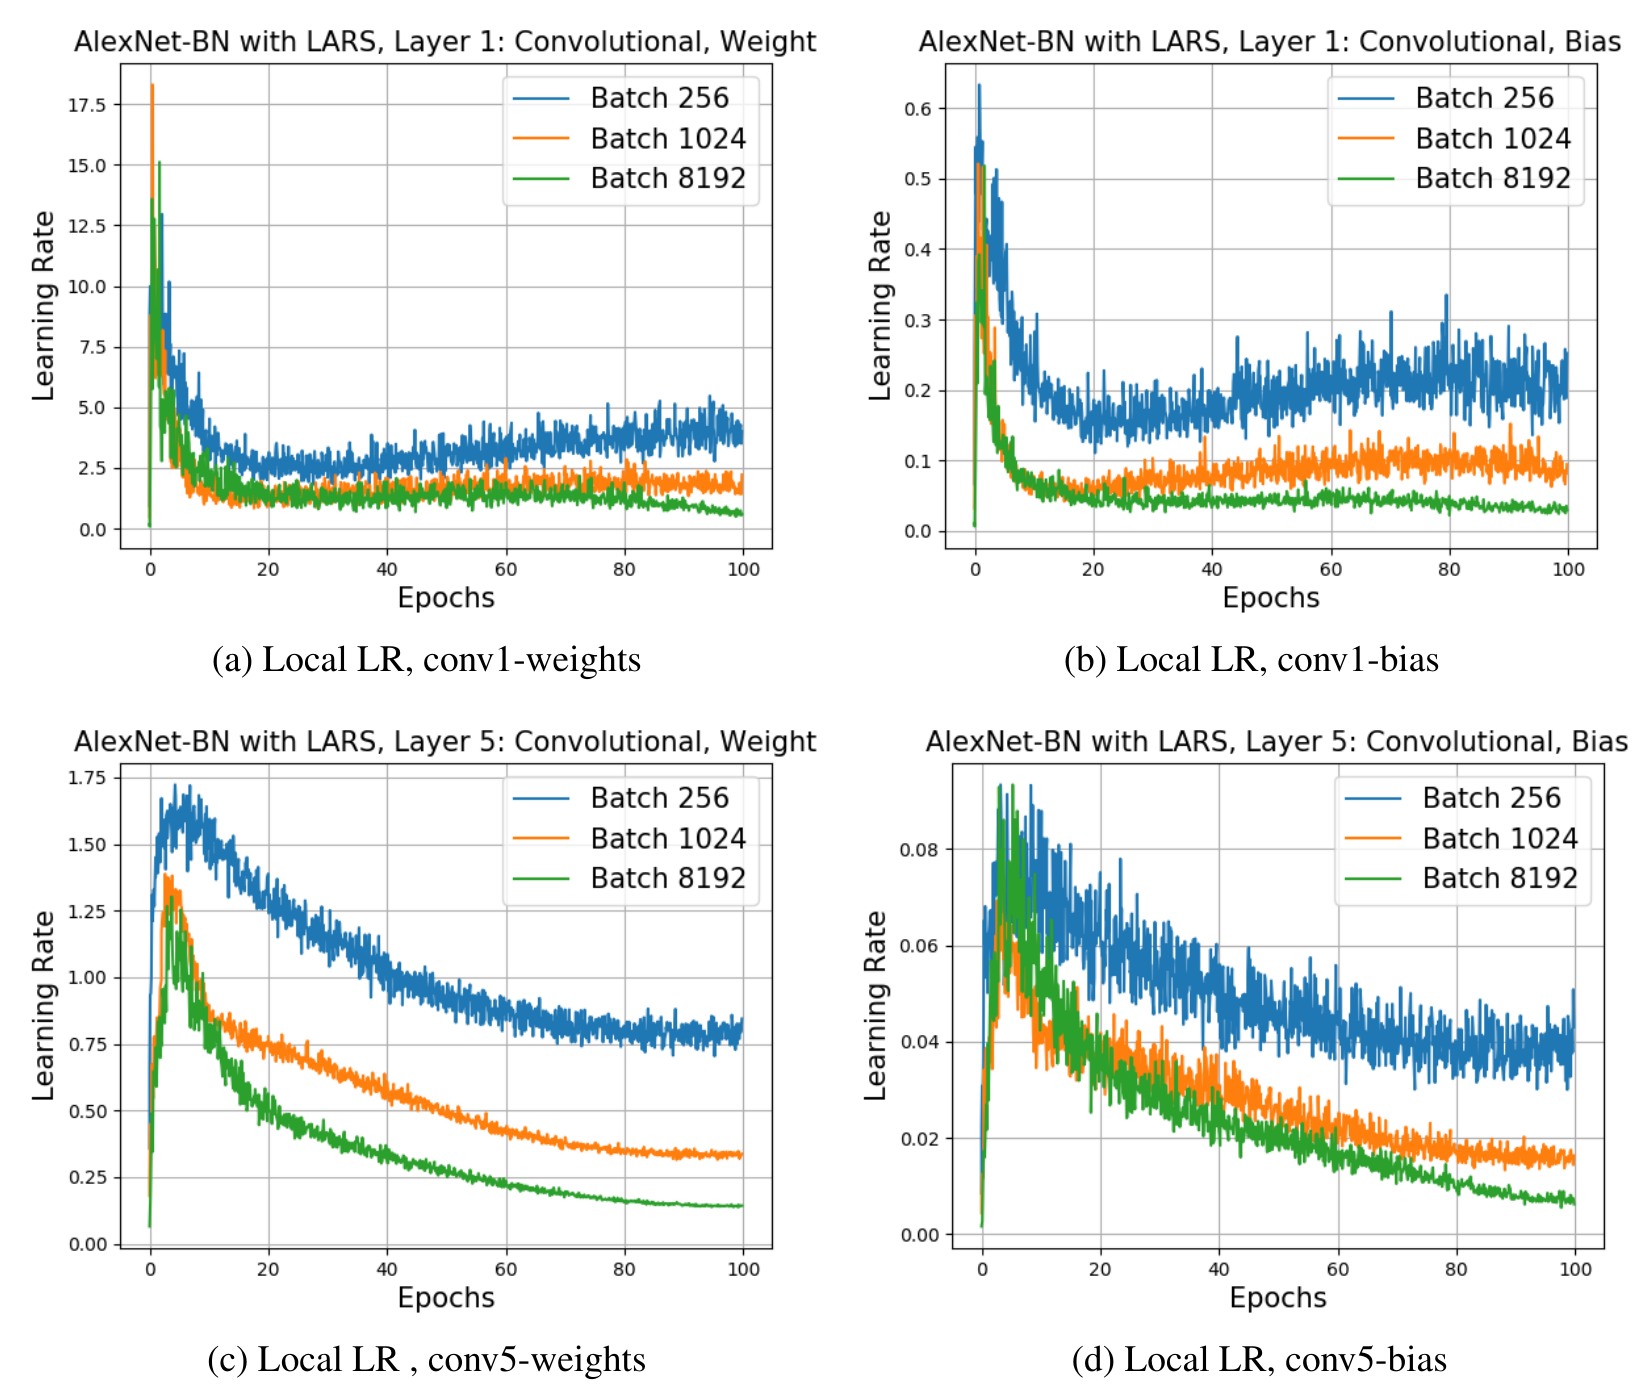
这张图画的是 LARS 自动算出来的 local LR。先看纵轴刻度,conv1 权重最高到 17.5,conv5 权重不到 1.75,两个偏置项更小,最多 0.6 和 0.08。同一个网络里,各层实际用的学习率差了一到两个数量级。再看三条线,训练后期 batch 越大,曲线压得越低。论文对此只说 local LR「强烈依赖层与 batch size」,没有进一步解释。这种随层、随 batch、随训练进度变化的学习率,很难用手写的调度做出来。
讨论
AlexNet 推到 32K
作者用 LARS 重训两个网络,都跑 100 个 epoch,SGD 动量 0.9、权重衰减 0.0005、,在 NVIDIA DGX-1 上完成。batch 16K 和 32K 放不下,是把一个 batch 切成几块、累积梯度后才更新来模拟的。
| batch | AlexNet 学习率 | AlexNet(%) | AlexNet-BN 学习率 | AlexNet-BN(%) |
|---|---|---|---|---|
| 512 | 2 | 58.7 | 2 | 60.2 |
| 4K | 10 | 58.5 | 10 | 60.4 |
| 8K | 10 | 58.2 | 14 | 60.1 |
| 16K | 14 | 55.0 | 23 | 59.3 |
| 32K | TBD | TBD | 22 | 57.8 |
整理自原论文 Table 3,AlexNet 预热 2 个 epoch,AlexNet-BN 预热 5 个 epoch;表中 TBD 为原文所写。
batch 8K 的 AlexNet,从没有 LARS 时的 44.8% 拉回 58.2%,和 batch 512 只差 0.5 个百分点。AlexNet-BN 撑得更远,16K 掉 0.9,32K 掉 2.4。
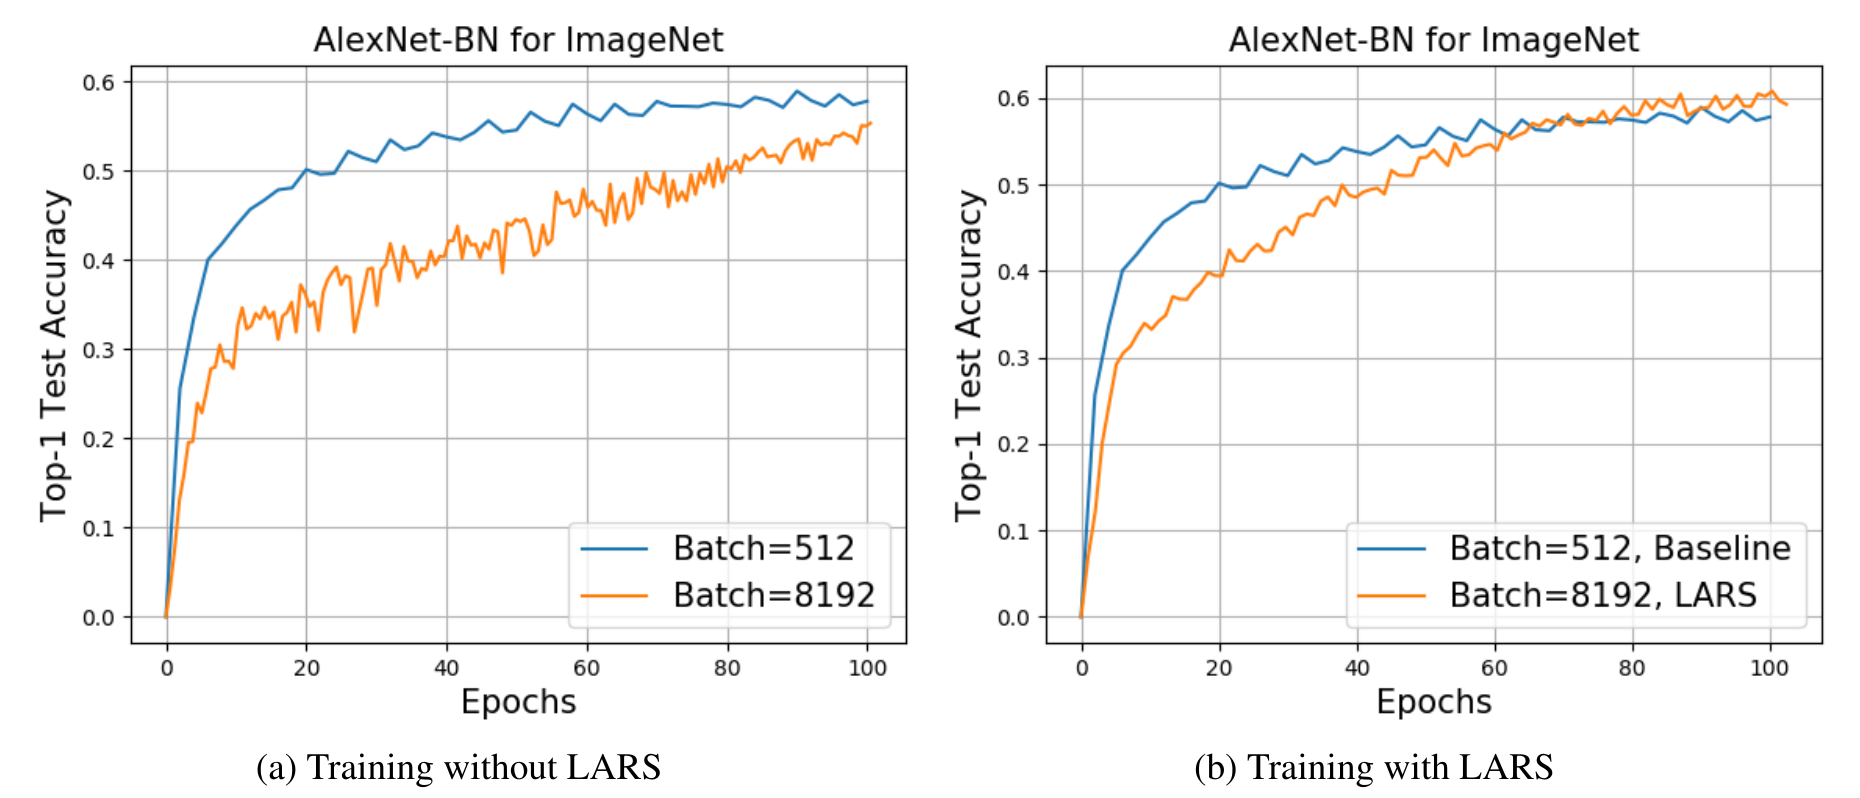
这张图是 AlexNet-BN 在 batch 8K 的训练过程。左边没有 LARS,橙线从头落后到尾;右边有 LARS,前 60 个 epoch 仍然落后,之后追上并稍微超过。大 batch 起步还是比较慢,LARS 让它在相同的 epoch 数内追回来。
另外两个观察和调参有关。一是可用的学习率区间很宽,AlexNet-BN 在 16K 时,基础学习率从 13 到 22 都有约 59.3%,32K 时从 17 到 28 都有约 57.5%。二是 32K 剩下的落差可以靠多训练补回来,100、125、150、200 个 epoch 分别是 57.8%、59.2%、59.5%、59.9%。作者的解释是 batch 大到某个程度后,随机梯度已经很接近真实梯度,再加大 batch 也拿不到更多信息。要注意,200 个 epoch 的 59.9% 仍低于 60.2%,而且训练两倍的 epoch,本来就不是大 batch 想要的结果。
ResNet-50
ResNet-50 跑 90 个 epoch,动量 0.9、权重衰减 0.0001,LARS 配 5 个 epoch 的预热和二次多项式衰减:
| batch | 全局学习率 | top-1(%) |
|---|---|---|
| 256(无 LARS) | 0.2 | 73.0 |
| 8K | 0.6 | 72.7 |
| 16K | 2.5 | 73.0 |
| 32K | 2.9 | 72.3 |
整理自原论文 Table 4。
32K 只比基线低 0.7 个百分点。不过这里的基线只有 73%,因为作者只做了最简单的数据增强(缩放到 256×256 后随机裁剪 224×224、水平翻转),测试也只用单一中心裁剪;Goyal 等人的基线是 76.4%。而且论文没有交代 ResNet-50 的大 batch 用了什么硬件,AlexNet 的 16K、32K 则明说是梯度累积模拟出来的,整篇没有真正扩展到上千张卡的墙钟时间。
LARS 也不是每个任务都管用。一年半后,同一位第一作者在 Google 用 LARS 预训练 BERT,batch 16K 时 SQuAD 的 F1 掉到 89.6,32K 直接发散。这个失败把他带到下一个优化器。
被重新检验
LARS 后来成了大 batch 的标准配置。MLPerf Training 的 ResNet-50 项目,closed division 只允许用 SGD 动量或 LARS 两种优化器,两届冠军都用 LARS,batch 分别是 32,768 和 65,536。自监督学习也大量采用,SimCLR 写明「为了稳定训练,所有 batch size 都用 LARS」,BYOL 也是。
2021 年,Google 的 Nado 等人在〈A Large Batch Optimizer Reality Check〉中回头追问,LARS 真的比一般的优化器擅长大 batch 吗?他们指出,LARS 论文的 ResNet-50 准确率偏低,也没有在同一个 batch 下和其他优化器比过。他们把 MLPerf 上最快的 LARS 训练流水线拿来,只换优化器和超参数,改用 Nesterov 动量,在 batch 32,768、2,512 步(64 个 epoch)的条件下各跑 50 次。LARS 的中位数是 75.97%,50 次中有 35 次达到 75.9% 的门槛;Nesterov 的两组设置分别是 75.97%(34 次)与 75.92%(29 次)。
追平的过程并不轻松。他们发现 MLPerf 版的「LARS」其实只对一般权重用 LARS,BatchNorm 的参数和偏置项交给普通的 heavy-ball 动量,也不加 L2 正则化;这个细节不在 LARS 论文里,却对两种优化器都「极为重要」。Nesterov 这边还得重调标签平滑、BatchNorm 初始化与预热曲线的形状才追得上。训练准确率也值得一看。Nesterov 78.97%、LARS 78.07%,测试准确率却差不多。Nado 等人因此认为,LARS 的逐层归一化或许更像一种正则化。把预算放宽到 6,000 步、改用最简单的 cosine 调度后,Nesterov 是 76.7%,LARS 是 76.9%,好几种设置都轻松越过 75.9%。他们的结论是,大 batch 本身没有那么不稳,难的是在极紧的步数预算里把所有超参数调到位。
NFNet 的作者也走过这条路。NFNet 的自适应梯度裁剪(AGC)同样看梯度范数和权重范数的比值,论文把它称为 LARS 这类归一化优化器的放宽版,只限制更新的上限,不完全忽略梯度大小。他们试过直接用 LARS,大 batch 一样训练得稳,只是准确率变差。
结论
LARS 的贡献是一张表和一行式子。表上显示 AlexNet-BN 各层的 差了两百多倍,式子让每层的更新固定为自身权重的一个比例。靠这个,AlexNet 在 batch 8K 从 44.8% 回到 58.2%,ResNet-50 在 32K 下只掉 0.7 个百分点。它没有证明一般的优化器做不到,三年多后 Nado 等人就用 Nesterov 在同样的步数下追平了。
自己实现 LARS 时,BatchNorm 的参数和偏置项要排除在 trust ratio 与权重衰减之外,MLPerf 和后来的自监督实现都这么做。拿它和别的优化器比,也请在同样的步数下认真调一组动量 SGD。
Table 3 里 AlexNet 的 32K 那两格 TBD,一直留到 v3 定稿,再也没有填上。