原論文
Sophia: A Scalable Stochastic Second-order Optimizer for Language Model Pre-training
- 発表先
- ICLR 2024国際会議
- arXiv への初回投稿
- arXiv:2305.14342
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizerssophia2023,
  title = {{Sophia: A Scalable Stochastic Second-order Optimizer for Language Model Pre-training}},
  author = {Hong Liu and Zhiyuan Li and David Hall and Percy Liang and Tengyu Ma},
  year = {2023},
  eprint = {2305.14342},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.14342}
}
あるオプティマイザが「Adam の 2 倍速い」と言うとき、いったいどう測ればよいのか?
Stanford の Hong Liu、Zhiyuan Li、David Hall、Percy Liang、Tengyu Ma は、この論文で小さな節を一つ割いてこの問いに答えている。ベースラインは、あらかじめ決めた総ステップ数 で学習率とスケジュールを最良に調整しておく。新手法は ステップだけ走らせ、最終損失がベースライン以下でなければならず、「だいたい同じ」では認められない。さらに彼らは、cosine スケジュールは総ステップ数に合わせて伸び縮みするので、 ステップの学習の途中のチェックポイントで比べると結論が偏る、と特に注意している。
この基準のもとで、彼らは Sophia が GPT-2 で半分のステップ数で AdamW の検証損失に達し、1 ステップあたりの時間とメモリはほとんど変わらないと主張している。
このノートでは、まず Sophia が何をするのかを見て、それからこの「2 倍」が、後にほかの研究者が測り直すとどれくらいになったかを見る。
問題の定義
Adam は勾配の大きさしか見ない
Adam の分母は、勾配の 2 乗の移動平均の平方根だ。勾配の方向が安定していると、 はおよそ になり、どの座標も歩幅は に近い。その方向の地形が急か平らかとは関係がない。
しかし言語モデルの損失地形は、方向によって曲率が大きく違う。著者らが 1.25 億パラメータの GPT-2 の対角ヘッセ行列を測ると、正の要素の大きさはとても広く散らばっていた。
2 次元の例
著者らは 2 次元の分離可能な関数で説明している。 で、 はとても急で、 はとても平らだ。
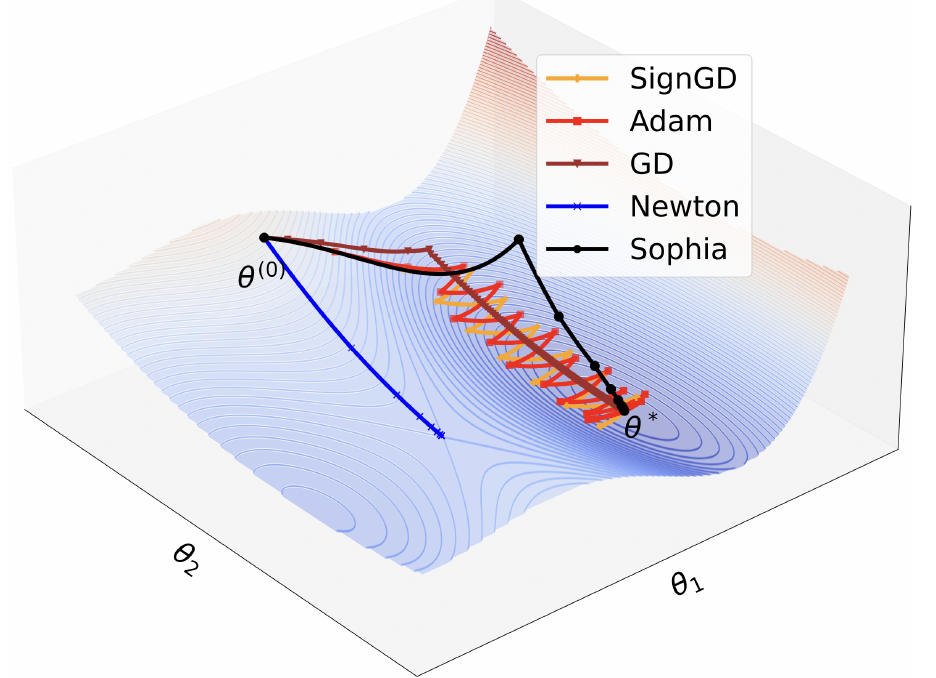
図のどの線も左上の から出発し、目標は右下の だ。
GD の学習率は最も急な方向に縛られ、最大でも急な方向の曲率の逆数くらいまでしか取れず、それを超えると発散する。この学習率は平らな方向には小さすぎるので、濃い赤の線は に沿ってとてもゆっくり進む。
Adam を簡略化したものが SignGD で、二つの方向とも毎ステップ ずつ進む。平らな方向では、同じ歩幅でも損失はほんの少ししか下がらない。急な方向では 3 ステップで谷底に着き、そこから行ったり来たり跳ね始める。止めたければ を 0 まで減衰させるしかなく、そうすると平らな方向はさらに遅くなる。図の赤い Adam と橙の SignGD はほとんど重なっていて、どちらも谷の中をジグザグに進んでいる。
凸最適化の教科書どおりなら、理想的な前処理はヘッセ行列だ。この分離可能な例では、Newton 法は各方向の勾配をその方向の曲率で割るだけで、急な方向では歩幅が自動的に小さくなり、平らな方向では自動的に大きくなる。問題は に曲率が負の区間があることで、Newton 法はそこで極大値や鞍点へ向かってしまう。青い線は鞍点に収束している。実際のモデルでは、曲率は学習の軌跡に沿って速く変わるので、二次の情報が信頼できるとは限らない。
二次の手法は高すぎる
既存の二次の手法にはコストの問題もある。K-FAC のようなブロック対角近似は大規模言語モデルには高すぎる。AdaHessian も対角ヘッセ行列を前処理に使うが、ほぼ毎ステップ推定するので、1 ステップのコストは勾配計算 2 回分を超える。著者らは、これらが頻繁に推定しなければならないのは、誤った推定を食い止める保護の仕組みがないからだと推測している。
だから、この論文が求める前処理は三つのことを同時に満たさなければならない。Newton のように曲率に応じてスケーリングすること、負の曲率や推定ミスがあっても破綻しないこと、そして平均すると 1 ステップあたりの計算がわずかしか増えないことだ。
問題の解決
更新式
Sophia の正式名は Second-order Clipped Stochastic Optimization だ。Algorithm 3 は次のように書かれている。
分子は勾配の移動平均で、Adam と同じだ。分母は対角ヘッセ行列の推定 に置き換わり、 ステップに 1 回だけ推定し、移動平均でノイズも除く。 は decoupled weight decay だ。すべての演算は座標ごとに行い、 は各要素を に切り詰める。
括弧の中の は、割り引いた Newton ステップだ。著者らは式を次のように書き換えている。
右辺のほうが読みやすい。まず Newton ステップ を計算し、各座標を で切り詰め、それに を掛ける。つまり が決めるのは「どれだけの割合の座標が切り詰められるか」だけで、切り詰められた座標の最終的な歩幅はどれも になる。
クリッピングを一通りたどる
Sophia-H のデフォルトの を使い、いくつかの座標でモーメンタムがどれも で、曲率の推定 だけが違うとする。
| 曲率 | 実際の歩幅 | |
|---|---|---|
| 20 | 0.01 | |
| 1 | 0.2 | |
| 0.2 | 1 | |
| 0.02 | 10 | (切り詰め) |
| −3 | (切り詰め) |
本稿で整理。原論文 Eq. (6) に従って計算。
曲率の大きい座標では、歩幅は自動的に Newton 式の小さな歩みに縮む。曲率の小さい座標は、本来ならとても大きな Newton ステップになるところを、 で切り詰められる。最後の行は Hutchinson 推定量でよく出る負の値で、 は を取るので比が爆発的に大きくなり、 に切り詰められる。つまりモーメンタム付きの SignSGD だ。曲率を小さく推定しすぎた場合も同じだ。
著者らはこの振る舞いを「モーメンタム付き SignSGD を予備に置く」と表現している。ヘッセ行列の推定がどれだけ外れていても、各座標が 1 ステップで動けるのは最大で だ。この手法が「ヘッセ行列の推定は 10 ステップに 1 回」と思い切れるのは、この上限があるからだ。
では はどう選ぶのか? 著者らの勧めは、小さなモデルで調整し、「切り詰められない」座標の割合を 10%〜50% に収めることだ。多すぎたり少なすぎたりしたら を 0.5 倍か 2 倍にしてやり直す。同じアーキテクチャ、同じデータでサイズの違うモデルなら共用できる。実際の学習では、切り詰められる座標の割合は 60% 前後まで上がっていく。つまり大部分の座標は、実は sign ステップで進んでいる。論文は最終的に (Sophia-H)と (Sophia-G)を使っている。
二種類の対角ヘッセ行列推定
Hutchinson 推定量(Sophia-H)。標準正規ベクトル を一つ引き、次を計算する。
その期待値はちょうどヘッセ行列の対角になる。必要なのは Hessian-vector product 一つ、つまり に対してもう一度逆伝播を行うことだけで、ヘッセ行列を組み立てる必要はない。この推定は不偏だが、1 回の推定では負になりうる。
Gauss-Newton-Bartlett 推定量(Sophia-G)。交差エントロピー損失のヘッセ行列は、Gauss-Newton 項 と、通常は小さめの残りの項に分けられ、著者らは前者だけを推定する。ここで はパラメータに対する logits のヤコビ行列、 は logits に対する損失の 2 階微分だ。交差エントロピーでは はモデルが出力する確率 だけに依存し、真のラベルとは関係がない。さらに統計学の Bartlett 恒等式を使うと、 は「モデル自身の分布からラベルを一つ引いて、勾配の外積を計算する」ことの期待値として書ける。
実装は 4 ステップで済む。
- 入力を 1 バッチ取って logits を計算する。
- モデル自身の softmax からラベル を引く。
- この偽のラベルで mini-batch 損失の勾配 を計算する。
- を返す。 はバッチサイズだ。
を掛けるのは、自動微分が平均勾配しか返さないからだ。Bartlett の第一恒等式によれば、サンプリングしたラベルのもとでの 1 件ごとの勾配の期待値は 0 なので、平均勾配の 2 乗に を掛けると、その期待値はちょうど 1 件ごとの勾配の 2 乗の平均に等しくなる。
この推定は常に非負なので、前処理後の方向は必ず降下方向になる。勾配の 2 乗という点で Adam の二次モーメントによく似ているが、違いは 2 か所ある。Adam は真のラベルの勾配を使い、Sophia-G はモデルからサンプリングしたラベルを使う。Adam は分母の平方根を取り、Sophia はそのまま割る。前者は文献では empirical Fisher と呼ばれ、著者らのアブレーションでは GNB に及ばない。
公式コードは Sophia-G だけを実装している。著者らは GitHub でも、Sophia-G の推定は負にならず、負の曲率に対する保護は Sophia-H のために用意したものだと答えている。
10 ステップに 1 回の推定
で、しかもヘッセ行列の推定には一部のサンプルしか使わない。GPT-2 のバッチは 480 件で、Sophia-H はそのうち 32 件だけ、Sophia-G は 240 件を使う。A100 で測った 1 ステップあたりの時間は次のとおりだ。
| 手法 | 355M | 770M |
|---|---|---|
| AdamW | 1.77 s | 3.25 s |
| Sophia-H | 1.88 s | 3.40 s |
| Sophia-G | 1.86 s | 3.42 s |
原論文 Table 1 をもとに整理。1 ステップあたりの時間には、10 ステップに 1 回のヘッセ行列推定を均して含めている。
メモリについては、Sophia が保存する状態は と の二つだけで、AdamW と同じだ。
理論保証はどの設定のものか
第 4 節は、簡略化した版の収束速度を証明している。関数は狭義凸でなければならず、ヘッセ行列はある半径の中で変化が限られ、更新は決定的だ。しかも分析で使っているのは完全なヘッセ行列で、まずその固有基底に回転し、そこで座標ごとに切り詰めてから元に戻す。これらの条件のもとで、誤差 に達するのに必要なステップ数は条件数(最大曲率を最小曲率で割ったもの)に依存しない。SignGD は単純な 2 次関数でさえ、速度が条件数の影響を受ける。
理論ではなぜ対角ヘッセ行列を使わないのか? 著者らの説明では、一般の関数では曲率の方向が座標軸とそろっているとは限らず、対角前処理が効くとは限らない。この一文は、Sophia の実装版の弱点をちょうど言い当てている。実際のモデルの斜めの谷は、対角ヘッセ行列でもやはりまっすぐに直せず、Shampoo や SOAP のような行列の前処理が必要になる。
議論
実験設定
GPT-2 は 1.25 億、3.55 億、7.7 億の三つのサイズで、nanoGPT のコードを使って OpenWebText(学習セットは約 90 億 token)で学習させる。コンテキストは 1024、バッチは 480。ほかに 3,000 万パラメータのモデルを調整用に使う。さらに大きいのは GPT NeoX アーキテクチャの 15 億と 66 億で、Pile で Levanter を使って学習させ、コンテキストは 2048。
ベースラインは AdamW(、weight decay 0.1)、Lion、AdaHessian だ。ピーク学習率以外のハイパーパラメータは、すべて 3,000 万パラメータのモデルでグリッドサーチしてから固定した。1.25 億と 3.55 億のピーク学習率は別途グリッドサーチし、より大きなモデルでは上へ探して「あと 1.25 倍大きくすると発散する」学習率を見つけた。共通の設定は、ピークの 0.05 倍までの cosine 減衰、2,000 ステップのウォームアップ、勾配ノルムのクリッピング 1.0、bf16。Sophia は 、、weight decay 0.2 を使う。
一つ非対称な細部がある。AdamW と Lion は 3.55 億以上のモデルで不安定だったので、著者らはそれらによく使われる工夫を一つ加え、注意スコアを層のインデックスで割った。Sophia にはこの工夫を使っていない。
2 倍はどこから来るのか
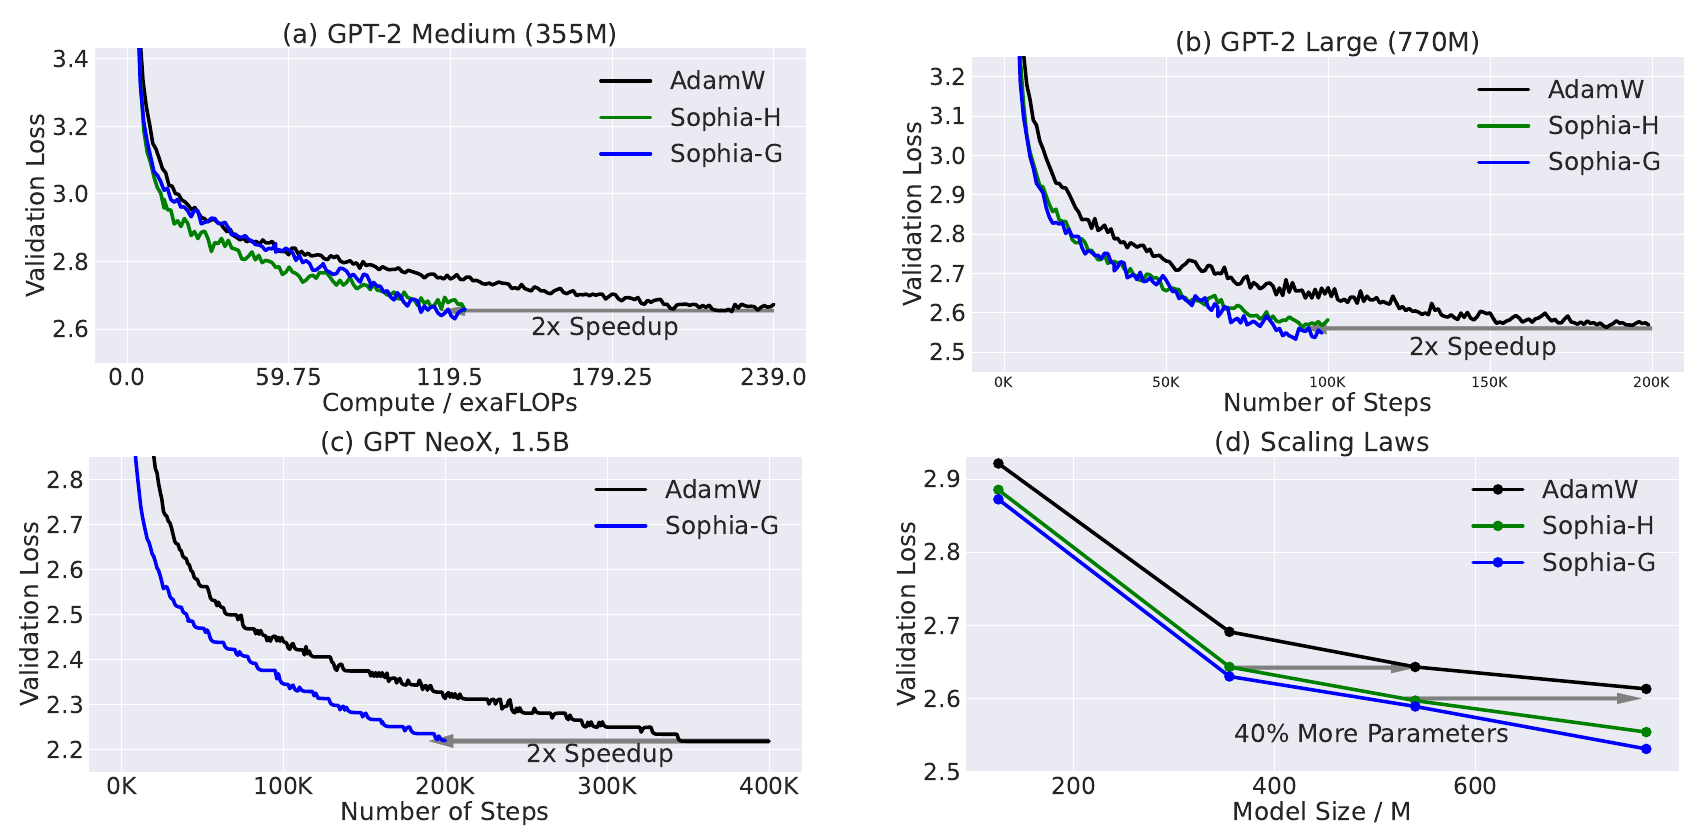
最初の 3 枚の読み方は同じだ。黒い線は AdamW が予算いっぱいまで走ったもので、青と緑の線は Sophia が半分だけ走ったもの。灰色の矢印は Sophia の終点から AdamW の終点へ水平に引かれていて、「2x Speedup」と記されている。(d) はモデルサイズを見る図に替わる。同じく 10 万ステップ学習すると、Sophia の 5.4 億モデルは AdamW の 7.7 億モデルより損失が低い。言い換えると、AdamW は約 40% 多くパラメータを使ってようやく追いつく。
同じステップ数での最終損失は次のとおりだ。
| モデル | AdamW | Sophia-H | Sophia-G |
|---|---|---|---|
| GPT-2 125M | 2.921 | 2.901 | 2.875 |
| GPT-2 355M | 2.691 | 2.645 | 2.627 |
| GPT-2 770M | 2.613 | 2.554 | 2.524 |
| NeoX 1.5B | 2.250 | – | 2.218 |
| NeoX 6.6B | 1.992 | – | 1.969 |
原論文 Figure 5 のキャプションをもとに整理。GPT-2 は 10 万ステップ、NeoX 1.5B は 20 万ステップ。
論文によれば、この範囲では検証損失が 0.05 低いことは、ステップ数をおよそ半分節約することに相当する。770M の差は 0.06〜0.09 で、これと合う。125M は 0.02〜0.05 しか差がない。66 億パラメータは同じステップ数での比較しかなく、「半分のステップ数」の対照は行っていない。下流タスクは SuperGLUE の四つのサブタスク(2-shot)しか試しておらず、Sophia の 20 万ステップと AdamW の 40 万ステップの正解率は同程度だった。
安定性とハイパーパラメータ
1.25 億パラメータの GPT-2 では、三つとも勾配ノルムのクリッピング 1.0 を使っている。AdamW と Lion では 10% を超えるステップでクリッピングが発動したが、Sophia-H ではめったに発動しなかった。注意スケーリングの工夫を外すと、AdamW は 3.55 億モデルで最大 1.5e-4 の学習率しか使えず、3e-4 では発散した。Lion の上限も 6e-5 から 3e-5 に下がった。Sophia-H はもともとこの工夫を必要としない。3,000 万パラメータのモデルで と の 9 通りの組み合わせを走査すると、損失はどれも 3.341〜3.356 の間に収まった。
アブレーション
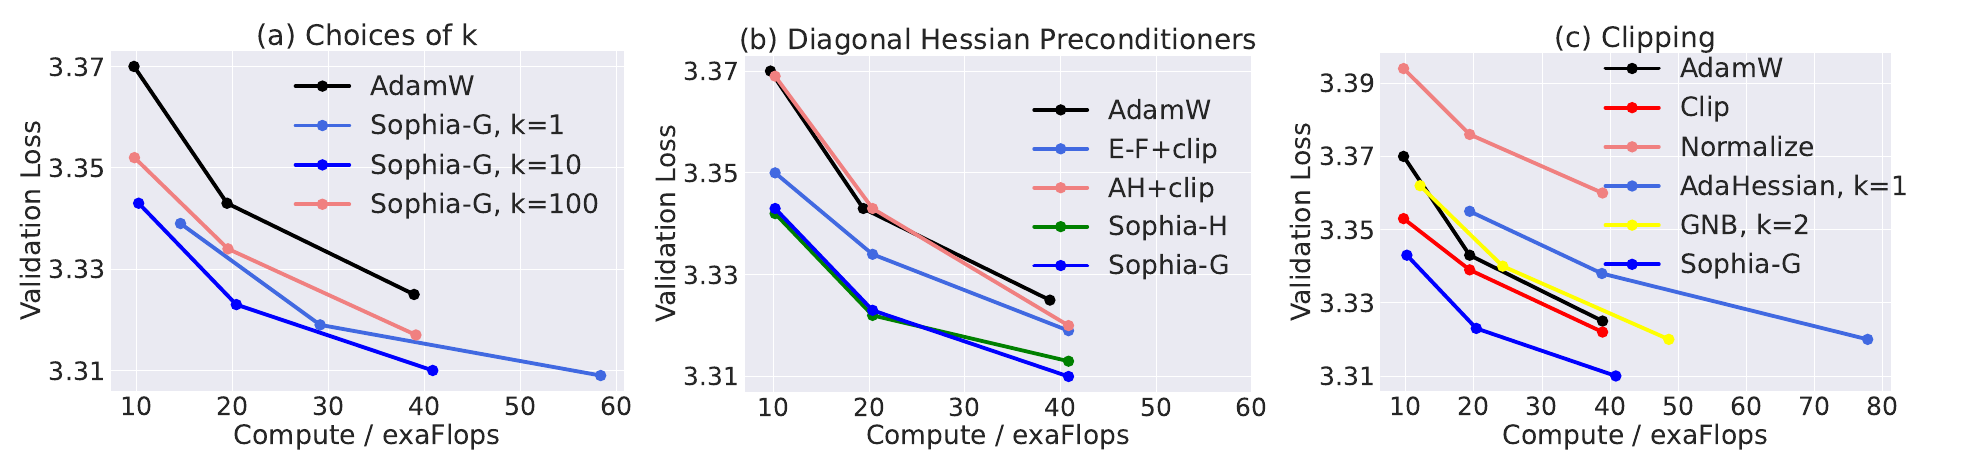
3 枚とも左下に行くほど良く、同じ計算量で損失が低い。
(a) 毎ステップヘッセ行列を推定する()と、同じステップ数での損失は最も低いが、オーバーヘッドが 50% 増え、計算量で比べるとかえって に負ける。 でも AdamW には勝つが、 には及ばない。
(b) 同じくクリッピングを加えた場合、GNB は empirical Fisher に勝ち、Sophia-H は AdaHessian に勝つ。著者らの推測では、Sophia-H はヘッセ行列の推定の移動平均を取り、AdaHessian はヘッセ行列の推定の 2 乗の移動平均を取るので、前者のほうがノイズ除去の効果が高い。
(c) が一番じっくり見る価値のある図だ。赤い線「Clip」は前処理をまったく使わず、モーメンタムを要素ごとに切り詰めるだけで、著者ら自身がこれは「essentially the same as sign momentum, or Lion with a single β」だと言っている。この線はすでに黒い AdamW に勝っている。クリッピングをしないと、AdaHessian は 、GNB は で発散してしまい、1〜2 ステップに 1 回推定するしかない。青い Sophia-G はさらに一段下にある。
言い換えると、Sophia の改善の一部は sign momentum そのものから来ていて、ヘッセ行列はその上にもう一層を足している。クリッピングは、ヘッセ行列の推定回数を減らすための保険だ。
ほかの人が測り直すと
論文が arXiv に載ってから数か月のうちに、公式リポジトリには再現できないという issue が次々に立った。
GitHub での再現。 2023 年 6 月 28 日、Aaron Defazio が公式リポジトリに issue を立てた。彼は GPT-2 small を 16 枚の V100、fp32 で学習させ、Sophia の学習スクリプトで AdamW も同時に走らせて、スクリプトの違いを排除した。両者それぞれ学習率を走査し、最良はどちらも 1e-3 だった。結果は Sophia-G 2.876、AdamW 2.869 で、彼は両者の最終損失はほぼ同じだと見ている。第一著者は、fp32 そのものが言語モデルの損失を bf16 より低くすると返答して推奨設定を示し、彼自身の fp32 の Sophia は 2.846 まで下がったとした。Defazio はそれに従って走らせ直したが、やはり再現できず、issue を閉じた。11 月には別の issue が README どおりに 125M を再現し、AdamW を 20 万ステップ走らせて 2.863 を得た。これは Sophia-G を 10 万ステップ走らせた 2.897 より低い。著者らは 2024 年 1 月に設定ファイルを更新した。
No Train No Gain(Kaddour ら、2023)。 この論文は Sophia、Lion といくつかの「学習を節約する」手法を BERT と T5 の事前学習に持ち込み、6、12、24 時間の固定予算のもとで比較した。ベースラインは学習率を完全に減衰させる AdamW だ。Sophia をそのまま FP16 の学習パイプラインに入れると NaN が出て、BF16 に変えてようやく安定した。T5 ではさらに RMS スケーリングを加えないと収束しなかった。24 時間の BERT では、GLUE の平均は AdamW 77.9、Sophia 72.3 で、T5 の SNI では 39.5 対 34.1 だった。ヘッセ行列の推定時間を含めずに同じステップ数だけ走らせても、著者らは「still do not observe any speedup」としている。
Zhao ら(2024)。 自己回帰言語モデルで SGD、Adafactor、Adam、Lion、Sophia を比較し、SGD 以外はどれも似たようなものだと結論した。付録では Sophia を Signum(モーメンタム付きの sign 更新で、Sophia の を 0 にしたものに等しい)と比べていて、Sophia は勝てなかった。
Fantastic Pretraining Optimizers(Wen ら、2025)。 著者の David Hall、Tengyu Ma、Percy Liang は Sophia の著者でもある。彼らは 1.3 億から 5.2 億パラメータで改めて調整して比較した。Sophia は計算量が小さいときは AdamW に負け、モデルやデータが大きくなってようやく少しリードするが、0.5B 以下では有意な高速化がなかった。理由も説明している。Sophia の論文の手順は「largely follows the correct procedure」で、ベースラインのピーク学習率は確かに調整されていた。しかし当時のコードの data loader はデータを完全にはシャッフルしておらず、そのコードでは AdamW の最適学習率が小さく抑えられていた。データを完全にシャッフルすれば、AdamW はずっと大きな学習率を使える。
結論
Sophia は 10 ステップに 1 回推定する対角ヘッセ行列を分母にし、さらに座標ごとのクリッピングで 1 ステップの移動の上限を に固定する。推定が外れた座標、負の曲率や小さすぎる曲率の座標は、自動的にモーメンタム付きの sign 更新に戻る。論文の設定では、GPT-2 も 15 億パラメータの NeoX も半分のステップ数で AdamW に追いつき、1 ステップあたり約 5% 遅いだけだった。
この論文が実装者に残した一番役に立つものは、むしろあの測定のルールだ。次に「2 倍速い」を見かけたら、まずベースラインの学習率が同じ総ステップ数、同じく完全にシャッフルしたデータで最良に調整されているかを確かめ、それから新手法が最終チェックポイントだけで比べているかを見る。Sophia を使うなら、切り詰められる座標の割合を見ながら を調整し、混合精度は bf16 を選ぶこと。
(論文自身のアブレーションでは、ヘッセ行列を外してクリッピングだけを残しても、すでに AdamW に勝っていた。後の Zhao らの比較でも、Sophia は確かに Signum に勝てなかった。)