原論文
Decoupled Weight Decay Regularization
- 発表先
- ICLR 2019国際会議
- arXiv への初回投稿
- arXiv:1711.05101
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizersadamw2017,
  title = {{Decoupled Weight Decay Regularization}},
  author = {Ilya Loshchilov and Frank Hutter},
  year = {2017},
  eprint = {1711.05101},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1711.05101}
}
次の PyTorch の 2 行は、引数名も数字も同じだ。
torch.optim.Adam(model.parameters(), lr=1e-3, weight_decay=1e-2)
torch.optim.AdamW(model.parameters(), lr=1e-3, weight_decay=1e-2)
1 行目は 1e-2 を L2 正則化の係数として勾配に加え、それから Adam に渡す。2 行目は各ステップでパラメータに直接 を掛け、勾配とは関係がない。訓練されるモデルは別物になる。
2017 年 11 月、フライブルク大学の Ilya Loshchilov と Frank Hutter がこの違いを指摘したとき、よく使われるフレームワークの実装はどれも 1 つ目の書き方で、しかもどれもそれを weight decay と呼んでいた。
彼らの主張は、画像分類で Adam の汎化が SGD に負けるのは、かなりの部分がここに原因がある、というものだ。
問題の定義
二つの「減衰」
重み減衰(weight decay)は、Hanson と Pratt の 1988 年の定義では、各ステップで重みに 1 よりわずかに小さい数を掛けてから、勾配で更新するものだ(論文の Eq. 1)。
L2 正則化は、損失関数に という項を加えるもので、その勾配は だ。SGD で更新すると、
前の式と見比べると、 とすれば両者はまったく同じになる。これが論文の Proposition 1 で、二つの用語が長らく混同されてきた理由でもある。
ただ、この等式には見落とされがちなことが隠れている。ある問題に最良の減衰量 があるなら、最良の L2 係数 は学習率と結びついている。学習率を変えれば、L2 係数も合わせて変えなければならない。SGD でさえ、この二つのハイパーパラメータは結合している。
Adam ではどうなる?
Adam は勾配を で割る。L2 を勾配に書き込めば、 という項も一緒に割られてしまう。
2017 年 5 月、Wilson らは、Adam が多くのタスクで SGD より汎化が劣ることを見出した。当時、画像分類の最高成績も、まだどれもモーメンタム付き SGD で訓練されたものだった。この差については、鋭い極小値や適応的手法そのものの問題など、いくつかの説明が出ていた。この論文は、別の、より具体的な仮説を出す。問題は、フレームワークが実装している「weight decay」が、Adam の中ではそもそも重み減衰になっていないことにあるのかもしれない。
問題の解決
Adam では等価にならない
Adam を一般的な形 で書く。 は前処理行列で、SGD の は単位行列、Adam のものは にモーメンタムを加えたものだ。二つのやり方の 1 ステップは、それぞれ次のようになる。
二つの式が等しくなるには、すべての について でなければならず、これは が単位行列の定数倍のときにしか成り立たない。Adam の は座標ごとに違うので、L2 を重み減衰と等しくする はどこにもない。これが Proposition 2 だ。
違いはどこにあるのか? 二つのパラメータで計算してみよう。どちらも現在の値は 1 で、勾配の典型的な大きさ()は一方が 1、もう一方が 0.01、L2 係数は とする。モーメンタムはひとまず無視し、 は に影響しないほど小さいと仮定する。
| パラメータ | L2 の減衰量 | AdamW の減衰量 | |
|---|---|---|---|
| A | 1 | ||
| B | 0.01 |
本稿での試算。AdamW の列は PyTorch の書き方に従い、減衰量は 、 とする。
L2 の減衰量は先に で割られるので、勾配の大きいパラメータ A が減衰される量は、勾配の小さいパラメータ B の 100 分の 1 しかない。論文の言い方では、L2 のもとでは、過去の勾配が大きい重みほど正則化が弱くなる。重み減衰は、すべての重みを同じ比率で縮める。
Proposition 3 は、この違いを一つの式にしている。前処理行列が に固定されているなら、重み減衰は、勾配のスケールで重み付けした L2 と等価になる。
が大きい(過去の勾配が大きい)パラメータほど、普通の L2 より強く正則化される。ペナルティ項は なので、各座標のペナルティの重みは に比例する。実際の Adam は毎ステップ前処理を替えるので、この命題をそのまま当てはめることはできないが、二つのやり方がそれぞれどんな目的関数を最適化しているのかを説明してくれる。
Algorithm 2 の二つの書き方
修正の方法は、減衰を勾配から取り出し、パラメータに直接作用させることだ。論文は二つの書き方を同じアルゴリズムに並べ、それぞれで増える項を色で示している。ここでは代わりに下の注記で区別する。
1 行目の Adam+L2 と注記された項だけを残せば Adam に L2 を加えたものになり、最後の行の AdamW と注記された項だけを残せば AdamW になる。デフォルト値は Adam と同じで、、、、 だ。
は学習率スケジュールの倍率で、固定にも、減衰にも、後で出てくる AdamWR のように周期的なリスタートにもできる。最後の行に注意してほしい。減衰項 には が掛かっているが、基本の学習率 は掛かっていない。論文の言う「分離(decoupling)」とはこのことで、 が によって意味を変えることはもうない。この細部は、フレームワークの実装によって扱いが違う。議論の節でまた取り上げる。
SGD 版(SGDW、Algorithm 1)も同様だ。L2 を勾配に書き込むと となり、SGDW では最後の行を に変える。SGD ではもともと二つを入れ替えられるので、SGDW の役割は、 を に合わせて調整し直さなくて済むようにすることだ。モーメンタムがある場合は、L2 項がモーメンタムと一緒に蓄積されるので、二つは完全には一致しなくなる。
コードにすると、違いは 2 行だけだ。以下は PyTorch 2.15 のドキュメントに載っているアルゴリズムに従って、単一テンソル版を書いたものだ。
def adam_step(p, grad, m, v, t, lr=1e-3, betas=(0.9, 0.999), eps=1e-8,
              weight_decay=0.0, decoupled=False):
    b1, b2 = betas
    if weight_decay and not decoupled:
        grad = grad + weight_decay * p        # Adam + L2:減衰項が勾配に混ざり、あとで sqrt(v_hat) で割られる
    if weight_decay and decoupled:
        p.mul_(1 - lr * weight_decay)         # AdamW:パラメータを直接一定の比率で縮め、m と v には入れない
    m.mul_(b1).add_(grad, alpha=1 - b1)
    v.mul_(b2).addcmul_(grad, grad, value=1 - b2)
    m_hat = m / (1 - b1 ** t)
    v_hat = v / (1 - b2 ** t)
    p.add_(-lr * m_hat / (v_hat.sqrt() + eps))
decoupled=True の行で使っているのは lr * weight_decay で、論文が使っているのは だ。この違いは覚えておいてほしい。
なぜ重み減衰なのか
第 3 節は、Aitchison 2018 のベイズフィルタリングの観点を引いて、重み減衰に理由を与えている。確率的最適化を各パラメータの事後分布の追跡とみなし、状態遷移を と仮定する。 とすると、各ステップで現在の推定値に を掛けることになり、これはまさに分離された重み減衰だ。この減衰は事前分布に作用し、各パラメータの不確かさとは関係がない。L2 の効果を得たいなら、減衰量はむしろ不確かさに応じて変わらなければならない。著者らは、この理論はすべて Aitchison の功績で、自分たちは要約しただけだとも説明している。
正規化した重み減衰
著者らは実験の中で、最良の重み減衰が訓練の長さによって変わり、訓練が長いほど最良の が小さくなることに気づいた。付録 B.1 は正規化した書き方を提案している。
はバッチサイズ、 は訓練サンプル数、 は総エポック数だ。 は「訓練全体で 1 バッチしか回さないとき」の減衰量と理解できる。
CIFAR-10 で計算してみよう。、 だ。100 エポック訓練するとき、。1800 エポック訓練するときは約 0.0012 で、実際の は 倍小さくなる。ImageNet32x32 に移ると、1 エポックは CIFAR-10 の 24 倍長いので、同じエポック数なら はさらに約 倍小さくする必要がある。著者らによれば、CIFAR-10 の生の をそのまま ImageNet32x32 に流用すると 5 倍ほど大きすぎて、結果はかなり悪くなる。正規化した書き方を使うと、最良の は、訓練の長さやデータセットが違っても、さらには SGDW と AdamW のあいだでも、とても近い値になる。たとえば 0.025 と 0.05 だ。
著者らは、平方根は少数の実験にもとづく一つの選択にすぎず、確かな結論は「何らかの正規化をする」こと自体が結果を大きく改善するという点だ、とも強調している。
AdamWR
最後の部品は学習率スケジュールだ。著者らが以前に提案した SGDR は、コサインアニーリングと周期的なリスタートを組み合わせる。
は前回のリスタートから何エポック経ったかで、バッチごとに更新されるので整数とは限らない。 はそのラウンドの長さだ。、 とすると、学習率の倍率は各ラウンドで 1 からコサインに沿って 0 まで下がり、それから 1 に跳ね戻る。最初のラウンドを とし、各ラウンドの長さに を掛けていくと、リスタートは第 100、300、700、1500 エポックで起き、各リスタート直前のモデルが推奨される解になる。
彼らはずっと前から Adam にリスタートを適用することを試していたが、当時は SGDR に勝てなかった。その原因がまさに、L2 が Adam の中では SGD ほど効かないことだった。重み減衰を直し、さらに正規化を加えると(長さの違う各ラウンドで同じ設定を使えるようになる)、リスタート付きの AdamW、つまり AdamWR になる。
議論
実験設定
実験は、Shake-Shake 正則化の論文の設定とコードを流用している。主なモデルは深さ 26、二つの残差分岐を持つ ResNet で、最初の残差ブロックの幅は 64(2x64d、1,160 万パラメータ)か 96(2x96d、2,560 万パラメータ)だ。バッチサイズは 128 に固定し、CIFAR-10 の標準的なデータ拡張を使う。ほかに ImageNet32x32、つまり ImageNet の 120 万枚の画像を に縮小したものも使う。
最初の実験は Adam と AdamW だけを比べ、三つの学習率スケジュール(固定、第 30、60、80 エポックで下げる、コサインアニーリング)と組み合わせ、それぞれで学習率と減衰量のグリッドを掃引して、100 エポック訓練する。どのスケジュールでも、分離した重み減衰のほうが L2 より良く、スケジュールが良いほど差は大きくなる。コサインアニーリングがはっきり最良で、以降の実験ではすべてこれを使う。この結果は、Adam がすでにパラメータごとに学習率を調整していても、全体の学習率スケジュールを加えることがやはり役に立つことも示している。付録 D ではさらに、従来の Adam(L2 と固定学習率)を 1800 エポックまで訓練しているが、4×4 の粗いグリッドでの最良の結果でも、AdamW が 18 分の 1 のエポック数と小さめのネットワークで出した結果と同じくらいにしかならなかった。
学習率と重み減衰のヒートマップ
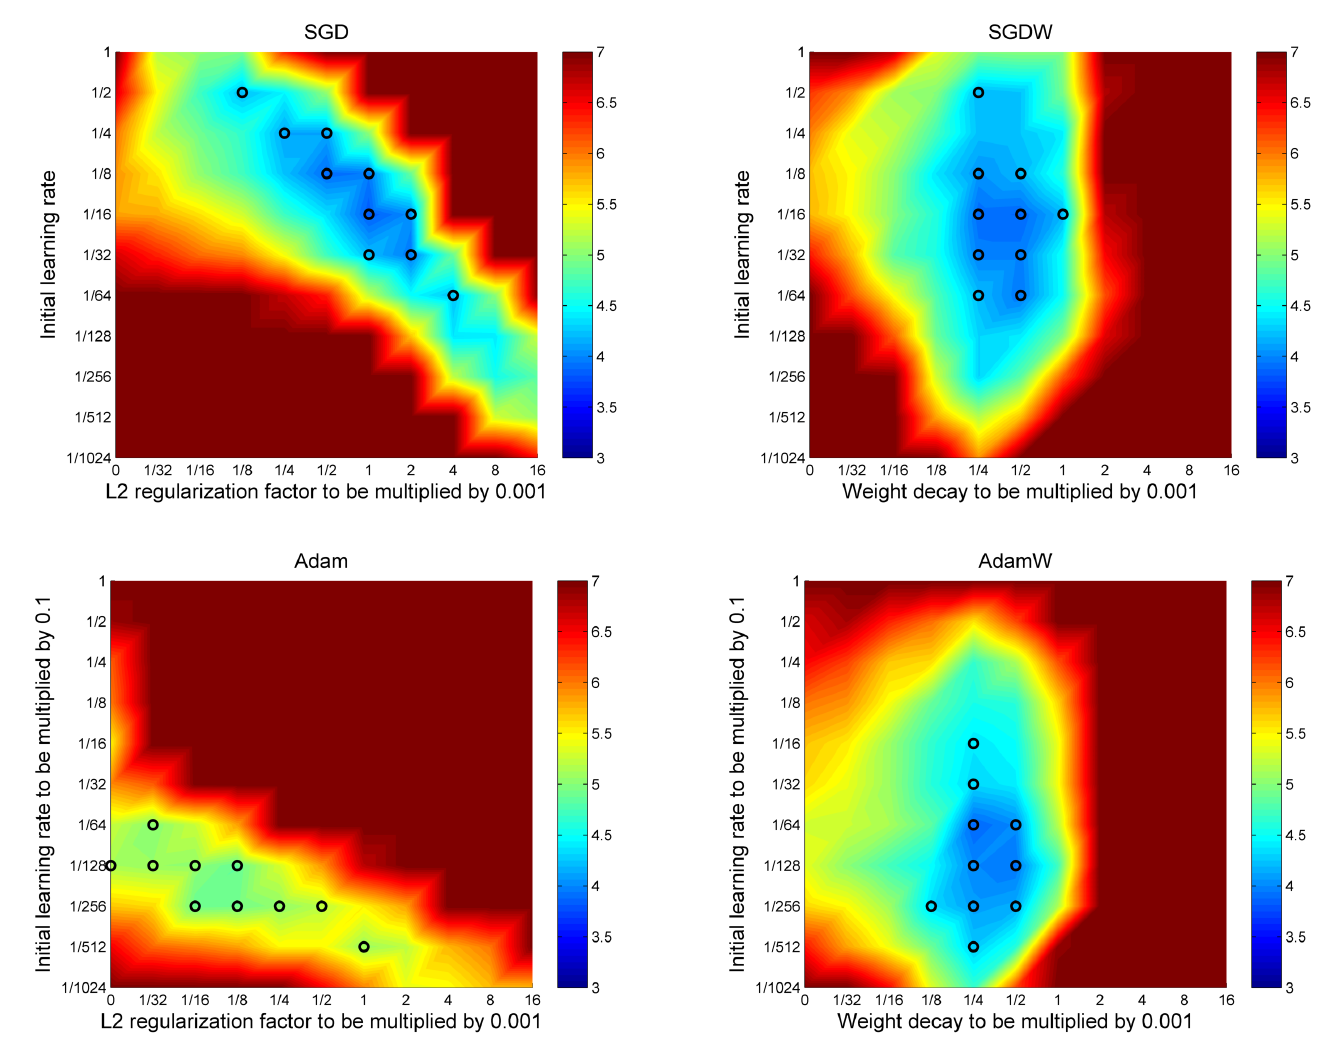
この図が論文全体の中心的な証拠だ。4 枚とも、26 2x64d の ResNet を CIFAR-10 で 100 エポック訓練したときのテスト誤差率で、縦軸は初期学習率、横軸は L2 係数または重み減衰、色は青いほど良く、黒丸は最良の 10 組の設定だ。
左上、SGD と L2。 良い領域は斜めの帯になっている。たとえばいちばん左上の黒丸は 、 にあり、どちらか一方だけを変えると悪くなるが、二つを一緒に変えるとさらに良くなることもある。これがまさに Proposition 1 の言う で、学習率が変われば最良の L2 係数もそれにつれて変わる。著者らは、SGD が「ハイパーパラメータに敏感」だという評判の一部は、この結合から来ているのかもしれないと考えている。
右上、SGDW。 良い領域は縦の帯になり、黒丸の多くは減衰量 1/4 から 1/2(さらに 0.001 を掛ける)のあいだにあって、五つの異なる学習率にまたがっている。学習率がうまく調整できていなくても、たとえば 1/1024 のままでも、減衰量だけを調整すればそれなりの値が見つかる。
左下、Adam と L2。 最良の結果は SGD より明らかに悪い。さらに黒丸の位置を見ると、L2 係数が 0 の設定も上位 10 に入っていて、L2 を加えた最良の結果は、まったく加えない場合とほぼ同じだ。言い換えると、ここでは L2 はほとんど効いておらず、良い領域はやはり斜めになっている。
右下、AdamW。 良い領域は SGDW と同じく縦になり、黒丸は減衰量 1/4 から 1/2 に集中する。最良の結果は Adam と L2 より明らかに良く、SGD や SGDW と肩を並べる。
つまりこの図は、二つのことを同時に支持している。分離すると、学習率と重み減衰はおおむね別々に調整できる。そして Adam は分離した重み減衰に変えることで、このタスクで SGD に追いついた。
汎化が良くなったのか、訓練がうまくなっただけなのか
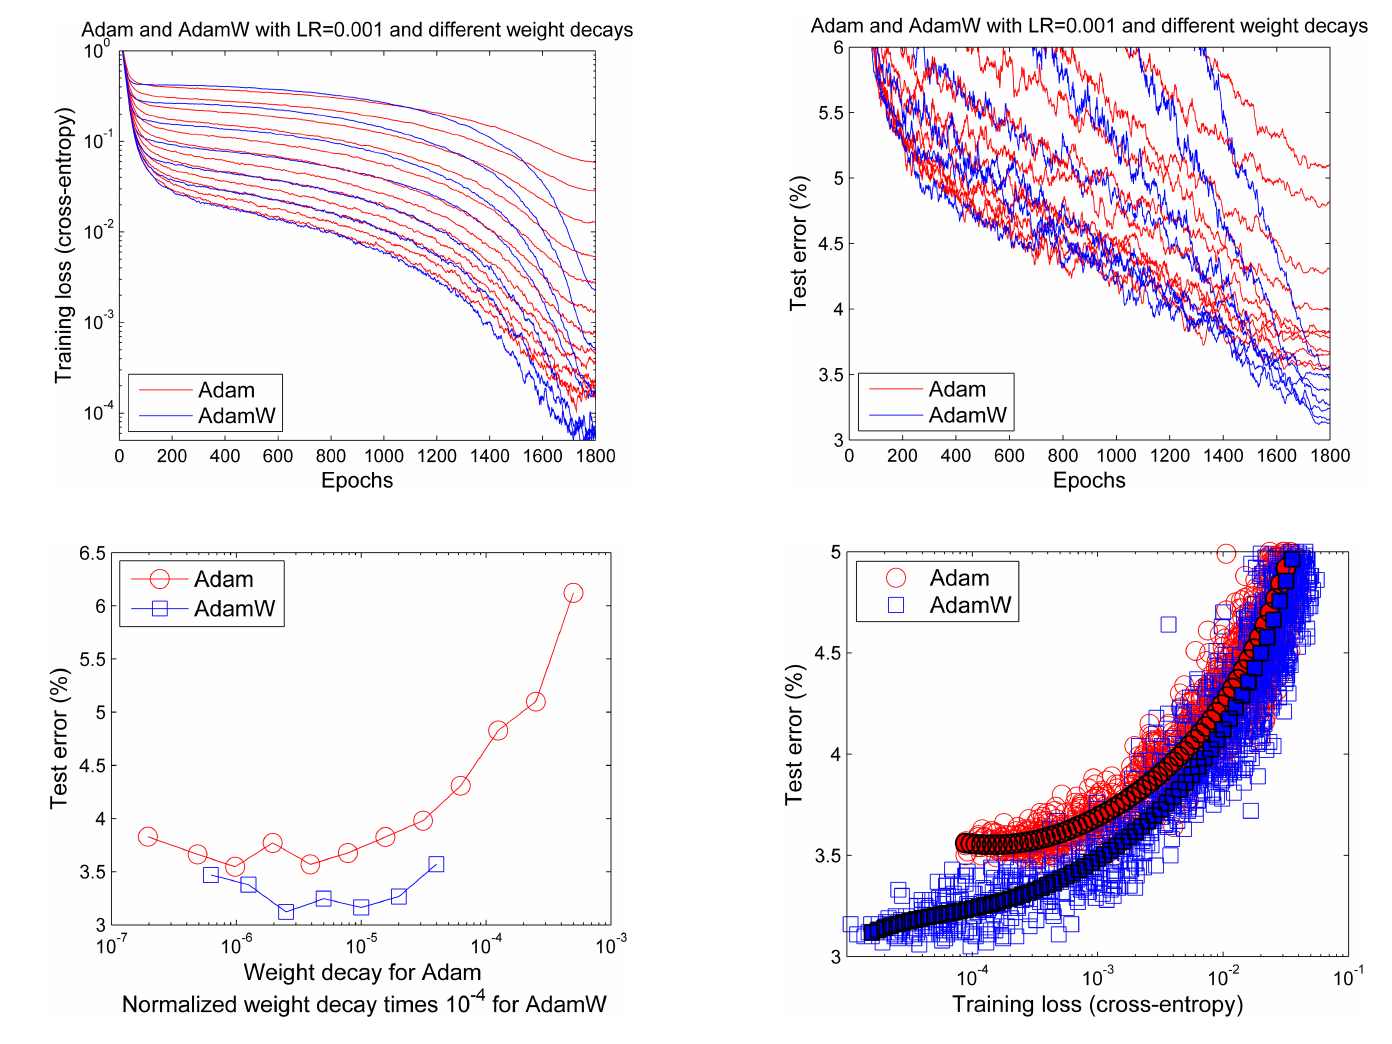
ヒートマップは 100 エポックしか訓練していない。著者らは続いて、より大きな 2x96d を 1800 エポックまで訓練した。初期学習率は Adam のデフォルト値 0.001 に固定し(スケジュールはやはりコサインアニーリング)、Adam と L2 では 12 通りの係数を、AdamW では 7 通りの正規化した減衰量を試している。
上段の学習曲線では、前半は 2 組がよく重なり、後半は AdamW の訓練損失とテスト誤差率がおおむね低い。左下は最終的なテスト誤差率で、Adam と L2 の最良は約 3.55%、AdamW の最良は約 3.1% だ。
右下の図が、見出しの問いに答えている。横軸は訓練損失、縦軸はテスト誤差率だ。もし AdamW が訓練損失をより低く下げただけなら、2 組の点は同じ曲線に乗るはずだ。実際には、同じ訓練損失のところで、青い AdamW のテスト誤差率は赤い Adam より低い。著者らはこれをもとに、AdamW は訓練がうまくなっただけでなく、汎化も良くなったと考えている。ImageNet32x32 でも結果は同じだった。
ウォームリスタートと、いつでも使える結果
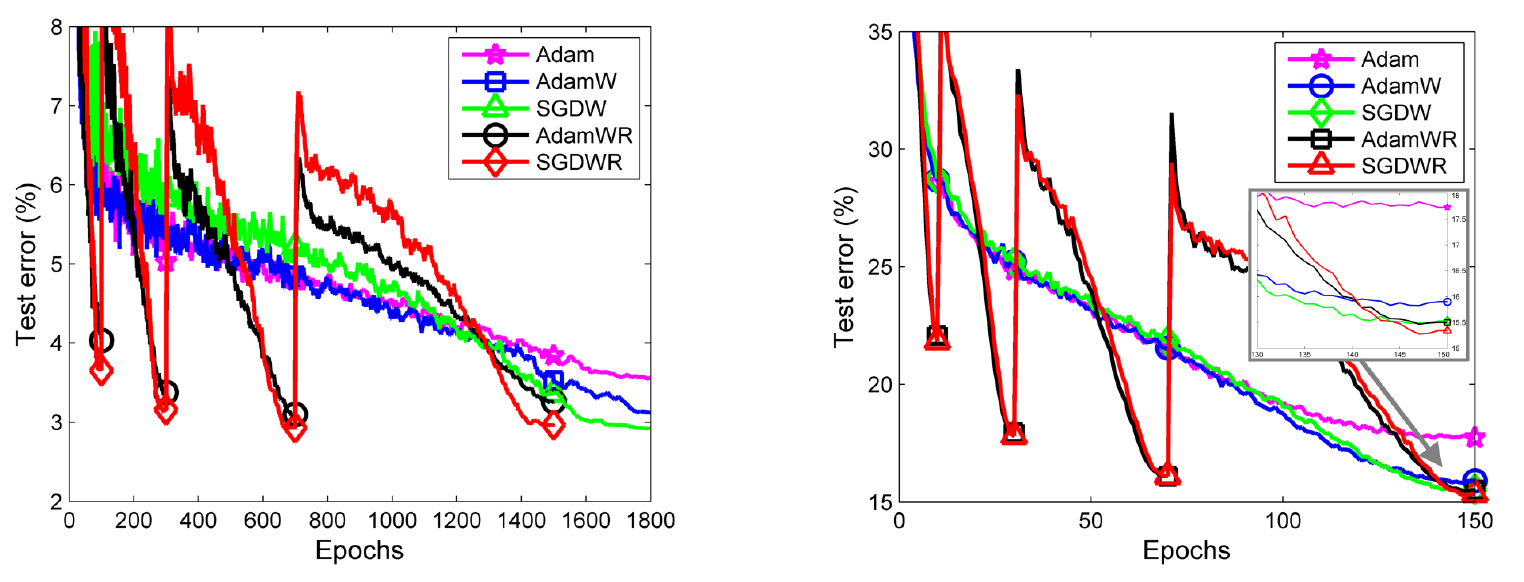
最後に、ウォームリスタートを加えた版を比べる。左図は CIFAR-10 で、R の付いた 2 本の線はリスタートのたびに跳ね上がり、それからすぐに低点まで下がる。最初のリスタートの前(第 100 エポック)で、AdamWR はすでに約 4.0% に達しており、著者らによれば、これで AdamW は最大 10 倍速くなった。これが論文の言う「いつでも使える」(anytime)で、訓練を途中で止めても、そこそこ良いモデルが手元にある。
論文の報告では、デフォルトの学習率 0.001 で、AdamW のテスト誤差率は Adam より相対的に 15% 下がり、CIFAR-10 でも ImageNet32x32 でもそうだった。AdamWR は同じ結果に達し、しかもいつでも使える。左図から読むと、CIFAR-10 で Adam は約 3.6%、AdamW は約 3.1% で止まっている。AdamWR は Adam と SGDWR のあいだの差の大半を縮め、ImageNet32x32 では両者は同等だ。
ほかのタスクと限界
第 4.5 節には、ほかのチームからの使用報告が集められている。脳波分類のチームは同じハイパーパラメータでの直接比較を提供しており、Deep4Net は 71.37% から 73.68% に、ResNet は 61.34% から 72.04% に上がった。OpenAI の 2018 年の GPT は AdamW で Transformer を訓練している。Zhang らは CIFAR で SGD、Adam、K-FAC を比べ、L2 と重み減衰が等価でない場合はいつも、分離した重み減衰のほうが良かった。
限界もはっきりしている。主な実験はすべて画像分類で、著者らは結論で、これらの結果はさらに多くのタスク、特に正則化が重要なタスクで検証する必要があると書いている。正規化した重み減衰の平方根の規則も、少数の実験から来たものにすぎない。
学習率がまた掛け戻された
前に出てきた lr * weight_decay の行に戻ろう。
論文の AdamW では、減衰量は で、スケジュールの倍率にだけ従い、基本の学習率 は掛けない。PyTorch の AdamW は で、 はスケジュールを含む実際の学習率なので、減衰量は になる。Optax の adamw も同じで、そのドキュメントには、ここでの重み減衰は学習率と掛け合わされ、PyTorch とは一致するが、スケジュールの倍率しか掛けない論文のやり方とは異なると明記されている。Keras の AdamW も、パラメータから variable * wd * lr を引く。
換算すると、論文の は PyTorch の lr × weight_decay に等しい。PyTorch のデフォルトは lr=1e-3、weight_decay=1e-2 で、各ステップの減衰は 、論文の書き方では に相当する。デフォルト値もフレームワークによって違い、PyTorch は 0.01、Optax は 、Keras は 0.004 だ。ハイパーパラメータを移すときは、まずどの書き方か、どのデフォルト値かを確かめる必要がある。
この違いには実際的な帰結がある。PyTorch の書き方では、学習率を変えると減衰量も同時に変わるので、前のヒートマップで見た「二つのハイパーパラメータを別々に調整できる」という性質は完全には成り立たなくなる。Fabian Schaipp は 2024 年 2 月のブログ記事で、合成したリッジ回帰の問題を使ってこれを示し、PyTorch の AdamW で学習率を掃引するときは lr × weight_decay を一定に保ち、学習率を 2 倍にしたら減衰を半分にするよう勧めている。timm で ViT を訓練した経験もこれと一致すると述べているが、その部分の実験は公開していない。Wang と Aitchison は 2024 年に別の角度から、AdamW が学習した重みは直近の更新の指数移動平均とみなせ、その時間スケールはおよそ ステップだと論じた。彼らは ResNet、ViT、NanoGPT で、エポック単位で数えた最良の時間スケールがほぼ一定であることを見出し、データセットが大きくなれば重み減衰はそれに合わせて小さくすべきだとした。これは論文の正規化した重み減衰と同じ方向だ。
論文の書き方を残しているフレームワークもある。たとえば MosaicML Composer の DecoupledAdamW は、減衰量に「現在の学習率を初期学習率で割ったもの」、つまりスケジュールの倍率だけを掛ける。また、PyTorch の Adam 自体にも weight_decay があるが、それは L2 だ。Adam で AdamW の振る舞いを得るには、別に decoupled_weight_decay=True を設定する必要がある。
その後
AdamW はその後、Transformer の訓練の標準装備になった。LLaMA は AdamW を使い、、重み減衰 0.1。OLMo 2 は埋め込み層を重み減衰の対象から外しさえした。DeepSeek-V4 はパラメータの大部分を Muon に任せ、埋め込み層、予測ヘッド、正規化層の重みには引き続き AdamW を使っている。
結論
この論文は、L2 正則化と重み減衰が等価なのは SGD の中だけで、しかも学習率に応じて係数を換算する必要があることを証明した。Adam の中では、L2 の勾配は で割られ、過去の勾配が大きい重みほど正則化が弱くなる。減衰を勾配の外に出し、パラメータに直接作用させたものが AdamW だ。CIFAR-10 のヒートマップは、これによって学習率と重み減衰をおおむね別々に調整でき、Adam の最良の成績も SGD に追いつくことを示した。1800 エポックの比較は、同じ訓練損失のもとで AdamW のテスト誤差率のほうが低いことを示した。証拠は主に画像分類の ResNet から来ており、正規化の規則も少数の実験しかしていない。
実際に使うときは、まず自分が使っているのがどの AdamW かを確かめよう。PyTorch、Optax、Keras の減衰量はどれも学習率に weight_decay を掛けたもので、論文と Composer の版はスケジュールの倍率しか掛けない。論文やほかのフレームワークから設定を移すときは、換算を忘れないこと。PyTorch で学習率を掃引するなら lr × weight_decay を固定するとよい。そして torch.optim.Adam(weight_decay=...) は、最初から最後まで L2 だ。
論文の初版のタイトルは〈Fixing Weight Decay Regularization in Adam〉で、修正された版はのちに大規模言語モデルの標準装備になった。ただ、最も普及したいくつかの実装は、学習率をまた減衰項に掛け戻してしまった。