原論文
SOAP: Improving and Stabilizing Shampoo using Adam
- 発表先
- ICLR 2025国際会議
- arXiv への初回投稿
- arXiv:2409.11321
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizerssoap2024,
  title = {{SOAP: Improving and Stabilizing Shampoo using Adam}},
  author = {Nikhil Vyas and Depen Morwani and Rosie Zhao and Mujin Kwun and Itai Shapira and David Brandfonbrener and Lucas Janson and Sham Kakade},
  year = {2024},
  eprint = {2409.11321},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2409.11321}
}
Shampoo を使う人は、誰もが一つ決めなければならない。一番高くつくあのステップを、どれくらいの間隔で実行するか?
Shampoo は毎ステップ二つの統計行列 、 を更新するが、実際に勾配に掛けるのはそれらの行列べき乗で、固有値分解か反復による根の計算が必要になる。このステップは高すぎるので、どの実装も ステップに 1 回だけ計算し、その間は古いものを使い回す。
Harvard の Nikhil Vyas、Depen Morwani らは、この を広げながら測ってみた。3.6 億パラメータの言語モデルで、 のとき Shampoo の最終テスト損失は約 2.824、 で約 2.868、 で約 2.932 になる。同じ設定の AdamW は約 2.943 だ。計算を節約しようと間隔を広げると、Shampoo の AdamW に対する優位はほとんどすべて吐き出されてしまう。
2024 年 8 月、Shampoo は AlgoPerf の外部チューニング部門で優勝したばかりだった。この論文は、それをもう少し安く、そしてもう少し調整しやすくしようとしている。
問題の定義
Shampoo は の重み行列一つに対して、左右二つの前処理を保持する。
原版の指数は で、後の実装の多くは に変えている。実際に使える Shampoo(たとえば Meta の DistributedShampoo)では、学習率やモーメンタムのほかに、統計量の移動平均の係数、行列の根を求めるときの 、1 次元と 2 次元のパラメータそれぞれの指数、歩幅を決める grafting にどのオプティマイザを使うか、そして前処理をどれくらいの頻度で更新するかを設定しなければならない。
問題は二つある。一つ目は、頻度を下げるとすぐに性能が落ちること。2 回の固有値分解の間、前処理全体が凍結されていて、勾配のスケールがどう変わってもそれを知らないからだ。二つ目は、ハイパーパラメータが多すぎることだ。
著者らの切り口は、まず Shampoo が固有基底の中で実際に何をしているのかを理解することだった。それを「高い部分」と「安い部分」に分けられれば、高い部分はゆっくり計算し、安い部分は毎ステップ更新できるかもしれない。
問題の解決
Shampoo は回転した Adafactor
まず Shampoo を理想化する。 乗を使い、、 はデータセット全体での期待値 、 を取り、さらに で補正するスカラーを掛ける。更新は次のようになる。
と を固有値分解し、、、固有値をそれぞれ と とする。代入すると次のようになる。
この式は 3 段階で読める。まず勾配を固有基底に回転させて、 とする。この座標系で、 番目の要素に を掛ける。最後に元の座標に戻す。
真ん中のステップは要素ごとのスケーリングで、しかもスケーリング係数は「第 行の量」掛ける「第 列の量」で、ランク 1 だ。これはまさに Adafactor のやり方だ。Adafactor はメモリを節約するため、要素ごとの二次モーメントを保存せず、各行の総和 と各列の総和 だけを保存し、 で復元する。
回転した座標で Adafactor を走らせたら、行の総和はいくつになるか? 、 を 、 の第 、第 列ベクトルとすると、
2 番目の等号では、 が正規直交基底であることを使っている。同様に 、 となる。Adafactor の に対するスケーリングは で、上の Shampoo とまったく同じだ。
これが論文の Claim 1、 乗の Shampoo は、Shampoo の前処理の固有基底の中で Adafactor を走らせることに等しい。高い部分は基底を見つけること(固有値分解)で、安い部分は基底の中で座標ごとにスケーリングすることだ。
Adafactor から Adam へ
この視点を持つと、Shampoo の頻度の問題の病巣が見えてくる。実際には ステップに 1 回だけ計算し直すので、「基底」と「スケーリング」を一緒に凍結していることになる。しかしスケーリングは要素ごとの移動平均がいくつかあるだけで、毎ステップ更新しても安い。基底はゆっくり変えてもかまわないが、スケーリングまで一緒に待つ理由はない。
スケーリングを毎ステップ更新するのならと、著者らは思い切って Adafactor を Adam に置き換え、ランク 1 分解をせずに要素ごとの完全な二次モーメントを使った。アルゴリズム(Algorithm 3)は次のとおりで、 は要素ごとの積だ。
基底は ステップに 1 回だけ更新し、それにはべき乗法 1 ステップと QR 分解を使う。 で、 は または 、 は前回の基底だ。完全な固有値分解を使うのは初回だけだ。
立ち止まって見ておきたい細部がいくつかある。
モーメンタム は元の座標で保存し、毎ステップ射影し直す。基底は ステップごとに変わるので、モーメンタムを古い座標で保存していると、基底を変えた瞬間に合わなくなるからだ。二次モーメント は回転後の座標にそのまま置かれていて、基底を変えても回転させない。要旨はこの基底を「slowly changing」と表現している。公式コードは基底を変えるとき、固有値の大きさに従って の順序を並べ替え、同じ方向が同じマスに対応するようにしている。
1 次元のパラメータ(バイアス、LayerNorm の重み)は、そのまま AdamW で更新する。最初の embedding 層と最後の出力層は一つの次元が語彙サイズなので、それほど大きな固有ベクトル行列を保存するのは高すぎる。そこでその側の は単位行列に固定する。両側とも単位行列なら SOAP は Adam に戻るので、論文は SOAP を「回転した空間で Adam を走らせるもの」と言っている。
減ったハイパーパラメータ
SOAP という名前は ShampoO with Adam in the Preconditioner's eigenbasis から来ている。AdamW と比べて増えるハイパーパラメータは一つだけで、基底を更新する頻度 だ。Shampoo と比べると、次のものが要らなくなる。
- 行列べき乗の指数。スケーリングは Adam の に任せる。
- 根を求めるときに固有値に加える 。Adam 自身の を使う。
- grafting。Adam が回転した空間で座標ごとに歩幅を決めるので、ほかのオプティマイザから借りる必要がない。
- 、 の移動平均の係数。Adam の をそのまま共用する。
代償
メモリは DistributedShampoo と同じだ。 の層一つに対して、、、、 の四つの正方行列に、勾配、、 を加え、合計 を保存する。AdamW なら で済む。
Shampoo は 1 ステップにつき左右から 1 回ずつ前処理を掛ける。SOAP はまず向こうへ射影し、また戻ってくる必要があり、左右の行列積が 1 巡多いので、1 ステップの計算量は Shampoo よりやや多い。その見返りに、頻度を下げられる。
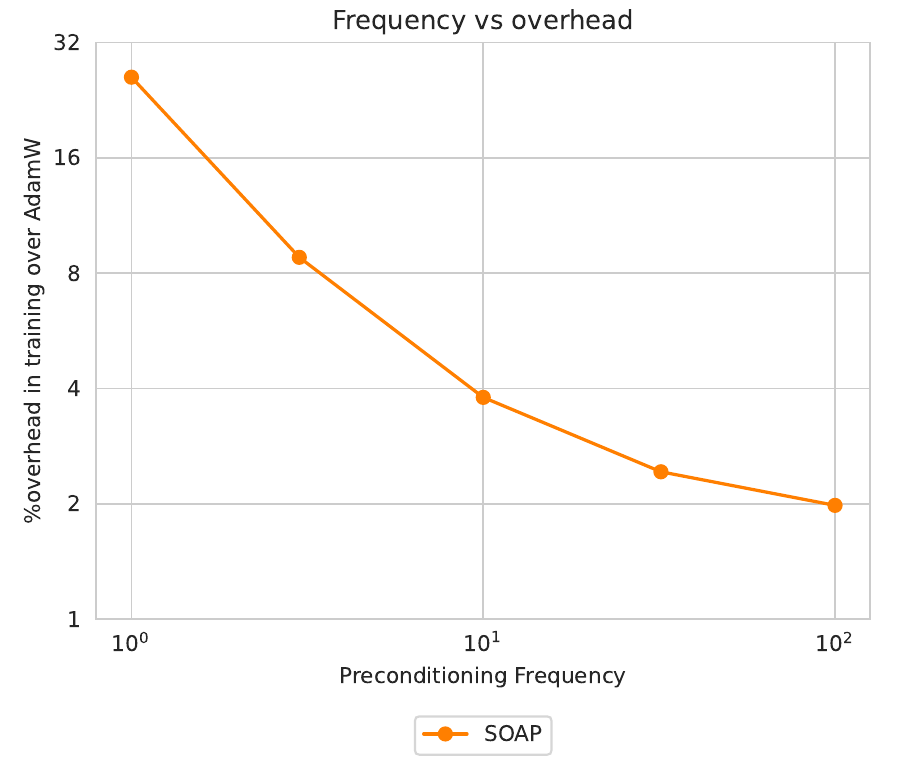
毎ステップ基底を変えると、学習時間は約 27% 増える。 で約 3.7%、 で約 2% だ。曲線が 0 まで下がらないのは、基底を変えるかどうかにかかわらず、毎ステップ fp32 で 、 を更新し、射影を 2 回行う必要があるからだ。これらの数値は 1 枚の H100 で、勾配累積によって大きなバッチを作って測ったものだ。
議論
実験設定
実験はすべて言語モデルの事前学習だ。データは C4 で、T5 の tokenizer を使う。モデルは OLMo のコードをベースにした decoder-only で、2.1 億、3.6 億、6.6 億の三つのサイズ(embedding を除く)がある。幅は 1024、1024、1408、深さは 12、24、24 で、RoPE と QK LayerNorm を使い、bf16 の混合精度で学習する。系列長は 1024、各バッチは約 200 万 token。学習量はパラメータ数の約 20 倍の token 数で、360m は 3,200 ステップ、660m は 6,400 ステップ走らせる。
三つのオプティマイザはどれもまず学習率を走査する。AdamW は 360m でさらに 、 も走査した。Shampoo は DistributedShampoo を使い、さらに 、統計量の移動平均の係数、4 組の指数を走査したが、これらの走査による損失の改善はどれも 0.004 未満だった。SOAP は学習率だけを走査した。共通の設定は 、decoupled weight decay 、z-loss で、ウォームアップの後にピークの 0.1 倍まで cosine で減衰させる。
「どれだけ速いか」の計算方法も説明しておく必要がある。cosine スケジュールは総ステップ数で決まるので、同じ学習の途中のチェックポイントで比べるのは公平ではない。著者らは SOAP を 0.5、0.625、0.75、0.875 倍の長さでそれぞれ完全な学習として走らせ直し、 で最終損失とステップ数の関係を当てはめて、どの長さで AdamW と Shampoo の最終損失に追いつくかを求めた。
主な結果
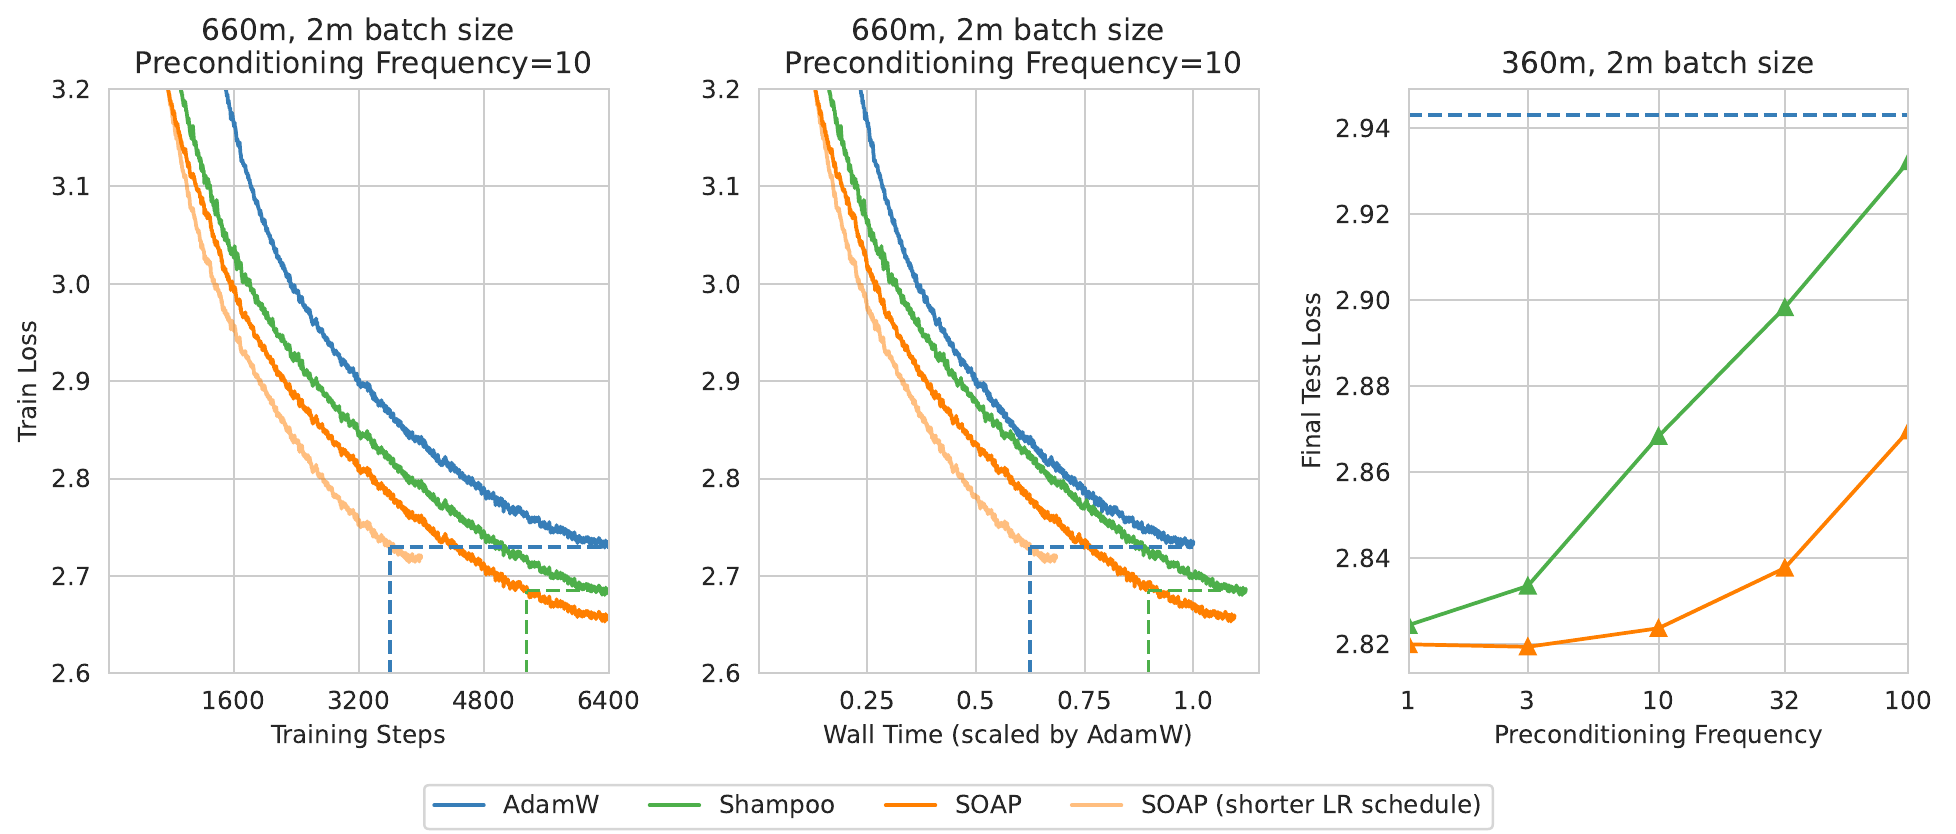
まず左図を見る。青、緑、橙の 3 本は、同じく 6,400 ステップ走らせた AdamW、Shampoo、SOAP で、終点では SOAP が最も低い。薄い橙の線はスケジュールを短縮した SOAP で、破線はそれが約 3,600 ステップで AdamW の終点に追いつくことを示している。中央の図は横軸を実時間に替えたもので、3 本の線の間隔が少し縮まる。SOAP と Shampoo は 1 ステップごとに AdamW より高くつくからだ。
論文の効率の推定に従うと、三つの設定の数値は次のとおりだ。
| 設定 | AdamW に追いつく | Shampoo に追いつく |
|---|---|---|
| 360m、200 万 | 0.50/0.52 | 0.75/0.74 |
| 660m、200 万 | 0.565/0.62 | 0.80/0.78 |
| 360m、25.6 万 | 0.72/0.83 | 0.875/0.90 |
原論文 Figure 2 に記された目盛りをもとに整理。各セルは「ステップ数の比/時間の比」で、1 列目のバッチの単位は token。Shampoo に対する時間の比は本稿で換算した(Shampoo の全体の時間はそれぞれ AdamW の 1.06、1.12、1.11 倍)。
大きなバッチでは、SOAP は AdamW の 50%〜57% のステップ数、約 52%〜62% の時間しか要らない。Shampoo に対しては 2 割あまり節約できる。これが要旨の「AdamW より反復回数が 40% 以上、実時間が 35% 以上少なく、Shampoo より約 20% 少ない」の出どころだ。さらに 360m をパラメータ数の 100 倍の token(335 億)まで走らせても、SOAP の AdamW に対する優位は残っていた。
頻度のアブレーション
冒頭の数値は Figure 1 の右半分から来ている。ここでもう一度載せる。
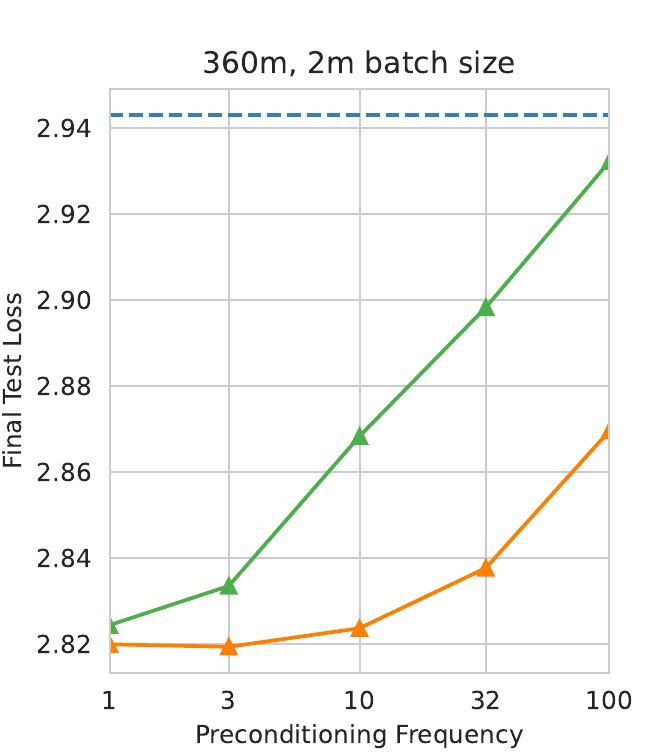
2 本の線はどちらも AdamW の破線より下にある。つまり が 1 から 100 まで、どちらも AdamW に勝っている。 では二つはほぼ同じ(2.820 対 2.824)で、「毎ステップ計算し直すなら、両者の違いは Adafactor と Adam の差だけ」という予想に合う。その後、Shampoo は 2.932 までずっと上がっていくが、SOAP は でもまだ 2.823 で、 になってようやく 2.870 まで上がる。
この結果は著者らの説明を裏づけている。SOAP は で 2.823、 でも より約 0.018 高いだけで、同じ頻度の Shampoo の 2.868 と 2.898 よりはるかに低い。Shampoo を本当に悪くしていたのは、スケーリングまで一緒に凍結されていたことだ。
バッチサイズ
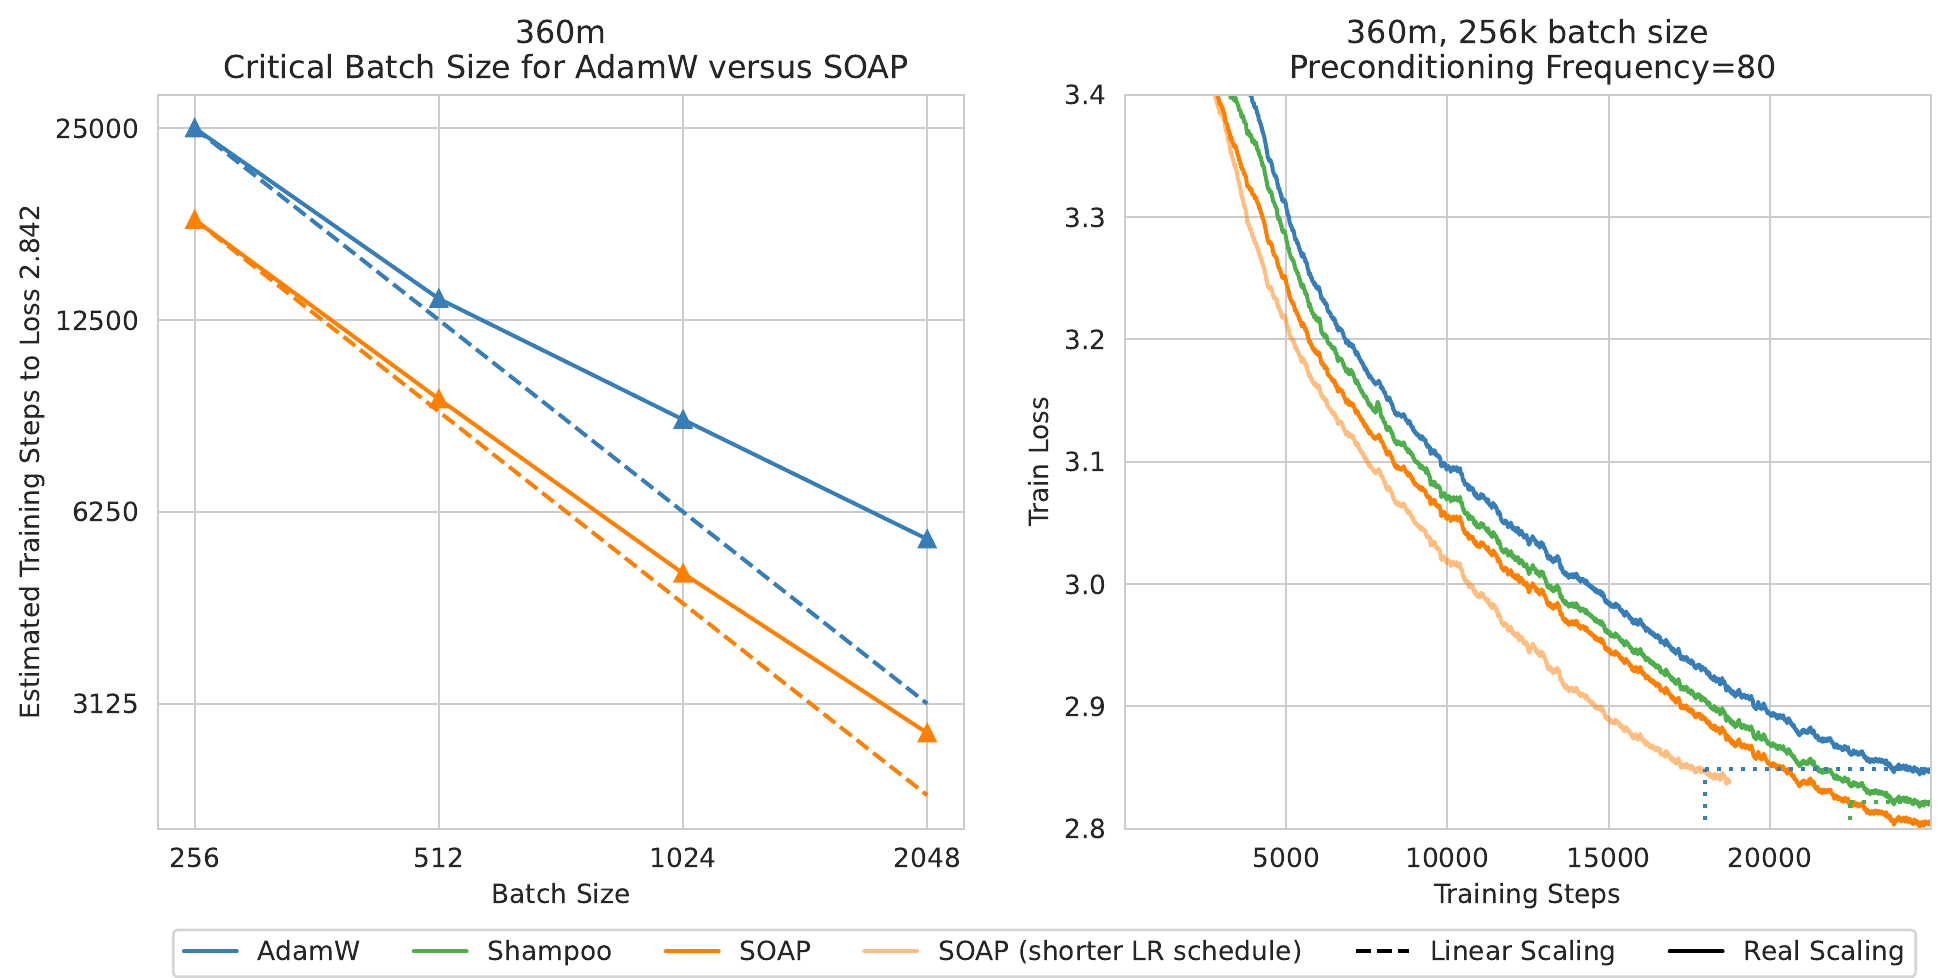
理想的には、バッチサイズを 2 倍にすれば、同じ損失に達するまでのステップ数は半分になる。これが左図の破線だ。実線が破線から離れるほど、増やしたバッチは無駄になっている。AdamW の青い実線は 512 からどんどん離れていき、2048 では必要なステップ数が理想値の 2 倍近くになる。SOAP の橙の実線は自分の破線に比較的近いので、著者らは SOAP の臨界バッチサイズのほうが大きいと述べている。公平にするため、バッチを 分の 1 にするごとに頻度を 倍にして、固有値分解のオーバーヘッドの割合を一定に保っている。
右図は最小の 25.6 万バッチだ。SOAP は AdamW よりステップ数が 25% 少なく、Shampoo より約 10% 少ない。上の表と照らし合わせると、小さなバッチでは優位がはっきり縮んでいる。著者らもこれは予備的な結果だとしていて、「バッチ×頻度」を固定するのが最良のトレードオフとは限らない。二次の手法が小さなバッチで効果を落とすのは、先行研究とも一致する。公式 README も、できるだけ大きなバッチを使うよう勧めている。
メモリを節約する変種と GaLore
SOAP は AdamW より だけ多くメモリを使う。論文は二つの節約法を試した。回転後の空間で代わりに Adafactor を走らせると、 一つ分を節約でき、損失はほとんど変わらない。短いほうの側だけを回転させ、もう一方の側は単位行列にすると、損失はもう少し増えるが、それでも Shampoo と同等かわずかに良い。二つを組み合わせるとメモリは で、標準的な Transformer ではすでに AdamW の より小さく、それでも AdamW に勝つ。
GaLore のフルランク版は SOAP によく似ていて、主な違いは 3 か所だ。GaLore の射影は現在の勾配の SVD から来るが、SOAP は の移動平均を使う。GaLore はモーメンタムを射影空間に保存し、基底を変えても元に戻さないが、SOAP は元の空間に保存する。GaLore は片側だけを射影する。2.1 億パラメータのモデルで、GaLore の最良の結果は 3.12 で、AdamW には勝つが Shampoo の 3.10 には負ける。そこで著者らは、SOAP のこれらの変更はどれも必要だと考えている。
このアイデアは、実は以前に書かれていた。Anil らは 2020 年の Distributed Shampoo 論文の付録 B で、2 次元の層では SOAP と本質的に等価なアルゴリズムを記述していた。ただし実験は付けず、未発表の実験では改善が見られなかったとだけ書いている。SOAP の著者らは関連研究でこのことを正直に説明し、違いは実装の細部から来ているのだろうと推測している。
限界
論文自身が挙げている限界ははっきりしている。モデルは最大 6.6 億パラメータで、当時の大規模モデルより 2 桁小さい。著者らは結論がより大きな規模にも一般化できると仮定しているが、それは「remains to be validated」だ。言語モデルしか試していない。スループットは 1 枚の GPU で測っていて、分散実装の比較は今後の課題としている。、 の演算はすべて fp32 で、PyTorch の QR はより低い精度をサポートしていないので、オーバーヘッドの下限は当面これ以上下げられない。
1 年後の独立検証
2025 年、Stanford の Wen、Hall、Ma、Liang は「Fantastic Pretraining Optimizers and Where to Find Them」を発表し、AdamW と 10 個の新しいオプティマイザを 1.3 億から 12 億パラメータ、Chinchilla の 1 倍から 8 倍のデータ量の設定に置き、それぞれを丁寧に調整したうえで比較した。
彼らは 3 億と 5.2 億パラメータのモデルで、SOAP が調整済みの AdamW より 1.2〜1.3 倍速いと測った。12 億パラメータになると、SOAP も Muon も約 1.1 倍しか残らない。もう一つの発見は、モデルに対するデータ量の比を 8 倍以上にすると、データが少ないときに最強だった Muon を SOAP と Kron が上回ることだ。彼らの SOAP 実装はさらに重みのブロック分割を行い、12 億パラメータではモーメンタムに bf16 を使っていて、原版とは少し違う。
結論
SOAP は一つの等価関係から出発する。 乗の Shampoo は、その固有基底の中で Adafactor を走らせることにほかならない。高い基底と安いスケーリングを切り離すと、基底は 10 ステップかそれ以上に 1 回だけ更新すればよく、スケーリングは毎ステップ Adam のやり方で更新する。ハイパーパラメータも、AdamW より頻度が一つ多いだけにまで減った。3.6 億と 6.6 億パラメータの言語モデル、大きなバッチで、AdamW よりステップ数が約半分、実時間が 38%〜48% 少ない。
試してみたいなら、公式の soap.py はそのままプロジェクトにコピーできる。README の設定、、頻度 10 から始め、まず 1 ステップが AdamW よりどれだけ遅いかをきちんと測ってから、頻度を下げるかどうかを決めるとよい。メモリが厳しいなら、片側だけの回転と Adafactor 版が、論文で検証済みの退路になる。
Fantastic は本文でわざわざ名指しして、SOAP はベースラインのハイパーパラメータを独立に走査した数少ない論文の一つで、報告した高速化も彼らの実測に最も近いと書いている。オプティマイザの論文で、こういう評価はめったに見ない。