原始論文
Fantastic Pretraining Optimizers and Where to Find Them
- 發表版本
- ICLR 2026會議
- arXiv 首次提交
- arXiv:2509.02046
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizersfantasticoptimizers2025,
  title = {{Fantastic Pretraining Optimizers and Where to Find Them}},
  author = {Kaiyue Wen and David Hall and Tengyu Ma and Percy Liang},
  year = {2025},
  eprint = {2509.02046},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2509.02046}
}
拿一個 1.3 億參數的語言模型,照 GPT-3 論文的配方用 AdamW 訓練,峰值學習率 6e-4。現在只改一個數字,把學習率換成 8e-3,其他設定都不動。達到同樣的 loss,步數少了一半。
這組實驗放在論文的第一張圖。GPT-3 配方的這條 AdamW 曲線,正是 Sophia、MARS、Cautious 等新優化器論文拿來比較的基準,這些論文宣稱的加速大多是 2 倍。Muon 的大規模版本宣稱約 2 倍,SOAP 宣稱 1.4 倍,DION 甚至報告了 3 倍。
如果光是把基準的學習率調好就有 2 倍,那這些優化器真正快了多少?Stanford 的 Kaiyue Wen、David Hall、馬騰宇(Tengyu Ma)與 Percy Liang 把 11 個優化器放在同一套流程裡,每一個都從頭調參,從 1.3 億參數一路比到 12 億參數。
論文題目套用了電影《怪獸與牠們的產地》(Fantastic Beasts and Where to Find Them)。這篇筆記要看的是,他們怎麼設計一個公平的比較,量到的加速比是多少,又和同期、後來的幾份大規模評估差在哪裡。
定義問題
作者認為,新優化器遲遲沒有取代 AdamW,問題出在評估方法,主要有兩個。
第一個是調參不對等。新方法的作者通常認真調自己的優化器,基準卻沿用舊配方,或是讓所有優化器共用同一組學習率和權重衰減。
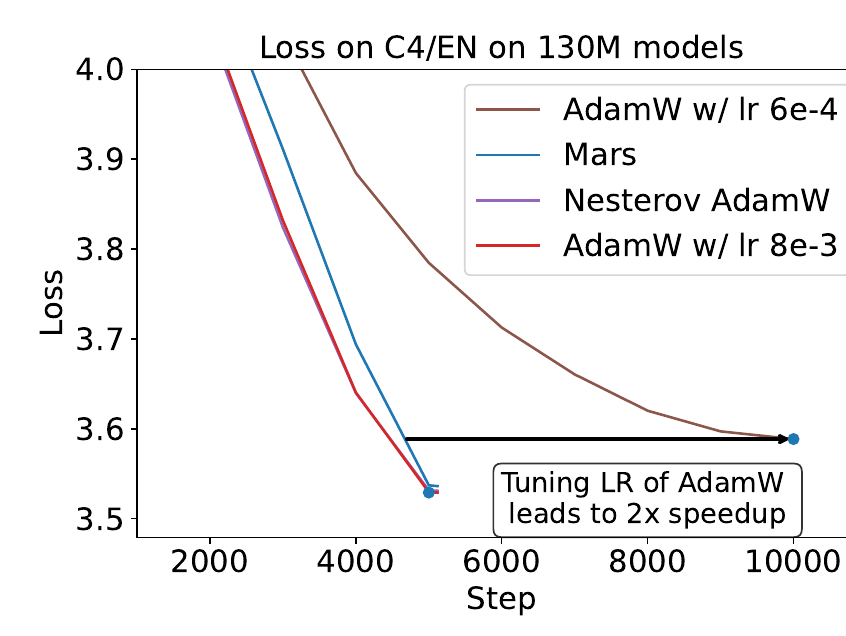
棕線是學習率 6e-4 的 AdamW,紅線是 8e-3。紅線不到 5,000 步就降到棕線第 10,000 步的終點 loss,最後還停在更低的約 3.53。MARS(藍線)和 Nesterov AdamW(紫線)也畫在圖上,終點都和調好的紅線很接近。拿棕線當基準,MARS 看起來就有 2 倍加速;換成紅線,差距就小得多。
共用超參數也不公平。就算是很像的優化器,最佳超參數也可能差很多。以 Lion 為例,論文的掃描找到它的最佳權重衰減約 0.6,AdamW 約 0.1;兩者如果共用同一個值,總有一個是吃虧的。
第二個是評估設定太窄。多數論文只在 1× Chinchilla 附近、一兩個模型大小上比較,有的還拿訓練中途的 checkpoint 比。所謂 1× Chinchilla,是 Chinchilla 論文推出的計算最佳比例,每個參數讀約 20 個 token。真實的大模型從 1 倍到 50 倍以上都有,一個在 1× 贏的方法,到了資料多的區間不一定還贏。
這篇論文要回答的就是這兩件事。怎麼確定每個優化器都調到接近最佳?在不同模型大小、不同資料量下,加速比又是多少?
解決問題
實驗場地
資料仿照 OLMo 2,混合 DCLM-baseline(3.8T token)、StarCoder V2(0.25T)與 ProofPile 2(55B),用 Llama 3 的 tokenizer。模型都是 Llama 架構、32 層、序列長 4,096,只改寬度:
| 模型 | 隱藏維度 | 前饋維度 | 注意力頭 |
|---|---|---|---|
| 130M | 512 | 2,048 | 8 |
| 300M | 768 | 3,072 | 12 |
| 520M | 1,024 | 4,096 | 16 |
| 1.2B | 1,536 | 6,144 | 24 |
整理自原論文 Table 2。
資料量以 Chinchilla 倍數表示,1×、2×、4×、8×(非嵌入參數量的 20 倍算 1×)。主要指標是 C4 英文子集的驗證 loss,另外追蹤 HellaSwag、ARC 等十多項下游準確率。實驗在 128 顆 TPU v5 lite 上用 JAX 跑,作者估算約相當於 12 張 H100。
比較的單位是「達到同一個 loss 需要多少 token」,不計每一步多花的計算時間。作者的理由是,SOAP 與 Kimi 的 Muon 論文都顯示,矩陣型優化器實作得當時,每步額外開銷可以壓到 10% 以下。
11 個優化器分成五類:
- 基準:AdamW
- 降低更新變異數的 AdamW 變體:NAdamW(Nesterov 動量)、MARS、Cautious
- 省記憶體:Lion、Adam-mini
- 矩陣型:Muon、Scion、Kron(PSGD)、SOAP
- 近似 Hessian:Sophia(結果放在附錄)
純量型和矩陣型的差別在預條件怎麼作用。AdamW、Lion、MARS 等純量型,對每個參數各自乘上一個純量;Muon、SOAP、Kron 等矩陣型,把整個權重矩陣當成一個整體,用矩陣乘法處理梯度。
三階段調參
全部組合都完整搜尋太貴,作者分三階段做。
第一階段是座標下降。 每個超參數都有一組離散的候選值,以 AdamW 為例,包括學習率、權重衰減、暖身步數、、、、梯度裁剪上限與批次大小(batch size)。起點是原論文建議的設定。每一輪固定其他超參數,只掃其中一個,若驗證 loss 的改善超過 就換成新值;一輪一輪掃,直到沒有任何一個超參數能再顯著改善。這個步驟在 6 個設定上各做一次:130M、300M、520M 的 1×,加上 130M 的 2×、4×、8×。
論文給了一個 AdamW 的示範。初始設定是學習率 0.008、權重衰減 0.1、暖身 1,000 步、批次 256 筆,loss 3.298;第一輪把暖身改成 2,000 步,降到 3.282;第二輪把批次改成 128 筆,降到 3.263;最後把梯度裁剪上限改成 2,loss 維持 3.263,掃描結束。
第二階段只調會隨規模變的超參數。 作者觀察到兩件事。很多超參數只要在最佳值附近,對 loss 幾乎沒影響;會影響 loss 的那些,最佳值多半也不隨規模改變。
於是他們把 loss 與最佳值相差 以內的設定都算作「接近最佳」。若某個超參數存在一個值,在每個設定下都屬於接近最佳,它就是對規模不敏感的,固定下來;否則就是對規模敏感,帶到第二階段繼續調。
結果每個優化器需要重調的超參數都不多。AdamW 是學習率、暖身、權重衰減和批次大小,Lion 是學習率和 ,Muon 和 Kron 都只有學習率。第二階段在 300M、520M 的 2×、4×、8× 共 6 個設定上重做,加上第一階段,總共 12 個設定。
第三階段把規律外推。 對每個需要重調的超參數 ,用 12 個設定的最佳值擬合
是參數量, 是 token 數。作者在 1.2B、1× 上對 AdamW 重做一次完整的第一階段來驗證,用擬合式預測的超參數,loss 和真正找到的最佳值相差在 以內。接著用這套預測跑兩組更大的案例,一組是 1.2B 模型的 1× 到 8×,另一組是 130M、300M 一路讀到 16×。
最佳值隨規模的變化,從附錄的表格就看得到。AdamW 在 130M、1× 的最佳學習率是 0.008、權重衰減 0.1、批次 128 筆;到了 1.2B、1×,變成學習率 0.002、權重衰減 0.2、批次 256 筆。Muon 矩陣部分的學習率則從 0.016 降到 0.004(1.2B、1× 時改用 0.008,loss 還略低一些)。模型大約 9 倍,學習率小了 2 到 4 倍;拿 130M 調好的學習率直接用在 1.2B 上,基準就會吃虧。
加速比怎麼量
加速比用 token 數換算。對每個模型大小,先用 AdamW 在 1×、2×、4×、8× 的四個 loss 擬合一條曲線
某個優化器用 個 token 達到 loss ,就在 AdamW 的曲線上反解,AdamW 要達到同一個 需要 個 token。加速比就是 。
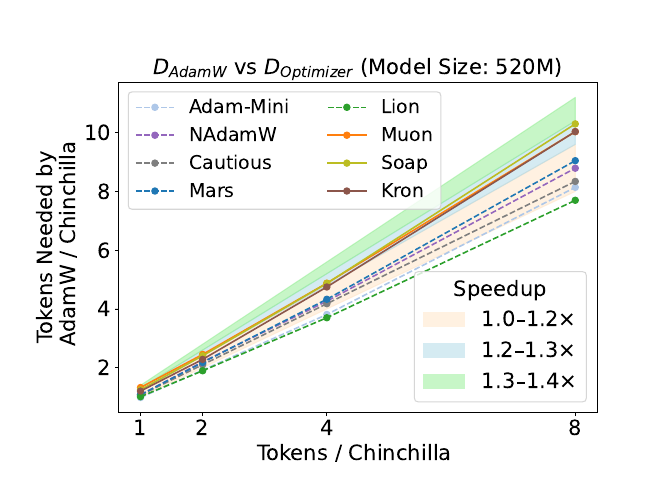
讀這張圖,看每條線離對角線多遠。如果某個優化器和 AdamW 一樣快,它的點會落在 上;點越往上,表示 AdamW 要多讀越多 token 才追得上。在 520M 上,實線的矩陣型優化器大致落在 1.2 到 1.4 倍的色帶裡,而且資料量越大,線往上翹得越明顯。
討論
主結果:最多 1.4 倍,而且越大越少
整理三個模型大小、四種資料量的結果,有四個規律。
- 沒有任何方法達到 2 倍。對調好的 AdamW,最高約 1.4 倍。SOAP 是少數自己認真調過基準的論文,它宣稱的 1.4 倍和這裡量到的最接近,在 300M、520M 上實際是 1.2 到 1.3 倍。
- 矩陣型勝過純量型。每個模型大小下,Muon、SOAP、Kron、Scion 都壓過純量型的優化器。1× 時 Muon 最好,到了 8×,SOAP 和 Kron 追上並超過。矩陣型的加速比隨資料量增加,隨模型變大而減少。
- 純量型調好後都和 AdamW 差不多,平均加速不到 1.2 倍。NAdamW、MARS、Cautious 這些降低變異數的變體小幅勝過 AdamW。
- 省記憶體的 Lion 和 Adam-mini 緊跟 AdamW,最多慢 5%,偶爾稍快。模型變大時,Lion 落後得越來越多,Adam-mini 反而越追越近。
附錄裡每個設定的最佳 loss 可以直接看出差距有多小,節錄幾格:
| 優化器 | 130M、1× | 520M、8× | 1.2B、8× |
|---|---|---|---|
| AdamW | 3.529 | 2.913 | 2.752 |
| NAdamW | 3.531 | 2.907 | 2.749 |
| Lion | 3.552 | 2.915 | — |
| Muon | 3.464 | 2.906 | 2.748 |
| SOAP | 3.483 | 2.899 | 2.749 |
本文整理,取自原論文附錄 C、D、E 各設定的最佳設定列;C4/EN 驗證 loss,越低越好。1.2B 只跑了四個優化器。
130M、1× 時,Muon 比 AdamW 低 0.065,是整張表最大的差距。到了 1.2B、8×,四個優化器擠在 0.004 之內。
1.2B:降到 1.1 倍
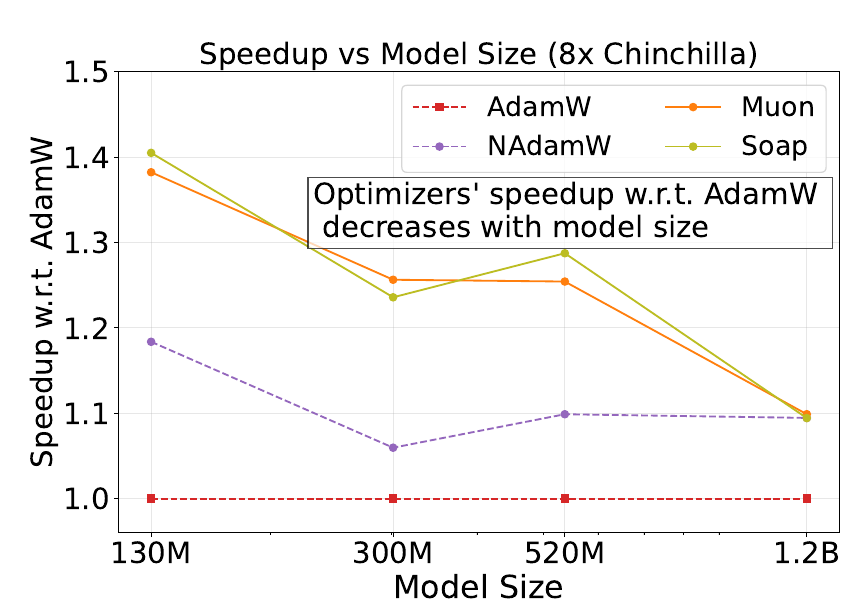
這張圖固定在 8× Chinchilla,看加速比怎麼隨模型大小變化。SOAP 和 Muon 在 130M 時都接近 1.4 倍,到 1.2B 只剩約 1.1 倍,和 NAdamW 幾乎一樣。
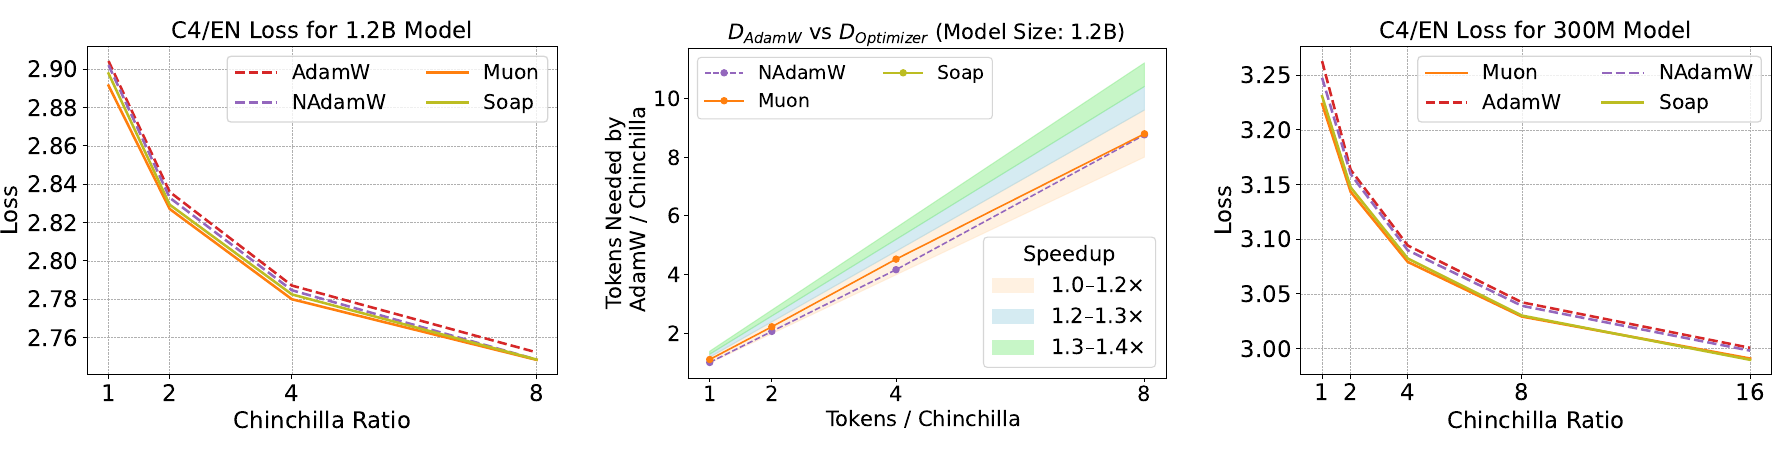
左圖是 1.2B 的 loss。NAdamW、Muon、SOAP 仍然比 AdamW 快,但三者之間幾乎沒有差距;中圖換算成加速比,大約 1.1 倍。下游評測也看不出差別,8×(193B token)時十項任務平均 AdamW 67.15、NAdamW 66.70、Muon 66.98。
作者用 16 次訓練擬合了 AdamW 與 Muon 的 scaling law,,並預測到了 7B、1× 時,Muon 的 loss 反而會比 AdamW 高。照附錄的係數算,7B、1× 時 AdamW 是 2.5706、Muon 是 2.5729,相差 0.002,比 Muon 那條擬合本身 0.005 的 RMS 誤差還小。這個預測是在擬合範圍外推 6 倍,能說的是 Muon 的優勢在這條線上會縮到看不見,誰勝誰負還說不準。
右圖延伸到 16× Chinchilla。8× 時 SOAP 已經在 130M 和 520M 上超過 Muon,作者在 300M 讀到 16× 再確認一次,SOAP 仍然勝出,130M 也一樣。他們猜測 SOAP、Kron 保留的二階動量,在資料量大時更有用。不過附錄表格裡,300M、16× 的最佳 loss 是 SOAP 2.990、Muon 2.991,只差 0.001,比他們自己座標下降時「算作改善」的門檻 0.003 還小。這一段更穩當的讀法是,資料量拉高之後,Muon 原本的領先消失了。
早期曲線會騙人
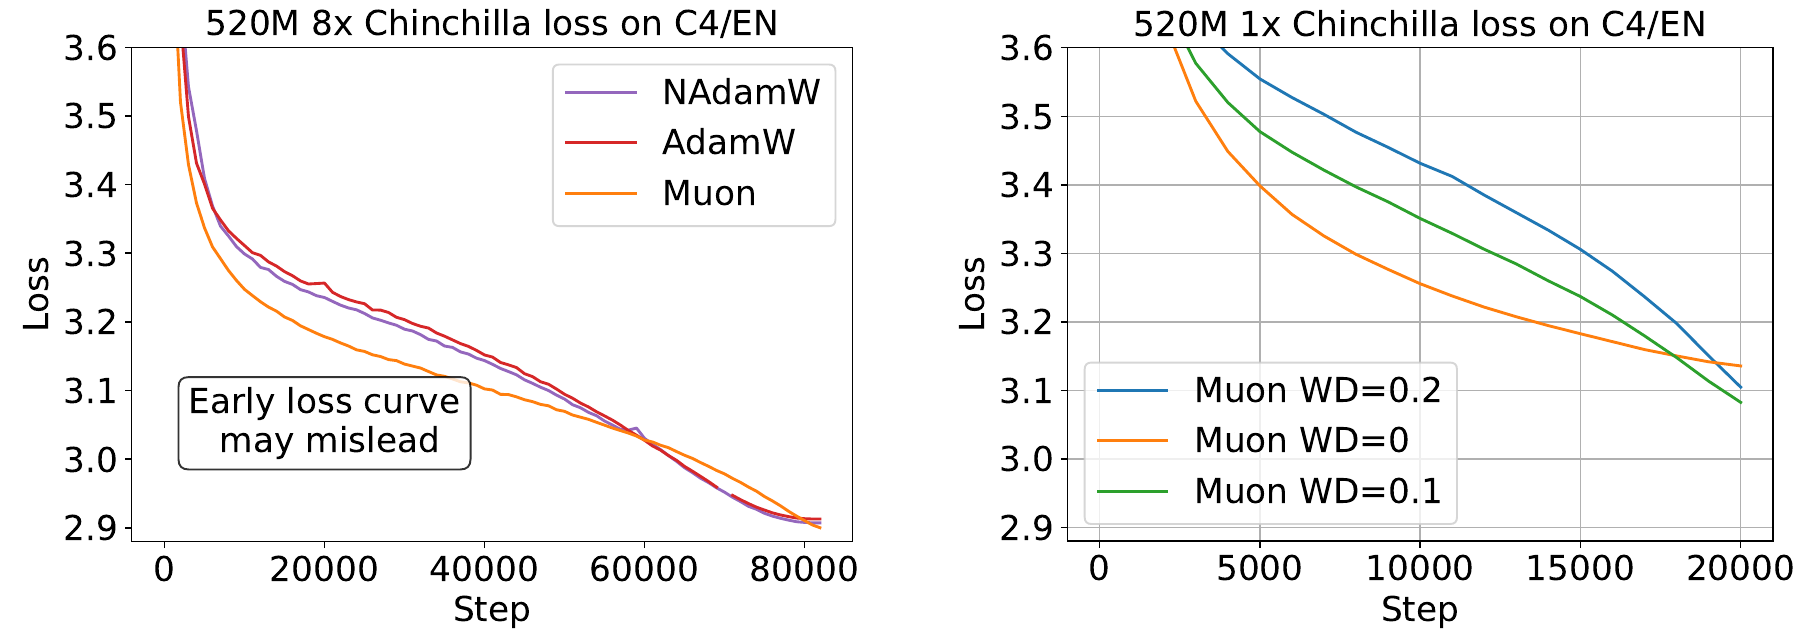
左圖是 520M、8× 的完整訓練曲線。Muon 前半段大幅領先,如果在第 3 萬步停下來比,看起來快得多;學習率開始大幅衰減之後,AdamW 和 NAdamW 追了上來,約 6 萬步時三條線交會,終點幾乎一樣。
右圖是同一個優化器換三種權重衰減。不加權重衰減的 Muon 前期最快,後面卻停滯,最後是三者中最差的;權重衰減 0.1 的終點最好。
所以作者建議只比最終 checkpoint。他們在這裡點名 Kimi 那篇 Muon 論文,那份報告比較 Muon 與 AdamW 的 MoE 模型時,用的正是學習率還沒衰減完的中途 checkpoint。
同一節還有兩個觀察。
- 只差一個超參數就能翻轉排名。520M、8× 時,SOAP 的學習率設成最佳值的 2 倍,它對 MARS 的領先就幾乎消失。作者統計了只改一個超參數、loss 仍在最佳值 0.02 以內的所有訓練,Muon、SOAP、MARS 三者的分布彼此重疊。沒有系統掃描,排名幾乎可以是任意的。
- 最佳權重衰減因優化器而異。前面提過 Lion 約 0.6;Kron 約 0.5,這是它能贏過 AdamW 的關鍵。
先前那些「2 倍」從哪來
附錄 G 逐一對照了先前論文的設定,找出加速被高估的原因。
- Sophia(2 倍):峰值學習率低於 6e-4。原因之一是當時使用的 Levanter 資料載入沒有完全隨機打亂,作者重現時發現,完全打亂才能穩定使用大學習率。在他們的設定下,Sophia 在 0.5B 以下沒有顯著加速。
- MARS(2 倍):基準和 Sophia 類似。MARS 論文第一版的圖其實已經顯示,把 AdamW 的學習率拉到 3e-3 會大幅變好。
- Muon(2 倍):NanoGPT speedrun 上是約 1.3 倍。Kimi 量到 2 倍,但他們的 AdamW 學習率偏低,400M 到 1.5B 只用 8e-4 到 9e-4;MoE 的比較又取在學習率未完全衰減時。Essential AI 的獨立研究量到的 token 效率是 1.1 到 1.2 倍。
- SWAN、DION(2 到 3 倍):在少於 1× Chinchilla 的區間比較,那裡的加速本來就比較大;DION 主打的通訊成本,這篇沒有計入。
- SPlus(2 倍):用的是固定學習率,不衰減,這不是一般預訓練的設定。
同期的另一份評估
比 Fantastic 早一天,EPFL 的 Semenov、Pagliardini 與 Jaggi 也在 arXiv 發表了 Benchmarking Optimizers for Large Language Model Pretraining。他們訓練了約 2,900 個模型,花了約 3 萬 GPU 小時,同樣比較 11 種方法,模型從 124M 到 720M,另有一個 520M 的 MoE;資料是 FineWeb,序列長只有 512,批次從 1.6 萬到 200 萬 token 不等。
兩邊有不少共識,例如權重衰減不能是 0、學習率要衰減到夠低,MARS 這類降低變異數的 AdamW 變體確實有用。最大的分歧在矩陣型優化器。Semenov 等人發現 AdEMAMix 與 MARS 勝過 Muon,在 720M、每批 100 萬 token 時兩者遙遙領先;Fantastic 的結果卻是 Muon 明顯勝過 MARS。
Fantastic 在相關研究一節自己分析了原因。
- 批次大小:Semenov 等人在 124M 上調得最仔細的實驗,每批只有 1.6 萬與 13 萬 token;Fantastic 調出來的批次都不小於約 40 萬 token。MARS、AdEMAMix 會對梯度做平均、降低雜訊,在雜訊主導的小批次區間占優勢,批次一大,這個優勢就縮小了。
- 硬體:EPFL 看起來主要用 1 到 8 張 H100,小批次比較划算;Fantastic 用 128 顆 TPU,大批次才能把平行度用滿。
- 調參:在 520M 左右的規模,Fantastic 掃到的最佳學習率是 4e-3 到 8e-3,EPFL 用的是 1e-3 到 2e-3,有些是從小模型直接搬過來沒重調;Fantastic 還把 Muon 的嵌入層與矩陣權重分開調學習率。
兩份研究也有呼應的地方。EPFL 發現 Lion 和 Signum 加大批次後明顯改善,模型一大又跟不上;Muon 加上權重衰減的版本在所有設定下都穩定,原版 Muon 則隨模型變大而退步。
更大的規模
1.2B 這個上限,論文自己也列為限制。2026 年 7 月,NVIDIA 的 SOAP, Muon, and Beyond: Pushing LLM Pretraining Scales 把比較推到數十億參數。
他們的設定和 Fantastic 差很多。
- 模型與資料:8B dense,以及 30B 總參數、3B 啟用和 72B 總參數、8B 啟用的 MoE;讀 1 兆到 3 兆 token。
- 批次:基準是每批約 2,500 萬 token,再放大到 2 倍、3 倍、4 倍,摘要提到最高約 1 億 token。
- 調參方式:AdamW 用的是 Nemotron 原本的生產配方,Muon 和 SOAP 的學習率主要靠 Kimi 的更新 RMS 對齊轉換過來,放大批次時再按平方根規則調學習率,沒有像 Fantastic 那樣逐一掃描。
結果是 Muon 與 SOAP 一致勝過 AdamW,差距在大批次時最明顯。批次加大後 AdamW 退化,Muon 仍然穩定。在 30B 的 MoE 上,同樣的批次下 Muon 的下游成績大多持平或較高,例如 MMLU-Pro 58.19 對 54.45、數學類平均 82.52 對 79.65;72B 的 MoE 用 2 倍批次的 Muon 對 1 倍批次的 AdamW,程式類平均高 4.5,數學類平均卻低了 3.2。SOAP 修好大批次下的不穩定後,loss 略低於 Muon,他們建議記憶體允許時優先用它。
這兩份結果可以並存。Fantastic 量的是在 AdamW 用得舒服的批次(約 50 萬到 100 萬 token)下、徹底調好之後的 token 效率;NVIDIA 量的是把批次推到遠超過 AdamW 臨界批次大小時,誰還撐得住。Essential AI 在 100M 到 4B 上看到的情況也一樣,Muon 達到同樣 loss 少用 10% 到 15% 的 token,而且這個優勢在批次加大時維持或擴大。
其他觀察與限制
所有優化器還有幾個共同現象。有權重衰減時,參數範數都隨學習率排程先升後降;學習率衰減期間梯度範數會上升,但 loss 沒有跟著變差;各優化器的訓練 loss 和驗證 loss 走勢一致,看不出誰的泛化特別好。
限制方面,作者明確寫出最大只到 1.2B。其他條件也要一起記住。這篇只比 token 效率,不算牆鐘時間與通訊;只有一套資料配方與 dense Llama 架構;批次都在數十萬 token 以上。
結論
這篇論文用三階段調參,讓 11 個優化器各自接近最佳,再在 130M 到 1.2B、1× 到 8× Chinchilla 上換算 token 效率。調好之後,最快的矩陣型優化器在小模型上約 1.3 到 1.4 倍,到 1.2B 只剩約 1.1 倍;純量型和 AdamW 差不多。先前的 2 倍大多來自弱基準與中途 checkpoint。
讀優化器論文時,先確認 AdamW 的學習率有沒有掃過、比較的是不是訓練結束的 checkpoint,以及實驗跨了幾種模型大小和資料量。自己換優化器之前,也先把 AdamW 的學習率、權重衰減和暖身掃一遍;如果起點是 GPT-3 配方那種偏低的學習率,光這一步就可能省下一半的步數。
至於怪獸的產地,看 NVIDIA 2026 年的結果,大概在批次 2,500 萬 token 以上的地方。