原論文
The Marginal Value of Adaptive Gradient Methods in Machine Learning
- 発表先
- NeurIPS 2017国際会議
- arXiv への初回投稿
- arXiv:1705.08292
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizersmarginalvalue2017,
  title = {{The Marginal Value of Adaptive Gradient Methods in Machine Learning}},
  author = {Ashia C. Wilson and Rebecca Roelofs and Mitchell Stern and Nathan Srebro and Benjamin Recht},
  year = {2017},
  eprint = {1705.08292},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1705.08292}
}
「These results suggest that practitioners should reconsider the use of adaptive methods to train neural networks.」
これはこの論文の要旨の最後の一文で、ニューラルネットワークの訓練に適応的手法を使うかどうか、考え直すよう勧めている。
2017 年 5 月、Adam は発表からまだ 2 年あまりだったが、論文自身の序論には、Adam はすでに多くの深層学習フレームワークでデフォルトのアルゴリズムになっていると書かれている。当時は二つの説が広まっていた。一つは、AdaGrad、RMSProp、Adam のような適応的手法は収束が速いということ。もう一つは、ハイパーパラメータの調整がほとんどいらないということだ。UC Berkeley の Ashia Wilson、Rebecca Roelofs、Mitchell Stern、Benjamin Recht と、TTIC の Nathan Srebro は、この二つの説をどちらも検証にかけた。
彼らはまず単純な分類問題を構成した。その上で SGD のテスト誤差率は 0 なのに、適応的手法は半分近くを間違える。続いて画像分類、文字レベルの言語モデル、2 種類の構文解析で実験し、結論はどれも、よく調整した SGD の勝ちだった。
このノートでは、まずその構成例を分解し、次に実験と彼らのハイパーパラメータ調整のやり方を見て、最後に、2 年後に別のグループが同じコードを使い、差が見えなくなるまで調整した話を見る。
問題の定義
深層ネットワークのパラメータ数はふつう訓練サンプル数よりはるかに多く、訓練損失を 0 にできる解は一つではなく、広い範囲に広がっている。オプティマイザが最終的にどれに止まるかは、それがたどる経路で決まる。訓練セットでは同じくらい良い解でも、新しいデータでは大きく違うことがある。
この論文が問うのは、このような状況で適応的手法と SGD が異なる解を選ぶのか、そして選んだ解の汎化性能に差があるのか、だ。
比較のために、論文はまず各手法を同じ枠組みに書き込んでいる。SGD はそのまま勾配に沿って進み、適応的手法は勾配の前に対角行列の逆行列を掛ける。
の選び方で AdaGrad、RMSProp、Adam のどれになるかが決まり、モーメンタム項は別に加える。SGD は に相当し、パラメータ空間のもともとの の幾何を使う。適応的手法は過去の勾配に応じて、座標ごとに物差しを取り替える。
問題の解決
SGD は最小ノルム解を見つける
まず最も単純な場合として、最小二乗法で二値分類をする。
のとき、損失を 0 にする解が一つでもあれば、解は無限にある。
SGD の勾配はどれも の形で、 の行空間に入っている。 から出発し、勾配と過去の反復点の線形結合だけを使う限り、この空間から出ることはない。行空間の中で を満たす解は一つだけで、、ちょうどすべての解の中で ノルムが最小のものであり、マージン(margin)が最大のものでもある。
だから SGD、モーメンタム、ミニバッチ SGD、Nesterov、さらには共役勾配法まで、最後はすべて同じ点にたどり着く。論文は、勾配降下法が自然に最大マージン解を見つけるのは、うれしい偶然だと述べている。
適応的手法は符号解を見つける
適応的手法は分母が座標ごとに違うので、行空間という制約がなくなる。一般の場合にどこへ収束するかを計算するのは難しく、論文は計算できる特殊な場合を選んだ(Lemma 3.1)。
スカラー が存在して となるなら、 から出発した AdaGrad、Adam、RMSProp はいずれも一意の解 に収束する。
証明の考え方は素直だ。 が に比例しているとき、勾配は に比例し、分母 は に比例する。両者を割ると、各座標の更新量の大きさはすべて同じになり、違うのは符号だけだ。だから各ステップのあとも は に比例したままで、帰納的に結論が得られる。
言い換えると、この特殊な場合では、適応的手法はどの特徴量も同じくらい重要なものとして扱い、どの重みの絶対値も等しくなる。論文の言い方では、適応的手法は ノルムの小さい解に収束し、SGD は ノルムの小さい解に収束する。
間違えさせるデータを作る
次に論文は、この違いがテスト誤差率として現れるようなデータを設計した。
各サンプルのラベル は確率 で 、それ以外は だ。特徴ベクトルはとても長く、最初の 3 次元とそれ以降に分けて見る。
- 第 1 次元はラベルそのもので、。
- 第 2、3 次元は常に 1。
- それ以降は各サンプルがそれぞれ自分専用の特徴量を持ち、正例は 1 個、負例は 5 個で、値はどれも 1。
本当に役に立つのは第 1 次元だけだ。第 2、3 次元は定数で、それ以降の特徴量はそれぞれ一つのサンプルにしか現れない。これらは訓練セットではとても識別力があるように見え、どれも特定のサンプルを「見分け」られるが、新しいサンプルにはまったく役に立たない。
このデータはちょうど Lemma 3.1 の条件を満たし、 になる。訓練サンプルを 10 個(正例 6、負例 4)とって実際に計算すると、 から出発した勾配降下法も Adam も訓練損失を 0 まで下げ、学習した重みは次のようになる。
| 特徴量 | SGD | Adam |
|---|---|---|
| 第 1 次元(ラベル) | 0.756 | 0.25 |
| 第 2、3 次元(定数) | 0.087 | 0.25 |
| 正例の専用特徴量 | 0.070 | 0.25 |
| 負例の専用特徴量 | −0.084 | −0.25 |
本稿での試算。SGD の列は最小ノルム解で、勾配降下法を収束まで反復した結果は解析解と一致する。Adam の列はデフォルトの 、学習率 で 2 万ステップ反復したもので、AdaGrad でも同じ重みになる。
SGD は重みの大部分を第 1 次元に置く。Adam はどの特徴量にも同じ大きさの重みを与え、符号はその特徴量が訓練セットでラベルとどう関係していたかに従う。
ここで新しいサンプルが来たとする。その専用特徴量はまったく新しく、訓練中に一度も現れていないので、 と重なるのは最初の 3 次元だけだ。
- SGD:スコアは 。正例は 、負例は で、どちらも正しく分類される。
- Adam:スコアは 。正例は 、負例は で、どちらも正例と判定される。
このデータでは、適応的手法は見たことのないサンプルをすべて正例とラベル付けするので、テスト誤差率は負例の割合 になる。 が に近いほど誤差率は半分に近づき、SGD の誤差率は 0 だ。付録では、これを固定の分布からサンプリングする版としても書いていて、結論は同じだ。
この例の次元は本当に無限である必要はなく、論文によれば 次元で十分だ。そして深層ネットワークでは、パラメータ数がサンプル数の 25 倍以上になることも珍しくない。著者らの解釈では、実データにも、頻繁に現れて本当に役に立つ少数の特徴量と、大量のスパースな特徴量があることが多い。有限の訓練セットでは、スパースな特徴量はサンプルをよく見分けられるように見えるが、実際には過学習にすぎない。
Lemma 3.1 の仕組みから見ると(これは本稿の解釈だ)、適応的手法の分母は各座標自身の過去の勾配から来ているので、めったに現れないスパースな特徴量は分母が小さく、相対的に歩幅が大きくなる。最後には本当に役に立つ特徴量と同じ大きさの重みまで押し上げられ、まさにこの問題を増幅してしまう。
この構成には前提がある。 から出発すること、データが という特殊な構造を満たすことが必要で、分析では分母の も外している。これが証明したのは「適応的手法の汎化はとても悪くなりうる」ことで、ニューラルネットワークで実際に起きるかどうかは、実験を見る必要がある。
議論
実験設定
論文は、非適応的な手法二つ(SGD、モーメンタムを 0.9 に固定した heavy-ball、以下 HB)と、適応的な手法三つ(AdaGrad、RMSProp、Adam)を比べ、さらにすべてデフォルト値のままの Adam を 1 本加えている。四つのタスクはどれもネット上で見つかるコードを使い、アーキテクチャや前処理はできるだけ変えていない。
| タスク | モデル | データ |
|---|---|---|
| 画像分類 | VGG+BN+Dropout | CIFAR-10 |
| 文字レベル言語モデル | 2 層 LSTM | 『戦争と平和』 |
| 識別的構文解析 | 2 層 LSTM+フィードフォワード | Penn Treebank |
| 生成的構文解析 | 3 層 LSTM | Penn Treebank |
原論文 Table 2 をもとに整理。四つのコードは Torch、DyNet、TensorFlow の三つのフレームワークを使っており、最初の二つのタスクはどちらも Torch。
構文解析とは、文を入れ子になった節、句、単語の木構造に分解することだ。識別的なやり方は、木の構築を一連の動作の系列予測に変換し、F1 で評価する。生成的なやり方は、木を深さ優先でたどった系列として書き、言語モデルとしてスコアを付け、パープレキシティで評価する。
各設定はランダムな初期化から 5 回ずつ実行する。訓練のエポック数はあらかじめ固定し、検証セットのあるタスクでは、予算内で検証の成績が最も良い設定を選ぶ。CIFAR-10 は別に検証セットを切り出していないので、代わりに訓練損失が最も低い設定を選ぶ。
ハイパーパラメータの調整
著者らは、影響が最も大きいハイパーパラメータは初期学習率と減衰のさせ方の二つだと見て、この二つだけを調整し、ほかは各フレームワークのデフォルト値のままにした。
学習率は対数スケールで 5 点をとる。最良の点が端に来たら外側に点を追加し、最良の値が真ん中に来るまで続ける。たとえば 2、1、0.5、0.25、0.125 を試して 2 が最良なら 4 も試し、4 がさらに良ければ 8 を試す。減衰のさせ方は 2 種類ある。
- dev-decay:これまでの最良の検証成績を記録し、あるエポックでそれを更新できなければ、学習率に を掛ける。
- fixed-decay: エポックごとに を掛ける。
著者らは、検証セットがあるなら dev-decay を勧めている。ハイパーパラメータが少なく、結果も fixed-decay に劣らない。付録には各手法で試した学習率が載っている。CIFAR-10 を例にとると、SGD の最良は 0.5、Adam の最良は 0.0003 で、デフォルトの 0.001 より 3 倍以上小さい。
CIFAR-10
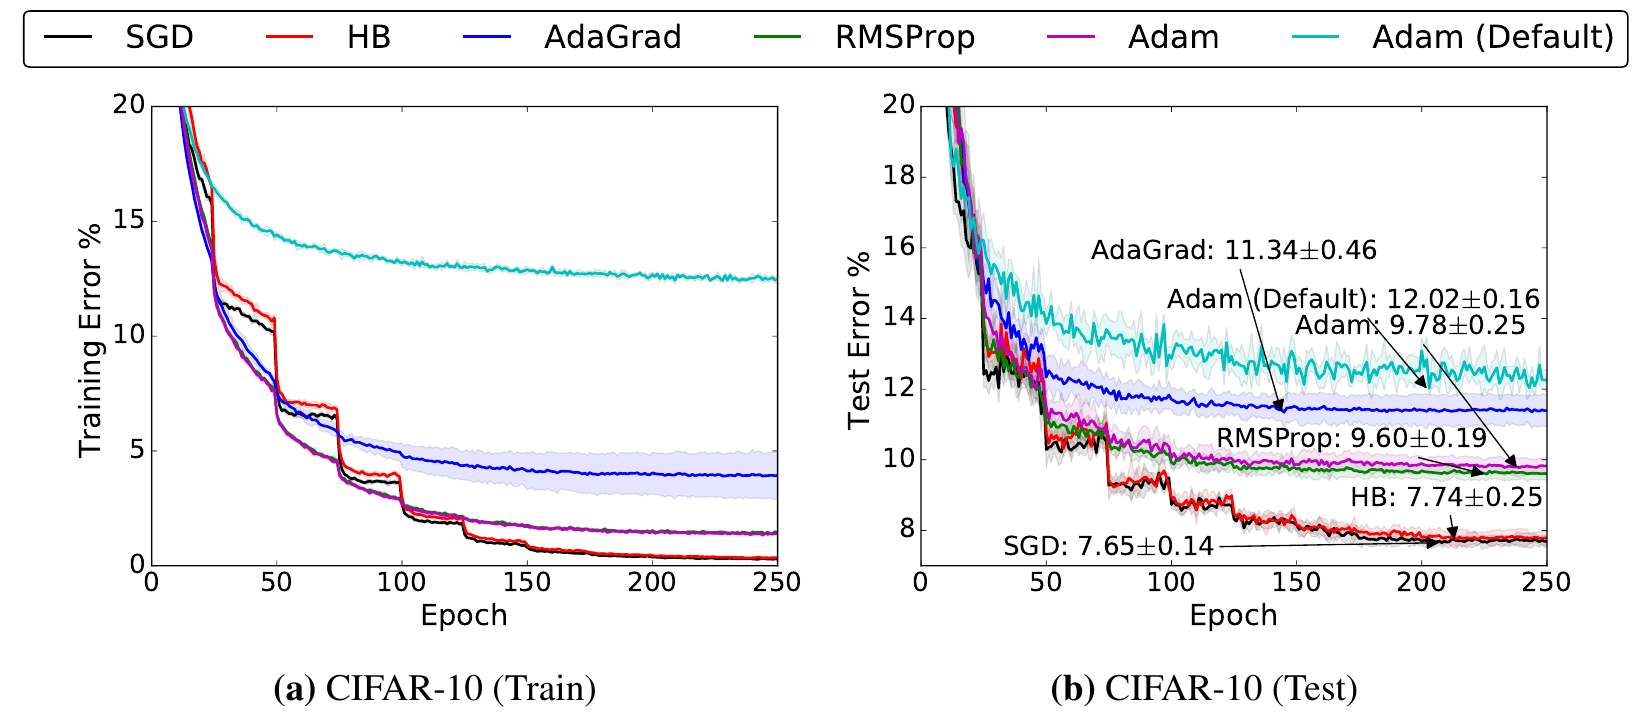
モデルは Torch のブログに載っていた VGG+BN+Dropout で、もとのテスト誤差率は 7.55% だ。右図には各手法の最良のテスト誤差率が示されている。SGD は 、適応的手法で最良の RMSProp は 、調整した Adam は 、デフォルトの Adam は だ。
時間の流れに沿って見ると、もっと面白い。最初の 50 エポックでは、適応的手法の訓練誤差率がはっきりリードしていて、テスト誤差率は SGD や HB と互角だ。第 50 エポックあたりから、適応的手法の訓練誤差率はまだ低いのに、SGD と HB のテスト誤差率が先行しはじめる。第 100 エポックになると、SGD と HB が訓練でもテストでも勝っている。左図で SGD と HB が 25 エポックごとに一段下がっているのは、学習率の減衰だ。2 年後にこの実験をやり直した Choi らが記録した設定は、25 エポックごとに学習率に 0.5 を掛けるものだった。適応的手法の曲線は、同じ位置でははるかに平らだ。
著者らは、適応的手法の学習率を大きくすることも試した。最初の 50 エポックでは確かに良くなるが、その後の停滞がよりひどくなり、どんな減衰のさせ方でも取り戻せなかった。
三つの言語タスク
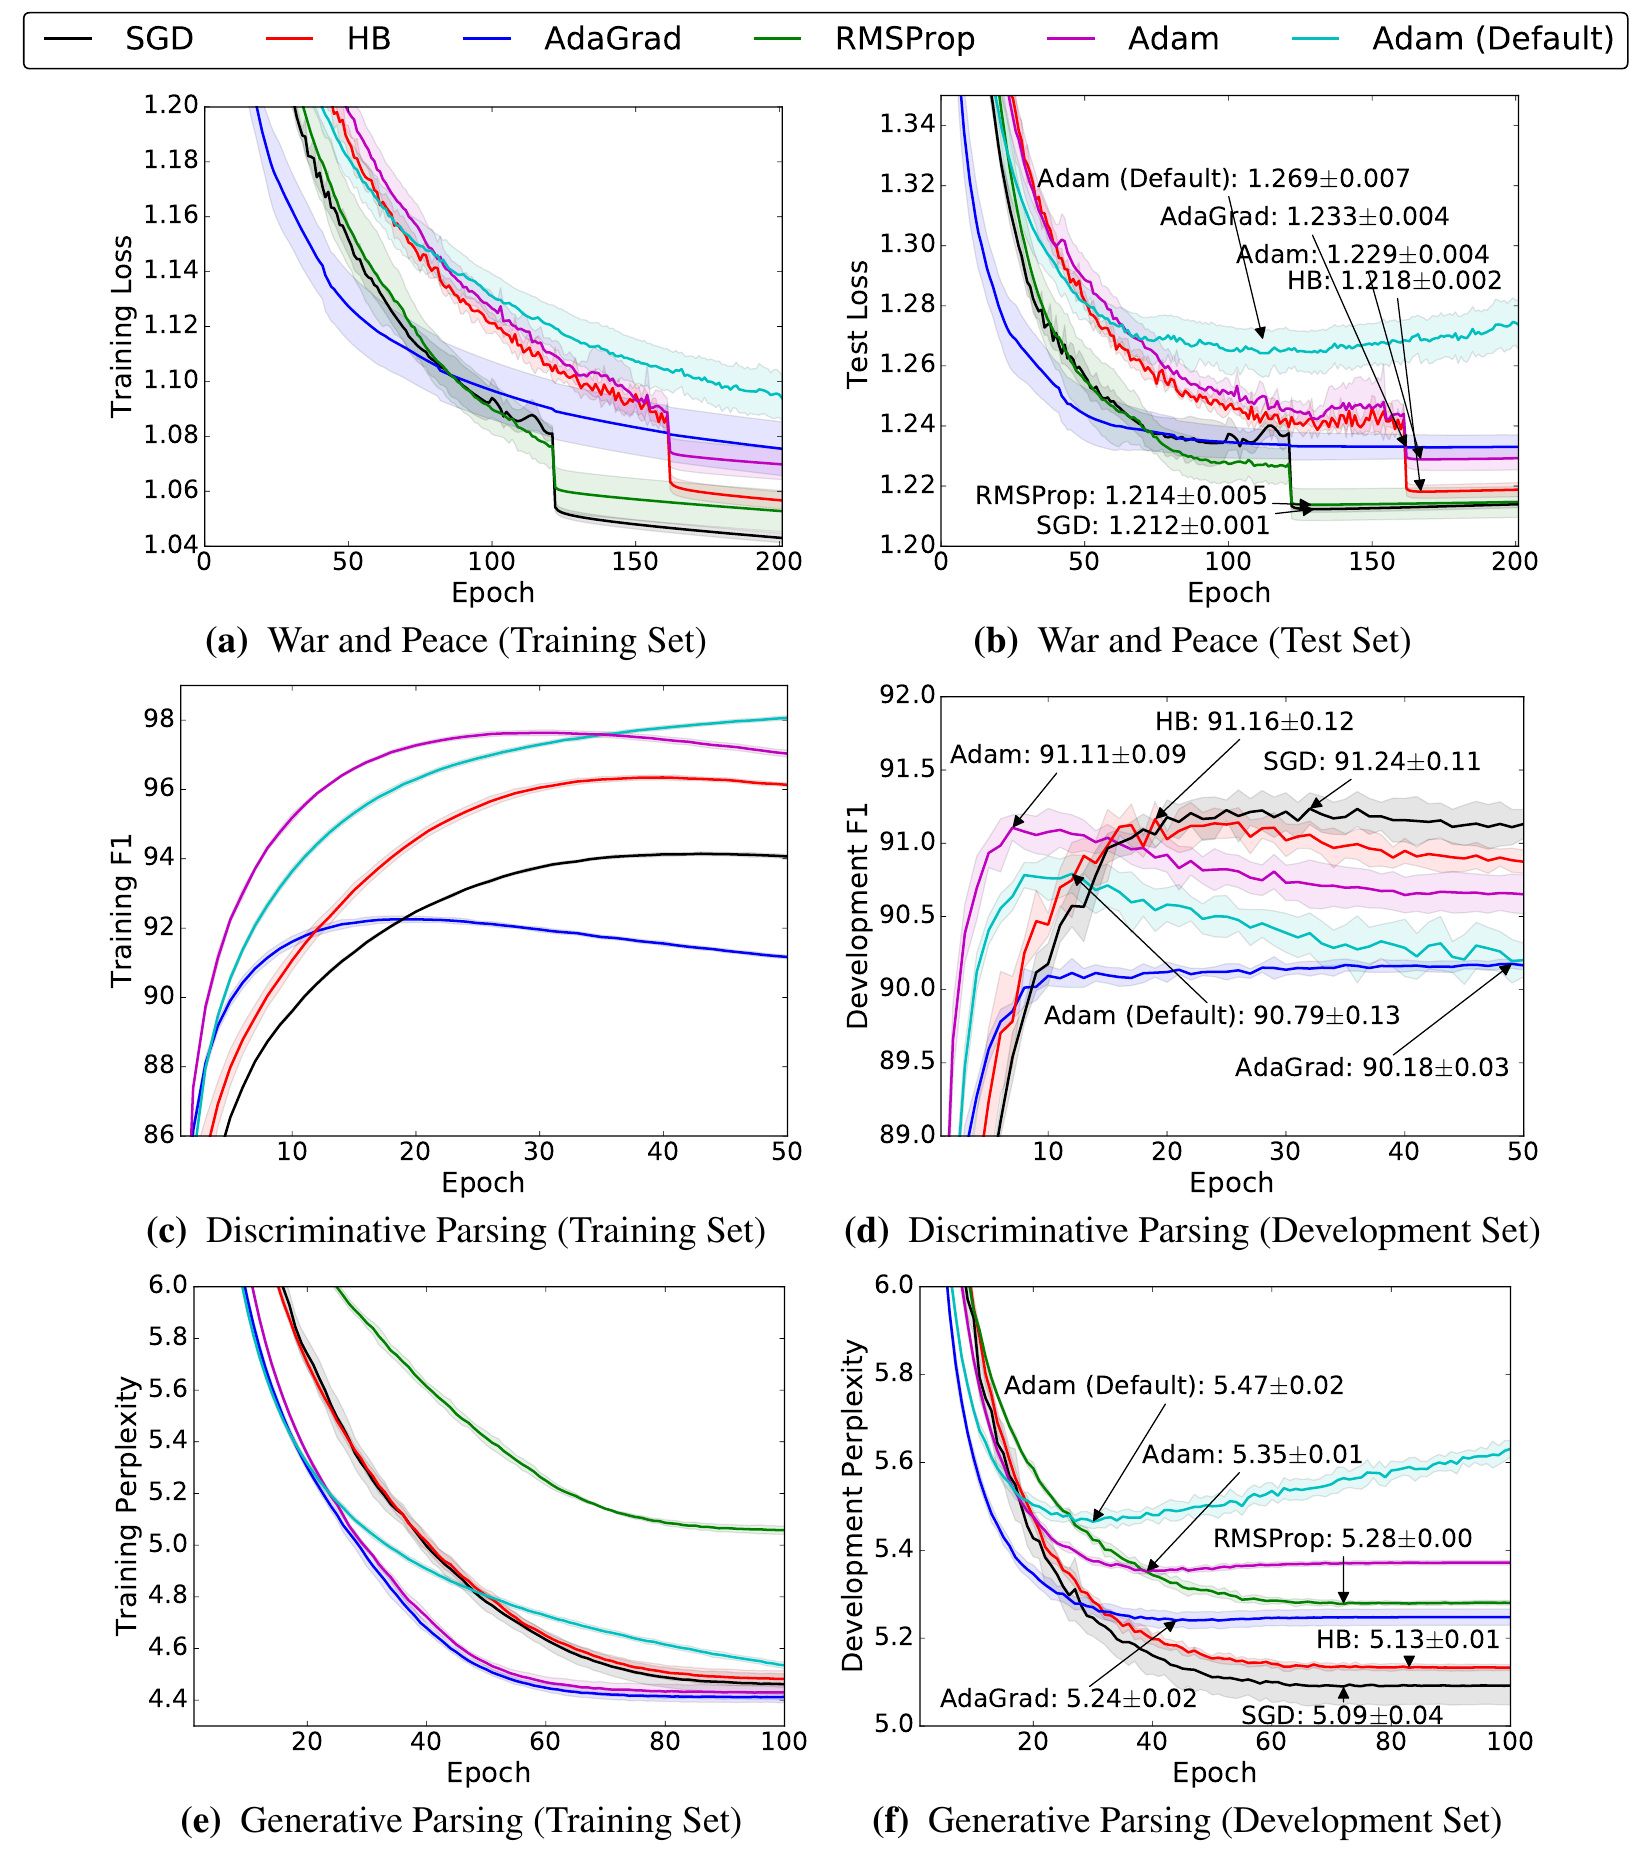
各行の左が訓練セット、右が検証セットまたはテストセットで、示されているのは各手法の最良値だ。
- 文字レベル言語モデル(1 行目)。torch-rnn で『戦争と平和』の全文を 200 エポック訓練する。テスト損失が最も低いのは SGD の で、RMSProp が でぴったり後に続く。著者らはわざわざ、これは適応的手法でも汎化の良い解を見つけうることの証明だと説明している。fixed-decay の探索からはもう一つ発見があり、AdaGrad 以外のすべての手法で、最良の設定は訓練が 60% か 80% まで進んだところで一度だけ学習率を 10 で割るものだった。
- 識別的構文解析(2 行目)。Cross と Huang のパーサを Penn Treebank で 50 エポック訓練し、dev-decay の 。当時の DyNet には RMSProp がなかった。検証 F1 が最も良いのは SGD の 91.24 で、HB と Adam がすぐ後を追う。Adam はわずか 6 エポックで自身の最良値 91.11 に達するが、SGD がこの数字に追いつくには 18 エポック、91.24 に達するには 31 エポックかかる。その後、Adam は訓練セットでは良くなり続けるが、検証の成績は下がっていく。
- 生成的構文解析(3 行目)。Choe と Charniak のモデルで、計算を節約するため LSTM の隠れ次元を 1500 から 500 に、dropout を 0.7 から 0.5 に下げ、100 エポック訓練する。検証パープレキシティが最も良いのは SGD の 5.09。Adam の訓練曲線は最も良いグループに入るのに、検証パープレキシティは調整した手法の中で最も悪い 5.35 だ。
四つのタスクをまとめると、次の 4 点になる。
- 適応的手法が見つける解は、非適応的手法より汎化が悪い。
- 訓練損失が同じくらい低いか、さらに低くても、適応的手法の検証やテストの成績はやはり劣る。
- 適応的手法は最初のうち訓練セットで速く良くなるが、検証の成績はすぐに頭打ちになる。
- 学習率と減衰を調整すると、Adam はどのタスクでもはっきり改善する。デフォルト値の Adam は 4 枚の図すべてで最下位かそれに近く、「Adam は調整がいらない」という説は成り立たない。
著者らは結論で、Adam がなぜいまだにこれほど人気があるのか、よくわからないと述べている。ほかの研究者と話したうえでの推測は、Adam は GAN や関数近似を組み合わせた Q 学習で特に人気があり、この二つは厳密には最適化問題を解いているわけではないので、Adam のダイナミクスがたまたまそれに合っているのかもしれない、というものだ。
を調整して、もう一度比べる
2 年後、トロント大学と Google Brain の Dami Choi、Christopher Shallue、George Dahl らが、〈On Empirical Comparisons of Optimizers for Deep Learning〉でこの論文に応えた。
彼らの出発点は、オプティマイザどうしの包含関係だ。モーメンタムを 0 にすれば SGD になるので、最良に調整したモーメンタムが最良に調整した SGD に負けることはありえない。Adam もモーメンタムを模倣できる。 を 0 にし、 をとても大きく調整すれば、分母 はほぼ定数 になり、さらに学習率のスケジュールでバイアス補正を打ち消せば、Adam の更新はモーメンタム付き SGD になる。だから、すべてのハイパーパラメータを調整するなら、Adam がモーメンタムより劣るはずはない。
Wilson らは学習率と減衰しか調整しておらず、 は各フレームワークのデフォルト値のままだった。構成例の分析でも は外している。Choi らは、Wilson らが公開した CIFAR-10 のコードでやり直した。
- もとのやり方どおり学習率だけを掃引すると、RMSProp と Adam が劣るという結果が再現された。
- ランダムサーチでモーメンタム関連のパラメータと も調整すると、SGD、モーメンタム、RMSProp、Adam の四つのテスト誤差率はほぼ同じになった。
- 自分たちのコードに替えて学習率スケジュールを探索しても、四つは誤差の範囲に収まった。
彼らはまた、Wilson らが CIFAR-10 で訓練損失を使って設定を選んでいたことにも気づき、検証セットで選ぶように変えたが、結論は変わらなかった。 というパラメータの影響は想像より大きく、四つのタスクで見つかった最良の は 10 桁にわたっていた。
二つの論文の結論をどう両立させるかについては、Choi ら自身が説明している。「デフォルトの の Adam」と「 を調整した Adam」を二つの異なるオプティマイザとみなせば、結論は矛盾しない。ここはもう一歩考えておきたい。 を大きくした Adam は、分母の適応的な効果も薄まり、モーメンタム付き SGD にどんどん近づく。Choi らが Wilson のコードで Adam の を調整したとき、最終的な探索範囲は から で、勾配のスケールより何桁も大きく、分母はほぼ定数だった。だから二つの論文を合わせると、こう読める。デフォルト設定での適応的な更新は確かに汎化が悪くなることがある。そして Adam を SGD に負けないところまで調整したハイパーパラメータの組は、その効き目の一部が、まさに Adam の適応性を弱めることから来ている。
ほかの反応
同じ時期には、この差に別の角度から取り組む流れもいくつかあった。
- 重み減衰を正しく書く。 2017 年 11 月、Loshchilov と Hutter はこの論文を引用し、Adam の汎化が悪い大きな原因は、L2 正則化が Adam の中では効いていないことだと考え、AdamW を提案した。
- 後半で SGD に切り替える。 Keskar と Socher の SWATS は、まず Adam で訓練し、ある条件が満たされたら SGD に切り替える。AdaBound は、Adam の各パラメータの学習率を次第に狭まる上下限で挟み、Adam から SGD へなめらかに移行させる。
- 大規模な比較のやり直し。 Schmidt らは 5 万回を超える訓練で 15 種類のオプティマイザを比べた。すべてのタスクで明らかに勝つものはなく、Adam は依然として強い選択肢だった。
逆方向の展開もあり、それが Transformer だ。Choi らは LM1B の Transformer 言語モデルで、はっきりした順位の差を見ている。Adam が目標の誤差率に達するのに必要なステップ数はモーメンタムの 60% だけで、同じ最終結果に達するのに必要なのは SGD の 25% だけだった。Zhang らは 2019 年、注意機構モデルの勾配ノイズが裾の重い分布になることが、SGD の成績が悪い原因の一つだと考えた。Kunstner らは 2023 年、バッチをデータセット全体まで大きくしていき、ノイズが減ると Adam のほうが SGD より大きく伸び、差はそれで縮まらないことを見出した。この論文の実験は 2017 年の CNN と LSTM までで、その結論をこうしたモデルにそのまま当てはめることはできない。
結論
この論文は構成例を使って、過剰パラメータ化された問題では、適応的手法と SGD が異なる解にたどり着くことを証明した。特定のデータ構造のもとでは、適応的手法が学習した解は新しいデータの半分を誤判定しうるのに、SGD は完全に正しい。四つの実験では、学習率と減衰だけを調整した場合、テストの成績はどれも SGD と HB のほうが良く、デフォルト値の Adam はさらにはっきり遅れをとった。2 年後、Choi らが同じコードでやり直し、 などのハイパーパラメータも一緒に調整すると、CIFAR-10 での差は消えた。
オプティマイザを比較する論文を読むときは、まずハイパーパラメータ調整の段落を探し、どのハイパーパラメータを、それぞれ何組調整し、何を基準に設定を選んだかを見よう。自分で比較するときも同じで、Adam は少なくとも学習率、学習率スケジュール、 を調整し、この論文の付録のように、各手法で実際に試したグリッドを書き出しておくこと。
Choi らが ImageNet で ResNet-50 を訓練したとき、最良の NAdam の は 9475 だった。もともとゼロ除算を避けるためだけの定数には、Wilson らのグリッドの中に居場所すらなかった。