原論文
LLaMA: Open and Efficient Foundation Language Models
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:2302.13971
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{transformersllama2023,
  title = {{LLaMA: Open and Efficient Foundation Language Models}},
  author = {Hugo Touvron and Thibaut Lavril and Gautier Izacard and Xavier Martinet and Marie-Anne Lachaux and Timothée Lacroix and Baptiste Rozière and Naman Goyal and Eric Hambro and Faisal Azhar and Aurelien Rodriguez and Armand Joulin and Edouard Grave and Guillaume Lample},
  year = {2023},
  eprint = {2302.13971},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2302.13971}
}
2023 年 2 月末、ChatGPT の公開からまだ三か月もたっていないころ、最強クラスの言語モデルはほぼすべて API の向こう側に閉じこもっていた。
GPT-3、Gopher、Chinchilla、PaLM はどれも重みを公開しておらず、訓練データの説明も「書籍 2TB」や「SNS の会話」のような一行だけ、ということがよくあった。重みを公開したモデルがなかったわけではなく、OPT、GPT-NeoX、BLOOM、GLM は公開されていた。ただ著者らの評価では、PaLM-62B や Chinchilla に並ぶものは一つもなかった。
Meta AI の Touvron、Lavril、Izacard、Grave、Lample らはこの論文で、70 億から 650 億パラメータの基盤モデル群 LLaMA を発表した。出た途端に注目を集めたのは、二つの主張のためだ。第一に、130 億パラメータの LLaMA-13B が、ほとんどのベンチマークで 1,750 億パラメータの GPT-3 に勝ち、推論は V100 一枚で動く。第二に、訓練データはすべて公開データセットから取り、重みも研究コミュニティに公開した(公開といっても実際は申請フォームの記入が必要だった。結局、一週間後にはネットのあちこちに出回っていた)。
問題の定義
前年、Chinchilla は、訓練の計算量が決まっているなら、最良の結果は最大のモデルではなく、より小さいモデルにより多くのデータを組み合わせたときに得られることを示した。その目標は、訓練の計算量を最も効率よく使うことだ。
著者らは、この目標が推論のコストを考えていないと指摘する。モデルをいったんデプロイすれば、推論の総コストは訓練よりはるかに大きくなることが多い。ある性能水準に達したいなら、得なのは推論が最も速いモデルで、訓練が最も速いモデルではない。大きなモデルをその水準まで訓練するほうが安くつくかもしれないが、小さいモデルを長めに訓練すれば、最終的に推論でずっと節約できる。
著者らは対照的な例を挙げる。Chinchilla の推奨に従えば、100 億パラメータのモデルは約 2,000 億 token で訓練すべきだ。ところが著者らは、70 億パラメータのモデルが 1 兆 token を見た後も、まだ性能が伸びていることを見つけた。
だからこの論文の目標は、さまざまな推論予算のもとで、それぞれ最も性能の高いモデルを訓練することだ。方法は、通常よりはるかに多くの token を見せることである。
いくつかのモデルについて、「1 パラメータあたり何 token 見たか」を計算してみよう。訓練 FLOPs はおよそ 、推論は 1 token あたりおよそ で、 はパラメータ数、 は訓練 token 数だ。
models = {               # パラメータ数, 訓練 token 数
    "GPT-3 175B":     (175e9, 300e9),
    "Chinchilla 70B": (70e9, 1.4e12),
    "LLaMA-7B":       (6.7e9, 1.0e12),
    "LLaMA-13B":      (13.0e9, 1.0e12),
    "LLaMA-65B":      (65.2e9, 1.4e12),
}
for name, (n, d) in models.items():
    train = 6 * n * d          # 訓練 FLOPs は約 6ND
    infer = 2 * n              # 推論は 1 token あたり約 2N FLOPs
    print(f"{name:15s} token/パラメータ {d / n:6.1f}  訓練 {train:.1e}  推論/token {infer:.1e}")

# GPT-3 175B      token/パラメータ    1.7  訓練 3.2e+23  推論/token 3.5e+11
# Chinchilla 70B  token/パラメータ   20.0  訓練 5.9e+23  推論/token 1.4e+11
# LLaMA-7B        token/パラメータ  149.3  訓練 4.0e+22  推論/token 1.3e+10
# LLaMA-13B       token/パラメータ   76.9  訓練 7.8e+22  推論/token 2.6e+10
# LLaMA-65B       token/パラメータ   21.5  訓練 5.5e+23  推論/token 1.3e+11
LLaMA-65B の比率は Chinchilla とほぼ同じで、どちらも 1 パラメータあたり約 20 token だ。この論文の主役は小さいモデルのほうで、LLaMA-7B は 1 パラメータあたり 150 近い token を見ており、Chinchilla の「最適」比率をはるかに超えている。もし LLaMA-13B が本当に GPT-3 に追いつけるなら、訓練の計算量は GPT-3 の四分の一で、1 token あたりの推論コストに至っては約十三分の一で済む。
問題を解く
公開データだけを使う
| データソース | サンプリング比率 | 1.4T token 訓練時のエポック数 | ディスクサイズ |
|---|---|---|---|
| CommonCrawl | 67.0% | 1.10 | 3.3 TB |
| C4 | 15.0% | 1.06 | 783 GB |
| GitHub | 4.5% | 0.64 | 328 GB |
| Wikipedia | 4.5% | 2.45 | 83 GB |
| Books | 4.5% | 2.23 | 85 GB |
| ArXiv | 2.5% | 1.06 | 92 GB |
| StackExchange | 2.0% | 1.03 | 78 GB |
原論文 Table 1 をもとに整理。
出どころごとに、処理の仕方が違う。
- CommonCrawl:2017 年から 2020 年までの五つのスナップショット。CCNet のパイプラインで行単位の重複除去を行い、fastText で英語以外のページを除き、n-gram 言語モデルで低品質な内容を除く。さらに、「Wikipedia に引用されるウェブページ」とランダムなウェブページを区別する線形分類器を訓練し、前者だけを残す。
- C4:著者らは、異なる方法で処理した CommonCrawl を加えると効果があることに気づき、T5 の C4 も加えた。C4 の品質フィルタは主に句読点、単語数、文の数といったルールに頼っており、CCNet とは異なる。
- GitHub:Apache、BSD、MIT ライセンスのプロジェクトだけを残し、行の長さと英数字の割合でフィルタし、さらにファイル単位で完全一致の重複を除く。
- Wikipedia:2022 年 6~8 月の版で、ラテン文字またはキリル文字を使う 20 言語を含む。
- 書籍:グーテンベルク・プロジェクトのパブリックドメインの書籍と、The Pile に含まれる Books3。内容が 90% を超えて重複する本は一冊だけ残す。
- ArXiv:LaTeX のソースファイル。最初の節より前の部分、参考文献、コメントを削り、著者が独自に定義したマクロを展開する。
- StackExchange:最大の 28 サイトの質問と回答。回答はスコアの高い順に並べる。
トークン化は SentencePiece の BPE で、数字は必ず一桁ずつに分け、未知の UTF-8 文字はバイト表現にフォールバックする。合計は約 1.4 兆 token で、ほとんどのデータは一度しか見ず、Wikipedia と書籍は約二回見る。
アーキテクチャ:借りてきた三つの変更
LLaMA は標準的な Transformer デコーダに、先行研究で提案され、すでに大規模モデルで使われている三つの変更を加えたものだ。論文も括弧で出どころを示している。
- Pre-normalization(GPT-3):各サブ層の出力ではなく入力を正規化し、訓練の安定性を高める。正規化関数には RMSNorm を使う。
- SwiGLU(PaLM):フィードフォワード層の ReLU を SwiGLU に置き換える。
- 回転位置エンコーディング RoPE(GPT-Neo):絶対位置エンコーディングを外し、各層に RoPE を加える。
SwiGLU には一つ細かい点がある。論文によれば、フィードフォワード層の幅は PaLM の ではなく だ。SwiGLU には行列が三つあり、標準的なフィードフォワード層には二つしかないので、幅を三分の二にしてはじめてパラメータ数が元とほぼ同じになる。公式コードはさらに、これを 256 の倍数に切り上げる。LLaMA-7B の で一度計算してみよう。
d, multiple_of = 4096, 256          # LLaMA-7B の d_model

hidden = int(2 * (4 * d) / 3)       # 4d の 3 分の 2
hidden = multiple_of * ((hidden + multiple_of - 1) // multiple_of)  # 256 の倍数に切り上げる
print(hidden)                       # 11008

relu_ffn = 2 * d * (4 * d)          # 行列二つ:d→4d、4d→d
swiglu_ffn = 3 * d * hidden         # 行列三つ:W、V と出力行列
print(f"{relu_ffn / 1e6:.1f}M {swiglu_ffn / 1e6:.1f}M")  # 134.2M 135.3M
各層のフィードフォワードのパラメータ数はほぼ同じで、その代わりに SwiGLU による品質向上が手に入る。
四つのサイズの設定は次のとおりで、バッチはどのモデルも 400 万 token だ。
| パラメータ | アテンションヘッド数 | 層数 | 学習率 | 訓練 token | |
|---|---|---|---|---|---|
| 6.7B | 4,096 | 32 | 32 | 1.0T | |
| 13.0B | 5,120 | 40 | 40 | 1.0T | |
| 32.5B | 6,656 | 52 | 60 | 1.4T | |
| 65.2B | 8,192 | 64 | 80 | 1.4T |
原論文 Table 2 をもとに整理。
最適化器は AdamW(、)で、コサイン学習率スケジュールで最大値の 10% まで下げる。重み減衰は 0.1、勾配クリッピングは 1.0、ウォームアップは 2,000 ステップ。
訓練を速く回す
著者らはいくつかの工学的な最適化を施している。
- 因果アテンションの効率的な実装:xformers ライブラリのもので、アテンションの重みを保存せず、因果マスクで隠される key/query のスコアも計算しない。
- 逆伝播時の再計算を減らす:線形層の出力のように、計算コストの高い活性化を保存しておく。そのために Transformer 層の逆伝播を手書きし、PyTorch の自動微分には頼らない。
- モデル並列と系列並列を使い、活性化の計算と GPU 間の通信をできるだけ重ねる。
65B の訓練では、GPU 一枚あたり毎秒約 380 token を処理する。80GB の A100 を 2,048 枚使って、1.4 兆 token を見終えるのに約 21 日かかる。
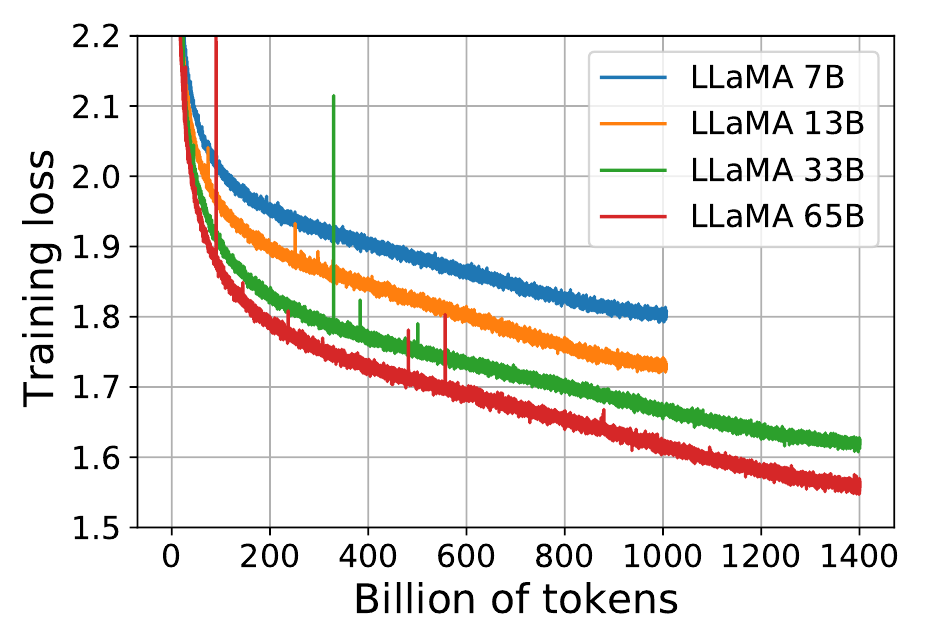
この図が先ほどの主張を支えている。四本の訓練損失曲線は最後まで下がり続けており、7B も 1 兆 token の時点でまだ平らになっていない。
議論
主な結果
著者らは 20 個のベンチマークで比較した。対象は非公開の GPT-3、Gopher、Chinchilla、PaLM と、公開されている OPT、GPT-J、GPT-Neo だ。数字はいずれもそれぞれの論文から取っている。
常識推論(ゼロショット、8 個のベンチマーク)。LLaMA-65B は BoolQ 以外のすべてで Chinchilla-70B に勝ち、BoolQ と WinoGrande 以外のすべてで PaLM-540B に勝った。LLaMA-13B はほとんどのベンチマークで GPT-3 に勝っている。
クローズドブック質問応答。Natural Questions では、65B のゼロショットが 23.8、64-shot が 39.9 で、PaLM-540B はそれぞれ 21.2 と 39.6 だ。LLaMA-13B も二つのクローズドブック質問応答のベンチマークで GPT-3、Chinchilla と肩を並べ、著者らは推論に V100 一枚しか要らない点にわざわざ触れている。
数学。GSM8K では、LLaMA-65B の一回の解答は 50.9 で、arXiv と数学のウェブページ 385 億 token で微調整した Minerva-62B(52.4)をわずかに下回る。多数決、つまり同じ問題に対して答えを複数サンプリングして投票させると、LLaMA-65B は 69.7 で、Minerva-62B の 68.5 を上回る。LLaMA は数学のデータで一切微調整していない。
コード。HumanEval の pass@1 は、LLaMA-65B が 23.7、PaLM-62B が 15.9、PaLM-540B が 26.2。13B 以上の LLaMA は、HumanEval と MBPP の両方で LaMDA-137B に勝つ。いずれも汎用モデルで、コード向けに特別な訓練も微調整もしていない。
MMLU は、LLaMA がはっきり遅れているところだ。65B の 5-shot の平均は 63.4 で、Chinchilla-70B は 67.5、PaLM-540B は 69.3。著者らは、書籍と学術論文が少なすぎることが原因だと考えている。ArXiv、グーテンベルク、Books3 を合わせても 177GB しかなく、Gopher、Chinchilla、PaLM は最大 2TB の書籍を使っていた。著者らはこの点で、Gopher が MMLU では GPT-3 に勝つのに、他のベンチマークではほぼ同じである理由も説明している。
訓練中の性能
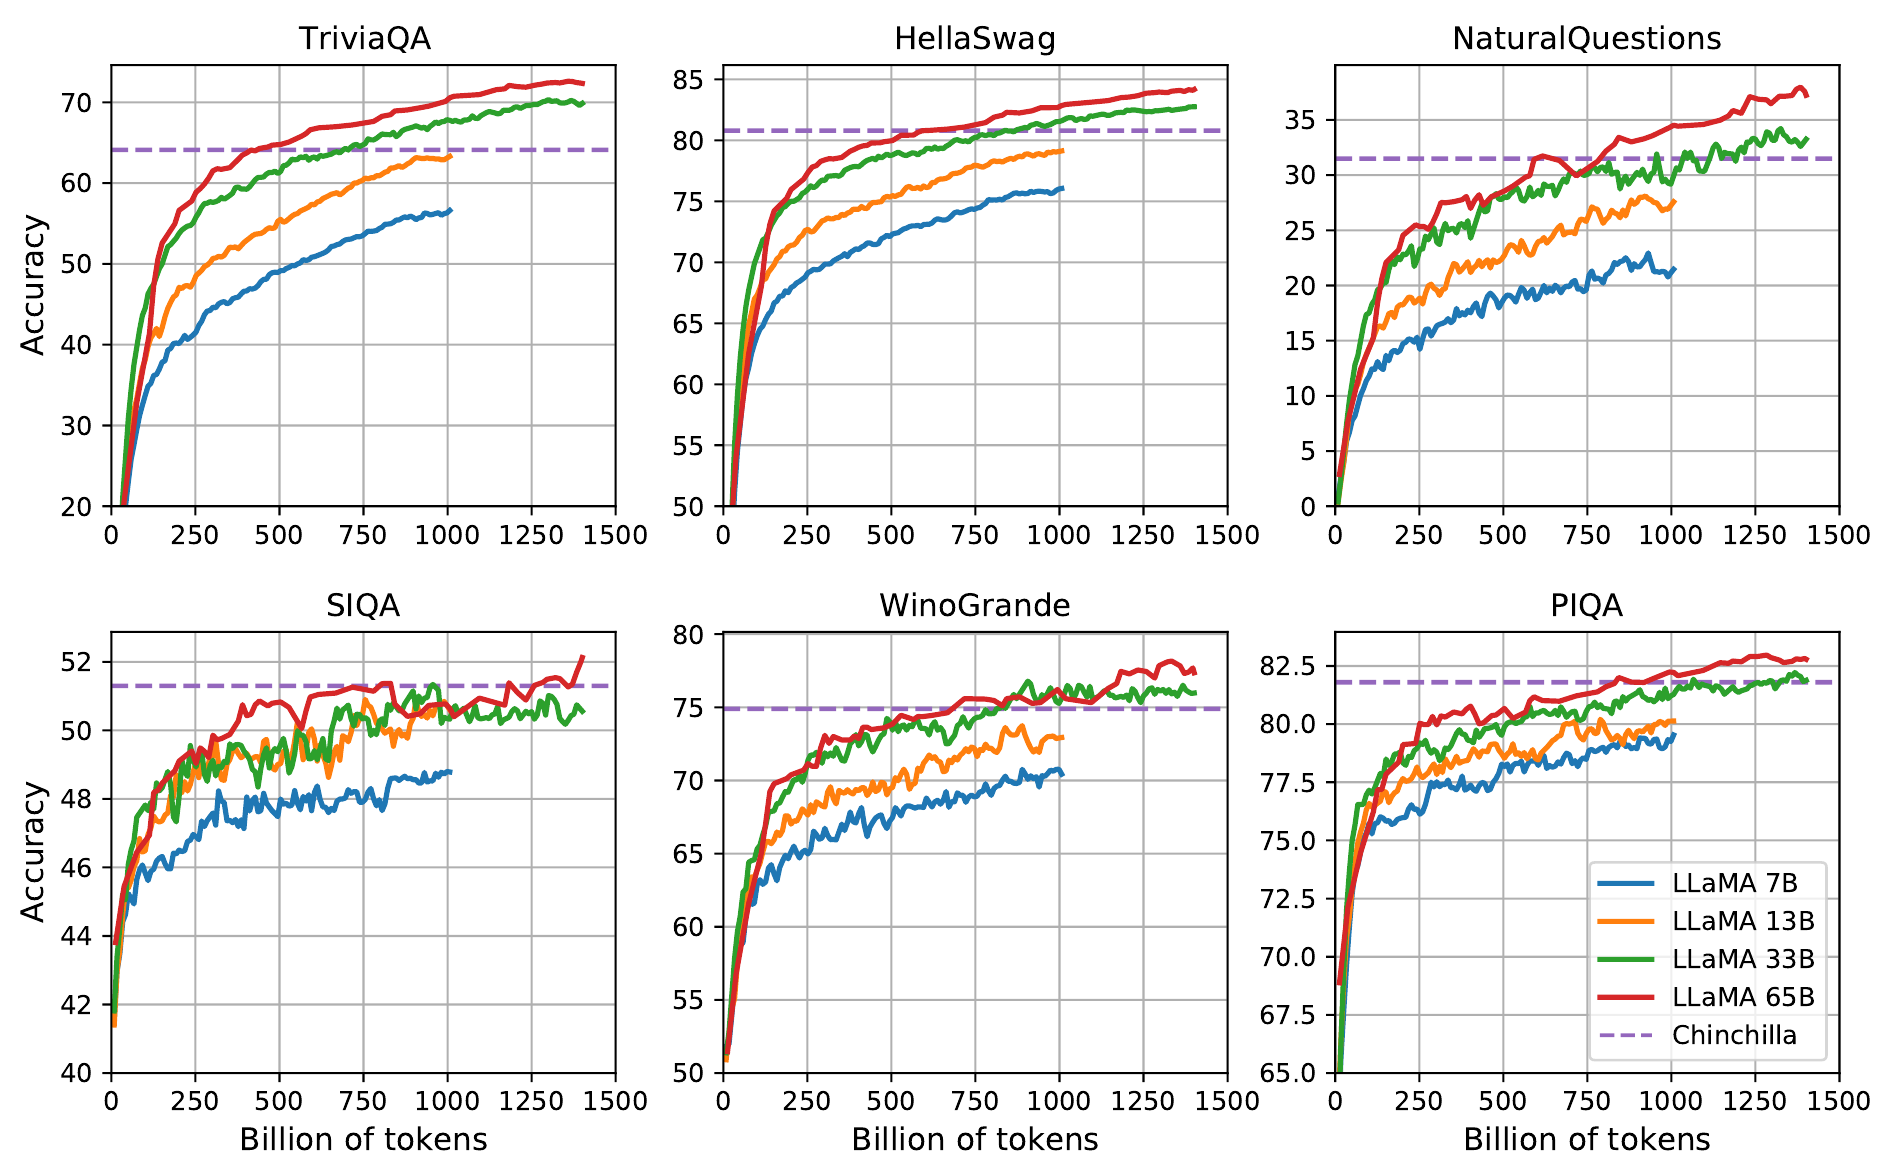
著者らは訓練の途中で、いくつかのベンチマークを追い続けた。ほとんどは着実に上がり、訓練損失と一緒に改善する。注目したい例外が二つある。SIQA はスコアの揺れが大きく、著者らはこのベンチマークは信頼できないかもしれないと考えている。WinoGrande はスコアとパープレキシティの関連が弱く、33B と 65B は訓練全体を通じてほぼ同じだった。
シンプルな指示チューニング
著者らは小さな実験もしている。Chung ら(Flan-PaLM)の手順に従って 65B に少量の指示チューニングを施し、LLaMA-I と呼んだ。MMLU は 63.4 から 68.9 に上がり、OPT-IML-Max 30B(43.2)や Flan-PaLM 62B(59.6)など中規模の指示チューニングモデルを上回ったが、当時の最高である code-davinci-002 の 77.4 にはまだ距離がある。著者らは、これは本論文の主眼ではなく、実験も一回だけだと強調している。
バイアス、有害性、真実性
有害性。RealToxicityPrompts では、モデルが大きくなるほど有害性が上がり、「丁寧に、敬意をもって、偏りなく文を完成させよ」と求めるプロンプトではそれがより顕著になる。65B は 0.141、7B は 0.081 だ。
ステレオタイプ。CrowS-Pairs では、LLaMA-65B の平均バイアススコアは 66.6 で、GPT-3(67.2)や OPT-175B(69.5)よりわずかに良いが、宗教のカテゴリでは OPT より約 10 ポイント高く、年齢と性別がそれに続く。著者らは、これらのバイアスは CommonCrawl から来ていると推測している。
性別と職業。WinoGender では、「they/them/someone」の代名詞の判断が「he」「she」よりはっきり正確だ。代名詞が職業の多数派の性別と食い違う「引っかけ」問題では誤りが増える。つまりモデルは、文中の証拠ではなく、職業のステレオタイプ的な性別で判断している。
真実性。TruthfulQA では、65B の回答の 57% が真実で、真実かつ情報量のある回答は 53% だった。GPT-3 175B の 28% と 25% より高いが、著者らも正解率はまだ低く、モデルが誤った答えをでっち上げる可能性は高いと述べている。
計算資源と炭素排出
LLaMA-65B の訓練には約 102 万 A100 GPU 時間を使った。著者らの見積もりでは、開発全体で約 5 か月、2,048 枚の A100 を使い、総消費電力は約 2,638 MWh で、アメリカの電力網の平均的な炭素強度をもとにすると、二酸化炭素換算で約 1,015 トンになる。著者らは、モデルを公開すれば、他の人がもう一度訓練し直さずに済むことを期待している。
公開の後
LLaMA の重みは、非商用ライセンスの申請制で研究者に提供された。一週間後、重みは 4chan で torrent ファイルとして流出した。Meta はその後 Hugging Face などのプラットフォーム上のコピーに削除要請を出したが、ファイルはすでに広く出回っていた。
その後数週間の動きが、この重みの影響の大きさを物語っている。2023 年 3 月 13 日、Stanford の研究者が Alpaca を発表した。OpenAI の text-davinci-003 で 52,000 件の指示デモンストレーションを生成して LLaMA-7B を微調整し、再現にかかる費用は全部で 600 ドル未満だという。彼ら自身のブラインドテストでは、Alpaca は text-davinci-003 に対して 90 勝 89 敗だった。評価の規模は小さいが、これによって「公開された重みに少量の指示データを足す」やり方が、多くの人が後に続く路線になった。
論文がデータの出どころを透明に列挙したことには、別の面もあった。Books3 には、著作権で保護された書籍が大量に含まれている。2023 年 7 月、Sarah Silverman を含む何人かの作家が Meta を相手に著作権訴訟を起こし、LLaMA が自分たちの本で訓練されたと訴えた。Books3 は訴訟の焦点の一つだった。
五か月後、Meta は商用利用できる Llama 2 を発表した。さらに一年後、Llama 3 は同じ方向をさらに推し進め、事前学習データを約 15 兆 token まで増やした。
結論
LLaMA が変えたのは部品ではなく、問いだ。Chinchilla が問うたのは訓練の計算量をどう使えば最も得か、LLaMA が問うたのはデプロイ後にどうすれば最も安く済むか。答えは小さいモデルにたくさん読ませることで、13B は 1 兆 token を読んで、ほとんどのベンチマークで GPT-3 を追い抜いた。
モデルを選ぶときは、このトレードオフを覚えておくとよい。訓練で多めに読ませる token のコストは一度きりだが、推論ではリクエストのたびにモデル全体を一回走らせる。長く運用するサービスなら、少し小さくて多めに読んだモデルのほうがたいてい得だ。
ついでに言うと、第二世代で名前は LLaMA から Llama に変わった。これでようやく、大文字の数を数えなくて済む。