原論文
SGDR: Stochastic Gradient Descent with Warm Restarts
- 発表先
- ICLR 2017国際会議
- arXiv への初回投稿
- arXiv:1608.03983
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizerssgdr2016,
  title = {{SGDR: Stochastic Gradient Descent with Warm Restarts}},
  author = {Ilya Loshchilov and Frank Hutter},
  year = {2016},
  eprint = {1608.03983},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1608.03983}
}
PyTorch の torch.optim.lr_scheduler を開くと、二つのスケジューラのドキュメントが同じ論文を指している。
一つは CosineAnnealingWarmRestarts で、名前がすでに出自をはっきり語っている。もう一つは CosineAnnealingLR で、ドキュメントは同じくこの論文を引用しつつ、わざわざ一文を添えている。SGDR には周期的なリスタートがあるが、この実装が行うのはリスタートなしの cosine アニーリングだ、と。
タイトルに「リスタート」と書かれた論文なのに、のちに大規模モデルの訓練設定に残ったのは、たいていリスタートのないほうの半分だった。2016 年に Ilya Loshchilov と Frank Hutter がいったい何を提案したのか、リスタートはもともと何を解決しようとしていたのか、最初から見ていこう。
この 2 人の著者を知らなければ、少し背景を補っておこう。彼らは当時ドイツのフライブルク大学にいて、Hutter の研究の主軸はハイパーパラメータ最適化と AutoML だった。Loshchilov はそれ以前に進化戦略 CMA-ES の研究を数多く手がけており、論文の第 2 節でリスタート戦略を振り返る際にも、自身の 2012 年の研究を引用している。勾配を使わない最適化では、「しばらく走らせ、まるごとやり直す」は多峰性関数に対処する昔ながらの手で、よくあるやり方は、リスタートのたびにサンプリングする集団を 2 倍にするものだ。この論文は、そのリスタートの習慣を SGD に持ち込んだ。
問題の定義
2016 年に ResNet のようなネットワークを訓練するときの主流は、モーメンタム付き SGD、つまり論文の式 (3)(4) だった。
著者らは序論で、こうした訓練で最も難しい部分として残っているのは、学習率をどうスケジュールするかと、重み減衰をどれくらいにするかだと述べている。この論文がベースラインに使う Wide ResNet(WRN)は、学習率を 0.1 から始めて、第 60、120、160 エポックでそれぞれ 0.2 を掛け、合計 200 エポック訓練する。
この階段状のスケジュールには面倒が二つある。第一に、どこで下げ、どれだけ下げるかが、どちらも調整すべきハイパーパラメータになる。第二に、モデルは学習率が下がるまで良くならない。第 100 エポックで止めなければならないとしたら、手元のモデルはまだ高い学習率の段階にいて、誤差が大きい。著者らは後者を anytime performance と呼んでいる。どの時点で止めても、手元に十分良いモデルがある、という意味だ。
この論文の目標は、SGD の anytime performance を改善することだ。訓練をいつでも止められて、しかも最終的には調整済みの階段状スケジュールに負けないようにするには、学習率をどうスケジュールすればよいのか?
問題の解決
ウォームリスタート
著者らのやり方は、 エポックごとに、SGD のやり直しを一度模擬することだ。このリスタートでは訓練を最初からやり直さない。パラメータ はそのまま新しい出発点にし、学習率だけを高い値に戻して、また下げていく。原文はまた、学習率をどこまで上げるかによって、それまでに蓄積した情報(たとえばモーメンタム)がどれだけ残るかが決まることも指摘している。
Cosine アニーリング
回目の実行の中では、学習率は式 (5) に従ってバッチごとに減っていく。
は前回のリスタートから何エポック走ったかだ。バッチごとに更新されるので、0.1、0.2 のような小数にもなる。いくつかの点を代入してみる。
- のとき、 で、学習率は 。
- のとき、 で、学習率はちょうど両端の中間。
- のとき、 で、学習率は まで下がる。
つまりこの曲線は、最初はゆっくり下がり、中盤はほぼ直線で、終わり近くでまたゆるやかになって、低い学習率にしばらくとどまる。CIFAR の実験では、各実行の と はそれぞれ 0.05 と 0 に固定している。著者らは、リスタートのたびにこの二つの値を下げていけば良いかもしれないと述べているが、ハイパーパラメータを少しでも減らすため、そうはしなかった。
と
周期の長さは二つの数で決まる。 は最初の実行の長さで、その後はリスタートのたびに周期に を掛ける。論文で最もよく出てくる 、 で計算してみよう。
| 何回目の実行か | 周期の長さ | 終わるエポック |
|---|---|---|
| 1 | 10 | 10 |
| 2 | 20 | 30 |
| 3 | 40 | 70 |
| 4 | 80 | 150 |
| 5 | 160 | 310 |
200 エポックの予算では、最後まで走り切るのは最初の 4 回だけで、5 回目は途中で終わる。、 にすると、リスタートは第 1、3、7、15、31、63、127 エポックに来る。
周期を倍にしていく狙いは、まずとても短い周期で使えるモデルをすばやく手に入れ、それから次第に長い周期でより良い結果を得ることだ。前に触れた、進化戦略でリスタートのたびに集団を 2 倍にするのと同じ発想だ。別の設定として があり、 エポックごとにリスタートする。 のときは、訓練全体が 1 本の cosine だけになり、リスタートはまったくない。この線は後でとても重要になる。
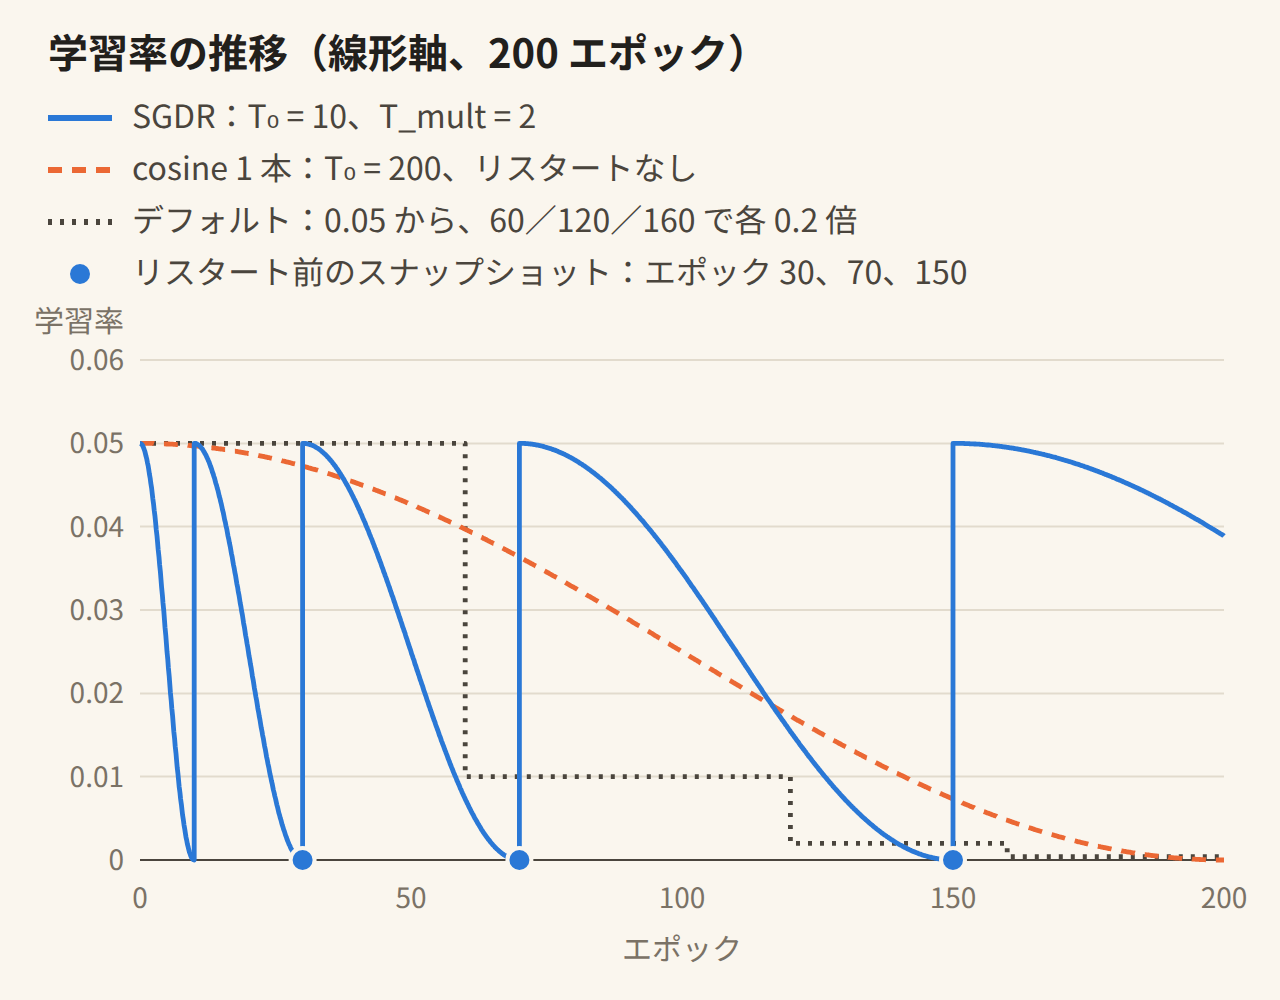
原論文はこれらのスケジュールを対数軸で描いていて、著者ら自身も、対数軸では cosine の形が見えないと認めている。そこでここでは線形軸で描き直した。青線は 0 まで落ちるたびにすぐ 0.05 に跳ね戻り、橙の破線は 0.05 から 0 までゆっくり下がり続ける。
どのモデルを渡すか?
学習率を急に上げると、モデルは一時的に悪くなる。だから SGDR は、最後のステップのパラメータを渡すとは限らない。最初のリスタートより前は、最新の を推奨する。それ以降は直近に走り終えた周期の終わり、つまり学習率がちょうど まで下がったときのモデルを渡す。上の表で言えば、第 200 エポックまで訓練したとき、SGDR が渡すのは第 150 エポックのモデルだ。著者らは、この規則ならモデルを選ぶために検証セットを別に切り出す必要がないと強調している。
なぜリスタートするのか
第 2 節は二つの流れを振り返っている。勾配を使わない最適化は、多峰性関数に対処するためにリスタートを使う。勾配を使う最適化では、リスタートはたいてい収束を速めるために使われる。たとえば O'Donoghue と Candès(2012)は、Nesterov の加速法がモーメンタムを効かせすぎると周期的に振動することを見出し、目的関数が大きくなったとき、あるいはモーメンタムの向きと負の勾配が鈍角をなしたときにリスタートした。
確率的勾配では事情が違う。1 バッチの損失や勾配はノイズが大きすぎて、こうした判定条件をそのまま持ち込むことはできず、まず平均を取る(たとえばエポックごとに 1 回)必要がある。著者らは最も単純な版、つまり決まったスケジュールでリスタートする方法を選んだ。議論の中でもかなり控えめで、SGDR の主な目的は anytime performance の改善であり、多峰性に関係する効果を観察したとは一切主張していない。
議論
実験設定
主な実験は、CIFAR-10 と CIFAR-100 で WRN-28-10(28 層、各層のフィルタ数がもとの ResNet の 10 倍、約 3,650 万パラメータ)を訓練するものだ。著者らはまず WRN の元論文の設定を再現した。モーメンタム 0.9、重み減衰 0.0005、バッチサイズ 128、200 エポックで、データ拡張には水平反転と、4 画素の反射パディング後のランダムクロップを使う。元の設定との違いは 2 点だけで、一つは画素ごとの平均を引くだけで ZCA 白色化をしないこと、もう一つはモーメンタムに Nesterov モーメンタムではなく式 (3)(4) の一般的な版を使うことだ。
単一モデル
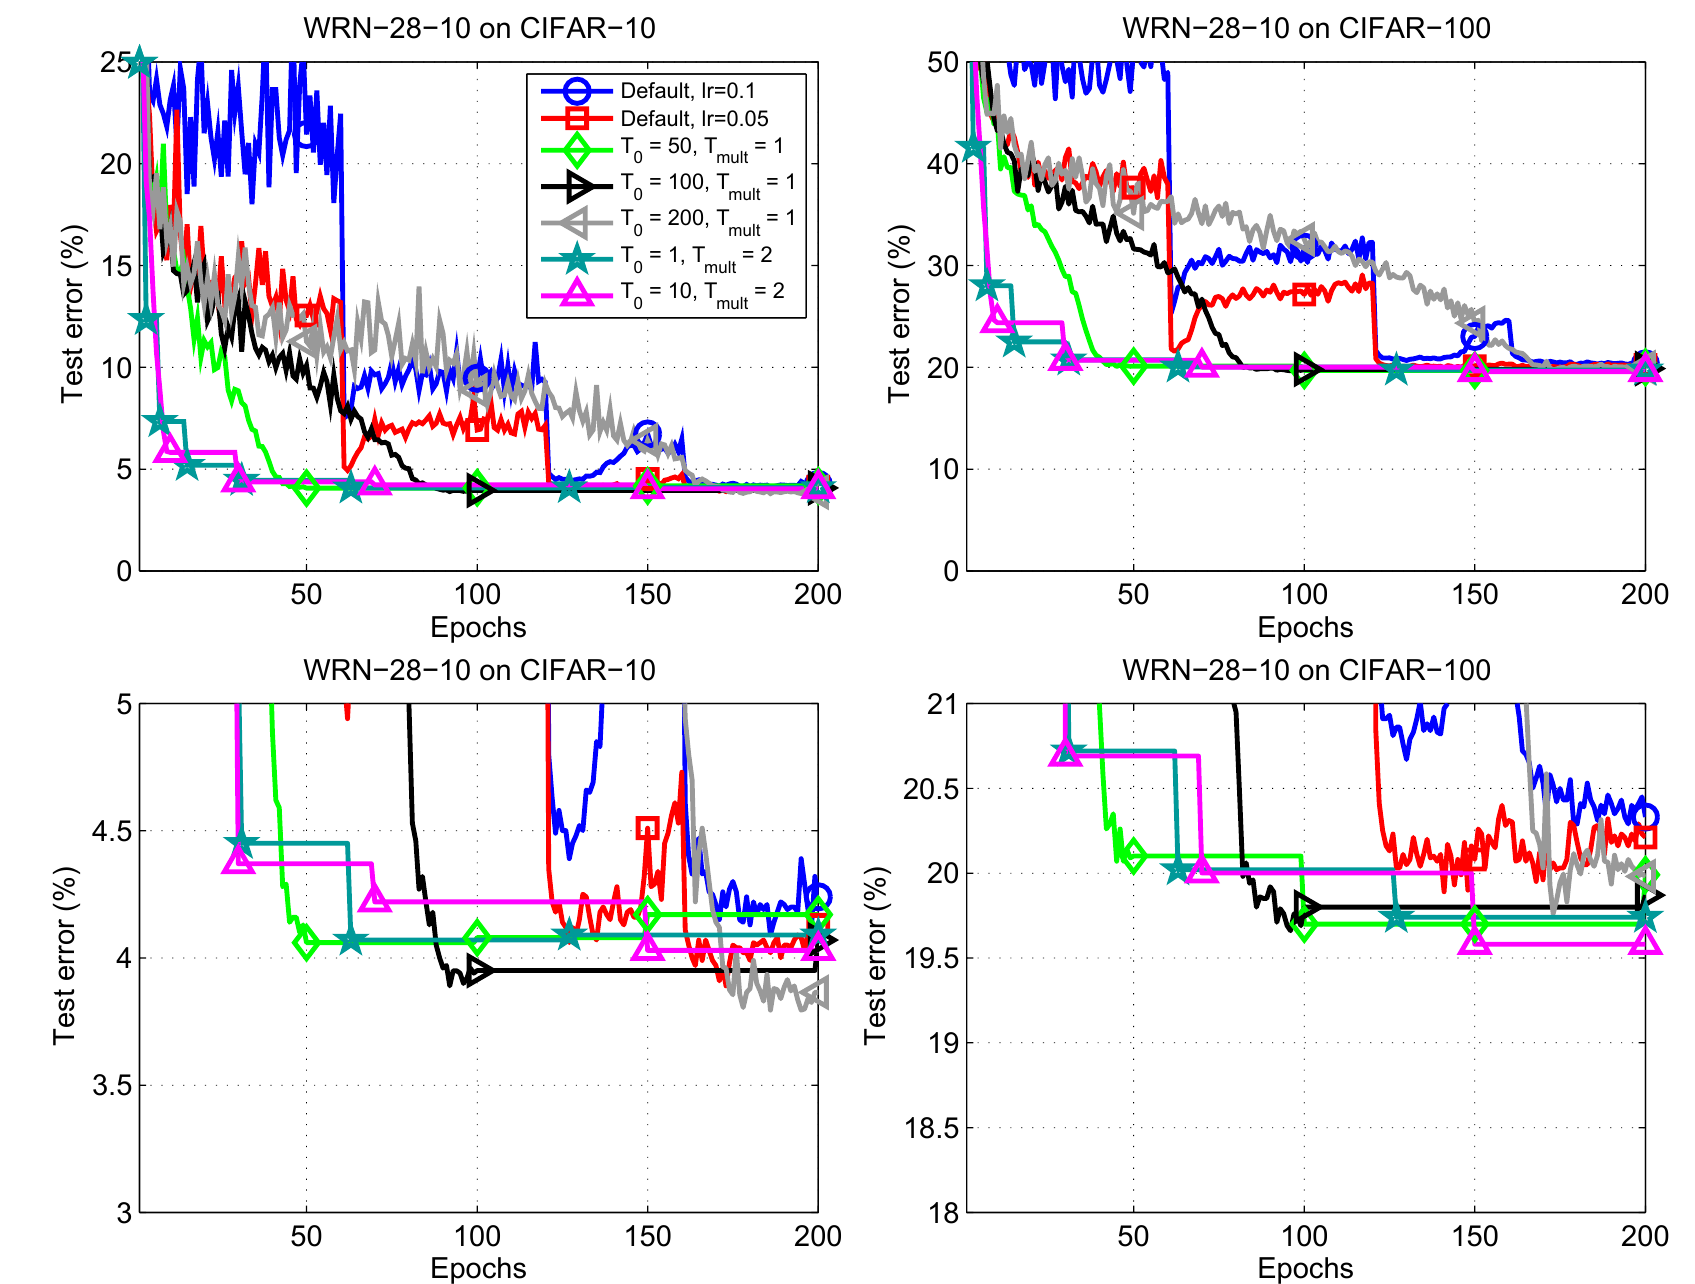
まず上段を見よう。青線と赤線はデフォルトのスケジュールで、第 60 エポックで学習率を下げるまでは、CIFAR-10 のテスト誤差はどちらも 12% 以上あり、一度下げた後も 7% から 10% のあいだにとどまる。CIFAR-100 のほうでは、赤線は 2 回の学習率の引き下げのあいだで、むしろ上がっていく。SGDR の線は推奨解を描いているので階段状になる。周期を倍にしていく緑の星()とマゼンタの三角()は、数十エポックのうちに低誤差の領域まで落ちる。下段は同じ結果を拡大したもので、最後の数エポックでどれが高くどれが低いかがわかる。
著者らの結論は、SGDR はエポック数を 2 分の 1 から 4 分の 1 に減らして、CIFAR-10 で約 4%、CIFAR-100 で約 20% のテスト誤差に達するというものだ。最終的な数字を以下にまとめる。
| WRN-28-10 のスケジュール | CIFAR-10 | CIFAR-100 |
|---|---|---|
| デフォルト、η₀ = 0.1 | 4.24 | 20.33 |
| デフォルト、η₀ = 0.05 | 4.13 | 20.21 |
| T₀ = 50、T_mult = 1 | 4.17 | 19.99 |
| T₀ = 100、T_mult = 1 | 4.07 | 19.87 |
| T₀ = 200、T_mult = 1 | 3.86 | 19.98 |
| T₀ = 1、T_mult = 2 | 4.09 | 19.74 |
| T₀ = 10、T_mult = 2 | 4.03 | 19.58 |
原論文 Table 1 をもとに整理。テスト誤差(%)、5 回の実行の中央値。
この表を読むときは、二つのことに注意したい。第一に、差の多くはコンマ数ポイントにすぎず、各組 5 回しか実行していない。著者らも表の説明で、太字は良いほうの数字を示しただけで、統計的検定はしていないと書いている。第二に、CIFAR-10 で最良の単一モデルは 3.86% で、、、つまり完全な cosine 1 本で、リスタートはまったくない。著者らはこれを根拠に、WRN のもとの階段状スケジュールは最良の選択ではないかもしれないと考えている。ただ、この設定は anytime performance も最も悪く、最後の数エポックになってようやく追いつく。
節約した時間で、著者らはより幅の広い WRN-28-20(1.458 億パラメータ、計算量は約 3 から 4 倍)を訓練した。CIFAR-10 は約 0.25 ポイント、CIFAR-100 は 0.5 から 1 ポイント良くなり、、 で 3.74% と 18.70% を得た。最初の 50 エポックだけを見ても、まだ一度もリスタートしていない と組み合わせた WRN-28-20 は、CIFAR-100 ですでに 19% を下回っている。一方、WRN-28-10 はどのスケジュールを使っても 19.5% より良くならなかった。
付録の訓練曲線は、さらにもう一つ観察を補っている。第 120 エポックあたりまでは、SGDR の訓練損失はデフォルトのスケジュールより速く下がる。その後デフォルトのスケジュールは過学習しはじめ、テスト損失が上がっていくが、SGDR の過学習はわずかだ。
タダのスナップショット・アンサンブル
SGDR の arXiv 初版が出た後、Huang らの Snapshot Ensembles は、その周期を使ってアンサンブルを作った。各リスタートの直前は学習率がちょうど最低まで下がっていて、モデルはそこそこ良い位置に止まっている。こうしたスナップショットを保存しておけば、訓練コストを増やさずに一組のモデルをそろえられる。この論文の正式版は振り返って、このアイデアが WRN で成り立つかを検証している。
やり方は、、 の SGDR で WRN-28-10 を訓練し、第 30、70、150 エポックでスナップショットを保存するというもので、スケジュールの図の三つの青い点にあたる。推論時は、各スナップショットの softmax 出力の確率を等しい重みで平均する。
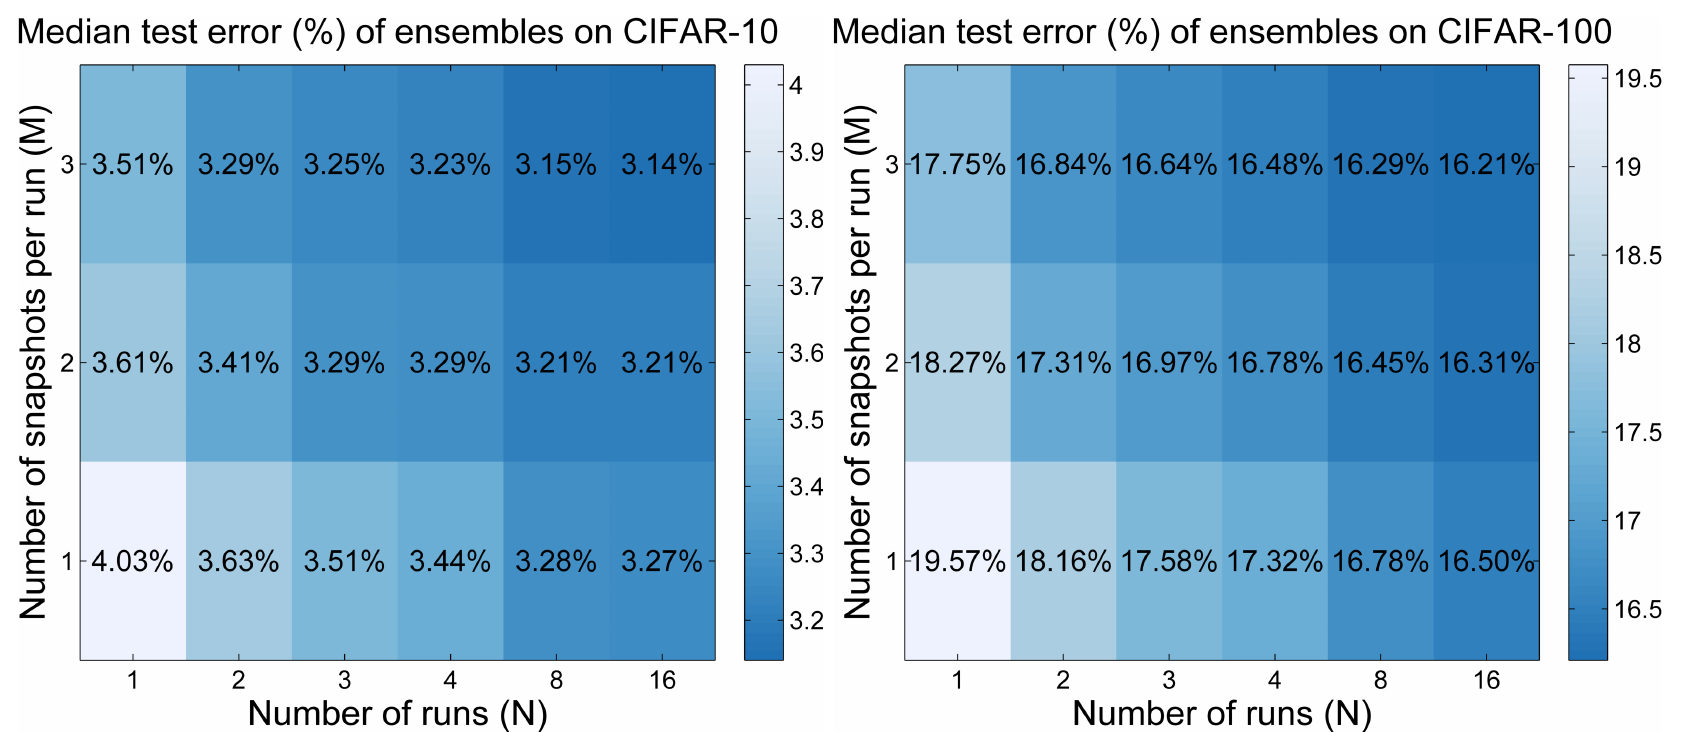
横軸は独立に何回訓練したか()、縦軸は 1 回の訓練からスナップショットをいくつ取るか()だ。左下は単一モデルで、CIFAR-10 は 4.03%、CIFAR-100 は 19.57%(16 回の中央値)。上に進んで にすると、同じ 1 回の訓練の三つのスナップショットで 3.51% と 17.75% まで下がる。独立した訓練で同じくらいの効果を得るには、 回走らせる必要がある(3.51% と 17.58%)。だからこの設定では、スナップショットのおかげで訓練量がおよそ 3 分の 1 で済んだことになる。
スナップショットをどこから取るかも重要だ。最後の 3 エポック(148、149、150)のモデルだけでアンサンブルすると、第 150 エポックのモデルだけを使ったのと同じ結果になり、改善はない。リスタート前のスナップショットが役に立つのは、それぞれ異なる周期から来ていて、予測に互いの違いがあるからだ。
二つのやり方は重ねられる。3 回の訓練からそれぞれ三つのスナップショットを取ると、誤差は 3.25% と 16.64% まで下がる。16 回の訓練からそれぞれ三つ取ると、要旨にある 3.14% と 16.21% になる。論文が主張する当時の CIFAR での最高成績だが、それは 48 個のモデルのアンサンブルだ。二つのデータセットの傾向も完全には一致しない。CIFAR-10 では 9 個のスナップショット(、)の 3.25% が、すでに 16 個の独立したモデルの 3.27% と同等だ。CIFAR-100 では、16 個の独立したモデルの 16.50% のほうが、9 個のスナップショットの 16.64% よりまだ少し良い。
EEG とダウンサンプリングした ImageNet
この手法が CIFAR だけのものではないことを示すため、著者らは別に二組の実験を行った。
一組目は脳波(EEG)のデータで、被験者 14 人、1 人あたり約 1,000 試行。実際の左右の手と足の動作を分類するもので、ネットワークは Schirrmeister らが設計した畳み込みネットワークを流用している。ベースラインのスケジュールは、まず総エポック数(30 から 480)を決め、それに比例した決まった時点で学習率を 10 分の 1 に下げる。予算を多く与えるほど結果は良くなる。SGDR は予算を前もって決める必要がなく、最終的な成績はベースラインとほぼ同じで、途中の成績はより良い。スナップショットを使ったアンサンブルも効果がある。中央値で約 9% の参照誤差が、1 回の訓練のスナップショットを使うとさらに 1 から 2 ポイント、二つの学習率のスナップショットを組み合わせると 2 から 3 ポイント下がる。
二組目は、著者ら自身が作ったダウンサンプリング版 ImageNet で、1,000 クラスも画像ももとと同じだが、box downsampling で 32 × 32 に縮めている(このデータセットはのちに 2017 年に別途発表された)。各画像の平均画素数は 2 桁少ないので、もとの ImageNet より難しい。クラスが多く、物体が画面の小さな一部しか占めないことも多いので、CIFAR よりも難しい。WRN-28-10 でデフォルトのスケジュールと二組の SGDR を比べ、それぞれ 4 種類の初期学習率(0.05、0.025、0.01、0.005)を使った。、、 の SGDR は、top-1 で 39.24%、top-5 で 17.17% の誤差を得た。これは AlexNet がもとの解像度の ImageNet で出した 40.7% と 18.2% に相当する。この実験は約 40 エポックしか走らせておらず、著者ら自身も予備的な結果と呼んでいる。AlexNet との比較は解像度もモデルもまたいでいるので、参考の目安としてしか使えない。
著者らの解釈では、初期学習率をうまく選べるかどうかの影響はとても大きく、SGDR は各周期で初期値から 0 まで一気に掃引するので、学習率の区間をまるごと試したのと同じことになり、初期値を選び間違えたときの被害を軽くする。
リスタートは本当に肝心なのか?
CIFAR-10 で最良の単一モデル、WRN-28-10 の 3.86% と WRN-28-20 の 3.66% は、どちらもリスタートのない から来ている。著者らも議論の中で、まったくリスタートしなくても、式 (5) というこの積極的なスケジュールはデフォルトのスケジュールと比べて十分競争力があり、しかも必要なハイパーパラメータは初期学習率と総エポック数の二つだけだと書いている。
後続の研究は、このことをもっとはっきりさせた。Gotmare ら(ICLR 2019)は mode connectivity を使って SGDR の軌跡を分析した。CIFAR-10 で VGG-16 を訓練し、スケジュールは同じく 、。第 30 と 150、第 70 と 150 エポックのモデルのあいだでは、結ぶ線上の訓練損失が確かに両端より高く、リスタート後にパラメータが障壁を越えたことを示している。しかし第 70 と 150 エポックのモデルは局所最小値とも言えず、異なる盆地にいるようにも見えないので、「局所最小値から抜け出す」という説明は単純化しすぎかもしれない。彼らは脚注で、実験でずっと良い成績を出していたのは、予算全体で 1 回の cosine(または線形)減衰を行うものだったとも述べ、本当に効いているのは減衰で、リスタートの寄与は比較的小さいと推測している。
実務でも、みなそのように使っている。fast.ai は 2017 年の講座で cycle_len と cycle_mult を使って SGDR を広めたが、2018 年末の fastai v1 になると、メンテナはフォーラムで、この書き方はもう使えず、デフォルトは 1cycle に変わったと答えている。その後の大規模な訓練は、たいてい cosine の周期を一つだけ走らせる。
- Bag of Tricks(He ら、2018)が ImageNet で使ったのは「簡略版」で、学習率は初期値から cosine に沿って 0 まで下がり続ける(ウォームアップの段階は別)。
- GPT-3 は 2,600 億トークンをかけて cosine で学習率をもとの 10% まで下げ、その後は 10% を保つ。最初の 3.75 億トークンでは線形にウォームアップする。
- LLaMA の cosine スケジュールは、最終的な学習率を最大値の 10% にし、最初の 2,000 ステップでウォームアップする。
周期を一つだけ走らせるなら、総ステップ数を前もって知っておかなければならず、SGDR が扱おうとした問題がまた戻ってくる。Chinchilla の付録はそのコストを数値で示した。cosine の周期を実際の訓練ステップ数より 25% 以上長く設定すると、モデルははっきり悪くなる。その後の WSD(ウォームアップ、一定、減衰の 3 段階のスケジュール)、WSM、Schedule-Free が扱っているのも、どれもこの問題だ。
結論
SGDR は、学習率スケジュールを一本の式にした。各周期で から cosine に沿って まで下げ、周期の長さは と で決め、周期が終わったら学習率を高い値に戻してやり直す。CIFAR では、エポック数を 2 分の 1 から 4 分の 1 に減らして階段状スケジュールと同等の誤差に達し、リスタート前のスナップショットからはタダでアンサンブルも組める。そして CIFAR-10 で最良の単一モデルは、リスタートしない 1 本の cosine から来ている。
全体でどれだけ訓練するかわかっているなら、いちばん手軽なのは完全な cosine の周期を一つ使うことだ。 を総ステップ数に等しくし、必要なら前にウォームアップを加える。CosineAnnealingLR がこの版だ。スナップショット・アンサンブルをしたいときや、本当に予算がわからないときだけ、CosineAnnealingWarmRestarts を持ち出す価値がある。そのときは論文の規則どおり、最後のステップではなく、周期の終わりのモデルを渡すことを忘れずに。
PyTorch のこの二つのスケジューラの名前は、実はもうあなたの代わりに選んでくれている。リスタートするつもりがないなら、名前の短いほうを選べばいい。