原論文
On the Variance of the Adaptive Learning Rate and Beyond
- 発表先
- ICLR 2020国際会議
- arXiv への初回投稿
- arXiv:1908.03265
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizersradam2019,
  title = {{On the Variance of the Adaptive Learning Rate and Beyond}},
  author = {Liyuan Liu and Haoming Jiang and Pengcheng He and Weizhu Chen and Xiaodong Liu and Jianfeng Gao and Jiawei Han},
  year = {2019},
  eprint = {1908.03265},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1908.03265}
}
If warmup is the answer, what is the question?
これは RAdam の GitHub リポジトリの冒頭に掲げられた一文だ。ウォームアップ(warmup)は当時すでに Transformer の学習の標準装備になっていて、最初の数千ステップで学習率を 0 近くからゆっくり引き上げなければ、Adam はまともに学習できなかった。なぜそうしなければならないのかについては理論的な説明が欠けていて、ウォームアップをどれだけの長さにするかも、たいていは試行錯誤で決めていた。
2019 年 8 月、イリノイ大学と Microsoft の Liyuan Liu らがこの論文を公開し、原因は Adam の適応的学習率にあると主張した。学習の初期には見た勾配の数が少なすぎて、その分散が手に負えないほど大きくなるというのだ。彼らはついでに修正版も提案した。Rectified Adam、略して RAdam である。
論文が arXiv に載ってからおよそ 1 週間後、Less Wright が fast.ai のフォーラムと Medium でこれを「新しい SOTA オプティマイザ」として紹介し、フォーラムではすぐに試す人が出てきた。さらに 2 か月後、Jerry Ma と Denis Yarats が反論を発表した。RAdam をばらしてみれば、Adam に固定のウォームアップを足しただけだというのである。
このノートでは、両方の言い分を見ていく。
問題の定義
Adam の適応的学習率
著者らはまず、さまざまな適応的オプティマイザを一つの枠組みで書き表した(Algorithm 1)。各ステップでモーメンタム と適応的学習率 を計算し、 で更新する。演算はすべて要素ごとだ。Adam の は次のとおり。
つまり二次モーメントの推定値の平方根をとって逆数にしたもので、分子の がバイアス補正だ。勾配がずっと大きいパラメータは歩幅が縮み、勾配がずっと小さいパラメータは歩幅が広がる。
ウォームアップしないとどうなるか
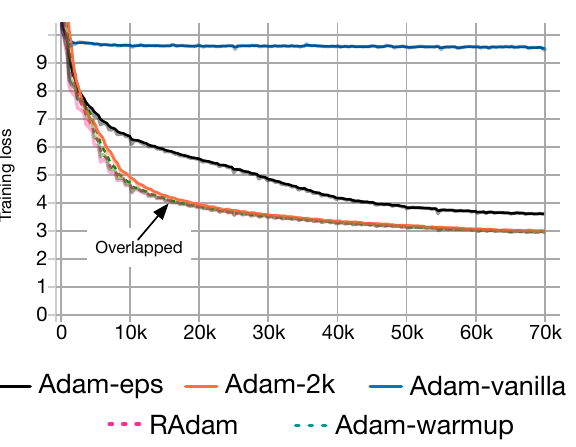
まず青線の Adam-vanilla と、いちばん下の Adam-warmup を見てほしい。同じ Transformer、同じ IWSLT'14 独英データで、ウォームアップなしでは訓練損失が 10 付近で止まり、ウォームアップすると 3 を切るところまで下がる。残りの 3 本は著者らの対照実験で、このあと取り上げる。
著者らが各ステップの勾配の絶対値の分布を描いてみると、ウォームアップなしでは最初の 10 ステップのうちに分布がゆがみ、重心がごく小さな値のほうへ押し寄せていた。彼らの解釈では、Adam は最初の数ステップで有害な更新をして、モデルをよくない領域へ連れていってしまう。ウォームアップの役割は、こうした更新の影響を小さくすることだという。
では、最初の数ステップの更新はなぜ有害なのか。
問題の解決
1 ステップ目にはサンプルが一つしかない
まず最も極端な を見よう。このとき で、適応的学習率全体がたった一つの勾配から推定される。
勾配が に従うとすると、 は自由度 1 のスケール逆カイ二乗分布に従い、 の分散は発散する。直感的にもわかりやすい。 がたまたま 0 にとても近ければ、 は非常に大きくなる。
小さな学習率ならこの分散を抑え込める。 だからだ。これが著者らによるウォームアップの説明で、学習初期には適応的学習率の分散が大きすぎるので、ウォームアップは小さな でそれを抑え込んでいる、というわけだ。
二つの対照実験
本当に分散が問題なら、別のやり方で分散を下げても解決するはずだ。著者らは Adam の変種を二つ用意した。
- Adam-2k:最初の 2,000 イテレーションは だけを更新し、モーメンタムとパラメータは凍結する。先に 2,000 個のサンプルを余分に見て二次モーメントを正確に推定してから学習を始めるのに等しい。
- Adam-eps:分母の を から に大きくして、 の上限を直接抑える。
先ほどの図で、Adam-2k はウォームアップなしなのに Adam-warmup と重なっている。勾配の分布もゆがまなくなった。Adam-eps も 10 で止まる問題は避けられたが、最終的には 3.6 前後にとどまり、ウォームアップより悪い。著者らは、大きすぎる が適応的学習率にバイアスを持ち込み、最適化を遅らせたと推測している。だから、もっと原理に基づいた方法が必要になる。
分散はサンプル数とともに下がる
次は分散を実際に計算する。Adam が使っているのは指数移動平均(EMA)で、そのままでは解析しにくい。著者らはこれを単純移動平均(SMA)で近似し、 が自由度 のスケール逆カイ二乗分布に従うと仮定した。この は「二次モーメントを推定するのに、実質的に何個のサンプルを使ったか」と考えればよい。
Theorem 1 によれば、この仮定のもとで の分散は が増えるにつれて単調に減少し、 では閉形式で書ける(式 (2))。言い換えれば、サンプルが少ないほど適応的学習率は当てにならない。 の範囲については、論文はこの分散を扱えない(intractable)ものとしている。
EMA は何個のサンプルに相当するか
では第 ステップの EMA は、どれだけの長さの SMA に相当するのか。著者らは両者の「重心」、つまり各サンプルの時刻を重みで平均した位置が一致するという条件から、次を導いた。
は の極限だ。デフォルトの を代入すると になる。最初の数ステップの を計算すると次のとおり。
| 1 | 2 | 3 | 4 | 5 | |
|---|---|---|---|---|---|
| 1.000 | 1.999 | 2.999 | 3.997 | 4.996 |
原論文の の定義から計算、。
学習初期の はほぼ そのもので、直感にもよく合う。勾配をいくつ見たかが、そのまま実質的なサンプル数になる。 が 1 に近いほど EMA の記憶は長くなり、 が上限に近づくまでに時間がかかる。
整流項
が手に入ったので、著者らは目標を、適応的学習率の分散がどのステップでも同じ値、つまり のときの最小値 に等しくなることに定めた。やり方は、スケーリング係数 を掛けることだ。
式 (2) の閉形式は数値的に不安定なので、著者らは一次近似に切り替えて式 (5) を得た。
と をそれぞれ代入して割ると、 が消える。
これが RAdam という名前に入っている rectification(整流)だ。いくつかの点で計算して、どんな形をしているか見てみよう。
| ステップ数 | 5 | 10 | 100 | 1,000 | 2,000 | 5,000 |
|---|---|---|---|---|---|---|
| 0.017 | 0.049 | 0.215 | 0.645 | 0.828 | 0.983 |
原論文 4.2 節の から計算、。
最初はごく小さく、1,000 ステップで約 0.65、5,000 ステップになってようやく 1 に近づく。この曲線を学習率の前に掛けると、見た目はまさにウォームアップだ。
アルゴリズムの全体
まとめたものが Algorithm 2 で、各ステップで行うことは次のとおり。
- 勾配 を計算し、二次モーメント と一次モーメント を更新する。
- 一次モーメントをバイアス補正する。。
- を計算する。
- なら、 と を計算し、 で更新する。
- そうでなければ適応的学習率は使わず、そのまま とする。
5 番目が、RAdam がモーメンタム SGD に退化するケースだ。先ほどの の表によれば、 のとき となるのは から 4 だけなので、最初の 4 ステップはバイアス補正つきのモーメンタム SGD で、5 ステップ目から整流された Adam に入る。のちに Ma と Yarats は、 でありさえすれば、 がちょうど と同値になることを証明した。論文はさらに、 なら となり、RAdam は全体がモーメンタム SGD に退化するとも述べている。
ウォームアップとの関係
著者らは 4.3 節で、 を線形ウォームアップと直接比べている。線形ウォームアップは学習率に を掛けることに等しく、形の上では によく似ている。そこで彼らは、これが「ウォームアップは分散を下げるテクニックである」ことの裏づけになると考えた。違いは、RAdam にはウォームアップ長 というハイパーパラメータが要らず、しかも に応じて自動的に調整される点だ。
彼らはまた、この修正は勾配クリッピング、 を大きくすること、初期化、正規化層といった学習を安定させるテクニックとは独立していて、併用できるとも強調している。
議論
実験設定
実験は 3 種類で、Adam 系の手法の重み減衰はすべて AdamW の分離型の書き方を採用している。
- 言語モデル:One Billion Word、2 層 LSTM、隠れユニット 2,048 個、学習率 0.001、バッチサイズ 128。
- 画像分類:CIFAR-10 は ResNet-20(186 エポック)、ImageNet は ResNet-18(90 エポック)。学習率は階段状に下げ、重み減衰は 。
- 機械翻訳:fairseq の Transformer で、IWSLT'14 の独英双方向と WMT'16 英独。Adam は 4,000 ステップの線形ウォームアップを使う。
言語モデルと画像の実験では、Adam と RAdam の はどちらも だ。
素の Adam との比較
ウォームアップなしの条件では、RAdam は三つのデータセットすべてで素の Adam に勝った。One Billion Word のテストパープレキシティは 36.92 から 35.70 に下がった。RAdam は最初の数エポックでは Adam より遅いが、その後は速く収束する。画像分類のテスト正解率は次のとおり。
| データセット | SGD | Adam | RAdam |
|---|---|---|---|
| CIFAR-10 | 91.51 | 90.54 | 91.38 |
| ImageNet | 69.86 | 66.54 | 67.62 |
原論文 Table 1 をもとに整理(%)。
RAdam は Adam より良いが、どちらのデータセットでも SGD には勝てていない。著者らは ImageNet の訓練正解率も報告していて、SGD、Adam、RAdam がそれぞれ 69.57、69.12、70.30 と、RAdam が最も高い。訓練では SGD を上回るのにテストでは下回るので、差は汎化から来ているように見える。ただし、これは訓練正解率から逆算した判断で、論文自体はそういう分析をしていない。
学習率に鈍感
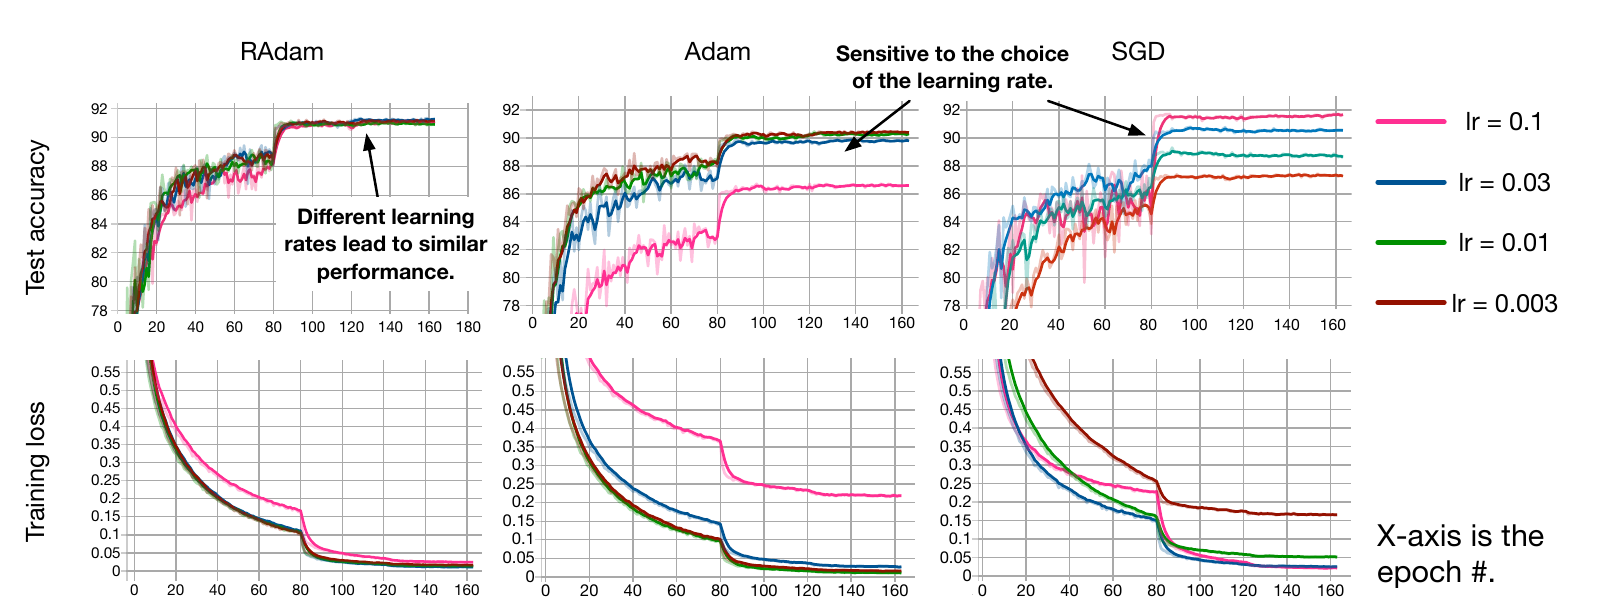
学習率を 0.1 から 0.003 まで変えても、RAdam のテスト正解率の 4 本の曲線はほとんど重なっている。Adam は学習率 0.1 で約 86% まで落ち、SGD は 4 本がそれぞれ別々の道をたどる。著者らはこれを、整流によって RAdam がより広い範囲の学習率に対応できるようになったと解釈している。とはいえ README の FAQ にも、RAdam の頑健性は無限ではなく、学習率はやはり調整が必要だと正直に書かれている。
ウォームアップとの比較
翻訳はウォームアップを最も手放せない場面なので、ここでの相手はしっかり調整した Adam + ウォームアップになる。
| タスク | Adam + ウォームアップ | RAdam |
|---|---|---|
| IWSLT'14 独→英 | 34.66 | 34.76 |
| IWSLT'14 英→独 | 28.56 | 28.48 |
| WMT'16 英→独 | 27.03 | 27.27 |
原論文 Table 2 をもとに整理。BLEU、IWSLT は 5 個の乱数シードの平均。
両者は互角で、著者らの結論も「ウォームアップと同程度の効果が得られる」だ。ここには付録を見ないとわからない設定がある。翻訳実験の は 0.9995 に設定されていて、付録が挙げる理由は にするためだ。 に代入するとちょうど 3,999 となり、Adam 側の 4,000 ステップのウォームアップとそろう。つまりこの比較では、RAdam の「自動ウォームアップ」の長さは を通じてあらかじめ合わせてあったわけだ。
CIFAR-10 では、Adam + ウォームアップの最高正解率は 91.29% で、RAdam の 91.38% と同程度だ。ただしウォームアップ長には 100、200、500、1,000 ステップの選択肢があり、学習率 0.1 に 100 ステップのウォームアップを組み合わせると 90.13% にとどまる。同じ学習率で RAdam は 91.06% だ。したがって著者らの主張をもう少し正確に言えば、RAdam は調整すべきハイパーパラメータが一つ少なく、最高成績そのものはほぼ同じ、ということになる。
最初の数ステップのモーメンタム SGD
モーメンタム SGD に退化するあの数ステップは重要なのか。付録 C では CIFAR-10、学習率 0.1 で置き換え実験をしている(5 回の平均)。全ステップ RAdam ならテスト正解率は 91.08%。最初の 4 ステップを普通の Adam に置き換えると 89.98% に落ちる。最初の 4 ステップを SGD にし、5〜8 ステップ目を整流なしの Adam に置き換えると 90.29% だ。著者らはこれが理論に合っている、つまり早い段階の更新ほど害が大きいと考えている。ただし、この部分はアルゴリズムの中では副次的な設計で、重要なのはウォームアップのメカニズムと整流項の導出だとも述べている。
Ma と Yarats の反論
2019 年 10 月、Jerry Ma(シカゴ大学)と Denis Yarats(ニューヨーク大学、Facebook AI Research)が arXiv に〈On the Adequacy of Untuned Warmup for Adaptive Optimization〉(AAAI 2021)を公開した。アブストラクトでいきなり、この分析に反論すると宣言している。論点は 3 段構えだ。
第一に、RAdam は固定のウォームアップである。 は と だけで決まり、勾配が実際にどうなっているかとはまったく関係がない。前に触れたように はちょうど最初の 4 ステップなので、RAdam は一言で言い表せる。まず 4 ステップのモーメンタム SGD を行い、その後は固定のウォームアップスケジュールをかぶせた Adam になる。彼らは最初の 4 ステップを「何もしない」や「ごく小さな学習率の Adam」に置き換えることも試したが、どれも差は無視できるほどだった。
第二に、分散の議論には穴がある。 RAdam は勾配の平均を 0 と仮定しているが、学習初期のモデルは極小値から遠く、勾配の平均はたいてい標準偏差より大きい。彼らが EMNIST で測ったところ、大半のパラメータの変動係数が安定して 1 を超えるのは、おおよそ 50 ステップ目あたりからだった。さらに肝心なのは、Adam の実際の更新量は で、 と には強い相関があることだ。1 ステップ目では両者は完全に等しく、どのパラメータの更新量もちょうど になる( のとき)。言い換えれば、適応的学習率の分散が「発散」するまさにそのステップで、実際の更新量の分散は 0 なのである。
第三に、見るべきは更新量の大きさだ。 彼らは、勾配がある極小値のまわりで純粋に平均 0 のノイズになる状況をシミュレーションし、Adam を走らせて更新量を見た。すると更新量は から始まり、約 40 ステップ後にようやく 前後で落ち着いた。つまり、モデルがすでに極小値にいても、Adam は最初の数十ステップで大きすぎる歩幅を踏み出す。同じ状況で SGD にはウォームアップが要らないので、Adam が SGD よりウォームアップを必要とする理由も、これで一部は説明がつく。
こうした分析を踏まえて、彼らは調整不要な経験則を二つ提案した。
前者の時定数 は、Adam の二次モーメントのバイアス補正項 にならって選んだもので、この直感はまったくの推測だと著者ら自身も書いている。後者は ステップの線形ウォームアップで、 ならちょうど 2,000 ステップになる。
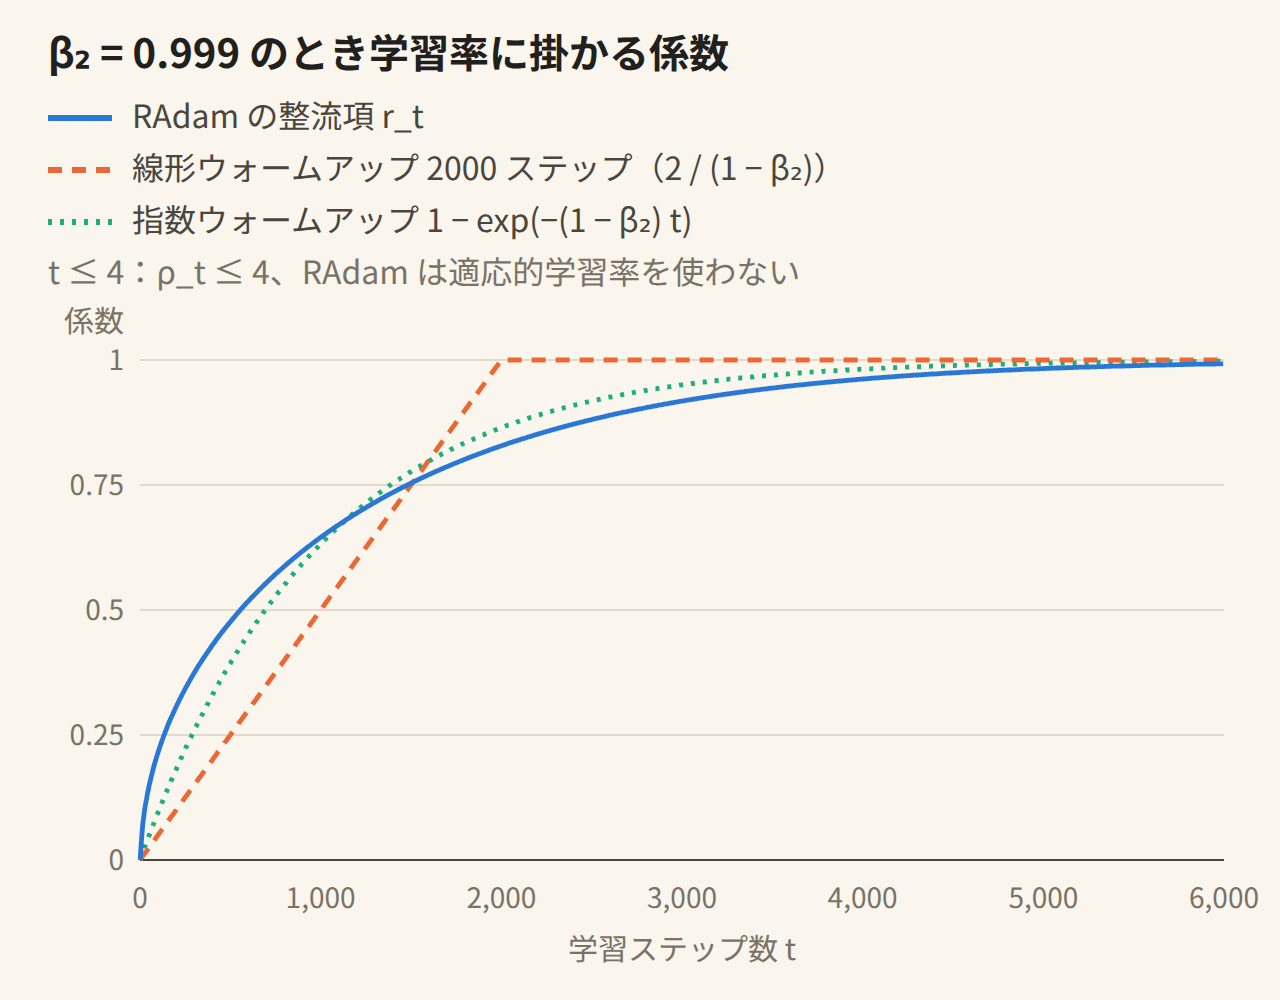
3 本の曲線の形は完全には一致しない。RAdam は最初の数百ステップで最も速く立ち上がるが、1,500 ステップあたりを過ぎるとかえって最下位になる。Ma と Yarats は「実効ウォームアップ長」、つまりウォームアップが合計で何ステップ分の学習率を削ったかで比べた。 では三つとも 1,000 ステップ前後(式どおりに計算すると RAdam は約 1,033 ステップ)で、しかもさまざまな でほとんど同じになる。
実験もこの主張を支持している。彼らは ImageNet の ResNet-50、WikiText-103 の Transformer 言語モデル、WMT16 英独の Transformer で、それぞれ 9〜12 通りの学習率と の組み合わせを掃引し、三つの手法の差はたいていコンマ数ポイントにとどまった。ImageNet の top-1 誤差を例にとると(5 個の乱数シード)、次のとおり。
| 学習率 | 指数 | 線形 | RAdam | |
|---|---|---|---|---|
| 0.99 | 27.9 | 28.0 | 28.4 | |
| 0.997 | 27.9 | 27.9 | 28.3 | |
| 0.999 | 28.2 | 28.3 | 28.4 |
Ma & Yarats の Table 1 をもとに整理。学習率 の 3 行を抜粋(%)。
この 3 行では、RAdam のほうがかえってわずかに悪い。表全体で差が最も大きいのは学習率 、 の組で、RAdam の誤差は二つの経験則より約 1 ポイント高い。彼らの勧めは、Adam を使うなら ステップの線形ウォームアップをすることだ。
どちらが正しいのか
二つの論文は、Adam が最初の数千ステップでは小さめの学習率を必要とする点では一致していて、食い違うのはその理由だ。
RAdam 側の証拠は、Adam-2k のような対照実験と、翻訳と画像でしっかり調整したウォームアップと互角だったことだ。Ma と Yarats の側は、 は で決まる固定のスケジュールにすぎないと指摘し、更新量の分析と三つのタスクにまたがる実験で、調整不要な線形ウォームアップで同じことができると示した。RAdam 論文の正式版はこの反論に応えていない。もっとも README の FAQ では、勾配の平均が分散よりずっと大きいときには分散の問題はそれほど大きくないかもしれないと認め、それを一部のモデルでウォームアップがより必要になる理由の候補として挙げている。
平均 0 という仮定については、RAdam 論文自身が 5.3 節でシミュレーションによって確かめている。勾配を からサンプリングし、 を 0、0.001、0.01、0.1、1、10 の 6 通り、 として、それぞれ 6,000 ステップの軌跡を 5,000 本走らせた。6 通りすべてで、生の適応的学習率の分散は初期に大きく、整流後はおおむね一定に保たれた。同じ節では、式 (5) の一次近似が式 (2) の閉形式とほぼ重なることも確かめている。ただ、このシミュレーションで測っているのはあくまで適応的学習率そのものの分散で、Ma と Yarats が指摘した と の相関には触れていない。
Ma と Yarats も、問題を解決しきれてはいない。彼らのシミュレーションでは更新量は約 40 ステップで落ち着くので、その理屈なら数百ステップのウォームアップで足りるはずだ。ところが RAdam でも彼らの経験則でも、実効ウォームアップは 1,000 ステップ前後あり、手で調整したウォームアップには 1 万ステップまで延ばしたものさえある。Adam がなぜこれほど長いウォームアップを必要とするのかは未解決の問題だと、彼ら自身が議論の中で書いている。
エンジニアリングの立場から見ると、実務上の結論は両者で一致していて、RAdam は長さ約 ステップのウォームアップと等価だ。ここから見落としやすい帰結が一つ出てくる。のちの大規模言語モデルでは を 0.95 にすることが多い。GPT-3 や LLaMA がそうだ。このとき で、式どおりに計算すると RAdam に組み込まれた実効ウォームアップはわずか約 24 ステップになる。一方、LLaMA が実際に使ったのは 2,000 ステップのウォームアップだ。
整流項そのものは、その後も残った。PyTorch には torch.optim.RAdam が組み込まれ、Schedule-Free の公式パッケージも 2024 年末にコミュニティ提供の RAdam 版を取り込んだ。その説明には、ウォームアップまで省けると書かれている。
結論
RAdam は Adam の適応的学習率から出発し、SMA 近似で第 ステップの等価サンプル数 を見積もり、整流項 で分散を一定にそろえる。 となる最初の数ステップは、そのままモーメンタム SGD に退化する。翻訳と画像分類では、ウォームアップ長を別に設定しなくても(翻訳実験の は特別にそろえてあったが)、調整済みの Adam + ウォームアップに追いつけた。その後 Ma と Yarats は、 は で決まる固定のウォームアップにすぎず、単純な線形ウォームアップでほぼ同じ結果が得られると指摘した。
すでに調整済みのウォームアップが手元にあるなら、RAdam に替えても得るものはたいしてないだろう。ないなら、RAdam と「 ステップの線形ウォームアップ」は、どちらも同じくらい頼れる出発点になる。ただし、RAdam を使うときに を変えると、ウォームアップの長さも同時に変わることは覚えておきたい。
README は冒頭で、ウォームアップが答えなら問いは何か、と問うていた。Ma と Yarats の答えは、Adam の初期の更新量が大きすぎることだ。では、なぜこれほど長くウォームアップしなければならないのか。それは自分たちにもまだわからないと、彼ら自身が認めている。