原論文
Chain-of-Thought Prompting Elicits Reasoning in Large Language Models
- 発表先
- NeurIPS 2022国際会議
- arXiv への初回投稿
- arXiv:2201.11903
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{transformerschainofthought2022,
  title = {{Chain-of-Thought Prompting Elicits Reasoning in Large Language Models}},
  author = {Jason Wei and Xuezhi Wang and Dale Schuurmans and Maarten Bosma and Brian Ichter and Fei Xia and Ed Chi and Quoc Le and Denny Zhou},
  year = {2022},
  eprint = {2201.11903},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2201.11903}
}
「レストランにリンゴが 23 個あり、昼食に 20 個使って、さらに 6 個買った。今いくつあるか?」
小学生なら簡単に解ける問題だ。ところが 2022 年初めの大規模言語モデルに、プロンプトで「問題と答え」の例を一つ見せてから解かせると、その形式どおりにいきなり「27」と答える。
Google の Wei、Wang、Schuurmans、Zhou らがこの論文で変えたことは一つだけだ。例題の答えの前に、解き方を数行書き足した。
Q: Roger has 5 tennis balls. He buys 2 more cans of tennis balls.
   Each can has 3 tennis balls. How many tennis balls does he have now?
A: Roger started with 5 balls. 2 cans of 3 tennis balls each is 6 tennis balls.
   5 + 6 = 11. The answer is 11.
するとモデルも、先に過程を書いてから答えを書くようになり、23 − 20 = 3、3 + 6 = 9 と計算する。著者らはこの途中の過程を思考の連鎖(chain of thought)と呼び、このプロンプトの与え方を思考の連鎖プロンプトと呼んだ。
手法に微調整は要らず、新しいモデルも要らない。論文はこの現象を、どのタスクで効くのか、どれほど大きなモデルが必要か、効果はどこから来るのか、もっともらしく見える説明のうちどれが成り立たないのかまで、きちんと測っている。
問題の定義
言語モデルを大きくすると、多くのタスクの性能は着実に上がる。例外が算術、常識、記号推論だ。DeepMind の Gopher の論文も、モデルを大きくするだけではこの種のタスクの性能は伸びないと指摘している。
著者らは既存の二つの路線からヒントを得た。一つ目は、モデルに途中のステップを生成させる路線だ。たとえば Ling らは 2017 年に、自然言語で書いた解答の根拠を使って数学の問題を解くモデルを訓練し、OpenAI の Cobbe らは 2021 年に小学校レベルの数学データセット GSM8K を公開して、解き方つきのデータで GPT-3 を微調整した。問題は、質の高い解き方を大量に書くのが高くつくことで、通常の入出力ペアよりずっと集めにくい。
二つ目は、GPT-3 が広めた少数ショットプロンプトだ。プロンプトに例をいくつか入れておけば、タスクごとにモデルを微調整する必要がない。単純な質問応答タスクではよく効くが、推論が必要なタスクになるとうまくいかず、モデルを大きくしてもあまり助けにならない。
どちらにも長所があり、限界もある。著者らが知りたかったのは、推論過程つきの例をいくつかプロンプトに入れるだけで、モデルに多段階の推論をさせられないか、ということだ。
問題を解く
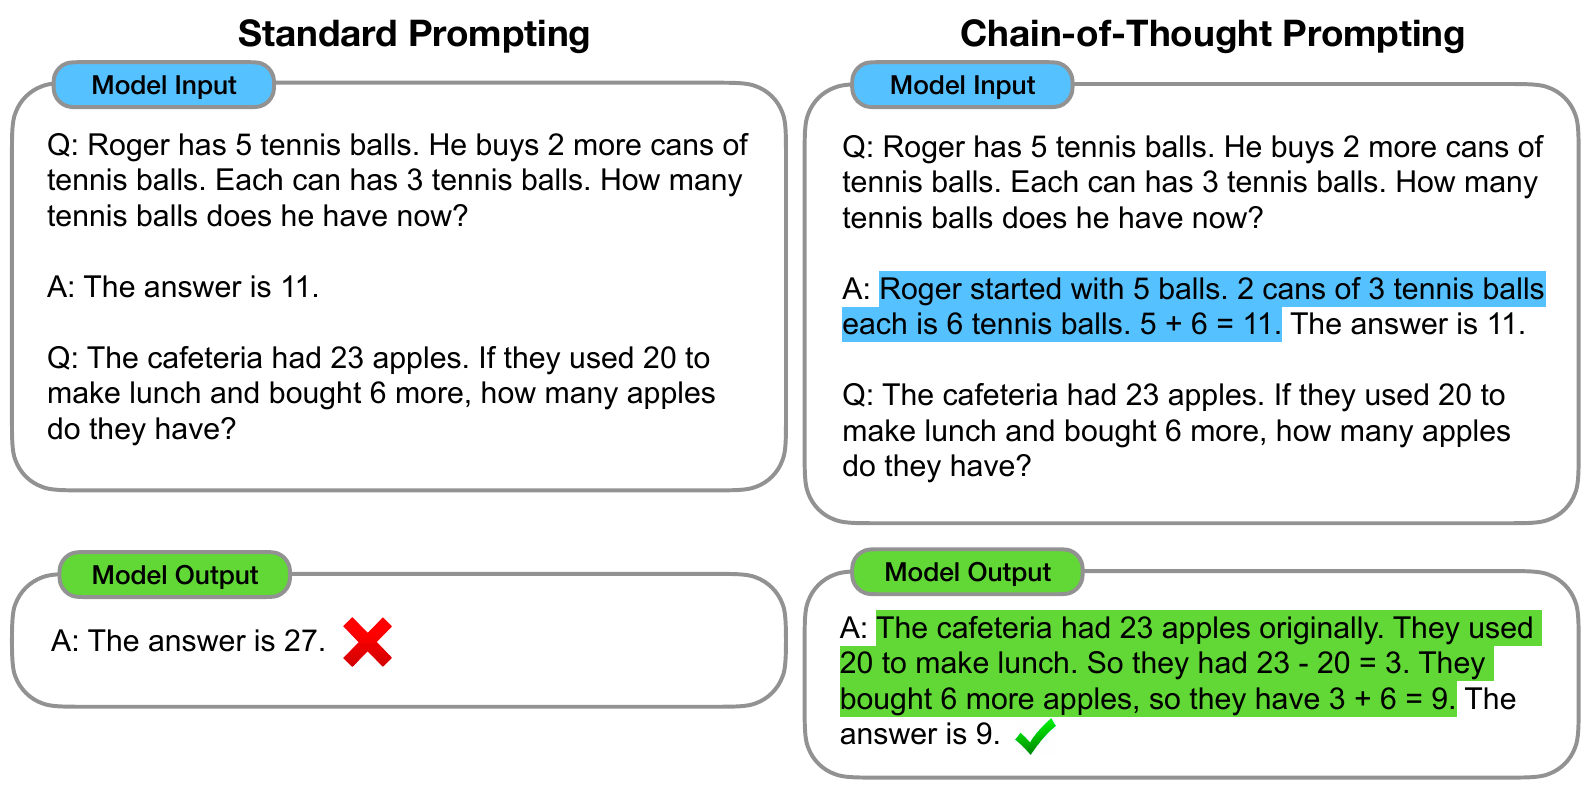
左右のプロンプトの違いは、例の答えの前にある青い文字の部分だけだ。右のモデルは「一歩ずつ計算せよ」とは言われていない。例の形式をまねて、先に過程を書き、それから答えを出しているだけだ。
標準的な少数ショットプロンプトでは、各例は(入力、出力)の組だ。思考の連鎖プロンプトでは、これを(入力、思考の連鎖、出力)の三つ組にする。著者らは数学の文章題用に 8 個の例を手書きし、ほぼすべての算術の評価に使い回した。選択式の AQuA だけは、訓練セットから別に 4 個の例を取った。著者らは、この例の組はプロンプトエンジニアリングで調整していないと強調している。
著者らは思考の連鎖の利点を四つ挙げる。
- 多段階の問題を途中のステップに分解でき、難しい問題ほど多くの計算を割り当てられる。
- モデルがどうやって答えにたどり着いたかが見え、推論がどのステップで誤ったかも見つけやすい。ただし著者らは、モデル内部で実際にどう計算しているかはまだ未解決の問題だとも述べている。
- 原理的には、人間が言葉で解けるどんなタスクにも使える。
- 既存の大規模モデルでも、プロンプトの例に思考の連鎖を加えるだけで使える。
実験設定
著者らは三種類の推論タスクを試した。
- 算術:GSM8K、SVAMP、ASDiv、AQuA、MAWPS の五つの数学文章題データセット。
- 常識:CSQA、StrategyQA、BIG-bench の日付理解とスポーツ理解、そして自然言語の指示をロボットの動作列に変換する SayCan。
- 記号:名前の各単語の最後の文字をつなげるタスクと、何人かがコインを裏返したり裏返さなかったりした後に、コインが表を向いているかを追うタスク。
モデルは全部で五系統だ。OpenAI API の GPT-3 四モデル(text-ada-001 から text-davinci-002 まで。著者らは 3.5 億から 1,750 億パラメータの InstructGPT に対応すると推測している。OpenAI が明かしていないので、論文原文は「presumably」と書いている)、LaMDA(4.22 億から 1,370 億)、PaLM(80 億、620 億、5,400 億)、UL2 20B、そして Codex。結果はすべて貪欲デコーディングによるものだ。LaMDA の結果は 5 通りの例の並び順の平均で、他のモデルはコストの都合で一つの並び順しか試していない。
議論
算術:規模が十分に大きくてはじめて効く
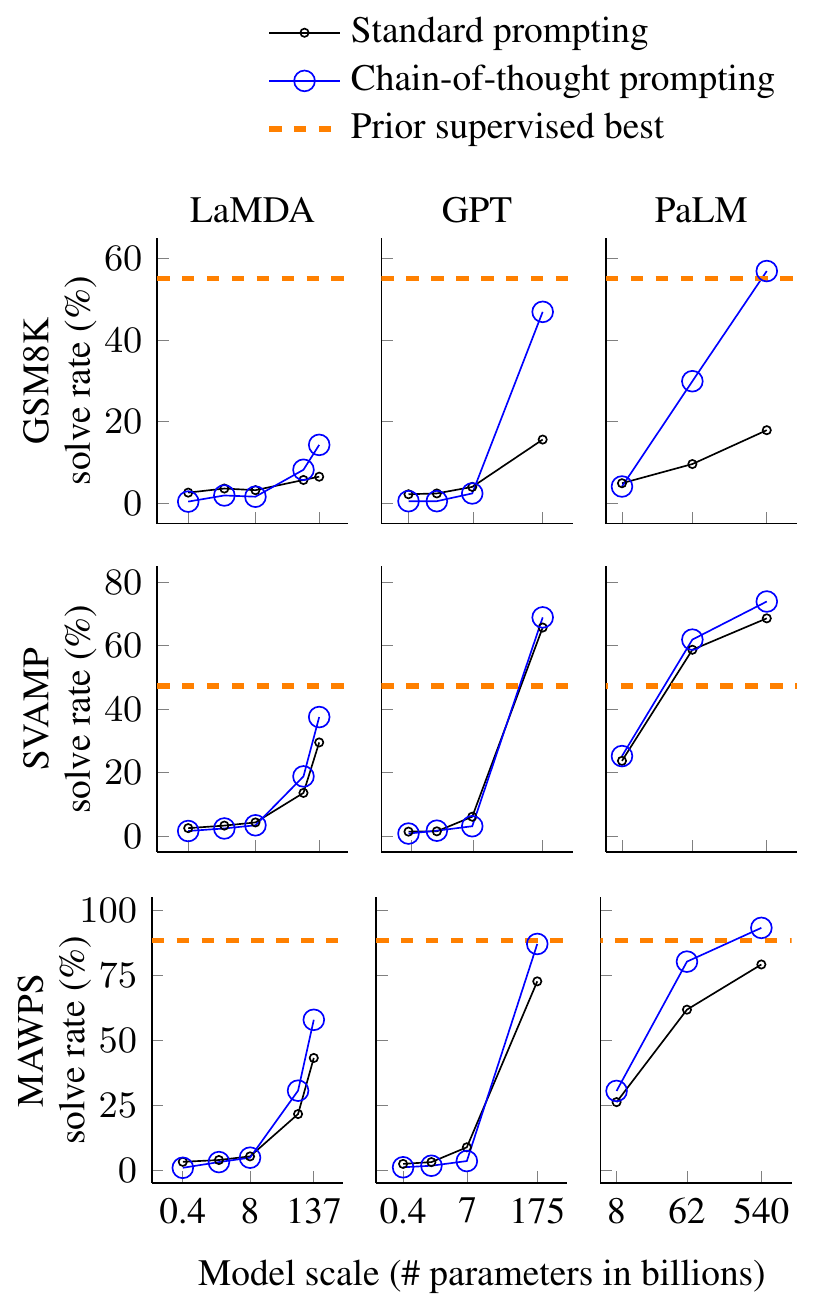
横軸はパラメータ数で、三つの列はそれぞれ LaMDA、GPT、PaLM、三つの行は三つのデータセットだ。黒線は標準プロンプト、青線は思考の連鎖プロンプト、オレンジの破線はそれまでに微調整で得られた最高成績である。
いちばん左の小さいモデルでは二本の線が重なり、青線のほうが低いこともある。著者らが調べたところ、小さいモデルは流暢な思考の連鎖を書けても論理が間違っていて、かえって答えの足を引っ張っていた。約 1,000 億パラメータに達してはじめて、思考の連鎖は差をつけ始める。著者らはこれを、モデル規模に応じて「創発」する能力と呼んだ。
二つ目の観察は、問題が難しいほど改善が大きいことだ。GSM8K はベースラインのスコアが最も低いデータセットで、最大の GPT と PaLM は思考の連鎖を使うとスコアが二倍以上になった。MAWPS のうち一ステップで解ける SingleOp サブセットでは、改善はごくわずかか、マイナスにさえなった。
| モデル | 標準プロンプト | 思考の連鎖プロンプト | 思考の連鎖 + 外部計算機 |
|---|---|---|---|
| LaMDA 137B | 6.5 | 14.3 | 17.8 |
| GPT-3 175B(text-davinci-002) | 15.6 | 46.9 | 49.6 |
| Codex(code-davinci-002) | 19.7 | 63.1 | 65.4 |
| PaLM 540B | 17.9 | 56.9 | 58.6 |
GSM8K の正答率(%)。原論文の付録 Table 1 をもとに整理。
PaLM 540B はわずか 8 個の例だけで、GSM8K の正答率を 17.9% から 56.9% に上げ、それまでの最高成績 55% を上回った。その 55% は、Cobbe らが GSM8K の訓練セットで GPT-3 175B を微調整し、さらに検証器で答えを選んで得たものだ。
最後の列は事後の小さな手直しだ。思考の連鎖の中には、推論も式も正しいのに、数値の計算だけを間違えているものがある。そこで著者らは Python の eval で思考の連鎖の中の各式を計算し直し、その結果を文字列照合で後続の式に代入した。これでほとんどのモデルがさらに数ポイント伸びた。
正しい答えは、正しい過程から出たのか
著者らは、LaMDA 137B が GSM8K で書いた思考の連鎖を人手で確認した。正解した 50 問のうち、推論過程が間違っていて偶然正しい答えに行き着いたのは 2 問だけで、残りの 48 問は推論も計算も正しかった。
間違えた 50 問のうち、46% はあと一歩のもので、たとえば計算ミス、記号の対応づけの誤り、一ステップの抜けだった。残りの 54% には、意味理解や一貫性の大きな誤りがあった。著者らは PaLM 62B と 540B の誤りも比べており、62B から 540B に大きくすると、「一ステップの抜け」と「問題の意味の取り違え」の誤りの多くが解消された。
アブレーション:効果はどこから来るのか
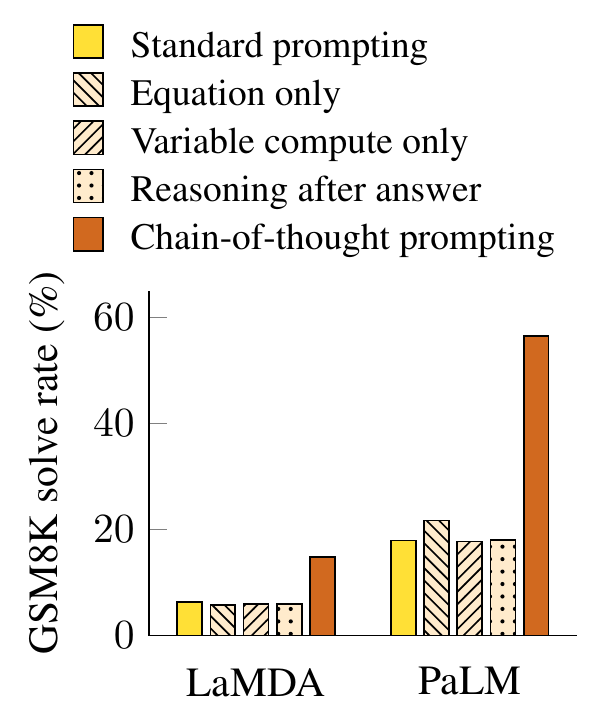
思考の連鎖が効く理由には、いくつかの説明が考えられる。著者らはそれぞれを検証する変種を一つずつ用意した。
- 式だけを書く。肝心なのは、計算すべき式をモデルに書かせることだけなのではないか。GSM8K ではほとんど役に立たず、LaMDA は 6.5 から 5.4 になった。著者らは、GSM8K の問題文は複雑すぎて、自然言語の推論ステップを経ずに式へ直接翻訳するのは難しいと考えている。ただし一~二ステップで解けるデータセットでは、式だけでも確かに効果があり、たとえば SVAMP は 29.5 から 35.1 に上がった。
- 計算量だけを増やす。肝心なのは、モデルに token を多めに生成させ、そのぶん多く計算させることではないか。著者らはモデルに、まず点の列を出力させた。点の数は式の文字数と同じにした。結果は標準プロンプトとほぼ同じ(6.4)だった。
- 答えの後に推論を書く。思考の連鎖は、事前学習で身につけた関連知識を呼び起こしているだけではないか。著者らは推論過程を答えの後ろに移し、答えが推論に頼れないようにした。結果はやはり標準プロンプトとほぼ同じ(6.1)だった。
三つの変種はどれも、思考の連鎖の 14.3 に遠く及ばない。著者らの結論は、途中のステップを自然言語で順に書くこと、そしてそれを答えより前に書くこと、その両方が必要だというものだ。
例の書き方はどれほど影響するか
プロンプト手法は、例に敏感すぎるとよく批判される。著者らは別の共著者二人に、同じ 8 問の思考の連鎖をそれぞれ独立に書いてもらった。元の書き手も GSM8K の解答のスタイルに合わせて、意図的に簡潔にした版を書いた。さらに GSM8K の訓練セットから 8 問ずつ三組を無作為に抜き出し、データセットにあるクラウドソーシングの作業者が書いた解き方をそのまま使った。
LaMDA 137B の GSM8K では、これらの版のスコアは 11.1 から 17.6 の範囲に収まった。互いに確かに差はあるが、どれも標準プロンプトの 6.5 よりはっきり高い。思考の連鎖の効果は、特定の書き手の書き方に左右されない。著者らは、例の順序や数を変えても結果は同じように頑健だと補足している。
常識推論と記号推論
常識推論では、モデルが大きいほど標準プロンプトも思考の連鎖も良くなり、思考の連鎖による改善は PaLM 540B で最も大きかった。StrategyQA は多段階の推論戦略を自分で考え出す必要があるタスクで、PaLM 540B は思考の連鎖で 75.6% を取り、それまでの最高成績 69.4% を上回った。スポーツ理解は、スポーツに関する一文がもっともらしいかを判定するタスクだ。たとえばサッカー選手がアメリカンフットボールの試合でパスを受ける、といった文である。PaLM 540B は 95.4% を取り、補助なしで解いたスポーツ愛好家一人の 84% を上回った。CSQA ではほとんど改善がなかった。
記号推論の二つのタスクは、人間にとってはとても簡単だ。例では二単語の名前や、二人がコインを裏返す場面だけを示す。テストでは同じ長さの問題に加えて、三~四単語の名前のような、より長い問題も出す。
LaMDA 137B は思考の連鎖で、文字の連結が 5.8% から 77.5% に、コインが 49.0% から 99.6% に上がった。PaLM 540B は同じ長さの問題でほぼ 100% に達した。著者らも認めているように、これらの問題は解き方の構造が例の中にすでに全部書かれていて、モデルは同じ手順を新しい記号に当てはめるだけでよい。それでも小さいモデルにはできない。例より長い問題では、標準プロンプトは完全に失敗し、思考の連鎖はモデルが大きくなるにつれて上がっていくが、スコアは同じ長さの問題より低い。
著者らが挙げた限界
著者らは議論の中で四点を挙げている。第一に、思考の連鎖は人の思考過程をまねたものだが、ニューラルネットワークが本当に「推論」しているのかという問いには答えていない(この論争はいまだに決着がついていない)。第二に、少数ショットなら例を数個手書きするのは安いが、微調整に使うとなるとアノテーションのコストが高い。第三に、推論過程が正しいという保証はなく、誤った過程から正しい答えが出ることも、誤った答えが出ることもある。第四に、大規模モデルでしか効かないので、デプロイのコストが高い。
その後の展開
数か月のうちに、この論文に直接続く後続研究がいくつも出た。
東京大学と Google の Kojima らは Large Language Models are Zero-Shot Reasoners で、例すら書かなくても、答えの前に「Let's think step by step」の一文を加えるだけで、text-davinci-002 の GSM8K が 10.4% から 40.7% に上がることを見つけた。
同じチームの Wang らは Self-Consistency で、貪欲デコーディングを複数回のサンプリングに置き換え、毎回異なる思考の連鎖を生成させてから、最終的な答えで多数決を取った。GSM8K はさらに 17.9 ポイント上がった。本論文もデコーディング方法を説明する箇所でこの手法に触れている。
二つ目の利点の「モデルがどうやって答えにたどり着いたかが見える」は、その後検証にさらされた。NYU と Anthropic の Turpin らは 2023 年の Language Models Don't Always Say What They Think で、少数ショットの例の選択肢を並べ替え、正解が常に (A) になるようにした。するとモデルは (A) を選ぶほうへ偏るのに、書いた思考の連鎖はそのことにまったく触れず、むしろ誤った答えにもっともらしい理由をこしらえる。BIG-Bench Hard の 13 タスクで、これにより GPT-3.5 と Claude 1.0 の正解率は最大 36% 下がった。思考の連鎖は、読めば筋が通っているのに、モデルが実際に頼っている手がかりとは食い違っていることがある。
さらに後になると、推論モデルは「先に推論を書いてから答える」こと自体をいっそ訓練の目標にしてしまい、長い推論過程を自分で書くことを強化学習でモデルに身につけさせた。
結論
例の答えの前に過程を数行書き足すだけで、PaLM 540B の GSM8K は 17.9% から 56.9% に跳ね上がった。三つのアブレーションが他の説明を一つずつ退け、自然言語で、しかも答えより前に書いた推論だけが効くことを示した。
使うときは、まずモデルが十分に大きいかを見て、次に問題が何ステップも必要かを見る。一ステップで解ける問題なら、書いても大差ない。モデルが書いた推論を読むときも、あまり真に受けないこと。もっともらしく書かれただけの説明かもしれない。
当時は八個の例を手書きする必要があったのが、四か月後には「Let's think step by step」の一文で済むようになり、さらに二、三年たつと、モデルはもう自分でじっくり長く考えるようになっていた。