原論文
Finetuned Language Models Are Zero-Shot Learners
- 発表先
- ICLR 2022国際会議
- arXiv への初回投稿
- arXiv:2109.01652
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modeltuningflan2021,
  title = {{Finetuned Language Models Are Zero-Shot Learners}},
  author = {Jason Wei and Maarten Bosma and Vincent Y. Zhao and Kelvin Guu and Adams Wei Yu and Brian Lester and Nan Du and Andrew M. Dai and Quoc V. Le},
  year = {2021},
  eprint = {2109.01652},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2109.01652}
}
GPT-3 は少数ショット学習(few-shot learning)の力をみんなに見せつけた。プロンプトに例をいくつか入れておけば、モデルはそれにならって答える。
例を取り除くと、話はかなり変わる。GPT-3 の読解、質問応答、自然言語推論(NLI)といったタスクでのゼロショットの成績は、少数ショットより明らかに劣っていた。著者らの推測では、例がないと、モデルが向き合うプロンプトの形式が事前学習データとかけ離れすぎている。たとえば NLI はある文が別の文から導けるかを判断するタスクだが、こうした問題がウェブのテキストに自然な形で現れることはほとんどない。
Google の Wei、Bosma、Zhao、Guu らは 2021 年 9 月、とても素直な方法を提案した。多くの NLP タスクは「この映画レビューは肯定的か、否定的か?」のように一文で説明できるのだから、既存の何十ものデータセットをすべて自然言語の指示に書き直して言語モデルを微調整し、見たことのないタスクをこなせるかを確かめればいい。彼らはこの方法を指示チューニング(instruction tuning)と呼び、微調整したモデルを FLAN(Finetuned Language Net)と名づけた。この名前はのちにモデルそのものより有名になり、Flan-T5 や Flan-PaLM にも受け継がれている。
問題の定義
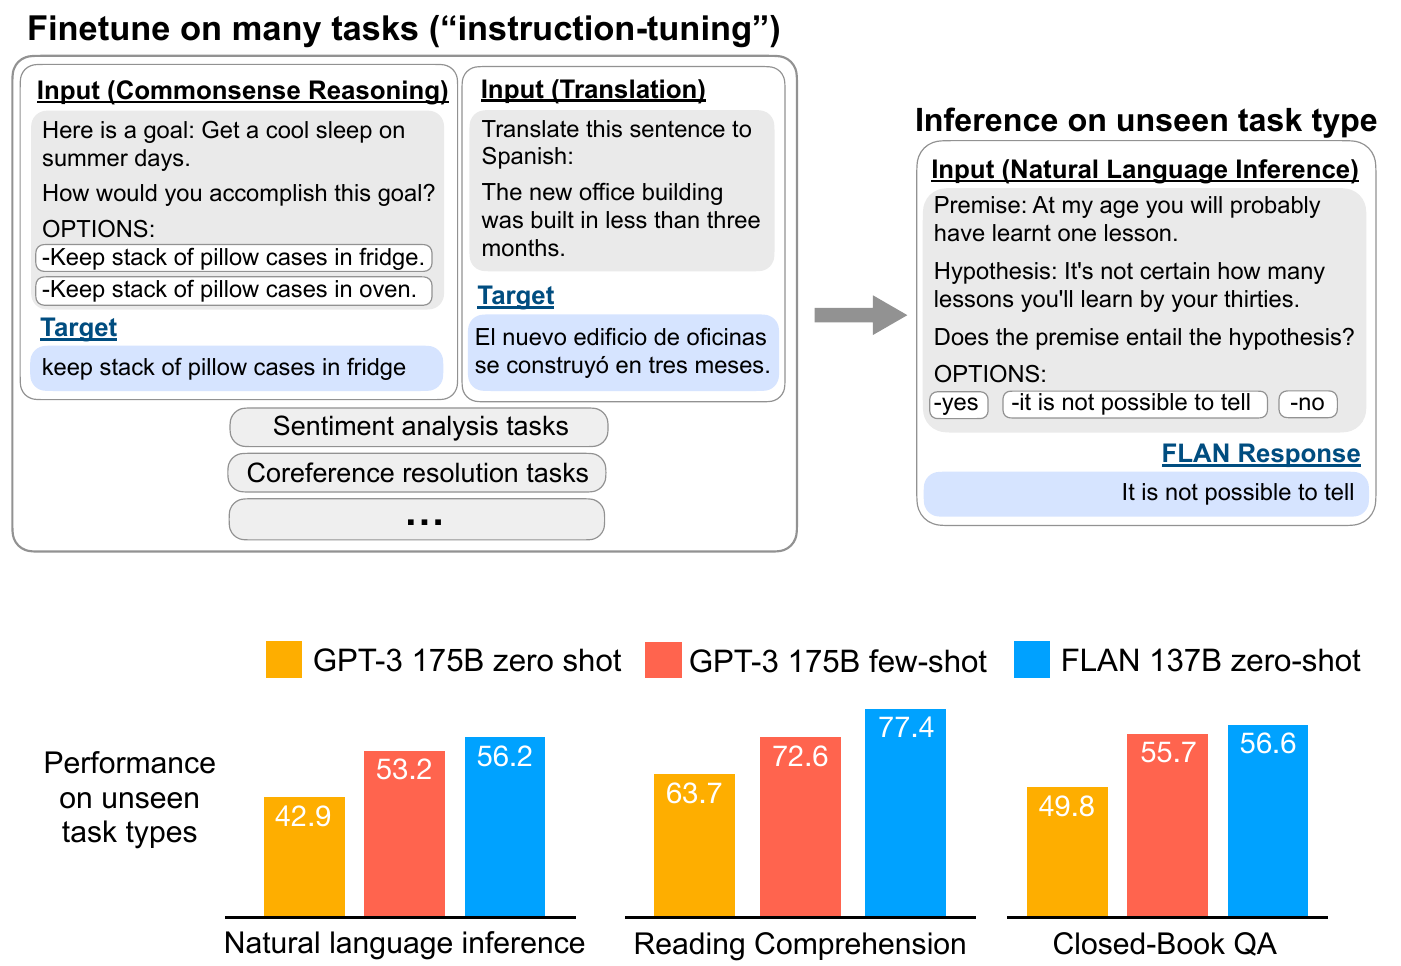
図の上半分が実験全体の設計だ。訓練では、モデルは常識推論、翻訳、感情分析など多くのタスクを見るが、どの問題も指示の形で書かれている。テストでは自然言語推論の問題を一つ与えるが、モデルは訓練中に推論タスクを一つも見ていない。
下半分は結果の予告だ。見たことのない三種類の問題タイプで、FLAN 137B のゼロショットは GPT-3 175B のゼロショットを上回り、GPT-3 の少数ショットさえ上回る。
著者らは指示チューニングを、既存の二つのやり方の中間に位置づける。一つは BERT や T5 の「事前学習してから微調整」で、タスクごとに大量のラベル付きデータが必要になり、最後に得られるのは専用のモデルだ。もう一つは GPT-3 の「プロンプト」で、微調整はせず、少数ショットの例や練り込んだプロンプトに頼る。指示チューニングは多くのタスクの教師信号で微調整するが、目標は、見たことのないタスクの自然言語による説明を、推論時にモデルが理解できるようにすることにある。
ここでいちばんはっきりさせておくべきなのは、「見たことがない」の定義だ。テストに使うデータセットが訓練に出てこないことを求めるだけでは足りない。モデルが MNLI で練習してから RTE を解いたら、どちらも NLI なので、新しいタスクをこなしているとは言いにくい。
問題を解く
データセットを指示に書き直す
著者らは TensorFlow Datasets から公開のテキストデータセットを 62 個集めた。理解タスクと生成タスクの両方を含み、タスクの種類ごとに 12 のクラスタ(cluster)に分けた。たとえば自然言語推論が 7 データセット、読解が 5、クローズドブック質問応答が 3、翻訳が 8、要約が 11 だ。
各データセットには、人手で 10 種類の指示テンプレートを書いた。ほとんどのテンプレートは元のタスクを説明するものだが、多様性を増やすため、各データセットで最大 3 個のテンプレートは「タスクをひっくり返す」。たとえば感情分類のデータセットを、映画レビューを書かせるのにも使う。同じ NLI のデータでも、何通りもの問い方に当てはめられる。
テンプレート 1:
<premise>
Based on the paragraph above, can we conclude that <hypothesis>?
<options>

テンプレート 3:
Read the following and determine if the hypothesis can be inferred from the premise:
Premise: <premise>
Hypothesis: <hypothesis>
<options>
訓練では、各データにそのデータセットのテンプレートを一つランダムに選んで当てはめる。
分類問題には選択肢を付ける
FLAN はデコーダだけの言語モデルなので、生成タスクならそのまま答えられる。厄介なのは分類問題だ。GPT-3 のやり方は「ランク分類」で、たとえば「yes」と「no」の二語の確率だけを比べ、高いほうを取る。著者らは、「yes」にはいろいろな言い方がありうるので、確率が分散してしまうと指摘する。
そこで FLAN は分類問題の末尾に OPTIONS: とすべてのクラスを付け、どの答えから選ぶべきかをモデルに知らせる。たとえば図の NLI の問題なら「yes / it is not possible to tell / no」だ。
問題タイプごと除外してテストする
評価では、著者らはかなり保守的な定義を採用している。データセット が未見タスクとみなされるのは、それが属するクラスタ全体が微調整に一度も出てこなかった場合だけだ。NLI をテストするなら、NLI クラスタの 7 データセットをすべて除き、残りのクラスタで微調整する。性質の近いクラスタもあわせて除外し、たとえば NLI をテストするときは「言い換え判定」のクラスタも使わない。
つまり 個のクラスタを評価するには、 個の異なる FLAN を訓練し、それぞれ一つのクラスタを除外しなければならない。コストは上がるが、こうしてはじめて「見たことのない問題タイプ」を測れる。
訓練設定
ベースモデルは LaMDA-PT で、1,370 億パラメータのデコーダだけの言語モデルだ。ウェブページ(コードを含む)、対話データ、Wikipedia で事前学習され、合計 2.49 兆 BPE token、約 10% は英語以外だ。LaMDA-PT は言語モデルの事前学習だけを済ませたもので、後の LaMDA のような対話向けの微調整はまだ受けていない。
各データセットの大きさの釣り合いを取るため、データセットごとに最大 3 万件を取り、T5 の「データ量に比例した混合」(T5 の論文で一つずつ比べられた混ぜ方だ)を使って、比率の上限を 3,000 にした。たとえば三つのデータセットがそれぞれ 10 万件、2 万件、1,000 件なら、3 万件で切ると 3 万、2 万、1,000 になる。比率の上限によって前の二つはどちらも 3,000 として扱われるので、サンプリングの比率は 3:3:1 だ。大きなデータセットが小さなデータセットを埋もれさせることはない。
微調整は 3 万ステップ、一バッチ 8,192 token、Adafactor で学習率 、入力と出力の長さはそれぞれ 1,024 と 256。128 コアの TPUv3 で約 60 時間かかり、勾配更新のステップ数は事前学習の 2% に満たない。
議論
主な結果
比較対象は三組ある。最も直接的なのは、同じ LaMDA-PT を微調整せずに、GPT-3 論文のプロンプトでゼロショットと少数ショットを行うもので、この比較から指示チューニングそのものの効果がそのまま測れる。ほかの二組は GPT-3 175B と GLaM 64B/64E で、数字はそれぞれの論文から取っている。
FLAN の成績には二通りの計算方法がある。一つはすべてのテンプレートの平均で、適当に自然な指示を書いたときにだいたいどれくらい取れるかを表す。もう一つは開発セットで最良のテンプレートを選んでからテストセットの成績を報告するもので、GPT-3 論文の「開発セットでプロンプトを調整できる」状況に対応する。最良のテンプレートを選んだ場合、FLAN のゼロショットは 25 データセットのうち 20 で GPT-3 のゼロショットを上回り、10 では GPT-3 の少数ショットさえ上回った。
いくつかのデータセットを見てみよう。
| データセット | LaMDA-PT ゼロショット | GPT-3 ゼロショット | GPT-3 少数ショット | FLAN ゼロショット(テンプレート平均) | FLAN ゼロショット(最良テンプレート) |
|---|---|---|---|---|---|
| ANLI R1 | 39.6 | 34.6 | 36.8 | 47.7 ± 1.4 | 46.4 |
| RTE | 73.3 | 63.5 | 72.9 | 78.3 ± 7.9 | 84.1 |
| CB | 42.9 | 46.4 | 82.1 | 64.1 ± 14.7 | 83.9 |
| BoolQ | 81.0 | 60.5 | 77.5 | 80.2 ± 3.1 | 82.9 |
| OBQA | 41.8 | 57.6 | 65.4 | 77.4 ± 1.3 | 78.4 |
| ARC-c | 42.0 | 51.4 | 51.5 | 61.7 ± 1.4 | 63.1 |
| HellaSwag | 57.0 | 78.9 | 79.3 | 56.4 ± 0.5 | 56.7 |
| Winogrande | 68.3 | 70.2 | 77.7 | 67.3 ± 2.5 | 71.2 |
原論文付録の Table 2 をもとに整理。数値は正解率。
NLI の伸びが最も目立つ。著者らは GPT-3 論文の観察を引いている。NLI の問題はウェブのテキストに自然に現れることがほとんどなく、文の続きを書かせる形にするとかなり不自然になる。FLAN なら「<前提> ということは、<仮説> ということか?」と直接尋ねられる。クローズドブック質問応答(ARC)と読解(MultiRC、OBQA)も大きく伸びた。
表からは指示への敏感さも見て取れる。CB のテンプレート平均は 64.1 で、標準偏差は 14.7 にもなる。問い方を変えるだけで、スコアが十数ポイント変わりうるということだ。最良のテンプレートでは 83.9 に達する。
最後の二行は反例だ。HellaSwag と Winogrande はもともと「文を最後まで続ける」タスクで、言語モデルの事前学習の目的とほぼ同じなので、指示は余計なものになる。この種の常識推論と共参照解決のタスクで、FLAN が未微調整の LaMDA-PT を上回ったのは 7 つのうち 3 つだけだった。HellaSwag で GPT-3 の 78.9 が LaMDA-PT よりずっと高いのはベースモデルの差によるもので、指示チューニングは役に立っていない。
翻訳はその中間だ。FLAN は 6 つの翻訳方向すべてで GPT-3 のゼロショットを上回るが、多くは GPT-3 の少数ショットに負ける。英語への翻訳は成績がよく、英語から他言語への翻訳は弱い。著者らは、英語中心の SentencePiece 語彙と事前学習データが関係していると考えている。
アブレーション:クラスタ数、モデルサイズ、指示そのもの
クラスタが多いほど性能が上がる。 著者らは NLI、クローズドブック質問応答、常識推論の三つのクラスタを固定で除外し、ほかのクラスタを一つずつ加えて微調整した。1 個から 7 個まで(11 から 39 データセット)だ。除外した三クラスタの平均性能は 49.9 から 63.5 まで上がり続けた。唯一の例外は感情分析のクラスタを加えたステップで、ほとんど効果がなかった。7 クラスタまで加えても曲線はまだ飽和していない。
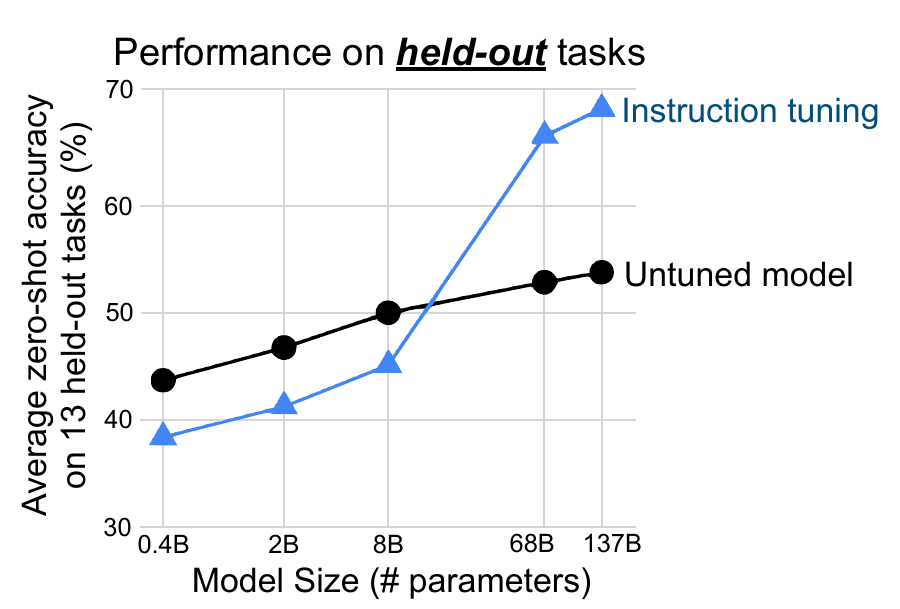
小さなモデルはかえって悪くなる。 同じクラスタの分け方で、著者らは 4.22 億から 1,370 億パラメータまでの五つのモデルに指示チューニングを行った。黒い線は未微調整のモデル、青い線は微調整後だ。68B と 137B では伸びが大きく、137B は約 54 から約 68 に上がる。しかし 8B 以下では、指示チューニング後の成績が未微調整を下回る。
著者らは一つの仮説を立てている。小さなモデルにとっては、約 40 個の微調整タスクを覚えるだけでモデルの容量を使い切ってしまい、新しいタスクに汎化する余力がない。大きなモデルはこれらのタスクを覚えたあとも容量に余裕があり、ついでに「指示どおりに動く」ことも覚える。論文はこの説明をそれ以上検証していない。
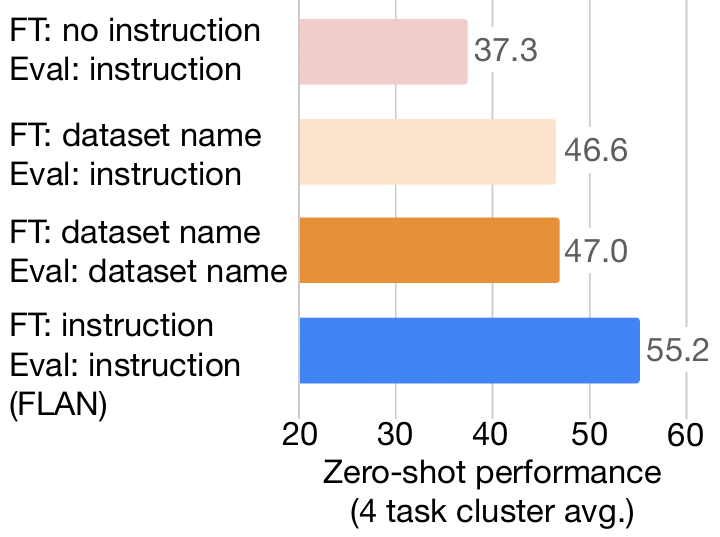
指示そのものが鍵になる。 伸びは単にマルチタスク微調整の効果で、指示とは関係ないのではないか。著者らは指示なしの微調整を二通り行った。一つは入力と出力だけを与えるもので、翻訳なら「The dog runs.」を入力し「Le chien court.」を出力する。もう一つは入力の前にタスク名とデータセット名を付けるもので、たとえば「[Translation: WMT'14 to French] The dog runs.」だ。
入力と出力だけの版は、評価で指示を使うと平均でわずか 37.3 だった。データセット名を付けた版は、指示で評価すると 46.6、名前で評価すると 47.0。指示で微調整し指示で評価する FLAN は 55.2 だ。マルチタスクのデータは確かに役立つが、見たことのないタスクに汎化させるには、訓練の段階で自然言語でタスクを説明しておく必要がある。
ほかの手法との組み合わせ
指示チューニングは少数ショットの例と一緒に使うこともできる。著者らは推論時に、最大 16 個の例を同じ指示の形式に当てはめ、問題の前につなげた。どのクラスタでも成績はさらに上がり、翻訳、構造化データからテキストへの変換、クローズドブック質問応答のように出力形式が比較的複雑なタスクで伸びが最も大きかった。テンプレート間の標準偏差も小さくなり、プロンプトの書き方にあまり左右されなくなった。
もう一つの実験は prompt tuning で、モデルを凍結し、入力の前につなげた短い連続ベクトルだけを訓練する。SuperGLUE では、FLAN から出発した prompt tuning は、LaMDA-PT から出発したものより常によかった。著者らによれば、特に訓練データが 32 件しかないときは、10% を超える改善になることが多い。
限界
著者ら自身がいくつか挙げている。タスクをどのクラスタに入れるかには、ある程度の主観が入る。指示はどれも短く、たいてい一文だけで、クラウドソーシングでアノテーターに渡す詳しい説明とはかなり違う。テスト問題が事前学習のウェブデータに含まれている可能性もあるが、付録の事後分析では、データの重複が結果に目立った影響を与えた形跡は見つからなかった。それから、1,370 億パラメータのモデルはデプロイのコストが高い。
後続研究はこの論文にどう応えたか
同じ時期、Hugging Face が主導する BigScience は T0 を発表した。似た方法で、110 億パラメータの T5 にプロンプト形式のマルチタスク訓練を行い、やはりゼロショット能力の向上を観察している。これは FLAN の「8B 以下では悪くなる」という結果と完全には一致しない。両者はベースモデルも、タスクやテンプレートの数も違う。
一年後、Google の Chung らは Scaling Instruction-Finetuned Language Models で微調整タスクを 1,836 個まで増やし、思考の連鎖(chain-of-thought)のデータも加えた。MMLU や BBH などの評価では、8,000 万パラメータの Flan-T5-Small でさえ元の T5-Small より伸びた。この評価は本論文の「問題タイプごと除外する」設定とは違うので、二つの結論は直接突き合わせられない。この結果からわかるのは、小さなモデルが指示チューニングの恩恵を受けられるかどうかは、タスクの数と多様性に大きく左右されるということだ。
OpenAI は InstructGPT の論文で、別の角度から検証している。FLAN と T0 のデータで 175B の GPT-3 を微調整し、実際の API ユーザーのプロンプトで比べた。この二つのモデルは元の GPT-3 よりよかったが、アノテーターのデモンストレーションだけで教師あり微調整したモデルには負けた。InstructGPT の出力が好まれた割合は、FLAN 版に対して 78%、T0 版に対して 79% だった。彼らの説明では、公開の NLP データセットは自動採点しやすい分類や質問応答が中心だが、実際の利用ではそれが約 18% にすぎず、自由な生成やブレインストーミングが約 57% を占めるという。
結論
既存の 62 個のデータセットを指示に書き直して 137B のモデルを微調整すると、一度も練習したことのない問題タイプで GPT-3 のゼロショットを上回る。手間はすべて実験設計にかけられている。問題タイプをまるごと除外して試験問題にし、伸びが指示そのものから来ていることもわざわざ証明した。
自分で指示データを用意するなら、そのまままねできることが二つある。タスクの種類は多いほどよい。同じタスクでも問い方を何通りか用意しておいたほうがよい。言い方を変えるだけで、スコアが十数ポイント変わることもあるからだ。
いまや指示チューニングと聞いて思い浮かぶのはチャットボットだ。だがそのいちばん最初の姿は、書き直された NLP の試験問題の束だった。