Article original
Sophia: A Scalable Stochastic Second-order Optimizer for Language Model Pre-training
- Publication
- ICLR 2024Conférence
- Premier dépôt sur arXiv
- arXiv:2305.14342
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizerssophia2023,
  title = {{Sophia: A Scalable Stochastic Second-order Optimizer for Language Model Pre-training}},
  author = {Hong Liu and Zhiyuan Li and David Hall and Percy Liang and Tengyu Ma},
  year = {2023},
  eprint = {2305.14342},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.14342}
}
Quand on dit qu'un optimiseur est « deux fois plus rapide qu'Adam », comment le mesure-t-on au juste ?
Dans cet article, Hong Liu, Zhiyuan Li, David Hall, Percy Liang et Tengyu Ma, de Stanford, consacrent une sous-section à cette question. La méthode de référence doit avoir son taux d'apprentissage et sa planification réglés au mieux pour un nombre total d'étapes fixé à l'avance ; la nouvelle méthode ne fait que étapes, et sa perte finale doit être inférieure ou égale à celle de la référence, pas « à peu près pareille ». Ils rappellent aussi qu'une planification en cosinus s'étire avec le nombre total d'étapes, et que comparer avec un checkpoint intermédiaire de l'entraînement à étapes biaise la conclusion.
Selon ce critère, ils affirment que Sophia atteint sur GPT-2 la perte de validation d'AdamW en deux fois moins d'étapes, avec un temps et une mémoire par étape quasiment inchangés.
Cette note examine d'abord le fonctionnement de Sophia, puis ce que d'autres ont mesuré de ce « deux fois » par la suite.
Définir le problème
Adam ne regarde que l'amplitude du gradient
Le dénominateur d'Adam est la racine carrée de la moyenne mobile des carrés du gradient. Quand la direction du gradient est stable, vaut environ , et chaque coordonnée avance d'un pas proche de , que le paysage soit raide ou plat dans cette direction.
Or, dans le paysage de perte d'un modèle de langage, la courbure varie énormément d'une direction à l'autre. Les auteurs ont mesuré la hessienne diagonale d'un GPT-2 de 125 millions de paramètres, et l'amplitude de ses éléments positifs est très dispersée.
Un exemple en deux dimensions
Les auteurs l'illustrent avec une fonction séparable en deux dimensions, , où est très raide et très plate.
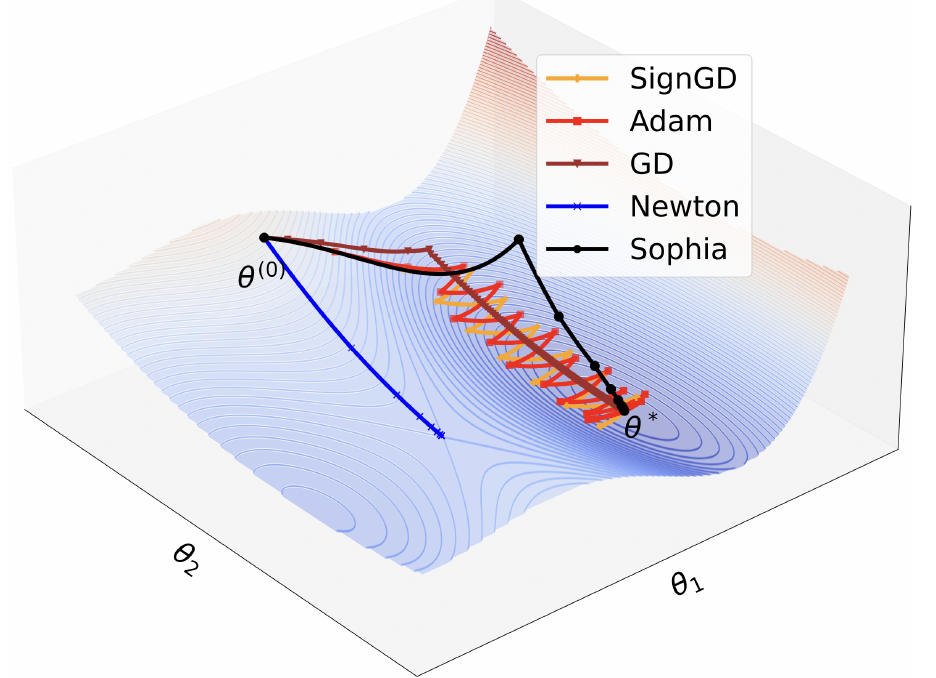
Chaque courbe part de , en haut à gauche, et vise , en bas à droite.
Le taux d'apprentissage de GD est limité par la direction la plus raide ; il ne peut guère dépasser l'inverse de la courbure dans cette direction, faute de quoi GD diverge. Ce taux est trop petit pour la direction plate, d'où la lenteur de la courbe rouge foncé le long de .
La version simplifiée d'Adam est SignGD, qui avance de à chaque pas dans les deux directions. Dans la direction plate, ce pas ne fait baisser la perte que d'un tout petit peu ; dans la direction raide, trois pas suffisent pour atteindre le fond de la vallée, après quoi il se met à rebondir. Pour l'arrêter, il faudrait faire décroître jusqu'à 0, ce qui ralentit encore la direction plate. Sur la figure, Adam en rouge et SignGD en orange se superposent presque, et avancent tous deux en zigzag dans la vallée.
D'après les manuels d'optimisation convexe, le préconditionneur idéal est la hessienne. Dans cet exemple séparable, la méthode de Newton divise le gradient de chaque direction par la courbure de cette direction ; le pas rétrécit automatiquement dans la direction raide et s'allonge dans la direction plate. L'ennui, c'est que a une portion de courbure négative, où la méthode de Newton se dirige vers un maximum ou un point selle ; la courbe bleue converge ainsi vers un point selle. Sur un vrai modèle, la courbure change en plus rapidement le long de la trajectoire d'entraînement, et l'information du second ordre n'est pas toujours fiable.
Les méthodes du second ordre coûtent trop cher
Les méthodes du second ordre existantes posent aussi un problème de coût. Les approximations diagonales par blocs comme K-FAC sont trop chères pour les grands modèles de langage ; AdaHessian utilise lui aussi la hessienne diagonale comme préconditionneur, mais l'estime presque à chaque étape, pour un coût par étape supérieur à deux calculs de gradient. Les auteurs supposent que si ces méthodes doivent estimer aussi souvent, c'est faute d'un mécanisme de protection contre les estimations erronées.
Le préconditionneur recherché ici doit donc faire trois choses à la fois, mettre à l'échelle selon la courbure comme Newton, ne pas dérailler en cas de courbure négative ou d'estimation erronée, et n'ajouter en moyenne qu'un tout petit calcul par étape.
Résoudre le problème
La règle de mise à jour
Le nom complet de Sophia est Second-order Clipped Stochastic Optimization. L'Algorithm 3 s'écrit :
Le numérateur est la moyenne mobile du gradient, comme dans Adam. Le dénominateur devient une estimation de la hessienne diagonale, faite seulement toutes les étapes et elle aussi lissée par moyenne mobile pour réduire le bruit. est la décroissance des poids découplée. Toutes les opérations se font coordonnée par coordonnée, et tronque chaque élément dans .
Le entre parenthèses est un pas de Newton au rabais. Les auteurs réécrivent l'expression ainsi
Le membre de droite se lit plus facilement. On calcule le pas de Newton , on tronque chaque coordonnée à , puis on multiplie par . ne détermine donc que « la proportion de coordonnées écrêtées », et toute coordonnée écrêtée finit avec un pas de .
Un écrêtage pas à pas
Prenons le par défaut de Sophia-H, et supposons quelques coordonnées ayant toutes un momentum , avec des estimations de courbure différentes :
| Courbure | Pas effectif | |
|---|---|---|
| 20 | 0.01 | |
| 1 | 0.2 | |
| 0.2 | 1 | |
| 0.02 | 10 | (écrêté) |
| −3 | (écrêté) |
Calculé pour cette note d'après l'Eq. (6) de l'article.
Pour les coordonnées à forte courbure, le pas se réduit automatiquement à un petit pas de type Newton ; celles à faible courbure, qui auraient reçu un énorme pas de Newton, sont écrêtées à . La dernière ligne correspond à une valeur négative, fréquente avec l'estimateur de Hutchinson ; prend alors , le rapport explose et il est écrêté à , ce qui revient à SignSGD avec momentum. Il en va de même quand la courbure est sous-estimée.
Les auteurs décrivent ce comportement comme « SignSGD avec momentum en guise de solution de secours ». Aussi aberrante que soit l'estimation de la hessienne, chaque coordonnée ne bouge que de au plus par étape ; c'est ce qui permet à toute la méthode d'oser « n'estimer la hessienne que toutes les 10 étapes ».
Comment choisir , alors ? Les auteurs conseillent de le régler sur un petit modèle, de sorte que la proportion de coordonnées « non écrêtées » se situe entre 10 % et 50 % ; si elle est trop forte ou trop faible, on multiplie par 0.5 ou par 2 et on recommence. Des modèles de tailles différentes, avec la même architecture et les mêmes données, peuvent partager cette valeur. Pendant l'entraînement réel, la proportion de coordonnées écrêtées monte jusqu'à environ 60 % ; la plupart des coordonnées font en fait des pas de signe. L'article retient finalement (Sophia-H) et (Sophia-G).
Deux estimateurs de la hessienne diagonale
L'estimateur de Hutchinson (Sophia-H). On tire un vecteur gaussien standard et on calcule
Son espérance est exactement la diagonale de la hessienne. Il suffit d'un produit hessienne-vecteur (Hessian-vector product), c'est-à-dire d'une rétropropagation supplémentaire sur , sans jamais assembler la hessienne. L'estimation est sans biais, mais une estimation isolée peut être négative.
L'estimateur de Gauss-Newton-Bartlett (Sophia-G). La hessienne d'une perte d'entropie croisée se décompose en un terme de Gauss-Newton, , et un terme résiduel généralement plus petit ; les auteurs n'estiment que le premier. Ici, est la jacobienne des logits par rapport aux paramètres, et la dérivée seconde de la perte par rapport aux logits. Pour l'entropie croisée, ne dépend que des probabilités produites par le modèle, et pas des vraies étiquettes. Grâce à l'identité de Bartlett, issue de la statistique, peut alors s'écrire comme l'espérance de « tirer une étiquette selon la distribution du modèle lui-même et calculer le produit extérieur du gradient ».
L'implémentation tient en quatre étapes :
- calculer les logits sur un lot d'entrées ;
- tirer des étiquettes selon le softmax du modèle lui-même ;
- calculer avec ces fausses étiquettes le gradient de la perte du mini-lot ;
- renvoyer , où est la taille de lot.
La multiplication par vient de ce que la différentiation automatique ne fournit que le gradient moyen. Selon la première identité de Bartlett, le gradient d'un exemple a une espérance nulle sous les étiquettes échantillonnées ; le carré du gradient moyen, multiplié par , a donc exactement pour espérance la moyenne des carrés des gradients par exemple.
Cette estimation n'est jamais négative, si bien que la direction préconditionnée est toujours une direction de descente. Elle ressemble beaucoup au moment d'ordre deux d'Adam, puisque les deux sont des carrés de gradients, avec deux différences. Adam utilise le gradient des vraies étiquettes, Sophia-G des étiquettes échantillonnées selon le modèle ; Adam prend la racine carrée du dénominateur, Sophia divise directement. Utiliser les vraies étiquettes donne ce que la littérature appelle l'empirical Fisher, et les ablations des auteurs montrent qu'il fait moins bien que GNB.
Le code officiel n'implémente que Sophia-G. Les auteurs ont d'ailleurs répondu sur GitHub que l'estimation de Sophia-G n'est jamais négative, et que la protection contre la courbure négative est prévue pour Sophia-H.
Une estimation toutes les 10 étapes
, et la hessienne n'est estimée que sur une partie des exemples. Le lot de GPT-2 compte 480 exemples ; Sophia-H n'en prend que 32, Sophia-G 240. Voici le temps par étape mesuré sur A100 :
| Méthode | 355M | 770M |
|---|---|---|
| AdamW | 1.77 s | 3.25 s |
| Sophia-H | 1.88 s | 3.40 s |
| Sophia-G | 1.86 s | 3.42 s |
D'après la Table 1 de l'article ; le temps par étape inclut, réparti sur les étapes, le coût de l'estimation de la hessienne faite toutes les 10 étapes.
Côté mémoire, Sophia ne stocke que deux états, et , comme AdamW.
Dans quel cadre vaut la garantie théorique
La section 4 démontre la vitesse de convergence d'une version simplifiée. La fonction doit être strictement convexe, la hessienne ne doit varier que de façon limitée dans un certain rayon, et les mises à jour doivent être déterministes ; de plus, l'analyse utilise la hessienne complète, en passant dans sa base propre, en écrêtant coordonnée par coordonnée dans cette base, puis en revenant. Sous ces conditions, le nombre d'étapes nécessaire pour atteindre une erreur ne dépend pas du conditionnement (courbure maximale divisée par courbure minimale) ; pour SignGD, même sur une simple fonction quadratique, le rythme dépend du conditionnement.
Pourquoi la théorie n'utilise-t-elle pas la hessienne diagonale ? Les auteurs expliquent que, pour une fonction quelconque, les directions de courbure ne sont pas forcément alignées sur les axes de coordonnées, et qu'un préconditionnement diagonal n'est alors pas forcément efficace. Cette phrase met justement le doigt sur le point faible de la version implémentée de Sophia. Les vallées obliques d'un vrai modèle, une hessienne diagonale ne peut pas davantage les redresser ; il faut pour cela des préconditionneurs matriciels comme Shampoo ou SOAP.
Discussion
Configuration expérimentale
GPT-2 est décliné en trois tailles, 125, 355 et 770 millions de paramètres, entraînées avec le code de nanoGPT sur OpenWebText (environ 9 milliards de tokens d'entraînement), avec un contexte de 1024 et des lots de 480 ; un modèle de 30 millions de paramètres sert au réglage. Les plus grands modèles sont des GPT NeoX de 1.5 et 6.6 milliards de paramètres, entraînés sur le Pile avec Levanter, avec un contexte de 2048.
Les références sont AdamW (, décroissance des poids de 0.1), Lion et AdaHessian. À part le taux d'apprentissage maximal, tous les hyperparamètres sont fixés après une grid search sur le modèle de 30 millions de paramètres. Pour 125 et 355 millions, le taux d'apprentissage maximal fait l'objet d'une grid search à part ; pour les modèles plus grands, on le monte jusqu'à trouver la valeur au-delà de laquelle « 1.25 fois plus fait exploser l'entraînement ». La configuration commune comprend une décroissance en cosinus jusqu'à 0.05 fois la valeur maximale, 2 000 étapes d'échauffement, un écrêtage de la norme du gradient à 1.0 et bf16. Sophia utilise , et une décroissance des poids de 0.2.
Un détail n'est pas symétrique. AdamW et Lion étant instables à partir de 355 millions de paramètres, les auteurs leur ajoutent une astuce courante, qui divise les scores d'attention par l'indice de la couche ; Sophia s'en passe.
D'où vient le facteur deux
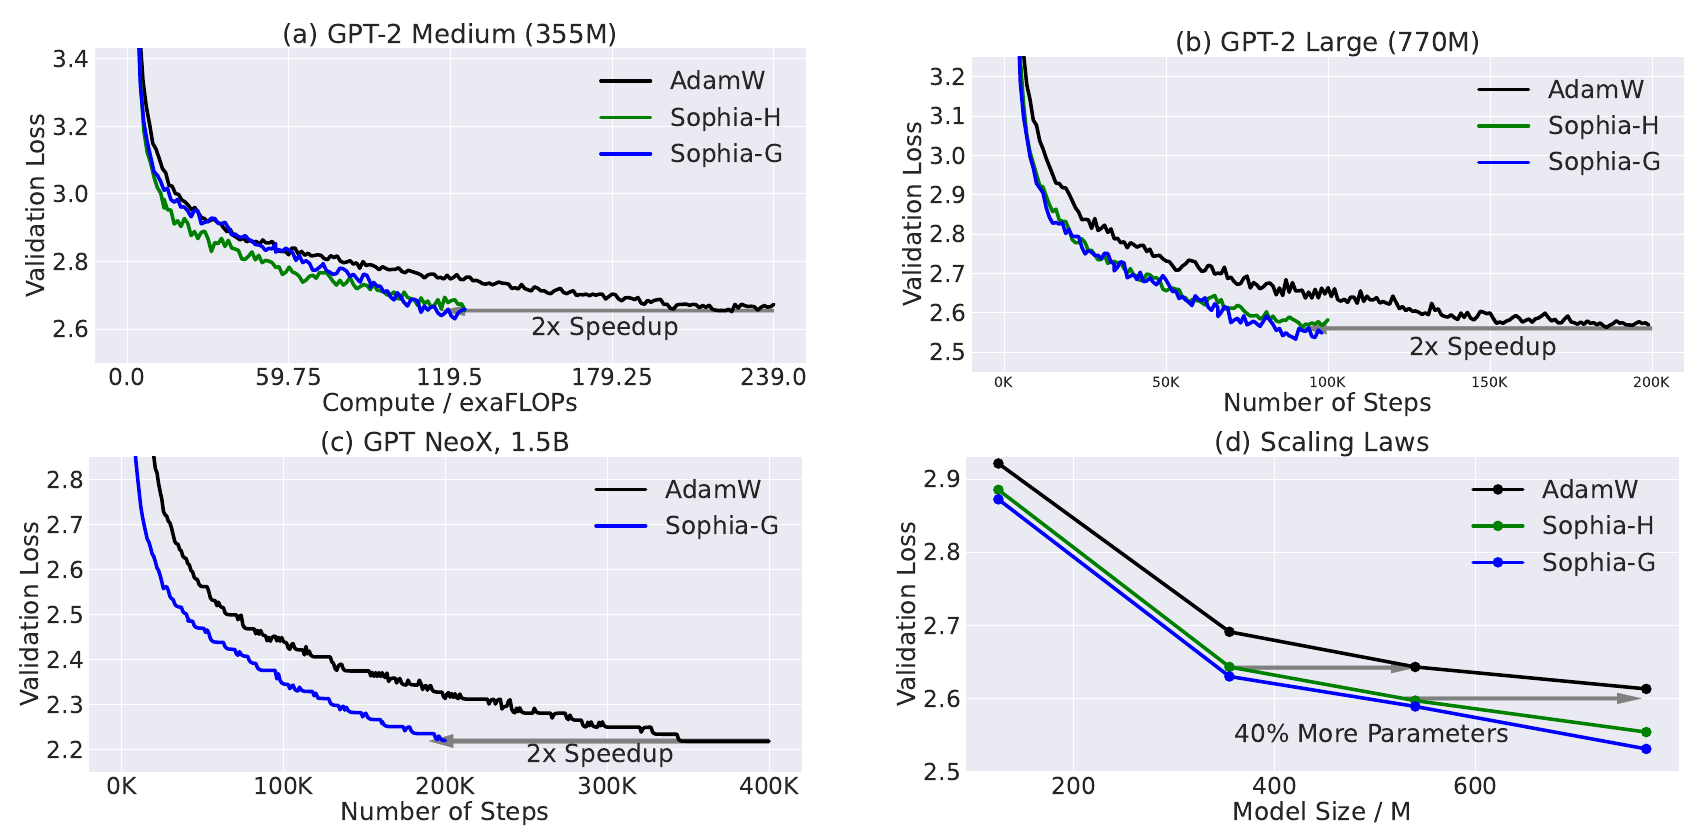
Les trois premiers graphiques se lisent de la même façon. La courbe noire est AdamW sur tout le budget, les courbes bleue et verte Sophia sur la moitié seulement ; une flèche grise relie horizontalement le point final de Sophia à celui d'AdamW, avec la mention « 2x Speedup ». Le graphique (d) s'intéresse plutôt à la taille des modèles. Après les mêmes 100 000 étapes, le modèle de 540 millions entraîné avec Sophia a une perte plus basse que celui de 770 millions entraîné avec AdamW ; autrement dit, AdamW a besoin d'environ 40 % de paramètres en plus pour le rattraper.
Perte finale à nombre d'étapes égal :
| Modèle | AdamW | Sophia-H | Sophia-G |
|---|---|---|---|
| GPT-2 125M | 2.921 | 2.901 | 2.875 |
| GPT-2 355M | 2.691 | 2.645 | 2.627 |
| GPT-2 770M | 2.613 | 2.554 | 2.524 |
| NeoX 1.5B | 2.250 | – | 2.218 |
| NeoX 6.6B | 1.992 | – | 1.969 |
D'après la légende de la Figure 5 de l'article ; 100 000 étapes pour GPT-2, 200 000 pour NeoX 1.5B.
Selon l'article, dans cette plage, une perte de validation plus basse de 0.05 équivaut à peu près à deux fois moins d'étapes. Pour 770M, l'écart est de 0.06 à 0.09, ce qui concorde ; pour 125M, il n'est que de 0.02 à 0.05. Pour 6.6 milliards de paramètres, il n'y a qu'une comparaison à nombre d'étapes égal, sans contrôle « moitié des étapes ». Côté tâches en aval, seules quatre sous-tâches de SuperGLUE (2-shot) sont testées ; Sophia sur 200 000 étapes et AdamW sur 400 000 étapes y ont une précision comparable.
Stabilité et hyperparamètres
Sur le GPT-2 de 125 millions de paramètres, les trois méthodes utilisent un écrêtage de la norme du gradient à 1.0 ; chez AdamW et Lion, plus de 10 % des étapes déclenchent l'écrêtage, alors que c'est rare chez Sophia-H. Sans l'astuce de mise à l'échelle de l'attention, AdamW ne supporte au plus qu'un taux d'apprentissage de 1.5e-4 sur le modèle de 355 millions et explose à 3e-4, et la limite de Lion passe de 6e-5 à 3e-5 ; Sophia-H n'a de toute façon pas besoin de cette astuce. Sur le modèle de 30 millions de paramètres, les neuf combinaisons de et balayées donnent toutes une perte entre 3.341 et 3.356.
Ablations
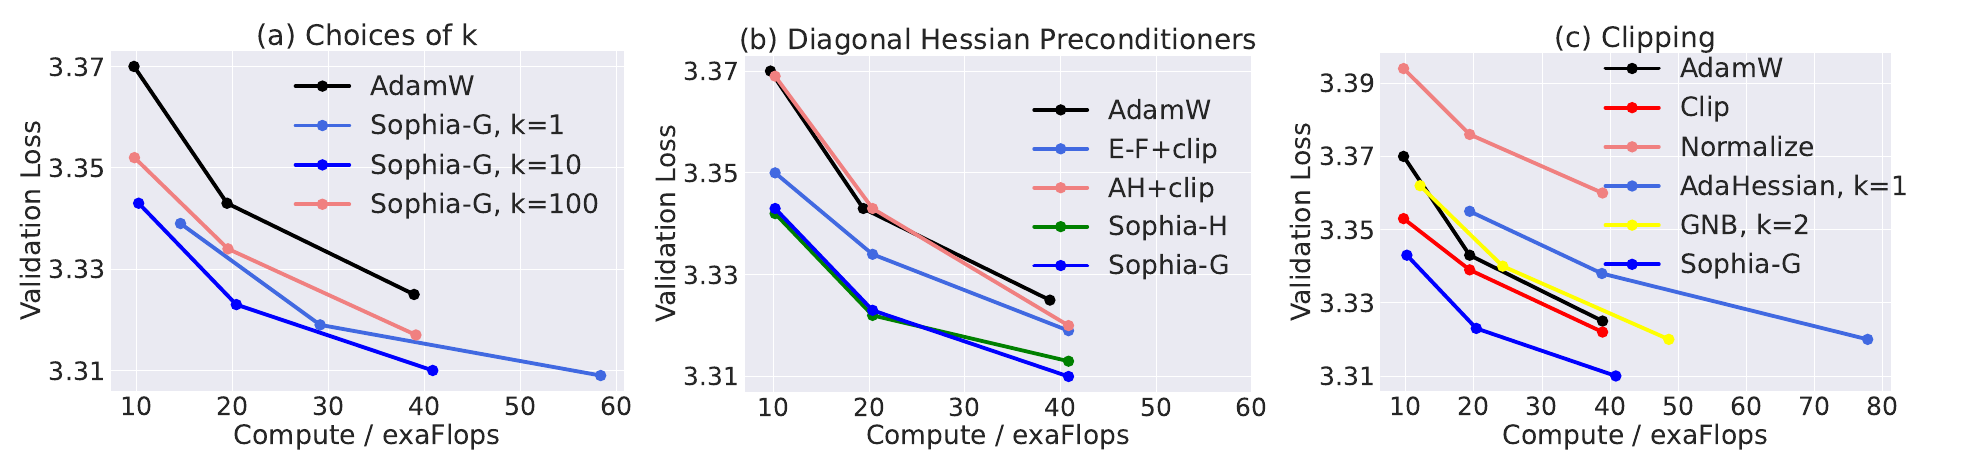
Sur les trois graphiques, plus on est en bas à gauche, mieux c'est, c'est-à-dire une perte plus basse à calcul égal.
(a) Avec une estimation de la hessienne à chaque étape (), la perte est la plus basse à nombre d'étapes égal, mais le surcoût est de 50 %, et à calcul égal, ce réglage perd face à ; bat encore AdamW, mais fait moins bien que .
(b) Avec le même écrêtage, GNB bat empirical Fisher, et Sophia-H bat AdaHessian. Les auteurs supposent que Sophia-H, qui fait une moyenne mobile des estimations de la hessienne, débruite mieux qu'AdaHessian, qui fait une moyenne mobile de leurs carrés.
Le graphique (c) est celui qui mérite le plus d'attention. La courbe rouge « Clip » n'utilise aucun préconditionnement et se contente d'écrêter le momentum élément par élément ; les auteurs eux-mêmes écrivent que c'est « essentially the same as sign momentum, or Lion with a single β ». Cette courbe bat déjà AdamW, en noir. Sans écrêtage, AdaHessian diverge dès et GNB dès , si bien qu'il faut refaire l'estimation à chaque étape ou presque. Sophia-G, en bleu, descend encore d'un cran.
Autrement dit, une partie du gain de Sophia vient du sign momentum lui-même, la hessienne ajoutant une couche par-dessus ; l'écrêtage est l'assurance qui permet d'estimer la hessienne moins souvent.
Ce que d'autres ont mesuré ensuite
Dans les mois qui ont suivi la mise en ligne sur arXiv, des issues signalant des échecs de reproduction se sont succédé sur le dépôt officiel.
Reproductions sur GitHub. Le 28 juin 2023, Aaron Defazio ouvre une issue sur le dépôt officiel. Il entraîne GPT-2 small sur 16 V100 en fp32 et fait tourner AdamW avec le script d'entraînement de Sophia, pour écarter toute différence de script ; le taux d'apprentissage de chacun est balayé, et l'optimum est 1e-3 dans les deux cas. Sophia-G obtient 2.876 et AdamW 2.869, et il penche pour des pertes finales à peu près équivalentes. Le premier auteur répond que le fp32 donne en soi des pertes plus basses que le bf16 pour les modèles de langage, et propose une configuration ; son propre Sophia en fp32 atteint 2.846. Defazio relance avec ces réglages sans parvenir à reproduire, puis ferme l'issue. En novembre, une autre issue reproduit 125M en suivant le README ; AdamW sur 200 000 étapes obtient 2.863, plus bas que les 2.897 de Sophia-G sur 100 000 étapes ; les auteurs mettent à jour les fichiers de configuration en janvier 2024.
No Train No Gain (Kaddour et al., 2023). Cet article place Sophia, Lion et plusieurs méthodes « d'économie d'entraînement » sur le préentraînement de BERT et T5, et les compare à budget fixe de 6, 12 et 24 heures, face à un AdamW dont le taux d'apprentissage décroît complètement. Insérer Sophia tel quel dans une chaîne d'entraînement en FP16 produit des NaN, et il faut passer en BF16 pour le stabiliser ; T5 a en plus besoin d'une mise à l'échelle RMS pour converger. Pour BERT sur 24 heures, la moyenne GLUE est de 77.9 pour AdamW contre 72.3 pour Sophia ; pour T5 sur SNI, 39.5 contre 34.1. Même sans compter le temps d'estimation de la hessienne et à nombre d'étapes égal, les auteurs « still do not observe any speedup ».
Zhao et al. (2024). Ils comparent SGD, Adafactor, Adam, Lion et Sophia sur des modèles de langage autorégressifs et concluent qu'à part SGD, tous se valent à peu près. En annexe, ils opposent Sophia à Signum (mise à jour par le signe avec momentum, ce qui revient à Sophia avec fixé à 0), et Sophia ne gagne pas.
Fantastic Pretraining Optimizers (Wen et al., 2025). Parmi ses auteurs, David Hall, Tengyu Ma et Percy Liang sont aussi auteurs de Sophia. Ils refont réglages et comparaison de 130 à 520 millions de paramètres ; Sophia perd face à AdamW à petit budget de calcul et ne prend une légère avance que quand le modèle ou les données grandissent, sans accélération significative en dessous de 0.5B. Ils en expliquent aussi la raison. La procédure de l'article Sophia « largely follows the correct procedure », et le taux d'apprentissage maximal de la référence a bien été réglé ; mais le data loader du code de l'époque ne mélangeait pas complètement les données, et dans ce code, le taux d'apprentissage optimal d'AdamW se retrouvait écrasé à une petite valeur. Une fois les données complètement mélangées, AdamW peut utiliser un taux d'apprentissage bien plus grand.
Conclusion
Sophia prend comme dénominateur une hessienne diagonale estimée toutes les 10 étapes, et plafonne à le déplacement de chaque étape par un écrêtage coordonnée par coordonnée. Les coordonnées mal estimées, à courbure négative ou trop faible, reviennent automatiquement à une mise à jour par le signe avec momentum. Dans le cadre de l'article, GPT-2 comme le NeoX de 1.5 milliard de paramètres rattrapent AdamW en deux fois moins d'étapes, pour environ 5 % de lenteur supplémentaire par étape.
Ce que l'article laisse de plus utile aux praticiens, c'est finalement sa règle de mesure. La prochaine fois que vous lirez « deux fois plus rapide », vérifiez d'abord que le taux d'apprentissage de la référence a été réglé au mieux pour le même nombre total d'étapes, sur des données tout aussi complètement mélangées, puis que la nouvelle méthode n'est comparée que sur les checkpoints finaux. Si vous utilisez Sophia, réglez en surveillant la proportion de coordonnées écrêtées, et choisissez bf16 pour la précision mixte.
(Dans les propres ablations de l'article, retirer la hessienne pour ne garder que l'écrêtage suffit déjà à battre AdamW ; et dans la comparaison ultérieure de Zhao et al., Sophia n'a effectivement pas battu Signum.)