Article original
SOAP: Improving and Stabilizing Shampoo using Adam
- Publication
- ICLR 2025Conférence
- Premier dépôt sur arXiv
- arXiv:2409.11321
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizerssoap2024,
  title = {{SOAP: Improving and Stabilizing Shampoo using Adam}},
  author = {Nikhil Vyas and Depen Morwani and Rosie Zhao and Mujin Kwun and Itai Shapira and David Brandfonbrener and Lucas Janson and Sham Kakade},
  year = {2024},
  eprint = {2409.11321},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2409.11321}
}
Avec Shampoo, il faut toujours trancher une question. À quelle fréquence faire l'étape la plus coûteuse ?
À chaque étape, Shampoo met à jour deux matrices de statistiques, et , mais ce qui multiplie réellement le gradient, ce sont leurs puissances matricielles, qui demandent une décomposition en éléments propres ou un calcul itératif de racines. Cette étape coûte trop cher ; les implémentations ne la font donc que toutes les étapes et réutilisent l'ancien résultat entre-temps.
Nikhil Vyas, Depen Morwani et leurs collègues de Harvard ont mesuré l'effet de ce . Sur un modèle de langage de 360 millions de paramètres, la perte de test finale de Shampoo est d'environ 2.824 avec , d'environ 2.868 avec et d'environ 2.932 avec ; dans le même cadre, AdamW est à environ 2.943. En espaçant les calculs pour économiser, Shampoo rend presque tout son avantage sur AdamW.
En août 2024, Shampoo venait de remporter la catégorie à réglage externe d'AlgoPerf. Cet article veut le rendre un peu moins cher, et un peu plus facile à régler.
Définir le problème
Shampoo maintient deux préconditionneurs, à gauche et à droite, pour une matrice de poids :
L'exposant d'origine est , et les implémentations ultérieures passent le plus souvent à . Un Shampoo utilisable en pratique (par exemple DistributedShampoo de Meta) demande, en plus du taux d'apprentissage et du momentum, de fixer le coefficient de moyenne mobile des statistiques, le du calcul des racines de matrices, des exposants distincts pour les paramètres 1D et 2D, l'optimiseur auquel le grafting emprunte la taille du pas, et la fréquence de mise à jour des préconditionneurs.
Il y a deux problèmes. D'abord, dès qu'on espace les mises à jour, les performances baissent, car entre deux décompositions en éléments propres, tout le préconditionneur est figé et ignore comment évolue l'échelle des gradients. Ensuite, il y a trop d'hyperparamètres.
Les auteurs commencent par comprendre ce que fait vraiment Shampoo dans sa base propre. Si on pouvait le séparer en une « partie chère » et une « partie bon marché », on pourrait peut-être calculer la partie chère lentement et mettre à jour la partie bon marché à chaque étape.
Résoudre le problème
Shampoo, c'est Adafactor dans une base tournée
Commençons par idéaliser Shampoo. On prend la puissance ; et sont les espérances sur tout le jeu de données, et ; et on multiplie par un scalaire de correction fondé sur . La mise à jour devient
Décomposons et en éléments propres, et , de valeurs propres respectives et . En substituant :
Cette ligne se lit en trois temps. On fait d'abord tourner le gradient dans la base propre, ; dans ce repère, l'élément est multiplié par ; enfin, on revient au repère d'origine.
L'étape du milieu est une mise à l'échelle élément par élément, dont le coefficient est « une quantité de la ligne » multipliée par « une quantité de la colonne », donc de rang 1. C'est exactement ce que fait Adafactor. Pour économiser la mémoire, Adafactor ne stocke pas le moment d'ordre deux de chaque élément, seulement la somme de chaque ligne et la somme de chaque colonne, puis reconstruit .
Si l'on exécute Adafactor dans ce repère tourné, que vaut la somme d'une ligne ? Notons et les -ième et -ième vecteurs colonnes de et :
La deuxième égalité utilise le fait que les forment une base orthonormée. De même, et . La mise à l'échelle d'Adafactor pour est , exactement la même que celle de Shampoo ci-dessus.
C'est le Claim 1 de l'article. Shampoo avec la puissance revient à exécuter Adafactor dans la base propre du préconditionneur de Shampoo. La partie chère consiste à trouver la base (décomposition en éléments propres), la partie bon marché à mettre à l'échelle coordonnée par coordonnée dans cette base.
D'Adafactor à Adam
Sous cet angle, on voit d'où vient le problème de fréquence de Shampoo. Ne recalculer que toutes les étapes, c'est figer à la fois la « base » et la « mise à l'échelle » ; or la mise à l'échelle n'est qu'une poignée de moyennes mobiles élément par élément, très bon marché à mettre à jour à chaque étape. La base peut changer lentement, mais rien n'oblige la mise à l'échelle à l'attendre.
Tant qu'à mettre à jour la mise à l'échelle à chaque étape, les auteurs remplacent carrément Adafactor par Adam, avec un moment d'ordre deux complet, élément par élément, sans factorisation de rang 1. Voici l'algorithme (Algorithm 3), où désigne le produit élément par élément :
La base n'est mise à jour que toutes les étapes, par une étape de la méthode de la puissance itérée suivie d'une décomposition QR, , où est ou et la base précédente. Seule la première fois utilise une décomposition en éléments propres complète.
Quelques détails méritent qu'on s'y arrête.
Le momentum est stocké dans le repère d'origine et projeté à chaque étape. Comme la base change toutes les étapes, un momentum stocké dans l'ancien repère ne serait plus aligné sur la nouvelle base au moment du changement. Le moment d'ordre deux vit en revanche directement dans le repère tourné et n'est pas tourné lors des changements de base ; le résumé de l'article qualifie cette base de « slowly changing ». Au changement de base, le code officiel réordonne selon l'amplitude des valeurs propres, pour qu'une même direction retombe dans la même case.
Les paramètres 1D (biais, poids de LayerNorm) passent directement par AdamW. L'embedding d'entrée et la couche de sortie ont une dimension égale à la taille du vocabulaire ; stocker une matrice de vecteurs propres aussi grande coûterait trop cher, et le de ce côté est donc fixé à l'identité. Quand les deux côtés sont l'identité, SOAP redevient Adam ; c'est pourquoi l'article décrit SOAP comme « Adam dans un espace tourné ».
Les hyperparamètres en moins
Le nom SOAP vient de ShampoO with Adam in the Preconditioner's eigenbasis. Par rapport à AdamW, il n'ajoute qu'un hyperparamètre, la fréquence de mise à jour de la base. Par rapport à Shampoo, tout ce qui suit disparaît :
- l'exposant des puissances de matrices, puisque la mise à l'échelle revient au d'Adam ;
- le ajouté aux valeurs propres lors du calcul des racines, remplacé par le d'Adam lui-même ;
- le grafting, puisque Adam fixe la taille du pas coordonnée par coordonnée dans l'espace tourné, sans rien emprunter à un autre optimiseur ;
- le coefficient de moyenne mobile de et , qui reprend directement le d'Adam.
Le coût
La mémoire est la même que pour DistributedShampoo. Une couche doit stocker quatre matrices carrées, , , et , plus le gradient, et , soit au total ; AdamW n'a besoin que de .
À chaque étape, Shampoo multiplie une fois par le préconditionneur à gauche et une fois à droite ; SOAP doit d'abord projeter, puis reprojeter en sens inverse, ce qui ajoute une série de multiplications matricielles à gauche et à droite, d'où un coût par étape légèrement supérieur à celui de Shampoo. En échange, on peut espacer davantage les mises à jour.
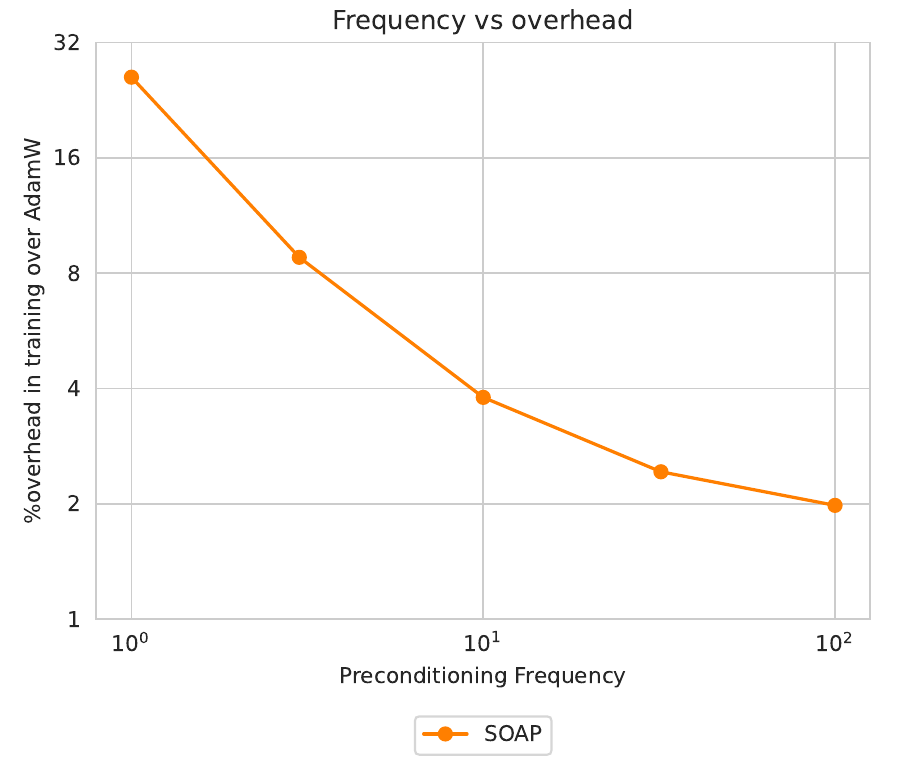
Avec un changement de base à chaque étape, le temps d'entraînement augmente d'environ 27 % ; avec , d'environ 3.7 %, et avec , d'environ 2 %. La courbe ne descend pas à 0, car qu'on change de base ou non, chaque étape doit mettre à jour et en fp32 et faire deux projections. Ces chiffres ont été mesurés sur un seul H100, avec de l'accumulation de gradients pour obtenir de grands lots.
Discussion
Configuration expérimentale
Toutes les expériences portent sur le préentraînement de modèles de langage. Les données sont C4, avec le tokenizer de T5 ; les modèles, construits sur le code d'OLMo, sont de type decoder-only, en trois tailles, 210, 360 et 660 millions de paramètres (hors embedding), de largeur 1024, 1024 et 1408 et de profondeur 12, 24 et 24, avec RoPE et QK LayerNorm, en précision mixte bf16. Les séquences font 1024 tokens et chaque lot compte environ 2 millions de tokens ; le volume d'entraînement est d'environ 20 fois le nombre de paramètres en tokens, soit 3 200 étapes pour 360m et 6 400 étapes pour 660m.
Les trois optimiseurs commencent par un balayage du taux d'apprentissage. Pour AdamW, et sont aussi balayés sur 360m ; pour Shampoo, avec DistributedShampoo, on balaie en plus , le coefficient de moyenne mobile des statistiques et quatre jeux d'exposants, des balayages qui améliorent tous la perte de moins de 0.004. Pour SOAP, seul le taux d'apprentissage est balayé. La configuration commune comprend , une décroissance des poids découplée de , une z-loss de , et, après l'échauffement, une décroissance en cosinus jusqu'à 0.1 fois la valeur maximale.
Il faut aussi préciser comment on mesure « combien plus vite ». Une planification en cosinus dépend du nombre total d'étapes, et comparer des checkpoints intermédiaires d'un même entraînement serait injuste. Les auteurs relancent donc SOAP en entraînements complets de 0.5, 0.625, 0.75 et 0.875 fois la longueur, ajustent la relation entre perte finale et nombre d'étapes par , puis cherchent à quelle longueur SOAP rattrape la perte finale d'AdamW et celle de Shampoo.
Résultats principaux
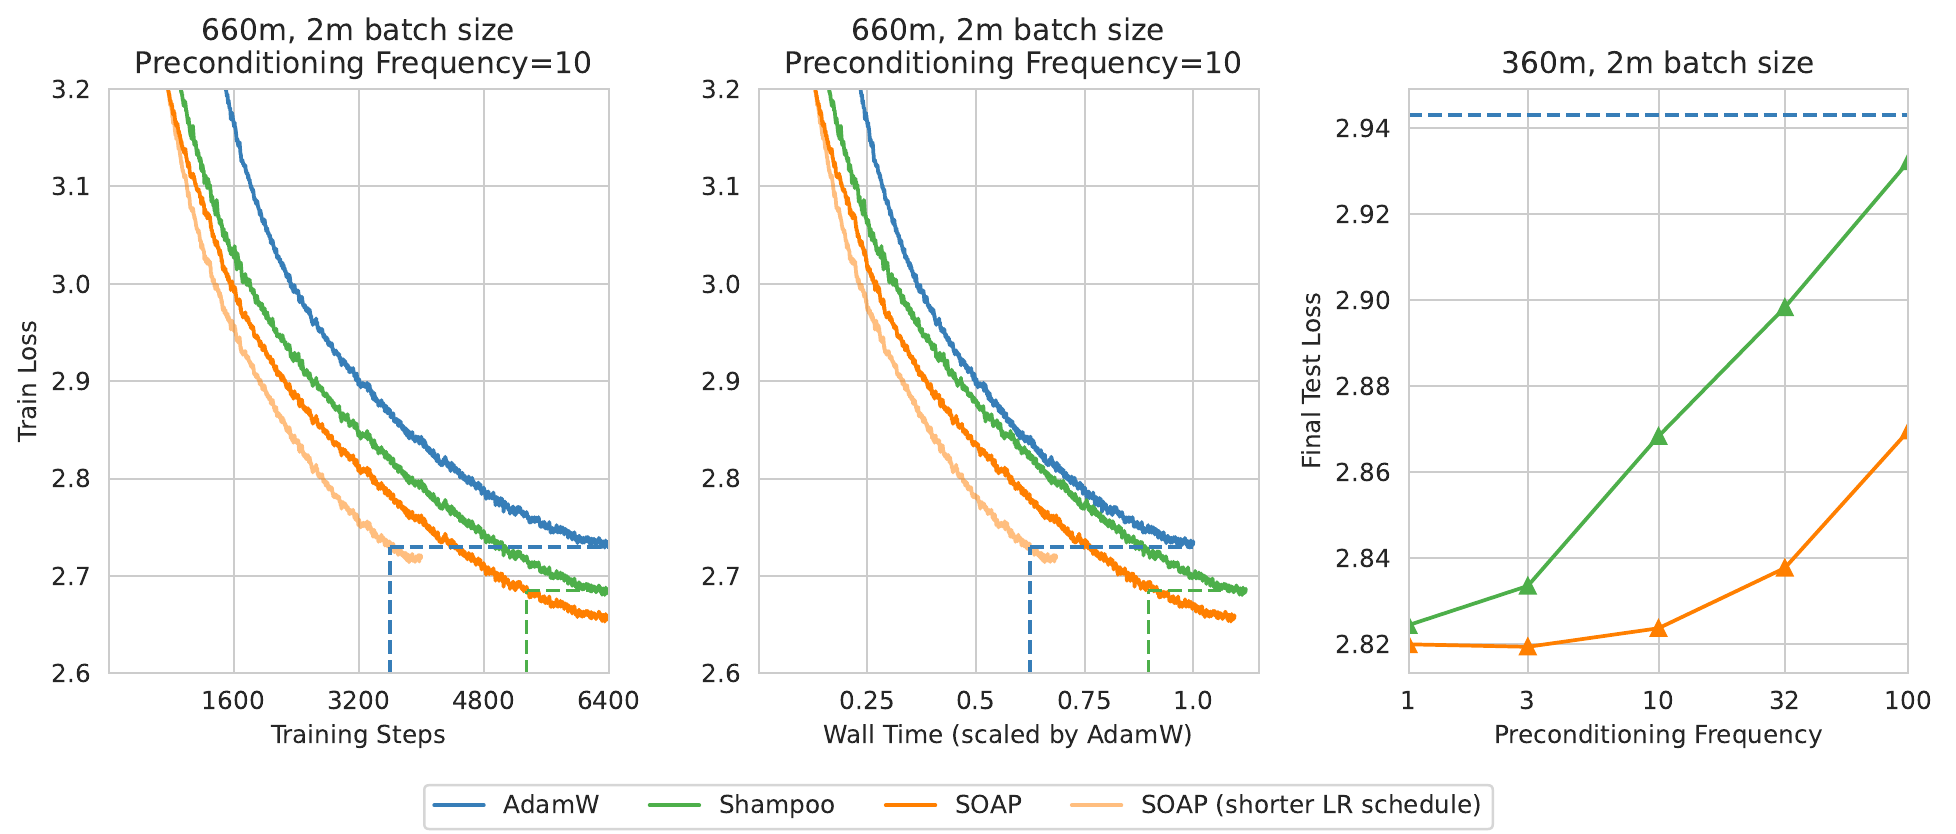
Commençons par le graphique de gauche. Les courbes bleue, verte et orange correspondent à AdamW, Shampoo et SOAP, tous entraînés sur 6 400 étapes ; à l'arrivée, SOAP est le plus bas. La courbe orange clair est SOAP avec une planification raccourcie, et la ligne pointillée montre qu'il rejoint le point final d'AdamW dès environ 3 600 étapes. Le graphique du centre passe au temps réel en abscisse, et l'écart entre les trois courbes se réduit un peu, parce que chaque étape de SOAP et de Shampoo coûte plus cher que celle d'AdamW.
Selon les estimations d'efficacité de l'article, voici les chiffres pour trois configurations :
| Configuration | Rattraper AdamW | Rattraper Shampoo |
|---|---|---|
| 360m, 2 millions | 0.50 / 0.52 | 0.75 / 0.74 |
| 660m, 2 millions | 0.565 / 0.62 | 0.80 / 0.78 |
| 360m, 256 000 | 0.72 / 0.83 | 0.875 / 0.90 |
D'après les graduations indiquées sur la Figure 2 de l'article ; chaque case donne « rapport d'étapes / rapport de temps », et la taille de lot de la première colonne est en tokens. Les rapports de temps face à Shampoo sont convertis pour cette note (sur tout l'entraînement, Shampoo prend respectivement 1.06, 1.12 et 1.11 fois le temps d'AdamW).
Avec de grands lots, SOAP n'a besoin que de 50 % à 57 % des étapes d'AdamW et d'environ 52 % à 62 % de son temps ; face à Shampoo, il économise un peu plus de 20 %. C'est de là que vient la phrase du résumé, « plus de 40 % d'itérations et plus de 35 % de temps réel en moins qu'AdamW, environ 20 % de moins que Shampoo ». En poussant 360m jusqu'à 100 fois son nombre de paramètres en tokens (33.5 milliards), l'avantage de SOAP sur AdamW se maintient.
Ablation sur la fréquence
Les chiffres cités en ouverture viennent de la moitié droite de la Figure 1, reproduite ici.
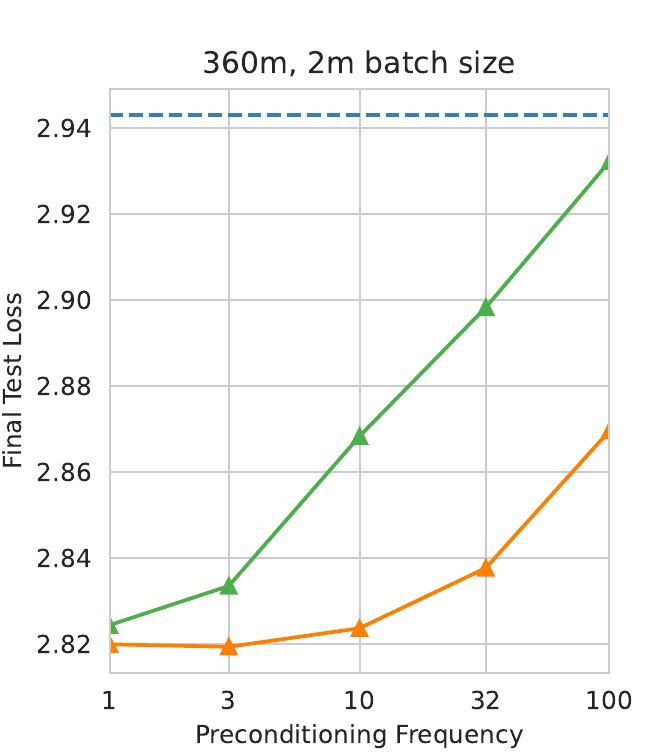
Les deux courbes restent sous la ligne pointillée d'AdamW ; pour de 1 à 100, les deux battent AdamW. À , ils sont presque identiques (2.820 contre 2.824), comme on l'attend si, avec un recalcul à chaque étape, seule la différence entre Adafactor et Adam les sépare. Ensuite, Shampoo monte jusqu'à 2.932, tandis que SOAP est encore à 2.823 à et ne monte à 2.870 qu'à .
Ces résultats appuient l'explication des auteurs. SOAP est à 2.823 à , et à il n'est qu'environ 0.018 au-dessus de , encore bien en dessous des 2.868 et 2.898 de Shampoo aux mêmes fréquences ; ce qui dégrade réellement Shampoo, c'est que la mise à l'échelle est figée elle aussi.
Taille de lot
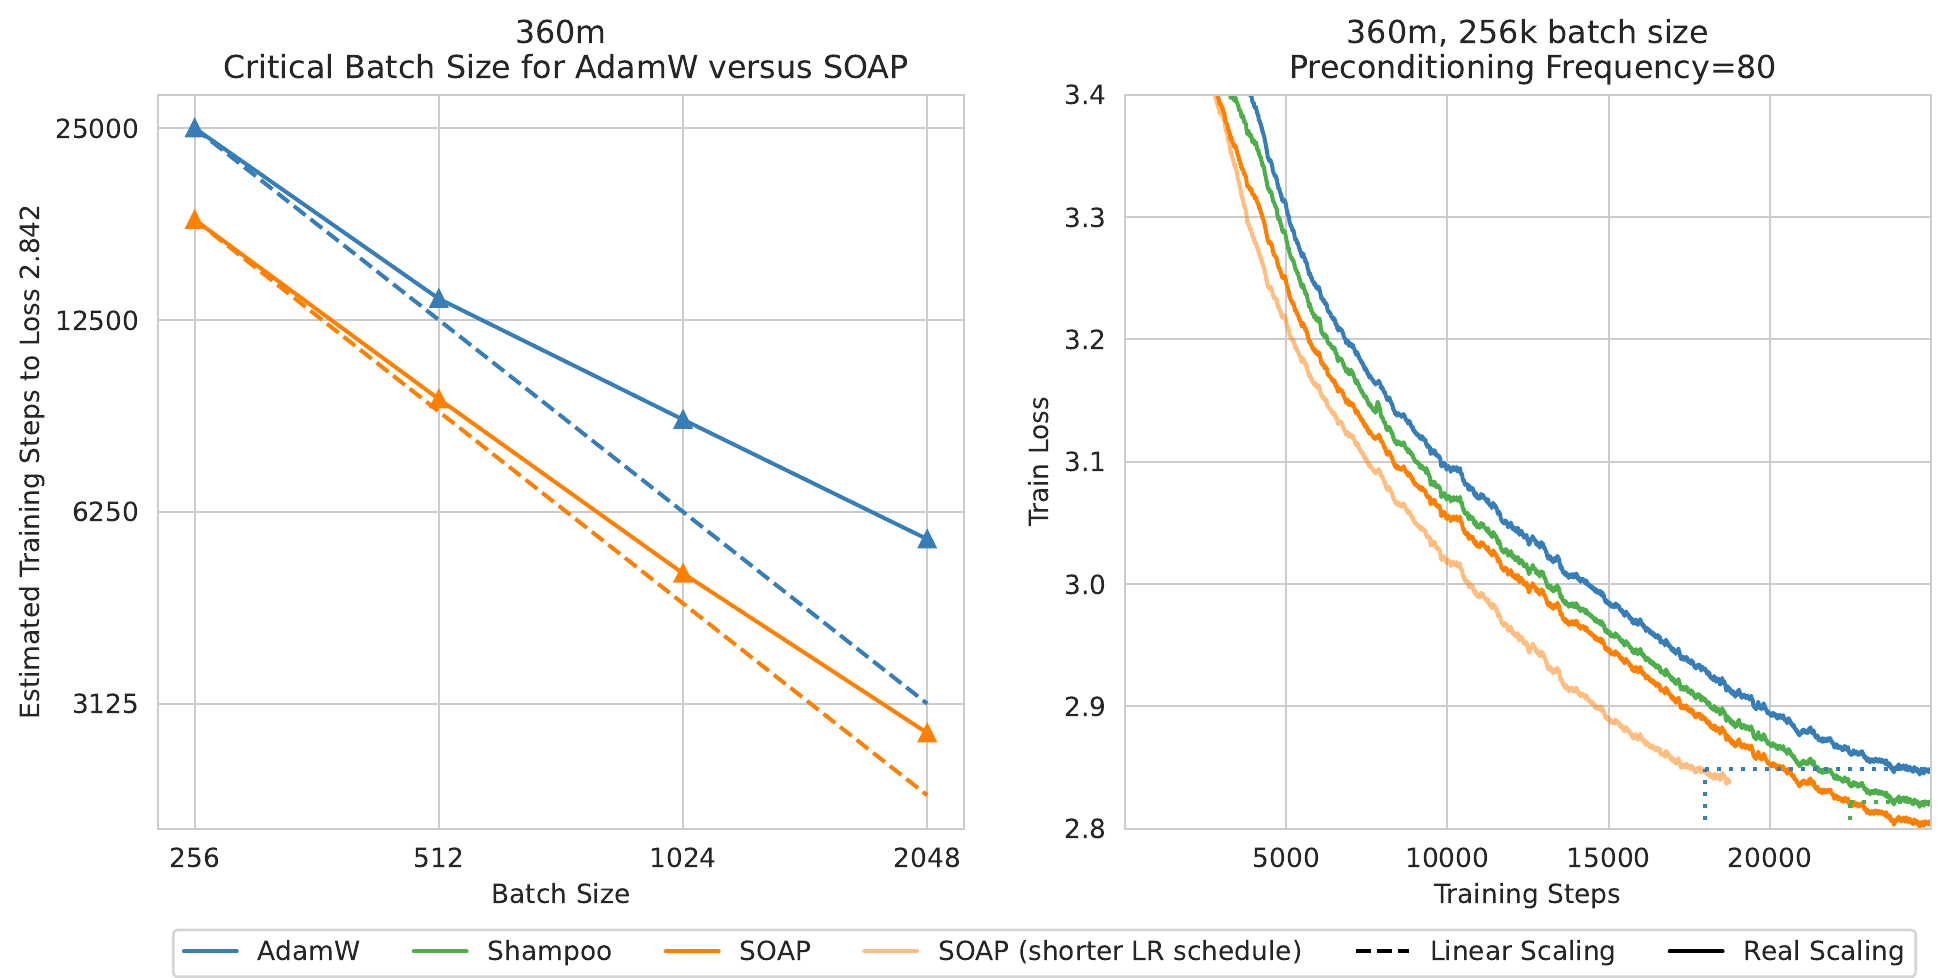
Idéalement, doubler la taille de lot divise par deux le nombre d'étapes nécessaires pour atteindre une même perte ; c'est la ligne pointillée du graphique de gauche. Plus le trait plein s'en éloigne, plus le surplus de lot est gaspillé. Le trait plein bleu d'AdamW s'en écarte de plus en plus dès 512, et à 2048 il lui faut près du double des étapes idéales ; le trait plein orange de SOAP colle davantage à sa propre ligne pointillée, et les auteurs en concluent que la taille de lot critique de SOAP est plus grande. Par souci d'équité, chaque fois que le lot est divisé par , la fréquence est multipliée par , pour garder constante la part du surcoût des décompositions en éléments propres.
Le graphique de droite correspond au plus petit lot, 256 000 tokens. SOAP y utilise 25 % d'étapes de moins qu'AdamW et environ 10 % de moins que Shampoo. Comparé au tableau ci-dessus, l'avantage fond nettement avec de petits lots. Les auteurs précisent que ce sont des résultats préliminaires, et que fixer « lot × fréquence » n'est pas forcément le meilleur compromis ; la baisse d'intérêt des méthodes du second ordre avec de petits lots concorde avec les travaux antérieurs. Le README officiel conseille lui aussi d'utiliser des lots aussi grands que possible.
Variantes économes en mémoire, et GaLore
SOAP demande de mémoire de plus qu'AdamW. L'article essaie deux façons d'économiser. Exécuter Adafactor au lieu d'Adam dans l'espace tourné économise un , presque sans changer la perte ; ne tourner que le côté le plus court, l'autre restant à l'identité, augmente un peu plus la perte, mais reste à égalité avec Shampoo ou légèrement meilleur. En combinant les deux, la mémoire tombe à , déjà moins que les d'AdamW sur un Transformer standard, et cette variante bat toujours AdamW.
La version de rang plein de GaLore ressemble beaucoup à SOAP, avec trois différences principales. La projection de GaLore vient de la SVD du gradient courant, celle de SOAP de la moyenne mobile de ; GaLore stocke le momentum dans l'espace projeté et ne le ramène pas au changement de base, alors que SOAP le stocke dans l'espace d'origine ; GaLore ne projette que d'un côté. Sur le modèle de 210 millions de paramètres, le meilleur résultat de GaLore est 3.12, mieux qu'AdamW mais moins bien que les 3.10 de Shampoo ; les auteurs en concluent que chacune de ces modifications de SOAP est nécessaire.
L'idée avait en fait déjà été décrite. Dans l'annexe B de l'article Distributed Shampoo de 2020, Anil et al. présentent un algorithme essentiellement équivalent à SOAP sur les couches 2D, sans expériences à l'appui, en indiquant seulement que des expériences non publiées n'avaient montré aucune amélioration. Les auteurs de SOAP le signalent honnêtement dans leurs travaux connexes, et supposent que la différence vient de détails d'implémentation.
Limites
L'article énumère clairement ses propres limites. Le plus grand modèle compte 660 millions de paramètres, deux ordres de grandeur de moins que les grands modèles de l'époque ; les auteurs supposent que les conclusions s'étendent à plus grande échelle, mais cela « remains to be validated ». Seuls des modèles de langage sont testés. Le débit est mesuré sur un seul GPU, et la comparaison d'implémentations distribuées est laissée à plus tard. Les calculs sur et se font tous en fp32, et la QR de PyTorch ne prend pas en charge de précision plus basse ; le plancher du surcoût ne peut donc pas encore être abaissé.
Une vérification indépendante un an plus tard
En 2025, Wen, Hall, Ma et Liang, de Stanford, publient « Fantastic Pretraining Optimizers and Where to Find Them », qui compare AdamW et dix nouveaux optimiseurs, chacun soigneusement réglé, sur des modèles de 130 millions à 1.2 milliard de paramètres et des volumes de données de 1 à 8 fois Chinchilla.
Sur les modèles de 300 et 520 millions de paramètres, ils mesurent que SOAP est 1.2 à 1.3 fois plus rapide qu'un AdamW bien réglé ; à 1.2 milliard de paramètres, SOAP comme Muon ne sont plus qu'à environ 1.1 fois. Autre constat, quand le rapport données/modèle atteint 8 fois ou plus, SOAP et Kron dépassent Muon, le plus fort quand les données sont peu nombreuses. Leur implémentation de SOAP découpe en outre les poids en blocs et stocke le momentum en bf16 à 1.2 milliard de paramètres, ce qui la distingue légèrement de l'original.
Conclusion
SOAP part d'une équivalence, selon laquelle Shampoo avec la puissance revient à exécuter Adafactor dans sa base propre. Une fois séparées la base, chère, et la mise à l'échelle, bon marché, la base peut n'être mise à jour que toutes les 10 étapes ou plus, tandis que la mise à l'échelle est mise à jour à chaque étape à la manière d'Adam ; les hyperparamètres se réduisent à une seule fréquence de plus qu'AdamW. Sur des modèles de langage de 360 et 660 millions de paramètres, avec de grands lots, SOAP demande environ moitié moins d'étapes qu'AdamW, et 38 % à 48 % de temps réel en moins.
Pour l'essayer, le soap.py officiel peut être copié tel quel dans votre projet. Partez des réglages du README, et une fréquence de 10, mesurez précisément de combien chaque étape est plus lente qu'avec AdamW, puis décidez s'il faut espacer davantage. Si la mémoire est juste, la rotation d'un seul côté et la variante Adafactor sont deux replis validés par l'article.
Dans le corps de l'article, Fantastic cite nommément SOAP comme l'un des rares articles à avoir balayé indépendamment les hyperparamètres de sa référence, et dont l'accélération annoncée est la plus proche de leurs propres mesures. Pour un article d'optimiseur, ce genre de compliment est rare.