Article original
Decoupled Weight Decay Regularization
- Publication
- ICLR 2019Conférence
- Premier dépôt sur arXiv
- arXiv:1711.05101
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizersadamw2017,
  title = {{Decoupled Weight Decay Regularization}},
  author = {Ilya Loshchilov and Frank Hutter},
  year = {2017},
  eprint = {1711.05101},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1711.05101}
}
Ces deux lignes de PyTorch ont les mêmes noms de paramètres, et les mêmes valeurs :
torch.optim.Adam(model.parameters(), lr=1e-3, weight_decay=1e-2)
torch.optim.AdamW(model.parameters(), lr=1e-3, weight_decay=1e-2)
La première traite 1e-2 comme le coefficient d'une régularisation L2, l'ajoute au gradient, puis confie le tout à Adam ; la seconde multiplie directement les paramètres, à chaque pas, par , indépendamment du gradient. Les modèles qu'elles entraînent ne sont pas les mêmes.
En novembre 2017, quand Ilya Loshchilov et Frank Hutter, de l'université de Fribourg-en-Brisgau, relèvent cette différence, les frameworks courants implémentent tous la première écriture, et l'appellent tous weight decay.
Selon eux, c'est là qu'il faut chercher une grande partie de la raison pour laquelle Adam généralise moins bien que SGD en classification d'images.
Définir le problème
Deux « décroissances »
Dans la définition de Hanson et Pratt (1988), la décroissance des poids (weight decay) consiste à multiplier les poids, à chaque pas, par un nombre légèrement inférieur à 1, avant la mise à jour par le gradient (Eq. 1 de l'article) :
La régularisation L2 ajoute à la fonction de perte un terme , dont le gradient vaut . Avec une mise à jour par SGD :
En comparant avec l'équation précédente, il suffit que pour que les deux soient identiques. C'est la Proposition 1 de l'article, et c'est la raison pour laquelle on a longtemps confondu les deux termes.
Mais cette égalité cache un point souvent négligé. Si un problème a une quantité de décroissance optimale , le meilleur coefficient L2, , est lié au taux d'apprentissage ; dès que l'on change le taux d'apprentissage, il faut aussi changer le coefficient L2. Même dans SGD, ces deux hyperparamètres sont couplés.
Et avec Adam ?
Adam divise le gradient par . Si l'on écrit la régularisation L2 dans le gradient, le terme est divisé lui aussi.
En mai 2017, Wilson et al. constatent qu'Adam généralise moins bien que SGD sur plusieurs tâches ; les meilleurs résultats en classification d'images étaient d'ailleurs alors tous obtenus avec SGD et momentum. Cet écart avait reçu plusieurs explications, comme les minima aigus, ou des défauts propres aux méthodes adaptatives. Cet article avance une hypothèse plus concrète, selon laquelle le problème pourrait venir de ce que le « weight decay » implémenté par les frameworks n'est, dans Adam, pas du tout une décroissance des poids.
Résoudre le problème
Pas d'équivalence dans Adam
Écrivons Adam sous une forme générale, , où est la matrice de préconditionnement ; pour SGD, est la matrice identité, pour Adam, c'est , avec en plus le momentum. Un pas de chacune des deux approches s'écrit :
Pour que les deux équations soient égales, il faudrait pour tout , ce qui n'est possible que si est un multiple constant de la matrice identité. Le d'Adam diffère d'une coordonnée à l'autre ; aucun ne rend donc L2 égal à la décroissance des poids. C'est la Proposition 2.
Où est la différence ? Faisons le calcul avec deux paramètres. Supposons qu'ils valent tous deux 1, que l'amplitude typique de leur gradient () soit 1 pour l'un et 0.01 pour l'autre, et prenons un coefficient L2 . Ignorons d'abord le momentum, et supposons aussi assez petit pour ne pas influencer :
| Paramètre | Décroissance avec L2 | Décroissance avec AdamW | |
|---|---|---|---|
| A | 1 | ||
| B | 0.01 |
Calcul fait pour cette note. La colonne AdamW suit l'écriture de PyTorch, où la décroissance vaut , avec .
Avec L2, la décroissance est d'abord divisée par ; celle du paramètre A, au grand gradient, n'est qu'un centième de celle du paramètre B, au petit gradient. Selon l'article, avec L2, les poids dont les gradients passés sont grands sont moins régularisés. La décroissance des poids, elle, réduit chaque poids dans la même proportion.
La Proposition 3 exprime cette différence par une formule. Si la matrice de préconditionnement est fixe, , la décroissance des poids équivaut à une régularisation L2 pondérée par l'échelle du gradient :
Les paramètres à grand (aux gradients passés grands) sont plus régularisés qu'avec une L2 ordinaire. Le terme de pénalité est ; le poids de pénalité de chaque coordonnée est donc proportionnel à . Le vrai Adam change de préconditionnement à chaque pas, et cette proposition ne s'y applique pas directement ; elle montre néanmoins quel type d'objectif chacune des deux approches optimise.
Les deux écritures de l'Algorithm 2
La correction consiste à sortir la décroissance du gradient, pour l'appliquer directement aux paramètres. L'article place les deux écritures côte à côte dans un même algorithme, en marquant de couleurs différentes le terme propre à chacune ; nous les distinguons ici par les annotations placées en dessous :
Si l'on ne garde que le terme marqué Adam+L2 à la première ligne, on obtient Adam avec L2 ; si l'on ne garde que le terme marqué AdamW à la dernière ligne, on obtient AdamW. Les valeurs par défaut sont celles d'Adam, , , , .
est le multiplicateur de la planification du taux d'apprentissage ; il peut être fixe, décroissant, ou redémarrer périodiquement comme dans AdamWR, présenté plus loin. Dans la dernière ligne, remarquez que le terme de décroissance est multiplié par , mais pas par le taux d'apprentissage de base . Le « découplage » de l'article désigne justement cela ; ne change plus de sens avec . Les frameworks traitent ce détail de différentes façons ; nous y reviendrons dans la discussion.
Il en va de même pour la version SGD (SGDW, Algorithm 1). Avec L2, le terme est écrit dans le gradient, ; SGDW modifie la dernière ligne en . Dans SGD, les deux sont en principe interchangeables ; SGDW sert à ne plus avoir à réajuster quand change. Avec momentum, ils ne sont d'ailleurs plus tout à fait identiques, car le terme L2 s'accumule avec le momentum.
En code, la différence tient en deux lignes. Voici une version pour un seul tenseur, d'après l'algorithme que donne la documentation de PyTorch 2.15 :
def adam_step(p, grad, m, v, t, lr=1e-3, betas=(0.9, 0.999), eps=1e-8,
              weight_decay=0.0, decoupled=False):
    b1, b2 = betas
    if weight_decay and not decoupled:
        grad = grad + weight_decay * p        # Adam + L2 : la décroissance entre dans le gradient, puis sera divisée par sqrt(v_hat)
    if weight_decay and decoupled:
        p.mul_(1 - lr * weight_decay)         # AdamW : les paramètres sont réduits directement, sans passer par m ni v
    m.mul_(b1).add_(grad, alpha=1 - b1)
    v.mul_(b2).addcmul_(grad, grad, value=1 - b2)
    m_hat = m / (1 - b1 ** t)
    v_hat = v / (1 - b2 ** t)
    p.add_(-lr * m_hat / (v_hat.sqrt() + eps))
La ligne de decoupled=True utilise lr * weight_decay, alors que l'article utilise . Gardez cette différence en tête.
Pourquoi la décroissance des poids
La section 3 s'appuie sur le point de vue du filtrage bayésien d'Aitchison (2018) pour justifier la décroissance des poids. On voit l'optimisation stochastique comme le suivi de la distribution a posteriori de chaque paramètre, avec une transition d'état supposée de la forme ; avec , chaque pas multiplie l'estimation courante par , ce qui est exactement la décroissance des poids découplée. Cette décroissance agit sur l'a priori, et ne dépend pas de l'incertitude de chaque paramètre ; pour obtenir l'effet de L2, la décroissance devrait au contraire varier avec l'incertitude. Les auteurs précisent aussi que cette théorie revient entièrement à Aitchison, et qu'ils n'en font que le résumé.
La décroissance des poids normalisée
Les auteurs constatent dans leurs expériences que la meilleure décroissance des poids change avec la durée d'entraînement ; plus l'entraînement est long, plus le meilleur est petit. L'annexe B.1 propose une écriture normalisée :
est la taille de lot, le nombre d'exemples d'entraînement, le nombre total d'époques. peut se comprendre comme la décroissance qu'on appliquerait « si tout l'entraînement ne comptait qu'un seul lot ».
Faisons le calcul pour CIFAR-10, avec et . Pour 100 époques, ; pour 1800 époques, environ 0.0012, et le réel doit être fois plus petit. Sur ImageNet32x32, une époque est 24 fois plus longue que sur CIFAR-10 ; pour un même nombre d'époques, doit encore être environ fois plus petit. D'après les auteurs, reprendre tel quel le brut de CIFAR-10 sur ImageNet32x32 donnerait une valeur environ 5 fois trop grande, avec de bien moins bons résultats. Avec l'écriture normalisée, le meilleur est très proche d'une durée d'entraînement à l'autre, d'un jeu de données à l'autre, et même entre SGDW et AdamW, par exemple 0.025 et 0.05.
Les auteurs soulignent aussi que la racine carrée n'est qu'un choix fondé sur un petit nombre d'expériences ; la conclusion fiable est que « faire une forme de normalisation » améliore déjà nettement les résultats.
AdamWR
Le dernier élément est la planification du taux d'apprentissage. Le SGDR, proposé auparavant par les auteurs, utilise un recuit cosinus avec redémarrages périodiques :
est le nombre d'époques écoulées depuis le dernier redémarrage ; il est mis à jour à chaque lot, et n'est donc pas forcément entier ; est la longueur du cycle courant. Avec et , le multiplicateur du taux d'apprentissage descend, à chaque cycle, de 1 à 0 en suivant un cosinus, puis remonte d'un coup à 1. Avec un premier cycle , et une longueur multipliée à chaque cycle par , les redémarrages ont lieu aux époques 100, 300, 700 et 1500, et le modèle juste avant chaque redémarrage est la solution recommandée.
Ils avaient déjà essayé d'appliquer les redémarrages à Adam, sans parvenir à égaler SGDR, justement parce que L2 est moins efficace dans Adam que dans SGD. Une fois la décroissance des poids corrigée et la normalisation ajoutée (pour que des cycles de longueurs différentes puissent partager les mêmes réglages), AdamW avec redémarrages devient AdamWR.
Discussion
Dispositif expérimental
Les expériences reprennent le dispositif et le code de l'article sur la régularisation Shake-Shake ; le modèle principal est un ResNet de profondeur 26 à deux branches résiduelles, dont le premier bloc résiduel a une largeur de 64 (2x64d, 11.6 millions de paramètres) ou de 96 (2x96d, 25.6 millions de paramètres) ; la taille de lot est fixée à 128, avec l'augmentation de données standard de CIFAR-10. Les auteurs utilisent aussi ImageNet32x32, c'est-à-dire les 1.2 million d'images d'ImageNet réduites à .
La première série d'expériences ne compare qu'Adam et AdamW, avec trois planifications du taux d'apprentissage (fixe, réduite aux époques 30, 60 et 80, recuit cosinus), chacune balayée sur une grille de taux d'apprentissage et de décroissance, avec 100 époques d'entraînement. Quelle que soit la planification, la décroissance des poids découplée fait mieux que L2, et plus la planification est bonne, plus l'écart est grand ; le recuit cosinus est nettement le meilleur, et toutes les expériences suivantes l'utilisent. Ce résultat montre aussi que, même si Adam ajuste déjà le taux d'apprentissage de chaque paramètre, une planification globale du taux d'apprentissage reste utile. L'annexe D entraîne en outre l'Adam classique (L2 et taux d'apprentissage fixe) jusqu'à 1800 époques ; sur une grille grossière de 4×4, son meilleur résultat ne fait qu'égaler celui d'AdamW avec dix-huit fois moins d'époques et un réseau plus petit.
Cartes de chaleur du taux d'apprentissage et de la décroissance des poids
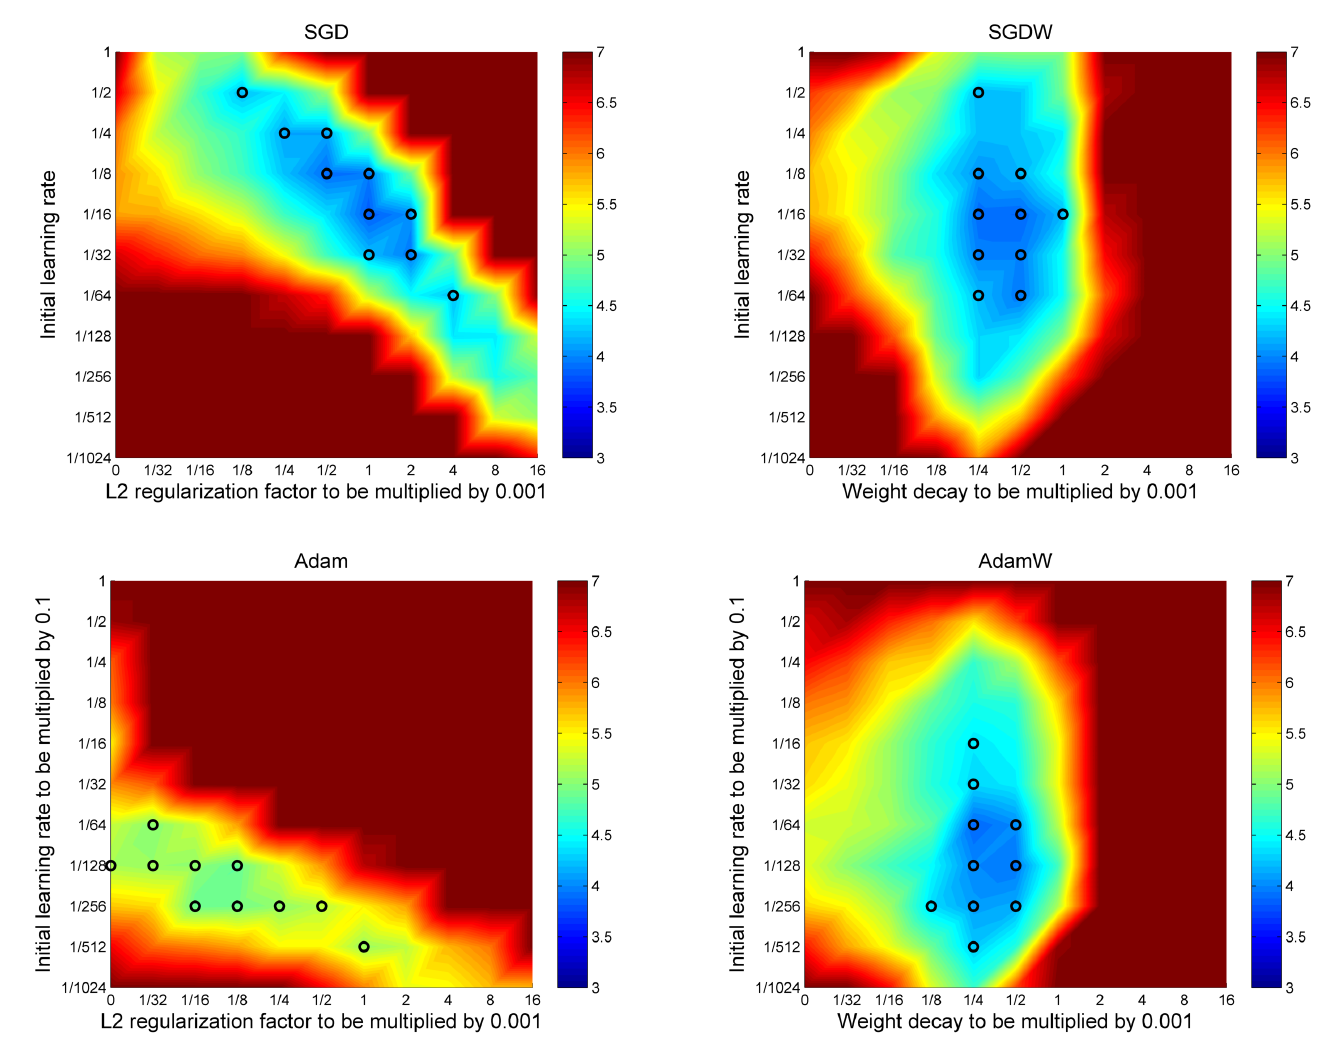
Cette figure est la preuve centrale de l'article. Les quatre cartes montrent le taux d'erreur de test d'un ResNet 26 2x64d entraîné 100 époques sur CIFAR-10 ; l'ordonnée est le taux d'apprentissage initial, l'abscisse le coefficient L2 ou la décroissance des poids ; plus c'est bleu, mieux c'est, et les cercles noirs marquent les 10 meilleures configurations.
En haut à gauche, SGD avec L2. La bonne région est une bande oblique. Par exemple, le cercle noir tout en haut à gauche se trouve à , ; changer l'un des deux seulement dégrade le résultat, alors que changer les deux ensemble peut l'améliorer. C'est exactement le de la Proposition 1 ; dès que le taux d'apprentissage change, le meilleur coefficient L2 change avec lui. Les auteurs pensent que la réputation de SGD, « très sensible aux hyperparamètres », vient peut-être en partie de ce couplage.
En haut à droite, SGDW. La bonne région devient une bande verticale ; les cercles noirs se situent pour la plupart entre 1/4 et 1/2 de décroissance (encore multipliée par 0.001), sur cinq taux d'apprentissage différents. Même avec un taux d'apprentissage mal réglé, par exemple bloqué à 1/1024, il suffit de régler la décroissance pour trouver une bonne valeur.
En bas à gauche, Adam avec L2. Le meilleur résultat est nettement moins bon que celui de SGD. Si l'on regarde où sont les cercles noirs, les configurations au coefficient L2 nul figurent aussi parmi les dix meilleures, et le meilleur résultat avec L2 est à peu près le même que sans L2 du tout. Autrement dit, L2 n'a presque aucun effet ici, et la bonne région est elle aussi oblique.
En bas à droite, AdamW. La bonne région est verticale, comme celle de SGDW, avec des cercles noirs concentrés entre 1/4 et 1/2 de décroissance ; le meilleur résultat est nettement supérieur à celui d'Adam avec L2, et au niveau de SGD et de SGDW.
Cette figure soutient donc deux choses à la fois. Une fois découplés, taux d'apprentissage et décroissance des poids se règlent à peu près séparément ; et Adam, avec une décroissance des poids découplée, rattrape SGD sur cette tâche.
Meilleure généralisation, ou simplement meilleur entraînement ?
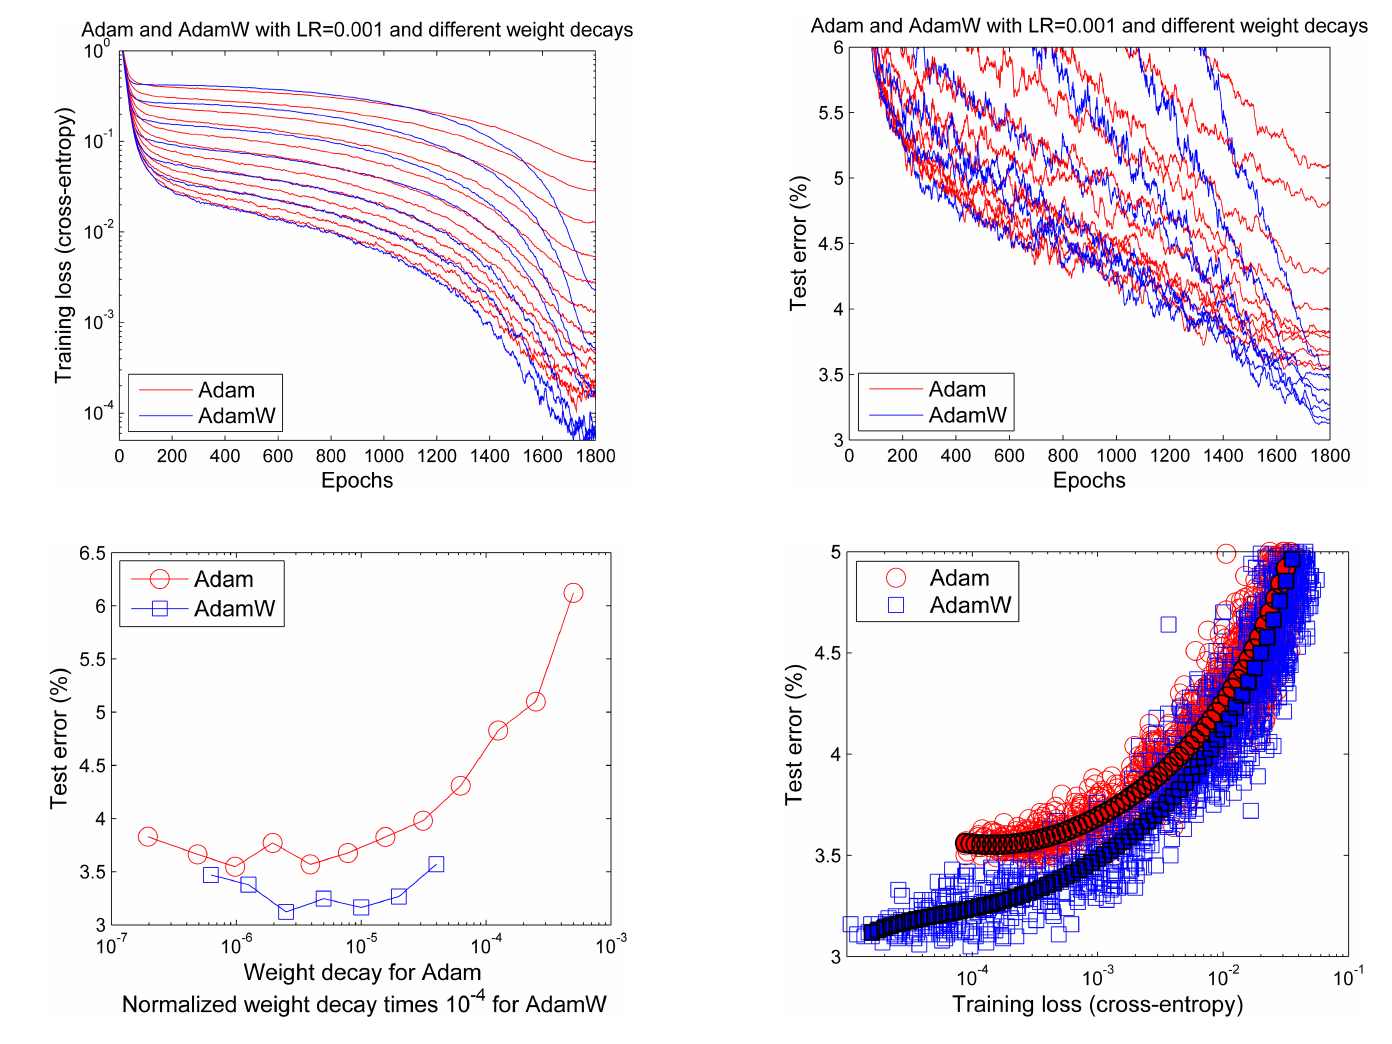
Les cartes de chaleur ne portent que sur 100 époques. Les auteurs entraînent ensuite le 2x96d, plus grand, sur 1800 époques, avec un taux d'apprentissage initial fixé à la valeur par défaut d'Adam, 0.001 (la planification reste un recuit cosinus) ; ils essaient 12 coefficients pour Adam avec L2, et 7 décroissances normalisées pour AdamW.
Dans les courbes d'apprentissage du haut, les deux groupes se superposent souvent dans la première moitié ; dans la seconde, la perte d'entraînement et le taux d'erreur de test d'AdamW sont en général plus bas. En bas à gauche figure le taux d'erreur de test final, d'environ 3.55 % au mieux pour Adam avec L2, et d'environ 3.1 % au mieux pour AdamW.
Le graphique en bas à droite répond à la question du titre. L'abscisse est la perte d'entraînement, l'ordonnée le taux d'erreur de test ; si AdamW se contentait de faire descendre plus bas la perte d'entraînement, les deux groupes de points devraient tomber sur une même courbe. En réalité, à perte d'entraînement égale, le taux d'erreur de test d'AdamW, en bleu, est plus bas que celui d'Adam, en rouge. Les auteurs en concluent qu'AdamW, en plus de mieux s'entraîner, généralise aussi mieux. Les résultats sont les mêmes sur ImageNet32x32.
Redémarrages à chaud et résultats disponibles à tout moment
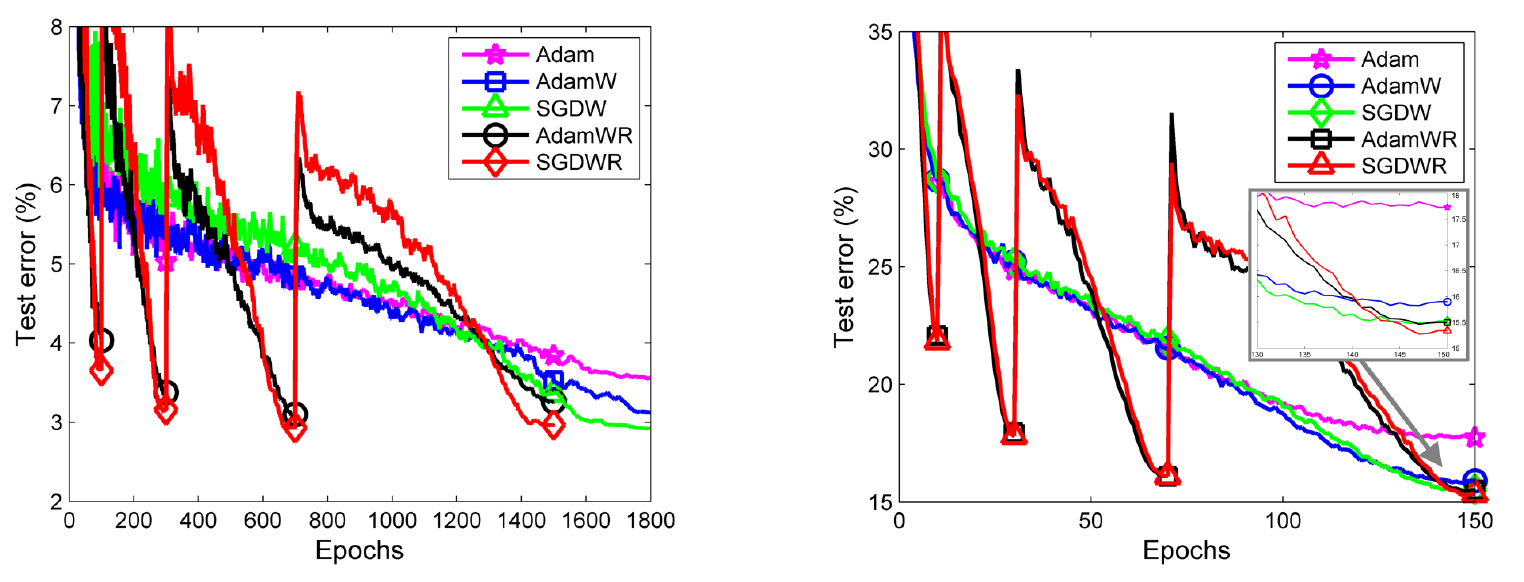
Comparons enfin les versions avec redémarrages à chaud. À gauche, sur CIFAR-10, les deux courbes marquées R remontent à chaque redémarrage, puis redescendent vite jusqu'à un minimum ; avant le premier redémarrage (à la 100e époque), AdamWR atteint déjà environ 4.0 %, et les auteurs disent que cela rend AdamW jusqu'à 10 fois plus rapide. C'est ce que l'article appelle « disponible à tout moment » (anytime) ; même si l'on arrête l'entraînement à mi-chemin, on dispose d'un bon modèle.
L'article rapporte qu'avec le taux d'apprentissage par défaut de 0.001, AdamW réduit le taux d'erreur de test d'Adam de 15 % en relatif, sur CIFAR-10 comme sur ImageNet32x32 ; AdamWR atteint le même résultat, tout en étant disponible à tout moment. Sur le graphique de gauche, Adam s'arrête vers 3.6 % sur CIFAR-10, et AdamW vers 3.1 %. AdamWR comble l'essentiel de l'écart entre Adam et SGDWR ; sur ImageNet32x32, les deux se valent.
Autres tâches et limites
La section 4.5 rassemble des retours d'autres équipes. Une équipe qui travaille sur la classification d'électroencéphalogrammes fournit une comparaison directe, à hyperparamètres identiques ; Deep4Net passe de 71.37 % à 73.68 %, et ResNet de 61.34 % à 72.04 %. Le GPT d'OpenAI de 2018 entraîne un Transformer avec AdamW ; Zhang et al. comparent SGD, Adam et K-FAC sur CIFAR, et dans tous les cas où L2 et décroissance des poids ne sont pas équivalents, la décroissance découplée fait mieux.
Les limites sont claires aussi. Les principales expériences portent toutes sur la classification d'images ; les auteurs écrivent dans leur conclusion que ces résultats restent à vérifier sur davantage de tâches, en particulier celles où la régularisation compte beaucoup. La règle de la racine carrée de la décroissance normalisée ne repose, elle aussi, que sur un petit nombre d'expériences.
Le taux d'apprentissage revient dans le produit
Revenons à cette ligne lr * weight_decay.
Dans l'AdamW de l'article, la décroissance vaut ; elle ne suit que le multiplicateur de planification, sans être multipliée par le taux d'apprentissage de base . L'AdamW de PyTorch applique , où est le taux d'apprentissage effectif, planification comprise ; la décroissance vaut donc . Il en va de même pour l'adamw d'Optax, dont la documentation précise que la décroissance des poids y est multipliée par le taux d'apprentissage, comme dans PyTorch, mais contrairement à l'article, qui ne multiplie que par le multiplicateur de planification ; l'AdamW de Keras soustrait lui aussi variable * wd * lr aux paramètres.
Par conversion, le de l'article correspond au lr × weight_decay de PyTorch. Avec les valeurs par défaut de PyTorch, lr=1e-3 et weight_decay=1e-2, la décroissance par pas vaut , soit dans l'écriture de l'article. Les valeurs par défaut diffèrent aussi d'une bibliothèque à l'autre, 0.01 pour PyTorch, pour Optax, 0.004 pour Keras ; avant de transporter des hyperparamètres, vérifiez de quelle écriture et de quelle valeur par défaut il s'agit.
Cette différence a une conséquence pratique. Avec l'écriture de PyTorch, changer le taux d'apprentissage revient à changer en même temps la décroissance ; la propriété des cartes de chaleur, « deux hyperparamètres réglables séparément », ne tient plus tout à fait. Dans un billet de blog de février 2024, Fabian Schaipp illustre ce point sur un problème de régression ridge synthétique, et conseille, quand on balaie le taux d'apprentissage avec l'AdamW de PyTorch, de garder lr × weight_decay constant ; si le taux d'apprentissage double, la décroissance est divisée par deux. Il mentionne aussi que son expérience de l'entraînement de ViT avec timm va dans le même sens, sans publier d'expérience sur ce point. Wang et Aitchison (2024) prennent un autre angle, où les poids appris par AdamW sont vus comme une moyenne mobile exponentielle des mises à jour récentes, sur une échelle de temps d'environ pas ; sur ResNet, ViT et NanoGPT, ils constatent que l'échelle de temps optimale, comptée en époques, est à peu près fixe, et que la décroissance des poids doit donc diminuer quand le jeu de données grandit. Cela va dans le même sens que la décroissance normalisée de l'article.
Certains frameworks gardent l'écriture de l'article, comme le DecoupledAdamW de MosaicML Composer, dont la décroissance n'est multipliée que par « le taux d'apprentissage courant divisé par le taux initial », c'est-à-dire par le multiplicateur de planification. Par ailleurs, l'Adam de PyTorch a lui aussi un weight_decay, qui est une L2 ; pour obtenir le comportement d'AdamW dans Adam, il faut en plus régler decoupled_weight_decay=True.
La suite
AdamW est ensuite devenu l'équipement standard de l'entraînement des Transformers. LLaMA utilise AdamW avec et une décroissance des poids de 0.1 ; OLMo 2 va jusqu'à exclure la couche d'embedding de la décroissance des poids ; DeepSeek-V4 confie la plupart de ses paramètres à Muon, mais garde AdamW pour les poids de la couche d'embedding, de la tête de prédiction et des couches de normalisation.
Conclusion
Cet article démontre que régularisation L2 et décroissance des poids ne sont équivalentes que dans SGD, et à condition de convertir le coefficient selon le taux d'apprentissage ; dans Adam, le gradient de L2 est divisé par , et les poids aux gradients passés importants sont moins régularisés. Sortir la décroissance du gradient pour l'appliquer directement aux paramètres, c'est AdamW. Les cartes de chaleur sur CIFAR-10 montrent qu'on peut alors régler à peu près séparément le taux d'apprentissage et la décroissance des poids, et que le meilleur score d'Adam rattrape celui de SGD ; la comparaison sur 1800 époques montre qu'à perte d'entraînement égale, AdamW a un taux d'erreur de test plus bas. Les preuves viennent surtout de ResNet en classification d'images, et la règle de normalisation ne repose que sur peu d'expériences.
En pratique, vérifiez d'abord quel AdamW vous utilisez. Dans PyTorch, Optax et Keras, la décroissance vaut le taux d'apprentissage multiplié par weight_decay ; dans l'article et dans Composer, elle n'est multipliée que par le multiplicateur de planification. Pensez à convertir quand vous reprenez les réglages d'un article ou d'un autre framework. Pour balayer le taux d'apprentissage dans PyTorch, vous pouvez garder lr × weight_decay constant ; quant à torch.optim.Adam(weight_decay=...), c'est, du début à la fin, une L2.
La première version de l'article s'intitulait « Fixing Weight Decay Regularization in Adam », et la version corrigée est ensuite devenue l'équipement standard des grands modèles de langage. Seulement, les implémentations les plus répandues ont remis le taux d'apprentissage dans le terme de décroissance.