Article original
SGDR: Stochastic Gradient Descent with Warm Restarts
- Publication
- ICLR 2017Conférence
- Premier dépôt sur arXiv
- arXiv:1608.03983
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizerssgdr2016,
  title = {{SGDR: Stochastic Gradient Descent with Warm Restarts}},
  author = {Ilya Loshchilov and Frank Hutter},
  year = {2016},
  eprint = {1608.03983},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1608.03983}
}
Dans torch.optim.lr_scheduler de PyTorch, la documentation de deux planificateurs renvoie au même article.
L'un est CosineAnnealingWarmRestarts, dont le nom dit déjà clairement d'où il vient. L'autre est CosineAnnealingLR ; sa documentation cite le même article, mais précise que, si SGDR comporte des redémarrages périodiques, cette implémentation fait un recuit cosinus sans redémarrage.
Le titre de l'article parle de « redémarrages », mais ce qui en est resté dans les réglages d'entraînement des grands modèles, c'est surtout la moitié sans redémarrage. Reprenons donc depuis le début ce qu'Ilya Loshchilov et Frank Hutter ont proposé en 2016, et le problème que les redémarrages devaient résoudre à l'origine.
Si vous ne connaissez pas ces deux auteurs, un peu de contexte. Ils sont alors à l'université de Fribourg-en-Brisgau, en Allemagne ; les recherches de Hutter portent principalement sur l'optimisation des hyperparamètres et l'AutoML, et Loshchilov avait auparavant beaucoup travaillé sur la stratégie d'évolution CMA-ES ; quand la section 2 de l'article passe en revue les stratégies de redémarrage, elle cite d'ailleurs ses propres travaux de 2012. En optimisation sans gradient, « faire tourner un moment, puis tout recommencer » est une vieille recette contre les fonctions multimodales, et l'usage courant veut qu'on double la population échantillonnée à chaque redémarrage. Cet article transpose l'habitude des redémarrages à SGD.
Définir le problème
En 2016, pour entraîner des réseaux de type ResNet, la norme est SGD avec momentum, c'est-à-dire les équations (3) et (4) de l'article :
Dans leur introduction, les auteurs expliquent que la partie la plus difficile de ce type d'entraînement se réduit à planifier le taux d'apprentissage et à choisir la décroissance des poids. Le Wide ResNet (WRN) qui sert de référence à l'article part d'un taux d'apprentissage de 0.1, multiplié par 0.2 aux époques 60, 120 et 160, pour 200 époques d'entraînement au total.
Cette planification en escalier pose deux problèmes. D'abord, où baisser et de combien, ce sont des hyperparamètres à régler. Ensuite, le modèle ne devient bon qu'une fois le taux d'apprentissage baissé ; s'il faut s'arrêter à la 100e époque, le modèle en main est encore coincé dans la phase à taux élevé, avec une grande erreur. Les auteurs appellent ce second aspect l'anytime performance, c'est-à-dire le fait de disposer d'un modèle assez bon à quelque moment qu'on s'arrête.
L'objectif de l'article est d'améliorer l'anytime performance de SGD. Comment planifier le taux d'apprentissage pour pouvoir arrêter l'entraînement à tout moment, sans finir moins bien qu'une planification en escalier bien réglée ?
Résoudre le problème
Le redémarrage à chaud
Les auteurs simulent, toutes les époques, un nouveau départ de SGD. Ce redémarrage ne reprend pas l'entraînement depuis zéro. Les paramètres sont conservés tels quels comme nouveau point de départ ; seul le taux d'apprentissage est ramené à une valeur haute, puis on le laisse redescendre. Le texte original souligne aussi que la hauteur à laquelle on remonte le taux d'apprentissage détermine la part de l'information accumulée jusque-là (le momentum, par exemple) qui est conservée.
Le recuit cosinus
Pendant la -ième exécution, le taux d'apprentissage décroît lot après lot selon l'équation (5) :
est le nombre d'époques écoulées depuis le dernier redémarrage. Il est mis à jour à chaque lot, et peut donc valoir 0.1, 0.2, etc. Essayons quelques points :
- , , et le taux d'apprentissage vaut .
- , , et le taux d'apprentissage est exactement à mi-chemin entre les deux extrêmes.
- , , et le taux d'apprentissage descend à .
La courbe descend donc lentement au début, presque linéairement au milieu, puis ralentit à nouveau vers la fin, et reste un moment à faible taux. Dans les expériences sur CIFAR, et sont fixés à 0.05 et 0 pour chaque exécution. Les auteurs notent qu'abaisser ces deux valeurs à chaque redémarrage pourrait être bénéfique, mais ne l'ont pas fait, pour limiter le nombre d'hyperparamètres.
et
La longueur des cycles dépend de deux nombres. est la longueur de la première exécution ; à chaque redémarrage, la période est ensuite multipliée par . Calculons avec les valeurs les plus fréquentes de l'article, et :
| Exécution | Longueur du cycle | Se termine à l'époque |
|---|---|---|
| 1 | 10 | 10 |
| 2 | 20 | 30 |
| 3 | 40 | 70 |
| 4 | 80 | 150 |
| 5 | 160 | 310 |
Dans un budget de 200 époques, seules les quatre premières exécutions vont jusqu'au bout ; la cinquième s'arrête à mi-parcours. Avec et , les redémarrages tombent aux époques 1, 3, 7, 15, 31, 63 et 127.
Doubler la période sert à obtenir rapidement un modèle utilisable avec des cycles très courts, puis à échanger des cycles de plus en plus longs contre de meilleurs résultats ; c'est la même idée que la stratégie d'évolution évoquée plus haut, qui double la population à chaque redémarrage. Une autre configuration est , avec un redémarrage toutes les époques ; quand , tout l'entraînement ne compte qu'un seul cosinus, sans aucun redémarrage. Cette courbe va prendre beaucoup d'importance par la suite.
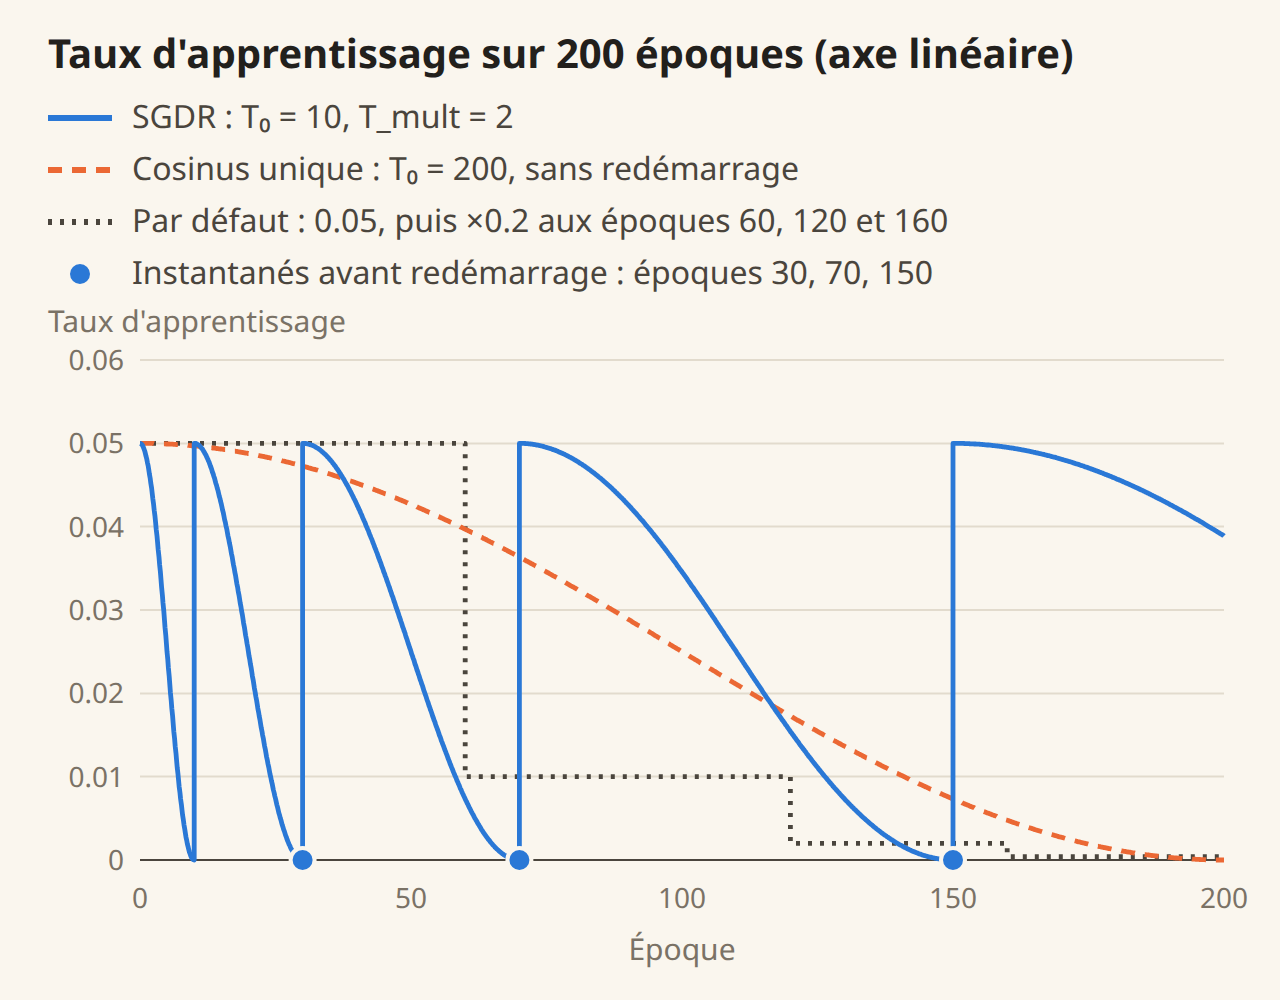
L'article trace ces planifications avec un axe logarithmique, et les auteurs reconnaissent eux-mêmes qu'un axe logarithmique empêche de voir la forme du cosinus ; nous les avons donc retracées ici sur un axe linéaire. La ligne bleue remonte à 0.05 dès qu'elle touche 0 ; la ligne orange en tirets descend lentement de 0.05 jusqu'à 0.
Quel modèle rendre ?
Quand le taux d'apprentissage remonte brusquement, le modèle se dégrade temporairement ; SGDR ne rend donc pas forcément les paramètres du dernier pas. Avant le premier redémarrage, il recommande le le plus récent ; ensuite, il rend la fin du dernier cycle achevé, c'est-à-dire le modèle au moment où le taux d'apprentissage vient d'atteindre . Dans l'exemple du tableau, à la 200e époque, SGDR rend le modèle de la 150e époque. Les auteurs soulignent que cette règle ne demande pas de jeu de validation séparé pour choisir le modèle.
Pourquoi redémarrer
La section 2 revient sur deux lignées. L'optimisation sans gradient utilise les redémarrages contre les fonctions multimodales ; l'optimisation par gradient s'en sert plutôt pour accélérer la convergence. Par exemple, O'Donoghue et Candès (2012) constatent que la méthode accélérée de Nesterov oscille périodiquement quand le momentum est trop fort, et redémarrent donc quand la fonction objectif augmente, ou quand la direction du momentum fait un angle obtus avec le gradient négatif.
Avec des gradients stochastiques, la situation est différente ; la perte et le gradient d'un seul lot sont trop bruités pour reprendre directement ces critères, qu'il faudrait d'abord moyenner (par exemple une fois par époque). Les auteurs ont choisi la version la plus simple, avec des redémarrages à intervalles fixes. Ils restent aussi très prudents dans la discussion, en précisant que l'objectif principal de SGDR est d'améliorer l'anytime performance, et ils ne prétendent avoir observé aucun effet lié à la multimodalité.
Discussion
Dispositif expérimental
L'expérience principale entraîne un WRN-28-10 (28 couches, avec à chaque couche 10 fois plus de filtres que le ResNet d'origine, environ 36.5 millions de paramètres) sur CIFAR-10 et CIFAR-100. Les auteurs reproduisent d'abord le dispositif de l'article WRN, avec un momentum de 0.9, une décroissance des poids de 0.0005, une taille de lot (batch size) de 128, 200 époques, et pour augmentation de données le retournement horizontal et un recadrage aléatoire après un remplissage par réflexion de 4 pixels. Seules deux choses diffèrent du dispositif d'origine ; ils soustraient seulement la moyenne par pixel, sans blanchiment ZCA, et utilisent le momentum dans sa version générale des équations (3) et (4), et non le momentum de Nesterov.
Modèle unique
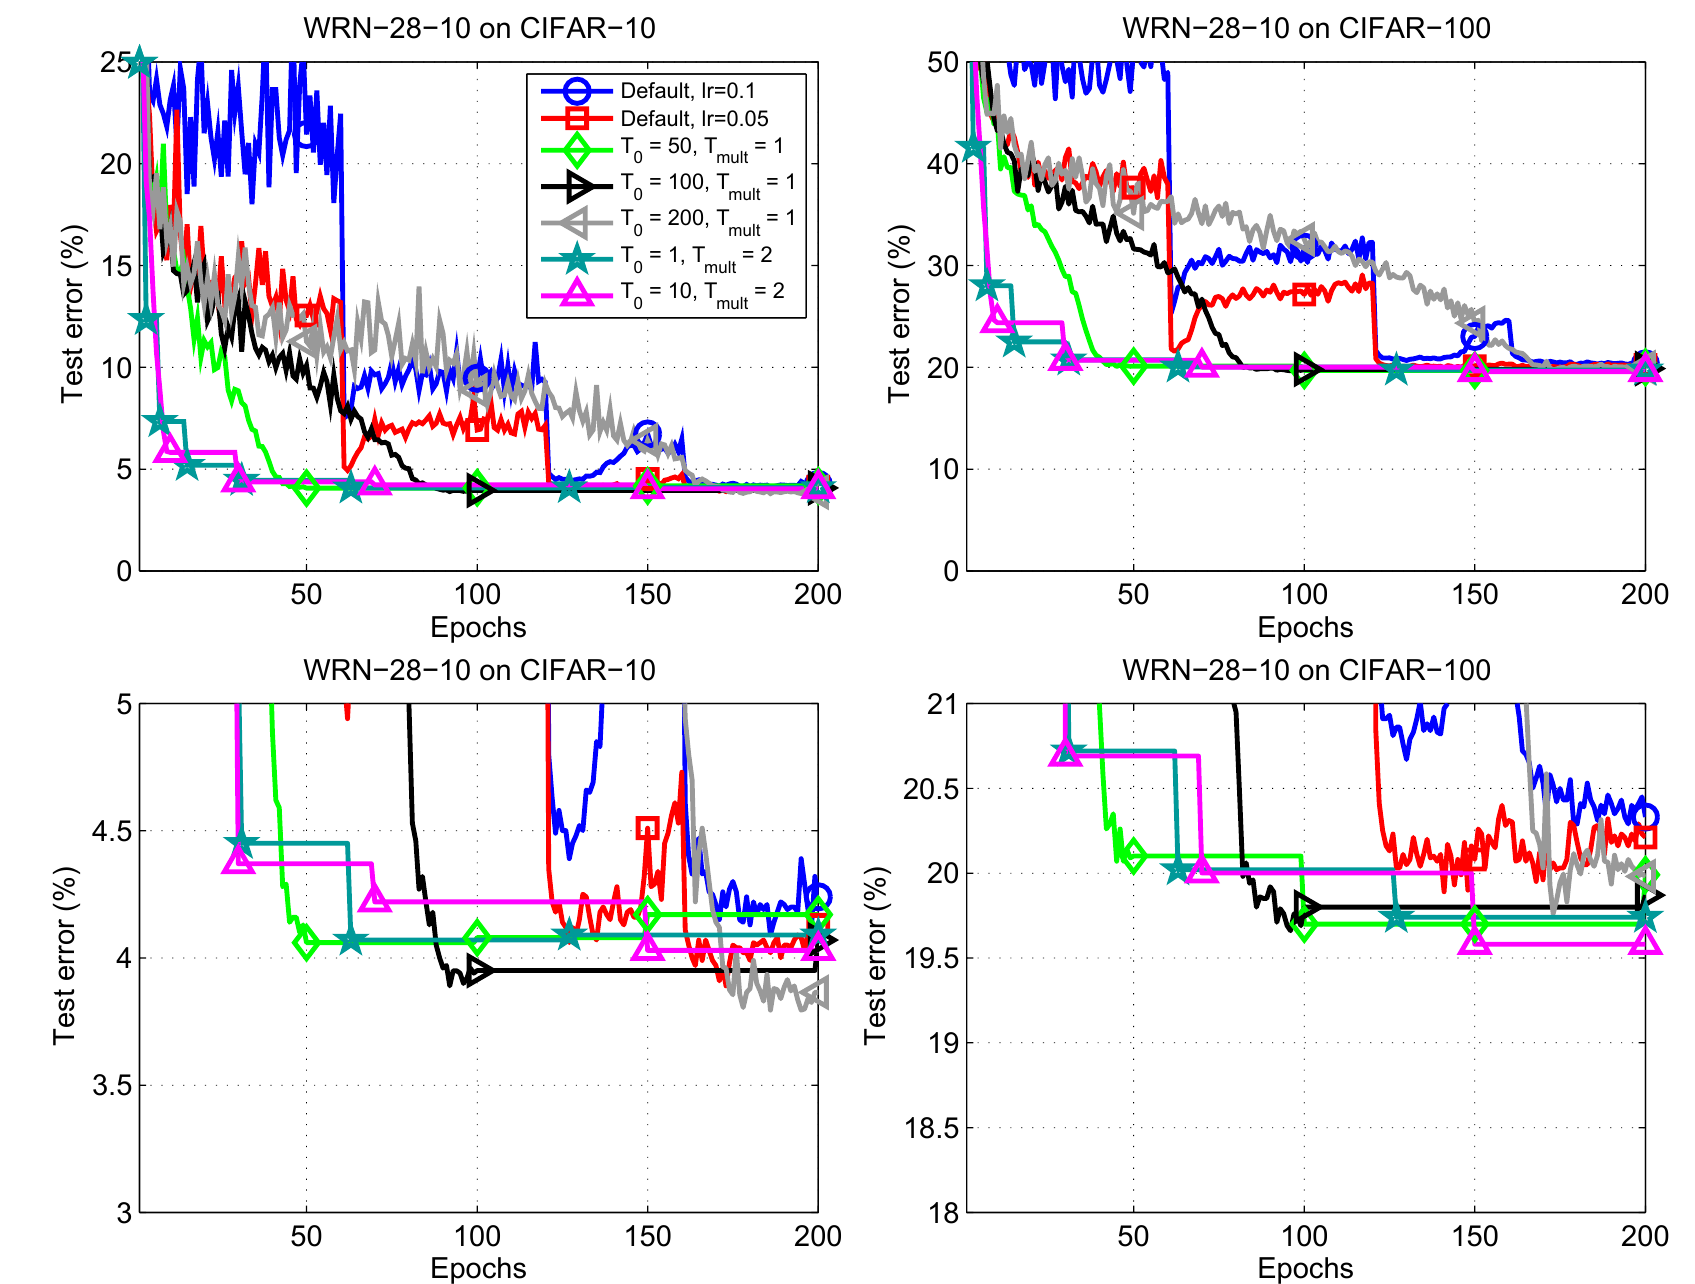
Regardons d'abord la rangée du haut. Les courbes bleue et rouge correspondent à la planification par défaut ; avant la baisse du taux d'apprentissage de la 60e époque, l'erreur de test sur CIFAR-10 est toujours au-dessus de 12 %, et reste entre 7 % et 10 % après une première baisse ; sur CIFAR-100, la courbe rouge remonte même entre deux baisses. Les courbes SGDR montrent la solution recommandée, d'où leur allure en escalier ; les étoiles vertes () et les triangles magenta (), à période doublée, tombent dans la zone de faible erreur en quelques dizaines d'époques. La rangée du bas agrandit les mêmes résultats, et permet de voir qui passe au-dessus de qui dans les dernières époques.
Les auteurs concluent que SGDR atteint, en 2 à 4 fois moins d'époques, une erreur de test d'environ 4 % sur CIFAR-10 et 20 % sur CIFAR-100. Les chiffres finaux sont les suivants :
| Planification du WRN-28-10 | CIFAR-10 | CIFAR-100 |
|---|---|---|
| Par défaut, η₀ = 0.1 | 4.24 | 20.33 |
| Par défaut, η₀ = 0.05 | 4.13 | 20.21 |
| T₀ = 50, T_mult = 1 | 4.17 | 19.99 |
| T₀ = 100, T_mult = 1 | 4.07 | 19.87 |
| T₀ = 200, T_mult = 1 | 3.86 | 19.98 |
| T₀ = 1, T_mult = 2 | 4.09 | 19.74 |
| T₀ = 10, T_mult = 2 | 4.03 | 19.58 |
D'après la Table 1 de l'article ; erreur de test (%), médiane de cinq exécutions.
Deux points sont à noter en lisant ce tableau. D'abord, les écarts ne sont le plus souvent que de quelques dixièmes de point, chaque configuration n'a été lancée que cinq fois, et les auteurs écrivent aussi dans la légende du tableau que le gras ne fait que signaler les meilleurs chiffres, sans test statistique. Ensuite, le meilleur modèle unique sur CIFAR-10, à 3.86 %, vient de , , c'est-à-dire d'un cosinus complet sans aucun redémarrage. Les auteurs en déduisent que la planification en escalier d'origine de WRN n'est peut-être pas le meilleur choix ; mais l'anytime performance de cette configuration est aussi la pire, et elle ne rattrape les autres que dans les toutes dernières époques.
Les auteurs utilisent le temps gagné pour entraîner un WRN-28-20 plus large (145.8 millions de paramètres, environ 3 à 4 fois plus de calcul). CIFAR-10 s'améliore d'environ 0.25 point de pourcentage, CIFAR-100 de 0.5 à 1 point, et , obtient 3.74 % et 18.70 %. Sur les 50 premières époques seulement, le WRN-28-20 avec , pas encore redémarré, passe déjà sous 19 % sur CIFAR-100, alors que le WRN-28-10, quelle que soit sa planification, ne fait jamais mieux que 19.5 %.
Les courbes d'entraînement de l'annexe ajoutent une observation. Jusqu'à la 120e époque environ, la perte d'entraînement de SGDR baisse plus vite que celle de la planification par défaut ; ensuite, la planification par défaut commence à surapprendre, sa perte de test remonte, et SGDR ne surapprend que légèrement.
Un ensemble d'instantanés gratuit
Après la première version arXiv de SGDR, les Snapshot Ensembles de Huang et al. utilisent ses cycles pour construire des ensembles. Juste avant chaque redémarrage, le taux d'apprentissage vient d'atteindre son minimum, et le modèle se trouve à une bonne position ; en sauvegardant ces instantanés (snapshots), on obtient un groupe de modèles sans coût d'entraînement supplémentaire. La version définitive de cet article vérifie si cette idée tient sur WRN.
La méthode consiste à entraîner un WRN-28-10 avec SGDR, et , et à sauvegarder des instantanés aux époques 30, 70 et 150, c'est-à-dire aux trois points bleus du graphique des planifications. À l'inférence, on fait la moyenne, à poids égaux, des probabilités de sortie softmax des instantanés.
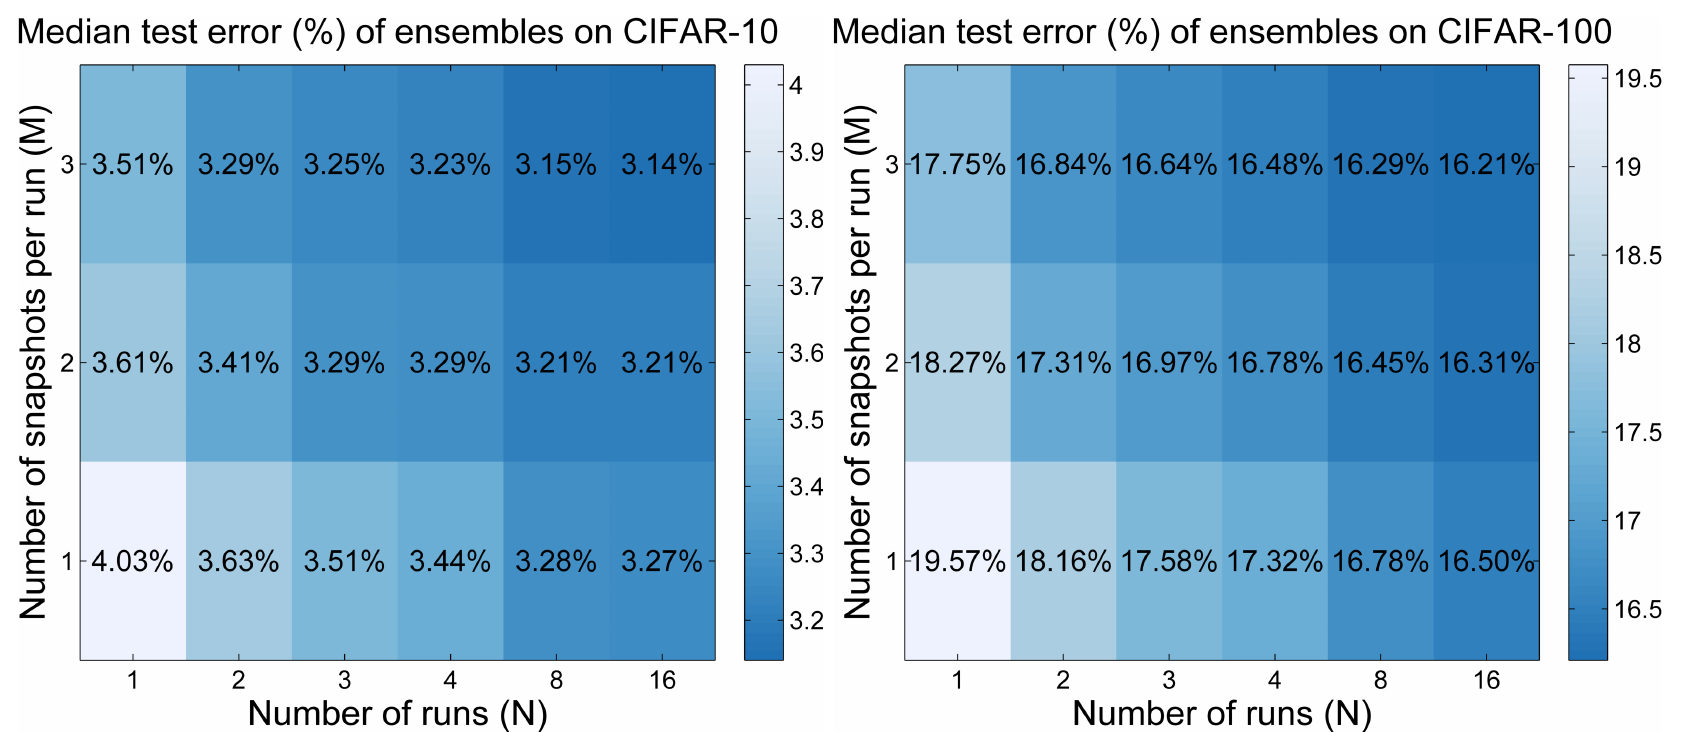
L'abscisse donne le nombre d'entraînements indépendants (), l'ordonnée le nombre d'instantanés pris par entraînement (). Le coin inférieur gauche correspond au modèle unique, 4.03 % sur CIFAR-10 et 19.57 % sur CIFAR-100 (médiane sur 16 exécutions). En montant jusqu'à , les trois instantanés d'un même entraînement font descendre l'erreur à 3.51 % et 17.75 %. Pour obtenir un effet comparable par des entraînements indépendants, il faut exécutions (3.51 % et 17.58 %) ; dans ce cadre, les instantanés divisent donc par trois environ le volume d'entraînement.
La provenance des instantanés compte aussi. Si l'on fait un ensemble avec les modèles des trois dernières époques (148, 149 et 150), le résultat est le même qu'avec le seul modèle de la 150e époque, sans amélioration. Les instantanés pris avant les redémarrages sont utiles parce qu'ils viennent de cycles différents, et que leurs prédictions diffèrent.
Les deux approches se cumulent. Avec 3 entraînements et 3 instantanés chacun, l'erreur tombe à 3.25 % et 16.64 % ; avec 16 entraînements et 3 instantanés chacun, on obtient les 3.14 % et 16.21 % du résumé, le meilleur résultat d'alors sur CIFAR selon l'article, mais au prix d'un ensemble de 48 modèles. Les tendances ne sont pas tout à fait les mêmes sur les deux jeux de données. Sur CIFAR-10, les 9 instantanés (, ) donnent 3.25 %, déjà au niveau des 3.27 % de 16 modèles indépendants ; sur CIFAR-100, les 16 modèles indépendants, à 16.50 %, restent un peu meilleurs que les 9 instantanés, à 16.64 %.
EEG et ImageNet sous-échantillonné
Pour montrer que la méthode ne vaut pas seulement pour CIFAR, les auteurs mènent deux autres séries d'expériences.
La première porte sur des électroencéphalogrammes (EEG), avec 14 sujets et environ 1 000 essais chacun ; il s'agit de classer les mouvements réels de la main gauche, de la main droite et des pieds, et le réseau reprend le réseau convolutif conçu par Schirrmeister et al. La planification de référence exige de fixer d'abord le nombre total d'époques (de 30 à 480), puis de diviser le taux d'apprentissage par 10 à des moments fixés proportionnellement ; plus le budget est grand, meilleur est le résultat. SGDR n'a pas besoin de fixer le budget à l'avance ; ses performances finales sont proches de celles de la référence, et meilleures en cours de route. L'ensemble d'instantanés est lui aussi efficace. Partant d'une erreur de référence médiane d'environ 9 %, les instantanés d'un seul entraînement la font encore baisser de 1 à 2 points de pourcentage, et la combinaison des instantanés de deux réglages du taux d'apprentissage de 2 à 3 points.
La seconde utilise un ImageNet sous-échantillonné construit par les auteurs ; les 1 000 classes et les images sont celles de l'original, simplement réduites à 32 × 32 par box downsampling (ce jeu de données a ensuite fait l'objet d'une publication séparée, en 2017). Chaque image compte en moyenne deux ordres de grandeur de pixels en moins, ce qui le rend plus difficile que l'ImageNet d'origine ; avec plus de classes, et des objets qui n'occupent souvent qu'une petite partie de l'image, il est aussi plus difficile que CIFAR. Sur un WRN-28-10, les auteurs comparent la planification par défaut et deux configurations SGDR, chacune avec 4 taux d'apprentissage initiaux (0.05, 0.025, 0.01, 0.005). SGDR avec , et obtient une erreur top-1 de 39.24 % et top-5 de 17.17 %, comparable aux 40.7 % et 18.2 % d'AlexNet sur l'ImageNet en pleine résolution. Cette expérience ne dure qu'environ 40 époques, et les auteurs la qualifient eux-mêmes de préliminaire ; la comparaison avec AlexNet mélange résolutions et modèles, et ne vaut que comme point de repère.
Selon les auteurs, le choix du taux d'apprentissage initial pèse lourd sur ces résultats ; comme chaque cycle de SGDR balaie tout l'intervalle depuis la valeur initiale jusqu'à 0, cela revient à essayer toute une plage de taux, ce qui atténue les dégâts d'une mauvaise valeur initiale.
Les redémarrages sont-ils vraiment l'essentiel ?
Sur CIFAR-10, les meilleurs modèles uniques, 3.86 % pour WRN-28-10 et 3.66 % pour WRN-28-20, viennent tous deux de , sans redémarrage. Les auteurs écrivent aussi dans la discussion que, même sans aucun redémarrage, la planification agressive de l'équation (5) est très compétitive face à la planification par défaut, et ne demande que deux hyperparamètres, le taux d'apprentissage initial et le nombre total d'époques.
Les travaux ultérieurs l'ont dit plus clairement. Gotmare et al. (ICLR 2019) analysent la trajectoire de SGDR par la mode connectivity, en entraînant un VGG-16 sur CIFAR-10 avec la même planification, et . Entre les modèles des époques 30 et 150, et entre ceux des époques 70 et 150, la perte d'entraînement le long du segment qui les relie est effectivement plus élevée qu'aux extrémités, signe qu'après le redémarrage, les paramètres ont franchi une barrière ; mais les modèles des époques 70 et 150 ne sont pas des minima locaux, et ne semblent pas non plus se trouver dans des bassins différents ; l'idée de « sortir d'un minimum local » est donc peut-être trop simpliste. Dans une note de bas de page, ils mentionnent que ce qui a constamment bien marché dans leurs expériences, c'est une seule décroissance cosinus (ou linéaire) sur tout le budget ; ils supposent que l'effet vient surtout de la décroissance, et que les redémarrages comptent moins.
C'est aussi ainsi qu'on s'en sert en pratique. En 2017, le cours de fast.ai avait popularisé SGDR avec cycle_len et cycle_mult ; fin 2018, avec fastai v1, les mainteneurs répondent sur le forum que cette écriture ne fonctionne plus, et que la valeur par défaut est désormais 1cycle. Les grands entraînements qui ont suivi n'utilisent le plus souvent qu'un seul cycle cosinus :
- Bag of Tricks (He et al., 2018) utilise sur ImageNet une « version simplifiée », où le taux d'apprentissage descend en cosinus de sa valeur initiale jusqu'à 0 (l'échauffement étant compté à part).
- GPT-3 fait descendre le taux d'apprentissage en cosinus jusqu'à 10 % de sa valeur d'origine, sur 260 milliards de tokens, puis le maintient à 10 % ; les 375 premiers millions de tokens servent à un échauffement linéaire.
- LLaMA utilise une planification cosinus dont le taux final vaut 10 % du maximum, avec 2 000 pas d'échauffement.
Avec un seul cycle, il faut connaître à l'avance le nombre total de pas, et le problème que SGDR voulait traiter revient. L'annexe de Chinchilla en a chiffré le coût ; si le cycle cosinus est plus long d'au moins 25 % que le nombre réel de pas d'entraînement, le modèle se dégrade nettement. WSD (une planification en trois phases, échauffement, plateau et décroissance), WSM et Schedule-Free, apparus ensuite, traitent tous ce problème.
Conclusion
SGDR écrit la planification du taux d'apprentissage sous forme d'une formule. Chaque cycle descend de à en suivant un cosinus, la longueur des cycles est fixée par et , et à la fin d'un cycle, on remonte le taux d'apprentissage pour recommencer. Sur CIFAR, SGDR atteint en 2 à 4 fois moins d'époques une erreur comparable à celle de la planification en escalier, et les instantanés pris avant les redémarrages forment en plus un ensemble gratuit ; quant au meilleur modèle unique sur CIFAR-10, il vient d'un cosinus sans redémarrage.
Si vous savez combien de temps vous allez entraîner, le plus simple est un cycle cosinus complet, avec égal au nombre total de pas, précédé si besoin d'un échauffement ; c'est la version que propose CosineAnnealingLR. CosineAnnealingWarmRestarts ne vaut la peine que si vous voulez un ensemble d'instantanés, ou si vous ne connaissez vraiment pas votre budget ; dans ce cas, pensez à suivre la règle de l'article, et à rendre le modèle de fin de cycle, pas celui du dernier pas.
Les noms des deux planificateurs de PyTorch ont en fait déjà choisi pour vous. Si vous n'avez pas l'intention de redémarrer, prenez celui dont le nom est le plus court.