Article original
LLaMA: Open and Efficient Foundation Language Models
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:2302.13971
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{transformersllama2023,
  title = {{LLaMA: Open and Efficient Foundation Language Models}},
  author = {Hugo Touvron and Thibaut Lavril and Gautier Izacard and Xavier Martinet and Marie-Anne Lachaux and Timothée Lacroix and Baptiste Rozière and Naman Goyal and Eric Hambro and Faisal Azhar and Aurelien Rodriguez and Armand Joulin and Edouard Grave and Guillaume Lample},
  year = {2023},
  eprint = {2302.13971},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2302.13971}
}
Fin février 2023, ChatGPT n'a même pas encore trois mois, et les modèles de langage les plus puissants sont presque tous enfermés derrière des API.
Les poids de GPT-3, Gopher, Chinchilla et PaLM ne sont pas publics, et leurs données d'entraînement se résument souvent à une ligne de description, du genre « Livres – 2 To » ou « Conversations de réseaux sociaux ». Des modèles à poids ouverts existent bien (OPT, GPT-NeoX, BLOOM et GLM ont tous été publiés), mais selon les auteurs, aucun n'est au niveau de PaLM-62B ou de Chinchilla.
Dans cet article, Touvron, Lavril, Izacard, Grave, Lample et leurs collègues de Meta AI présentent LLaMA, une série de modèles de fondation de 7 à 65 milliards de paramètres. Deux affirmations attirent tout de suite l'attention. D'abord, LLaMA-13B, avec 13 milliards de paramètres, bat GPT-3 et ses 175 milliards sur la plupart des benchmarks, et tourne en inférence sur un seul V100. Ensuite, toutes les données d'entraînement viennent de jeux de données publics, et les poids sont mis à la disposition de la communauté de recherche (mis à disposition, c'est vite dit, puisqu'il fallait remplir un formulaire de demande ; une semaine plus tard, ils traînaient partout sur Internet).
Définir le problème
L'année précédente, Chinchilla avait montré qu'à budget de calcul d'entraînement donné, les meilleurs résultats viennent non pas du plus grand modèle, mais d'un modèle plus petit entraîné sur davantage de données. Son objectif était d'utiliser au mieux le calcul d'entraînement.
Les auteurs font remarquer que cet objectif ignore le coût d'inférence ; or, une fois le modèle déployé, le coût total de l'inférence dépasse souvent de loin celui de l'entraînement. Pour atteindre un niveau de performance donné, le modèle le plus intéressant est le plus rapide en inférence, et non le plus rapide à entraîner. Entraîner un grand modèle jusqu'à un certain niveau coûte peut-être moins cher, mais un petit modèle entraîné plus longtemps finit par faire économiser bien davantage à l'inférence.
Les auteurs donnent un point de comparaison. Selon les recommandations de Chinchilla, un modèle de 10 milliards de paramètres devrait être entraîné sur environ 200 milliards de tokens ; or ils constatent qu'un modèle de 7 milliards de paramètres continue de progresser après 1 000 milliards de tokens.
L'objectif de l'article est donc d'entraîner, pour différents budgets d'inférence, le meilleur modèle possible dans chaque cas, en lui faisant voir beaucoup plus de tokens que d'habitude.
Calculons le « nombre de tokens vus par paramètre » de quelques modèles. Les FLOPs d'entraînement valent environ et l'inférence environ par token, où est le nombre de paramètres et le nombre de tokens d'entraînement :
models = {               # paramètres, tokens d'entraînement
    "GPT-3 175B":     (175e9, 300e9),
    "Chinchilla 70B": (70e9, 1.4e12),
    "LLaMA-7B":       (6.7e9, 1.0e12),
    "LLaMA-13B":      (13.0e9, 1.0e12),
    "LLaMA-65B":      (65.2e9, 1.4e12),
}
for name, (n, d) in models.items():
    train = 6 * n * d          # FLOPs d'entraînement, environ 6ND
    infer = 2 * n              # inférence, environ 2N FLOPs par token
    print(f"{name:15s} tokens/param {d / n:6.1f}  entraînement {train:.1e}  inférence/token {infer:.1e}")

# GPT-3 175B      tokens/param    1.7  entraînement 3.2e+23  inférence/token 3.5e+11
# Chinchilla 70B  tokens/param   20.0  entraînement 5.9e+23  inférence/token 1.4e+11
# LLaMA-7B        tokens/param  149.3  entraînement 4.0e+22  inférence/token 1.3e+10
# LLaMA-13B       tokens/param   76.9  entraînement 7.8e+22  inférence/token 2.6e+10
# LLaMA-65B       tokens/param   21.5  entraînement 5.5e+23  inférence/token 1.3e+11
Le ratio de LLaMA-65B est proche de celui de Chinchilla, environ 20 tokens par paramètre. Ce sont les petits modèles qui sont au cœur de l'article ; LLaMA-7B a vu près de 150 tokens par paramètre, bien au-delà du ratio « optimal » de Chinchilla. Si LLaMA-13B rattrape vraiment GPT-3, il le fait avec un quart du calcul d'entraînement de GPT-3, et un coût d'inférence par token d'environ un treizième seulement.
Résoudre le problème
Uniquement des données publiques
| Source de données | Proportion d'échantillonnage | Époques pour 1.4T tokens d'entraînement | Taille sur disque |
|---|---|---|---|
| CommonCrawl | 67.0 % | 1.10 | 3.3 To |
| C4 | 15.0 % | 1.06 | 783 Go |
| GitHub | 4.5 % | 0.64 | 328 Go |
| Wikipedia | 4.5 % | 2.45 | 83 Go |
| Books | 4.5 % | 2.23 | 85 Go |
| ArXiv | 2.5 % | 1.06 | 92 Go |
| StackExchange | 2.0 % | 1.03 | 78 Go |
D'après la Table 1 de l'article.
Chaque source a son propre traitement :
- CommonCrawl : cinq instantanés de 2017 à 2020, passés par le pipeline CCNet, qui dédoublonne ligne par ligne, élimine les pages non anglaises avec fastText et filtre les contenus de faible qualité avec un modèle de langage n-gram. Les auteurs entraînent en plus un classifieur linéaire qui distingue « les pages citées comme références par Wikipédia » des pages aléatoires, et ne gardent que les premières.
- C4 : les auteurs constatent qu'ajouter du CommonCrawl traité de différentes manières est bénéfique, et ajoutent donc le C4 de T5. Son filtrage de qualité repose surtout sur des règles portant sur la ponctuation, le nombre de mots ou le nombre de phrases, contrairement à CCNet.
- GitHub : seuls les projets sous licence Apache, BSD ou MIT sont conservés, filtrés selon la longueur des lignes et la proportion de caractères alphanumériques, puis dédoublonnés au niveau du fichier, sur correspondance exacte.
- Wikipédia : les versions de juin à août 2022, couvrant 20 langues qui utilisent l'alphabet latin ou cyrillique.
- Livres : les livres du domaine public du projet Gutenberg, plus Books3, issu de The Pile ; quand des livres se recouvrent à plus de 90 %, un seul est conservé.
- ArXiv : les sources LaTeX, dont on supprime tout ce qui précède la première section, la bibliographie et les commentaires, et dont on développe les macros définies par les auteurs.
- StackExchange : les questions-réponses des 28 plus grands sites, avec les réponses triées par score décroissant.
La tokenisation utilise le BPE de SentencePiece ; les nombres sont toujours découpés chiffre par chiffre, et les caractères UTF-8 inconnus sont décomposés en octets. Au total, environ 1 400 milliards de tokens ; la plupart des données ne sont vues qu'une fois, Wikipédia et les livres environ deux fois.
Architecture : trois modifications empruntées
LLaMA est un décodeur Transformer standard, avec trois modifications proposées par d'autres et déjà utilisées dans de grands modèles ; l'article indique leur origine entre parenthèses :
- Pre-normalization (GPT-3) : on normalise l'entrée de chaque sous-couche, et non sa sortie, pour stabiliser l'entraînement ; la fonction de normalisation est RMSNorm.
- SwiGLU (PaLM) : la ReLU de la couche feed-forward est remplacée par SwiGLU.
- Encodage de position rotatif RoPE (GPT-Neo) : les encodages de position absolus disparaissent, remplacés par RoPE à chaque couche.
SwiGLU cache un petit détail. L'article indique une largeur de feed-forward de , et non les de PaLM. La raison est que SwiGLU a trois matrices, contre deux pour une couche feed-forward standard ; en multipliant la largeur par deux tiers, on retrouve à peu près le même nombre de paramètres. Le code officiel arrondit ensuite au multiple de 256 supérieur. Faisons le calcul avec pour LLaMA-7B :
d, multiple_of = 4096, 256          # d_model de LLaMA-7B

hidden = int(2 * (4 * d) / 3)       # deux tiers de 4d
hidden = multiple_of * ((hidden + multiple_of - 1) // multiple_of)  # arrondi au multiple de 256 supérieur
print(hidden)                       # 11008

relu_ffn = 2 * d * (4 * d)          # deux matrices : d→4d, 4d→d
swiglu_ffn = 3 * d * hidden         # trois matrices : W, V et la matrice de sortie
print(f"{relu_ffn / 1e6:.1f}M {swiglu_ffn / 1e6:.1f}M")  # 134.2M 135.3M
Le nombre de paramètres du feed-forward reste presque identique à chaque couche, et l'on y gagne le surcroît de qualité de SwiGLU.
Voici les réglages des quatre tailles ; pour tous les modèles, un lot contient 4 millions de tokens :
| Paramètres | Têtes d'attention | Couches | Taux d'apprentissage | Tokens d'entraînement | |
|---|---|---|---|---|---|
| 6.7B | 4 096 | 32 | 32 | 1.0T | |
| 13.0B | 5 120 | 40 | 40 | 1.0T | |
| 32.5B | 6 656 | 52 | 60 | 1.4T | |
| 65.2B | 8 192 | 64 | 80 | 1.4T |
D'après la Table 2 de l'article.
L'optimiseur est AdamW (, ), avec une décroissance cosinus du taux d'apprentissage jusqu'à 10 % du maximum, une décroissance des poids de 0.1, un écrêtage des gradients à 1.0 et 2 000 étapes d'échauffement.
Accélérer l'entraînement
Les auteurs recourent à plusieurs optimisations d'ingénierie :
- Implémentation efficace de l'attention causale : issue de la bibliothèque xformers, elle ne stocke pas les poids d'attention et ne calcule pas les scores key/query que le masque causal élimine de toute façon.
- Moins de recalcul pendant la rétropropagation : les activations coûteuses à calculer, comme les sorties des couches linéaires, sont conservées ; pour cela, les auteurs écrivent à la main la rétropropagation des couches Transformer au lieu de s'en remettre à l'autograd de PyTorch.
- Parallélisme de modèle et parallélisme de séquence, en faisant se chevaucher autant que possible le calcul des activations et les communications entre GPU.
Pour le 65B, chaque GPU traite environ 380 tokens par seconde. Avec 2 048 A100 de 80 Go, il faut environ 21 jours pour parcourir 1 400 milliards de tokens.
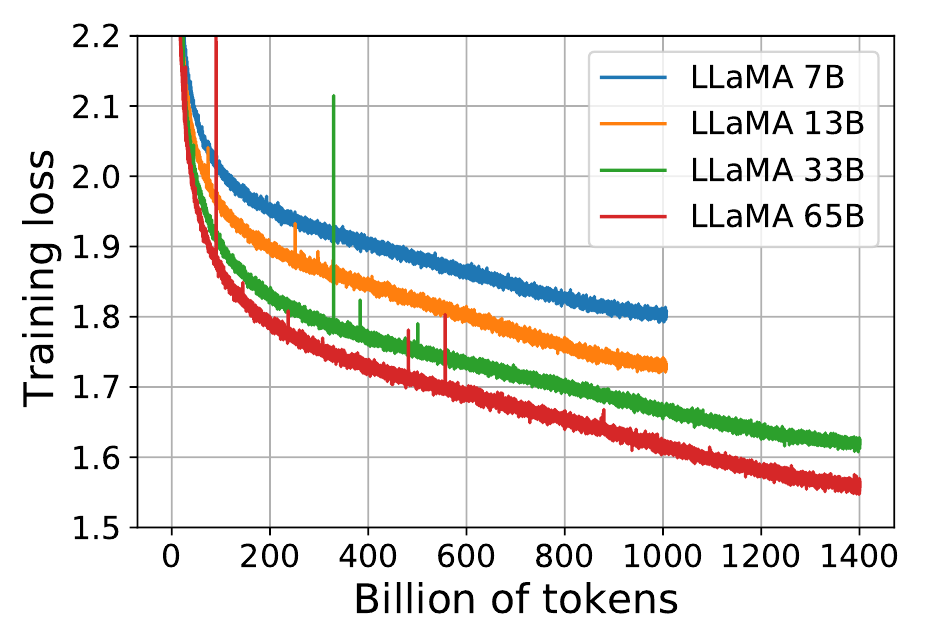
Cette figure appuie l'affirmation de départ. Les quatre courbes de perte d'entraînement descendent encore à la fin, et celle du 7B ne s'aplatit pas non plus à 1 000 milliards de tokens.
Discussion
Résultats principaux
Les auteurs évaluent les modèles sur 20 benchmarks, face aux modèles non publics GPT-3, Gopher, Chinchilla et PaLM, et aux modèles publics OPT, GPT-J et GPT-Neo. Les chiffres viennent des articles respectifs de chaque modèle.
Raisonnement de sens commun (zero-shot, 8 benchmarks). LLaMA-65B bat Chinchilla-70B partout sauf sur BoolQ, et PaLM-540B partout sauf sur BoolQ et WinoGrande. LLaMA-13B bat GPT-3 sur la plupart des benchmarks.
Questions-réponses à livre fermé. Sur Natural Questions, le 65B obtient 23.8 en zero-shot et 39.9 en 64-shot, contre respectivement 21.2 et 39.6 pour PaLM-540B. Sur les deux benchmarks de questions-réponses à livre fermé, LLaMA-13B soutient aussi la comparaison avec GPT-3 et Chinchilla, et les auteurs soulignent qu'il ne demande qu'un seul V100 en inférence.
Mathématiques. Sur GSM8K, LLaMA-65B obtient 50.9 en une seule réponse, un peu moins que Minerva-62B (52.4), fine-tuné sur 38.5 milliards de tokens d'arXiv et de pages web mathématiques. Avec le vote majoritaire, c'est-à-dire en échantillonnant plusieurs réponses à la même question puis en procédant à un vote, LLaMA-65B atteint 69.7, devant les 68.5 de Minerva-62B. LLaMA n'a été fine-tuné sur aucune donnée mathématique.
Code. En pass@1 sur HumanEval, LLaMA-65B obtient 23.7, PaLM-62B 15.9 et PaLM-540B 26.2. À partir de 13B, LLaMA bat LaMDA-137B sur HumanEval comme sur MBPP. Ce sont tous des modèles généralistes, ni entraînés ni fine-tunés spécialement pour le code.
MMLU est le point où LLaMA est nettement à la traîne. Le 65B obtient une moyenne de 63.4 en 5-shot, contre 67.5 pour Chinchilla-70B et 69.3 pour PaLM-540B. Les auteurs l'attribuent au manque de livres et d'articles académiques. ArXiv, Gutenberg et Books3 ne totalisent que 177 Go, alors que Gopher, Chinchilla et PaLM ont utilisé jusqu'à 2 To de livres. Ils expliquent aussi par là pourquoi Gopher bat GPT-3 sur MMLU alors que les deux se valent sur les autres benchmarks.
Les performances pendant l'entraînement
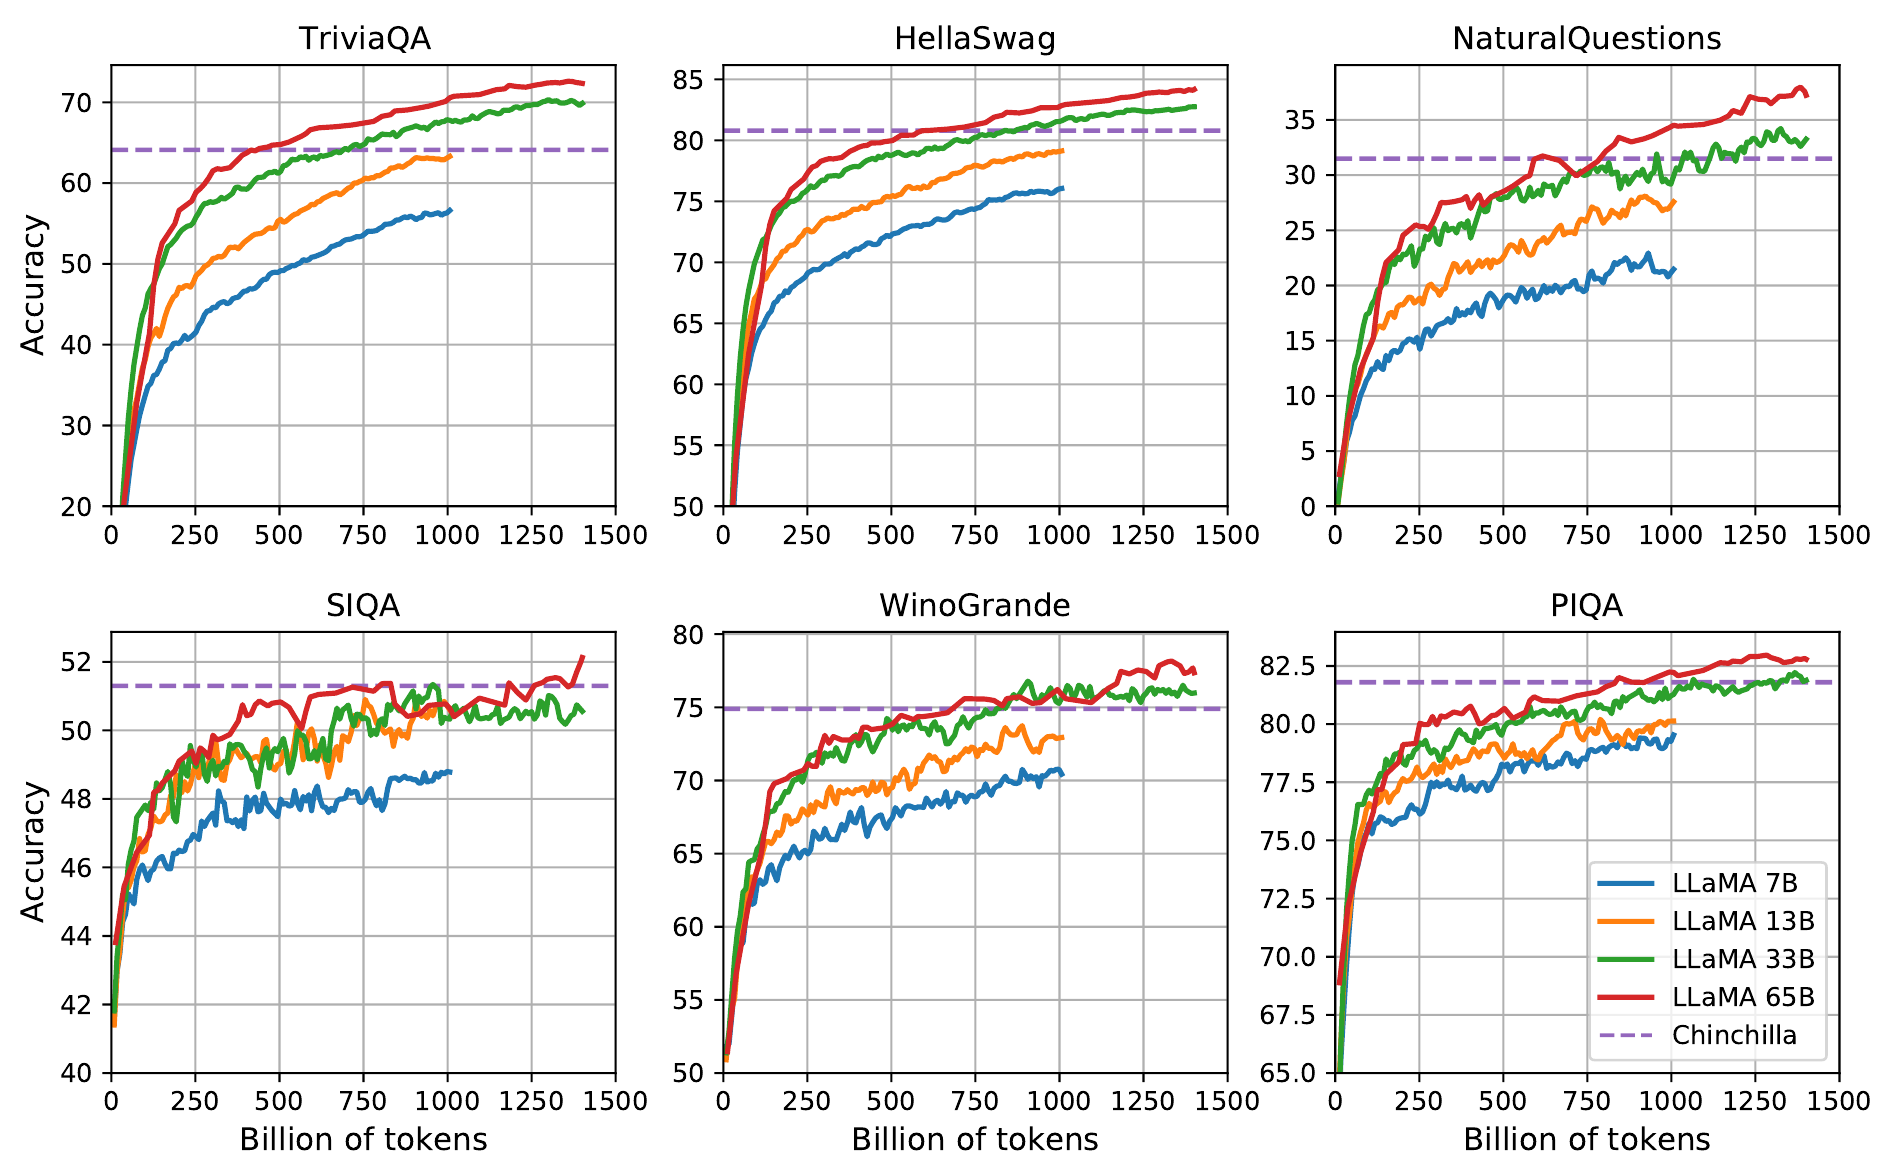
Les auteurs suivent plusieurs benchmarks tout au long de l'entraînement. La plupart progressent régulièrement, en même temps que la perte d'entraînement s'améliore. Deux exceptions méritent l'attention. Le score sur SIQA fluctue beaucoup, et les auteurs pensent que ce benchmark n'est peut-être pas fiable ; sur WinoGrande, le score est moins lié à la perplexité, et le 33B et le 65B restent presque identiques pendant tout l'entraînement.
Un fine-tuning d'instructions simple
Les auteurs mènent aussi une petite expérience ; en suivant le protocole de Chung et al. (Flan-PaLM), ils appliquent au 65B un léger fine-tuning d'instructions et appellent le résultat LLaMA-I. Sur MMLU, le score passe de 63.4 à 68.9, devant des modèles de taille moyenne fine-tunés sur instructions comme OPT-IML-Max 30B (43.2) et Flan-PaLM 62B (59.6), mais encore assez loin du meilleur de l'époque, les 77.4 de code-davinci-002. Les auteurs insistent sur le fait que ce n'est pas le cœur de l'article et qu'ils n'ont fait qu'une seule expérience.
Biais, toxicité et véracité
Toxicité. Sur RealToxicityPrompts, la toxicité augmente avec la taille du modèle, et plus nettement encore avec des prompts qui demandent de « compléter la phrase de façon polie, respectueuse et impartiale » ; le 65B atteint alors 0.141, contre 0.081 pour le 7B.
Stéréotypes. Sur CrowS-Pairs, LLaMA-65B obtient un score de biais moyen de 66.6, légèrement meilleur que GPT-3 (67.2) et OPT-175B (69.5) ; le biais le plus marqué concerne toutefois la religion, environ 10 points de pourcentage au-dessus d'OPT, suivie de l'âge et du genre. Les auteurs supposent que ces biais viennent de CommonCrawl.
Genre et profession. Sur WinoGender, le modèle résout nettement mieux les pronoms « they/them/someone » que « he » et « she ». Sur les questions « pièges », où le pronom ne correspond pas au genre majoritaire de la profession, il se trompe davantage ; il juge donc d'après le genre stéréotypé de la profession plutôt que d'après les indices de la phrase.
Véracité. Sur TruthfulQA, 57 % des réponses du 65B sont vraies, et 53 % sont à la fois vraies et informatives, contre 28 % et 25 % pour GPT-3 175B ; les auteurs reconnaissent toutefois que le taux de bonnes réponses reste bas et que le modèle risque fort d'inventer de fausses réponses.
Calcul et émissions de carbone
L'entraînement de LLaMA-65B a demandé environ 1.02 million d'heures GPU A100. Les auteurs estiment que l'ensemble du développement a duré environ 5 mois sur 2 048 A100, pour une consommation totale d'environ 2 638 MWh, soit environ 1 015 tonnes d'équivalent CO2 avec l'intensité carbone moyenne du réseau électrique américain. Ils espèrent que la publication des modèles évitera à d'autres de refaire cet entraînement.
Après la publication
Les poids de LLaMA étaient fournis aux chercheurs sous licence non commerciale, sur demande. Une semaine plus tard, ils fuitaient sur 4chan sous forme de fichier torrent ; Meta a ensuite demandé le retrait des copies hébergées sur Hugging Face et d'autres plateformes, mais les fichiers circulaient déjà largement.
Les semaines suivantes montrent l'influence de ces poids. Le 13 mars 2023, des chercheurs de Stanford publient Alpaca. Ils génèrent 52 000 démonstrations d'instructions avec text-davinci-003 d'OpenAI, s'en servent pour fine-tuner LLaMA-7B, et annoncent un coût total de reproduction inférieur à 600 dollars ; dans leur propre évaluation à l'aveugle, Alpaca l'emporte 90 fois contre 89 face à text-davinci-003. L'évaluation est modeste, mais elle a fait de « poids ouverts plus un peu de données d'instructions » une voie que beaucoup ont suivie.
La liste transparente des sources de données a aussi eu un revers. Books3 contient un grand nombre de livres protégés par le droit d'auteur. En juillet 2023, plusieurs écrivains, dont Sarah Silverman, poursuivent Meta pour violation du droit d'auteur, l'accusant d'avoir entraîné LLaMA sur leurs livres ; Books3 est l'un des points centraux de la plainte.
Cinq mois après LLaMA, Meta publie Llama 2, utilisable commercialement ; un an plus tard, Llama 3 pousse la même direction encore plus loin, avec environ 15 000 milliards de tokens de préentraînement.
Conclusion
LLaMA n'invente aucun nouveau composant ; il change de question. Chinchilla demandait comment dépenser au mieux le calcul d'entraînement, LLaMA demande comment économiser le plus une fois le modèle déployé, et la réponse consiste à faire lire beaucoup de livres à un petit modèle. Avec 1 000 milliards de tokens lus, le 13B dépasse GPT-3 sur la plupart des benchmarks.
Gardez ce compromis en tête quand vous choisissez un modèle. Les tokens supplémentaires lus à l'entraînement ne se paient qu'une fois, alors que chaque requête d'inférence fait tourner le modèle entier ; pour un service qui doit rester longtemps en ligne, un modèle un peu plus petit qui a lu davantage est généralement plus avantageux.
Au passage, dès la deuxième génération, le nom est passé de LLaMA à Llama ; on n'a enfin plus besoin de compter les majuscules.